

Node.js读取文件时怎么处理不同系统的换行符差异
详细讲解在Node.js中读取不同操作系统生成的文本文件时,如何妥善处理CRLF与LF换行符差异,避免末尾回车符导致的隐藏Bug与解析错误。
/\r?\n/ 拆分行,或先统一替换换行符;对于逐行处理的大文件,优先使用内置的 readline 模块,它原生兼容各类操作系统的换行符且不会额外占用过多内存。
一、为什么换行符会引发隐蔽的 Bug
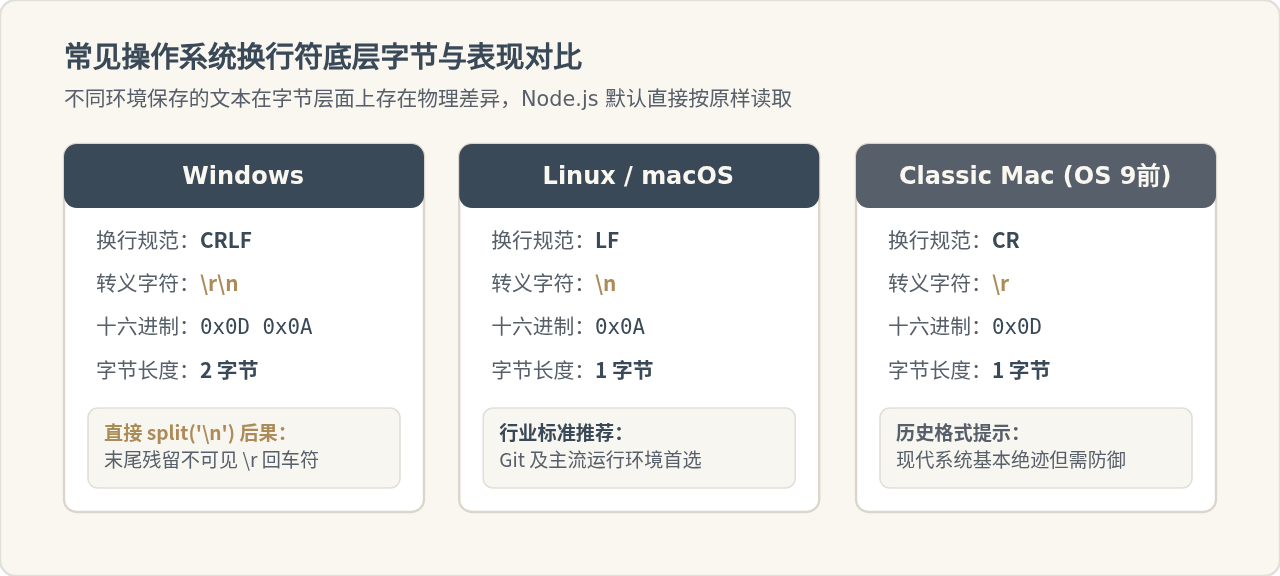
在日常跨平台开发或读取外部配置文件、CSV、日志时,文件可能来源于 Windows、Linux 或 macOS。不同系统在文本文件中记录“换行”所采用的底层字节编码并不相同:
- Windows 系统:使用
CRLF(Carriage Return + Line Feed),即\r\n,对应十六进制字节0x0D 0x0A。 - Linux 与现代 macOS 系统:使用
LF(Line Feed),即\n,对应十六进制字节0x0A。 - 早期经典 Mac 系统(Mac OS 9 及之前):使用
CR(Carriage Return),即\r,对应十六进制字节0x0D。
Node.js 的 fs.readFile() 默认只是把底层字节按字符集(如 UTF-8)解码为内存字符串,并不会主动修改或统一换行符。许多开发者习惯直接使用 content.split('\n') 进行行切割,如果读取的是 Windows 格式的文本,切分出的每一行字符串末尾都会保留一个不可见的 \r 字符。
这会导致一系列看起来非常诡异的运行期错误:比如 line === 'admin' 判断永远为 false(因为实际是 admin\r);拼接文件路径时出现乱码或路径解析失败;用正则匹配行末 /$ 时匹配不中;甚至在终端输出日志时发生光标回退覆盖现象。
二、常用处理方法:从简单分割到流式解析
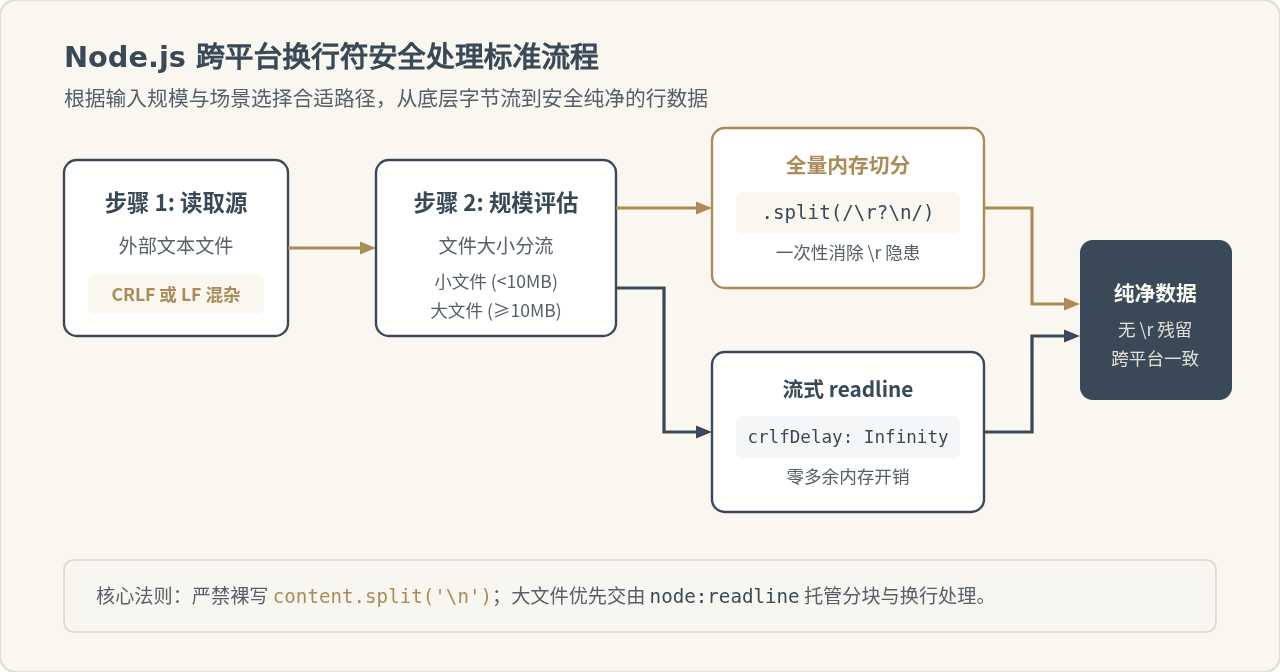
处理换行符差异并不复杂,核心目标是让切分出来的每一行内容都彻底剥离系统特异的控制字符。根据文件大小和使用场景,主要有以下三种处理方式:
方法 1:使用通用正则表达式拆分(适用于中小文件)
如果文件体积较小(几十 KB 到数 MB 内),直接用 fs.readFileSync 或 fs.promises.readFile 载入内存,配合正则表达式拆分最为简单直接:
import fs from 'node:fs';

const content = fs.readFileSync('data.txt', 'utf-8');

// 关键:匹配可选的回车符加上强制的换行符
const lines = content.split(/\r?\n/);

lines.forEach((line, index) => {
  console.log(`第 ${index + 1} 行内容: "${line}",字符数: ${line.length}`);
});
这里使用的正则表达式是 /\r?\n/:
\r?表示匹配 0 个或 1 个\r回车符;\n表示匹配标准的换行符。
无论是 Windows 的 \r\n 还是 Linux 的 \n,都会被完整当作分隔符消费掉,生成的数组元素中绝不会残留 \r。
如果你的系统需要防御性解析极其古老的仅含 \r 的文件,可以使用 /\r\n|\r|\n/,或者先将全局的 \r\n 与 \r 统一替换为 \n:
const normalized = content.replace(/\r\n/g, '\n').replace(/\r/g, '\n');
方法 2:使用内置 readline 模块逐行流式读取(推荐大文件方案)
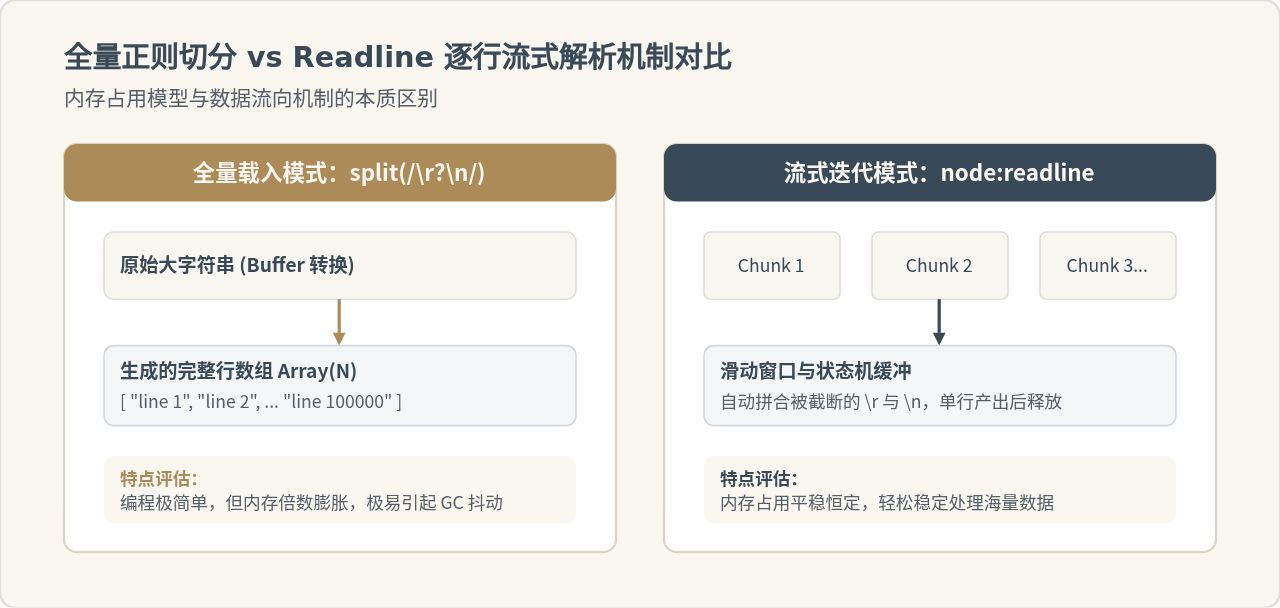
当处理几十兆甚至几个 G 的日志文件、大型 CSV 数据集时,一次性把全部内容读取并 split 会瞬间占用两倍以上内存,甚至触发 Node.js 堆内存溢出(OOM)。此时应该使用内置的 node:readline 模块配合流处理。
readline 具有内置的跨平台换行兼容逻辑,它在内部会自动识别 \r\n 和 \n,并将解析出的整洁字符串分发给 line 事件,开发者完全不需要手动处理正则:
import fs from 'node:fs';
import readline from 'node:readline';

async function processFileLineByLine(filePath) {
  const fileStream = fs.createReadStream(filePath, { encoding: 'utf-8' });

  // crlfDelay: Infinity 会把 \r\n 视为单个换行符,避免拆成两个事件
  const rl = readline.createInterface({
    input: fileStream,
    crlfDelay: Infinity
  });

  for await (const line of rl) {
    // line 已经剥离了换行符与回车符,干净可用
    handleLine(line);
  }
}

function handleLine(line) {
  // 业务逻辑
}

processFileLineByLine('large-dataset.csv');
参数中的 crlfDelay: Infinity 非常重要。因为流式读取是以分块(chunk)为单位进行的,如果一个 \r\n 恰好被分块边界切开(前半块以 \r 结尾,后半块以 \n 开头),默认情况下可能会产生延迟甚至误判。设置 crlfDelay: Infinity 会让 readline 始终将紧随其后的 \n 与前面的 \r 绑定为一次换行。
三、两种核心方案的技术对比与选型维度
为了让不同场景下的选择更清晰,我们可以从内存消耗、处理延迟、复杂度及边界控制等维度对比这两种最常见方案:
| 对比维度 | 正则分割 (split(/\r?\n/)) | Readline 流式 (createInterface) |
|---|---|---|
| 内存消耗 | 高(需完整载入文件字符串及生成的行数组) | 极低(恒定保持在少量缓冲区内存内) |
| 实现代码量 | 1 - 2 行,同步/异步均可一行完成 | 需要创建 Stream、Interface 与异步迭代器 |
| 适用文件规模 | 中小型文件(建议 < 10 MB) | 任意规模(数 MB 到数十 GB 日志均可) |
| 反向随机访问 | 支持(通过下标 lines[i] 快速定位) |
不支持(单向流,若需回溯需自建缓存) |
| 分块断行处理 | 无需考虑(整串载入后一次性匹配) | 内置 crlfDelay 自动处理跨 Chunk 的 CRLF |
四、常见踩坑点与防御性调试技巧
在实际工程中,换行符引发的问题往往非常隐蔽。以下几个要点可以帮助排查和避免潜在陷阱:
1. 如何直观排查字符串末尾是否存在隐藏的 \r
在控制台直接 console.log(line) 时,\r 是不可见的,肉眼根本无法发现。可以使用以下两种方式进行精确检查:
- 序列化检查:使用
JSON.stringify(line),如果末尾存在回车符,输出会明确显示为"hello\\r"。 - Buffer 十六进制检查:使用
Buffer.from(line)查看字节序列,如果末尾出现0d,说明存在\r。
const testLine = "system_status\r";

console.log(testLine);               // 表面上看起来完全正常: system_status
console.log(JSON.stringify(testLine)); // 清晰暴露: "system_status\r"
console.log(Buffer.from(testLine));   // 字节流中可见结尾为 <... 73 0d>
2. 文件末尾的空行问题
根据 POSIX 规范,标准的文本文件在最后一行末尾通常会有一个换行符。当使用 content.split(/\r?\n/) 时,最后一行末尾的换行符会被切出一个长度为 0 的空字符串 ""。
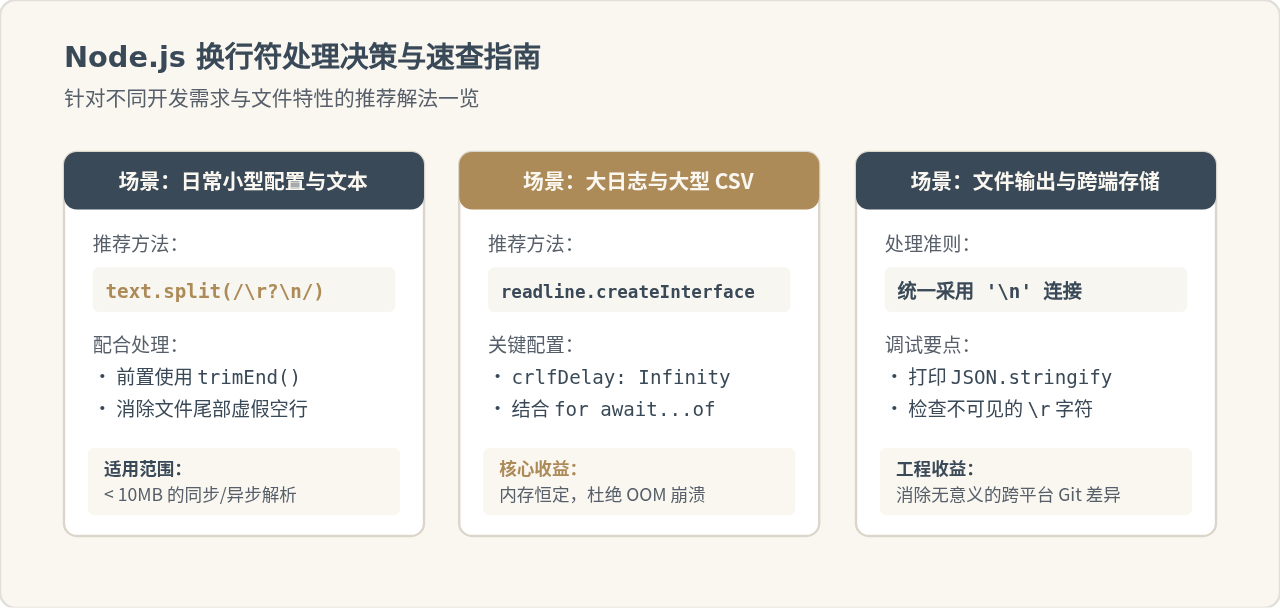
如果业务逻辑不需要这个因结尾换行而产生的虚假空行,建议在处理前使用 trimEnd(),或者在切分后过滤:
// 做法 A:先移除文件末尾空白/换行,再切分
const linesA = content.trimEnd().split(/\r?\n/);

// 做法 B:切分后根据业务要求保留非空行
const linesB = content.split(/\r?\n/).filter(line => line.trim().length > 0);
3. 写入文件时的换行符统一
除了读取,当 Node.js 需要跨平台生成或修改文件时,也需要注意写入的换行符:
- Node.js 提供了
os.EOL(End Of Line),在 Windows 上其值为\r\n,在 POSIX 系统上为\n。 - 但在现代工程中,统一将文件写入为
\n(LF)通常是更好的选择。绝大多数现代编辑器、数据库和云端运行环境都能完美识别\n,统一使用\n可以避免在多人协作提交代码或跨平台部署时产生大量无意义的 Git Diff。
五、总结与工程落地建议
跨系统换行符差异是典型的“隐性陷阱”:在纯类 Unix 开发机上测试一切正常,一旦部署到由 Windows 生成文件的环境或处理用户上传文件时,就会突然暴露出字符匹配失败的问题。要保障代码在所有环境下表现一致,牢记以下三条原则:
- 弃用单纯的
split('\n'):无论是小脚本还是复杂应用,涉及行拆分时一律使用正则/\r?\n/。 - 大体量数据托付给
readline:只要涉及长文本流处理,优先使用配置了crlfDelay: Infinity的readline接口。 - 善用序列化调试:在遇到字符串比较或正则匹配失败且排查无果时,第一时间使用
JSON.stringify()打印字符串,查看末尾是否有隐藏的\r。
NestJS 是什么?与 Express、Koa 的核心区别及选型建议
2026-11-05 13:46:41
生产环境升级 Node.js 的注意事项与兼容性测试策略
2026-11-05 09:19:24
nvm 常用命令详解:怎么平滑切换和升级 Node.js 版本
2026-11-04 09:02:34
JavaScript和JSP的根本区别:运行环境与执行机制解析
2026-11-03 23:30:18
使用nvm卸载指定版本Node.js并切换默认环境
2026-11-03 23:09:26







