JSON数据中包含换行符导致解析失败的解决方法
深入解析JSON数据中因换行符导致的解析失败故障,对照RFC 8259规范解释控制字符与转义序列的本质区别,提供源头序列化修复、传输链排查及消费端安全容错解析的完整解决方案。
在前后端数据交互、日志采集或调用第三方接口时,只要传输的字符串字段包含多行文本,解析器就常常抛出 SyntaxError: Unexpected token 或 JSONDecodeError: Unterminated string。这类错误通常并不是由于网络丢包或数据截断,而是文本中的“物理换行符”(即控制字符 LF/CR)直接暴露在 JSON 字符串字面量中,违反了 JSON 语法规范。解决该问题的核心在于:在生成端采用标准序列化工具将物理换行转义为合法的 \n 字符序列;若必须在消费端做兜底兼容,则需通过语法感知的状态机或精确正则将未转义的控制字符补齐转义,同时严禁粗暴全局替换。
一、问题复现与典型报错形态
假设用户在网页表单的多行文本框(textarea)中输入了包含换行的地址信息,服务端如果直接通过字符串模板进行拼接:
// 错误的手动拼装示例
const rawText = "北京市朝阳区\n建国路88号";
const jsonString = `{"address": "${rawText}"}`;
JSON.parse(jsonString); // 立即抛出解析异常
此时运行上述代码,不同语言的解析器将呈现如下典型报错:
- JavaScript:
SyntaxError: Unexpected token in JSON at position 20 (line 2 column 1)或Bad control character in string literal。 - Python:
json.decoder.JSONDecodeError: Unterminated string starting at line 1 column 13 (char 12)。 - Java (Jackson / Fastjson):
JsonParseException: Illegal unquoted character ((CTRL-CHAR, code 10)): has to be escaped using backslash to be included in name or string value。 - Go (encoding/json):
invalid character '\n' in string literal。
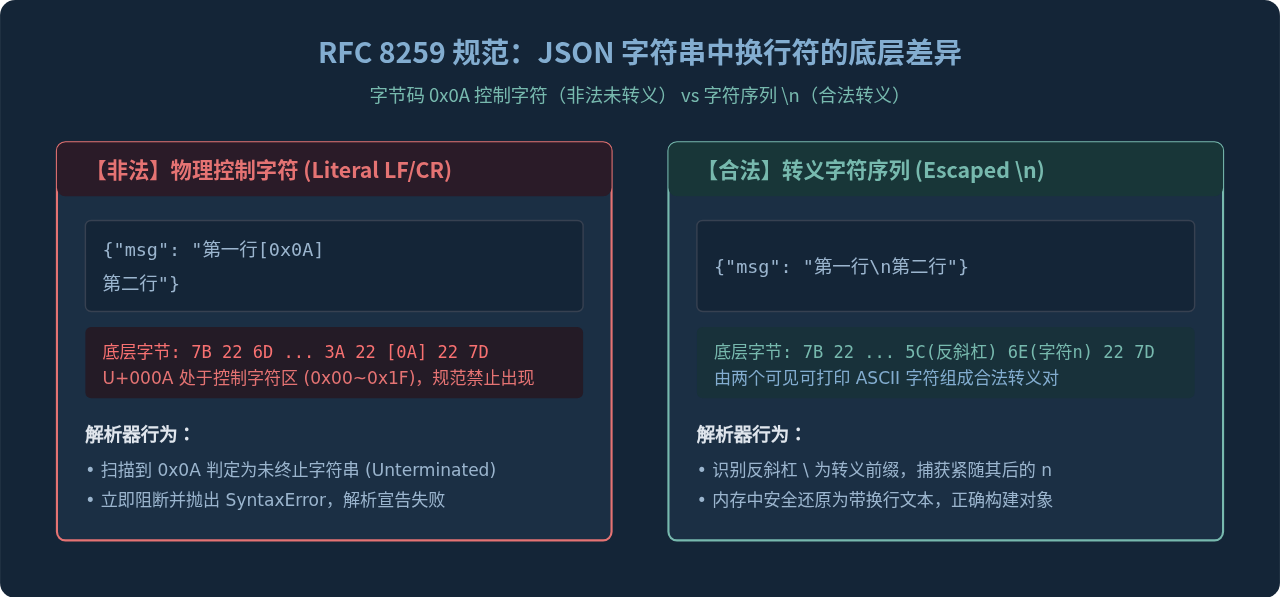
虽然开发者在视觉上看到的是合乎情理的“多行文字”,但在底层的字节流中,换行是以 ASCII 码 0x0A(LF)或 0x0D 0x0A(CRLF)存在的控制字符。解析器在读取到双引号闭合前遇到了物理换行,直接判定当前字符串未正常闭合,从而终止解析。
二、根本原因:RFC 8259 规范对字符串字符集的硬性约束
根据互联网工程任务组制定的 JSON 正式规范 RFC 8259 第 7 节(Strings),字符串是由双引号包围的零个或多个 Unicode 字符序列。规范明确规定:任何位于 U+0000 到 U+001F 范围内的控制字符(Control Characters),均不得以无转义的形式直接出现在字符串字面量中。
在这一范围中,常见的换行符 LF(U+000A,ASCII 10)与回车符 CR(U+000D,ASCII 13)正是控制字符。若要将它们包含在字符串值内部,必须使用两字符的反斜杠转义序列(Escape Sequence),即 \n(ASCII 0x5C + 0x6E)和 \r(ASCII 0x5C + 0x72)。
三、故障排查与定位的四步路径
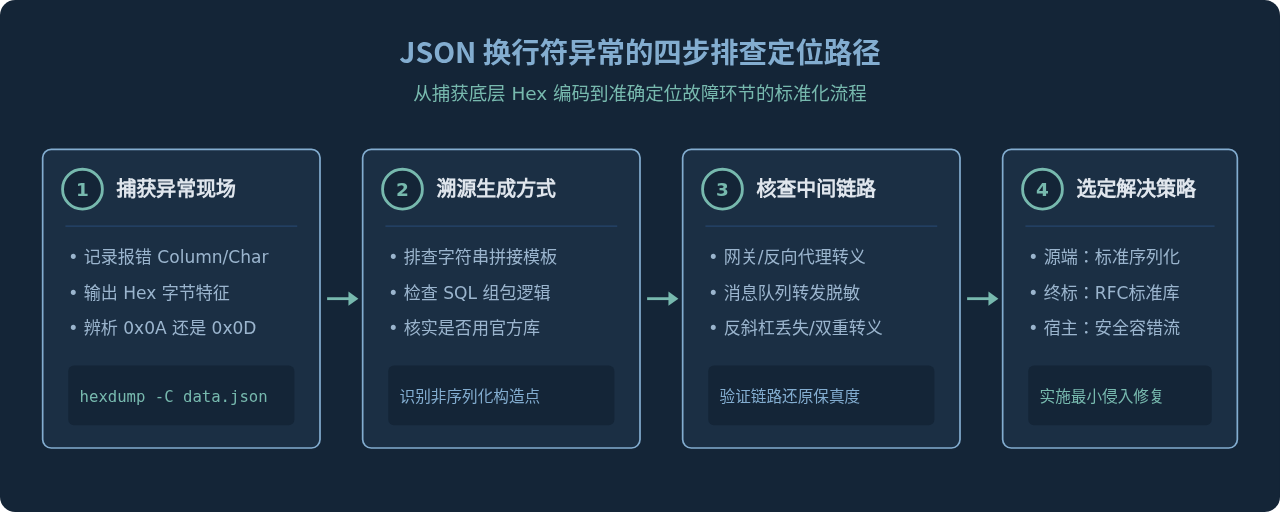
当排查一段解析失败的 JSON 时,切忌盲目添加 replace,应按照标准化步骤定位污染源头与字符具体编码:
- 提取原始字节流并打印十六进制:不要使用普通文本编辑器(编辑器会自动将控制字符可视化或重新格式化)。在终端中使用
xxd、hexdump -C或在代码中打印指定位置字符编码,确认异常位置是0x0A(LF)、0x0D(CR) 还是未配对的反斜杠0x5C。 - 定位数据生产边界:检查该 JSON 是由标准的序列化库(如
JSON.stringify、json.dumps)生成,还是程序中通过字符串拼装、模板字符串拼接或 SQL CONCAT 生成。如果是手工拼装,则根本原因就在于拼装前未转义。 - 排查网络中继与存储环节:检查数据是否经历过反向代理(如 Nginx)、消息队列(Kafka/RabbitMQ)或数据库存储。某些中间件或过滤网关在清洗特殊字符时,可能会误将
\n中的反斜杠滤除,只保留裸换行。 - 检查二次转义与反斜杠丢失:在部分语言(如 Java/C++)的字符串字面量中,代码中的
"\\n"编译后才是传输流中的\n。如果开发者只写了"\n",编译器在生成字面量时就已将其替换为0x0A,送入 JSON 解析器必然导致崩溃。
四、核心解决方法与多场景实践
解决换行符导致的解析失败,应区分数据源可控(生产端修复)与数据源不可控(消费端容错)两种应用场景。
1. 生产端根治:使用标准序列化库(黄金法则)
杜绝在任何业务代码中使用字符串格式化函数(如 String.format、模板字符串、`f-string` 等)拼凑 JSON。主流语言自带的标准 JSON 库会自动将换行符替换为正确的转义序列 \n:
JavaScript / Node.js:
// 正确做法:交由 JSON.stringify 统一序列化
const payload = {
  title: "多行输入示例",
  content: "首行文本\n次行文本\r\n末行文本"
};
const validJson = JSON.stringify(payload);
// validJson 内容为: {"title":"多行输入示例","content":"首行文本\\n次行文本\\r\\n末行文本"}
// 解析测试完全合规:
const parsed = JSON.parse(validJson);
Python:
import json

data = {
    "remarks": "第一行备注\n第二行备注"
}
# json.dumps 自动将 0x0A 序列化为 \n 字符串
json_str = json.dumps(data, ensure_ascii=False)

# 反序列化还原无障碍
obj = json.loads(json_str)
assert obj["remarks"] == data["remarks"]
Java (使用 Jackson / Gson):
// 永远不要拼接: "{\"content\":\"" + text + "\"}"
ObjectMapper mapper = new ObjectMapper();
Map<String, String> map = new HashMap<>();
map.put("content", "段落A\n段落B");
String jsonOutput = mapper.writeValueAsString(map); // 自动转义控制字符
2. 消费端容错:安全修复非法控制字符
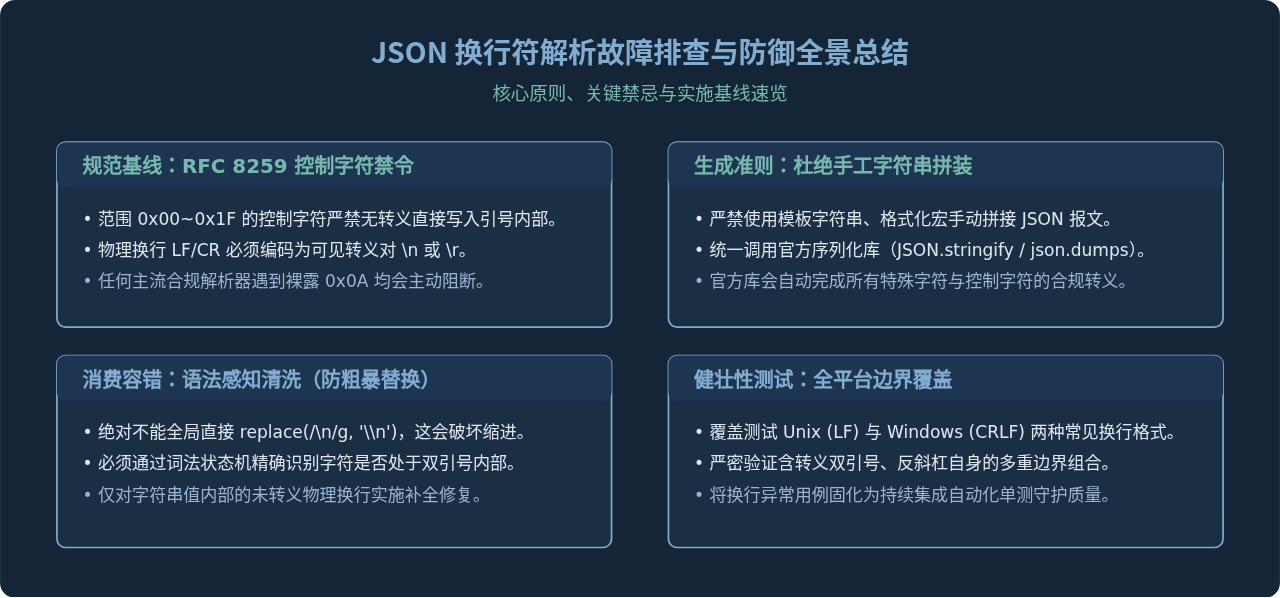
若数据来自老旧接口、不可修改的下游服务或第三方爬虫输出,消费端必须在送入 JSON.parse 或 json.loads 前进行清洗。切忌使用 str.replace(/\n/g, '\\n')!如果 JSON 本身经过了漂亮的换行缩进(Pretty Print),盲目将所有换行替换为 \n 会彻底破坏 JSON 对象键值间的语法结构。
安全清洗方案必须仅针对处于双引号之内的物理换行符进行转义。可以通过状态机词法扫描,或使用精准的正则替换:
/**
 * 针对引号内部未转义换行符的精准清洗函数
 * 适用于非法 JSON 字符串的紧急修复
 */
function sanitizeRawNewlinesInJson(jsonStr) {
  let inString = false;
  let isEscaped = false;
  let result = '';

  for (let i = 0; i < jsonStr.length; i++) {
    const char = jsonStr[i];

    if (char === '"' && !isEscaped) {
      inString = !inString;
      result += char;
    } else if (inString && char === '\\') {
      isEscaped = !isEscaped;
      result += char;
    } else if (inString && char === '\n') {
      result += '\\n';
      isEscaped = false;
    } else if (inString && char === '\r') {
      result += '\\r';
      isEscaped = false;
    } else {
      result += char;
      isEscaped = false;
    }
  }

  return result;
}

// 验证测试:
const malformed = '{\n  "title": "格式化缩进正常",\n  "text": "第一行\n第二行内容"\n}';
const cleaned = sanitizeRawNewlinesInJson(malformed);
const result = JSON.parse(cleaned);
console.log(result.text); // 正确输出多行内容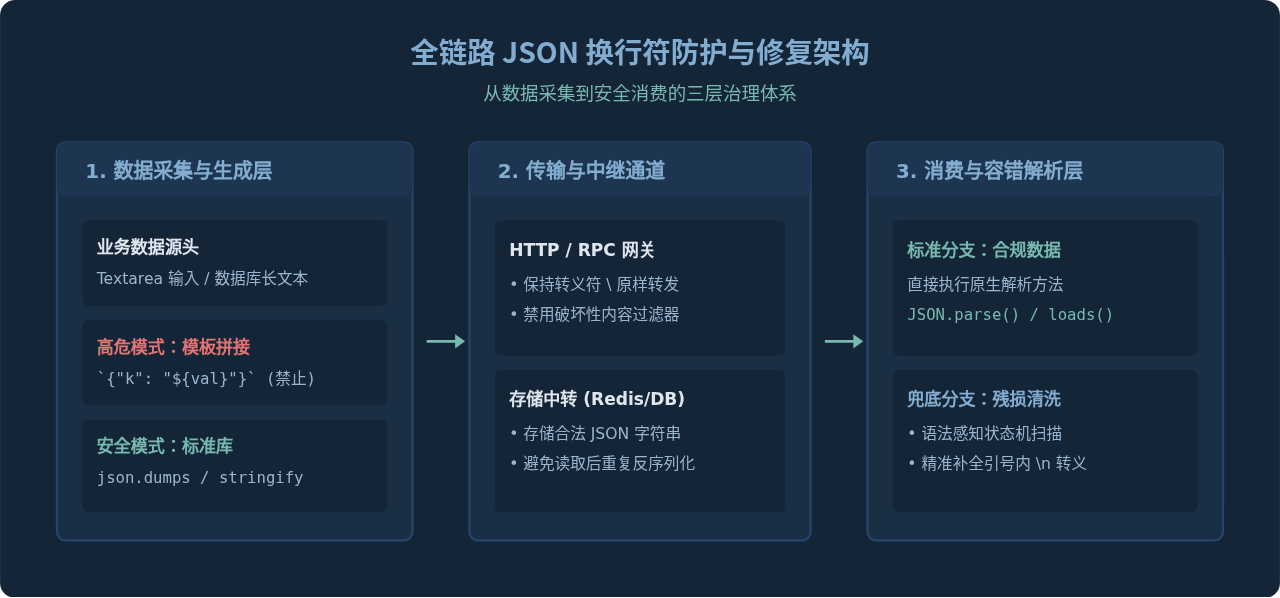
五、测试验证与易错陷阱
- 使用粗暴替换:执行
text.replaceAll("\n", "")抹去换行,导致原本属于多行的文本失去段落结构,业务含义被破坏。 - 多重转义导致斜杠爆炸:若在已经具备
\n的字符串上二次追加\\n,解析后将变成字面字符\n而非真实换行符。 - 忽视 Windows 风格换行:Windows 环境输入通常为 CRLF(
\r\n),在编写正则或状态机时,必须同时兼顾\r(0x0D)的转义,否则仍可能在部分解析引擎中遗留隐患。
在交付或部署修复方案后,可使用以下包含边界条件的测试用例对解析模块进行断言验证:
// 验证用例集
const testCases = [
  { name: "Unix 换行", raw: '{"data":"Line1\nLine2"}' },
  { name: "Windows CRLF 换行", raw: '{"data":"Line1\r\nLine2"}' },
  { name: "包含双引号与转义符", raw: '{"data":"Say \\"Hi\\"\nNext"}' },
  { name: "格式化缩进 JSON", raw: '{\n  "data": "A\nB"\n}' }
];

testCases.forEach(tc => {
  try {
    const safeStr = sanitizeRawNewlinesInJson(tc.raw);
    const obj = JSON.parse(safeStr);
    console.log(`[PASS] ${tc.name} 解析成功:`, obj.data.length > 0);
  } catch (e) {
    console.error(`[FAIL] ${tc.name} 解析失败:`, e.message);
  }
});
JavaScript怎么准确判断数据类型:typeof、instanceof与Object.prototype.toString
2026-11-05 17:09:21
JS中将数组和对象混合组装为JSON字符串
2026-11-05 16:41:42
JS运算符优先级与结合性的区别是什么?
2026-11-05 13:22:02
JS Map怎么只遍历Key或Value
2026-11-05 13:00:36
D3.js 与 ECharts 选型对比:灵活性 vs 开发效率
2026-11-05 09:45:01