Node.js后端生成高强度随机字符串的方法
深入解析在Node.js后端生成高强度、密码学安全随机字符串的工程方法。涵盖内置crypto模块API选型、自定义字符集实现、模偏差(Modulo Bias)规避以及生产场景中的安全与性能权衡。

node:crypto 模块所提供的密码学安全伪随机数发生器(CSPRNG),并根据业务需求配合正确的编码转换或拒绝采样算法。本文将具体阐明底层原理、开箱即用的标准格式生成方式,以及自定义字符集时消除“模偏差”的完整工程实现。
一、核心认知:为什么必须使用 CSPRNG 而非 Math.random
在许多日常前端脚本或初级示例中,常能见到诸如 Math.random().toString(36).substring(2) 这类生成随机字符串的代码。这种写法看起来简洁轻便,不需要引入任何模块即可快速获得一串字母数字混合文本,在前端生成临时列表渲染 key 或无安全要求的测试数据时完全成立。
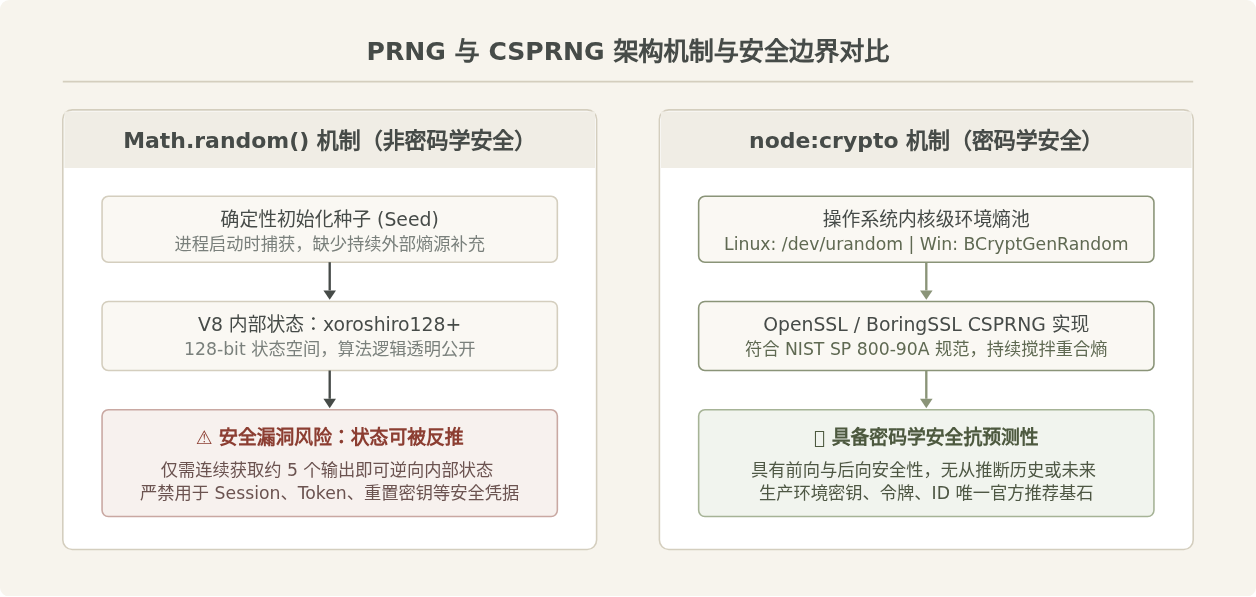
然而,一旦进入后端安全上下文(如 Session ID、OAuth 授权码、防重放 Nonce),该写法将带来严重安全漏洞。原因在于 V8 引擎底层实现的 Math.random() 采用的是名为 xoroshiro128+(或早期 xorshift128+)的算法。这种算法属于普通伪随机数发生器(PRNG),内部仅维护 128 位的确定性状态。
攻击者只需收集后端系统连续生成的少数几个随机值,就可以反向求解出引擎当前的内部种子状态,进而以 100% 的准确率推算出后续生成的所有“随机”值。
相比之下,Node.js 内置的 node:crypto 模块使用的是操作系统内核维护的密码学安全伪随机数发生器(CSPRNG)。在 Linux 和 macOS 上它对接 getrandom(2) 或 /dev/urandom,在 Windows 上对接 BCryptGenRandom。这些内核源通过硬件环境噪声不断补充物理熵池,在密码学上具备前向安全性与后向不可预测性。
二、基础实践:基于内置 API 快速生成标准格式
在实际项目中,如果业务对于随机字符串的字符组成没有特定限制(例如不需要排除特定标点或要求纯大写),直接使用 Node.js 内置方法完成字节生成与编码转换是性能最高、最不容易出错的选择。
1. 标准通用唯一标识符:crypto.randomUUID()
自 Node.js 14.17.0 和 16.7.0 起,官方在 node:crypto 中原生提供了 randomUUID()。该函数直接生成符合 RFC 4122 标准的 Version 4 UUID。
import { randomUUID } from 'node:crypto';

// 生成一个 36 字符的标准 UUID v4 字符串
const uuid = randomUUID();
console.log('UUID v4:', uuid);
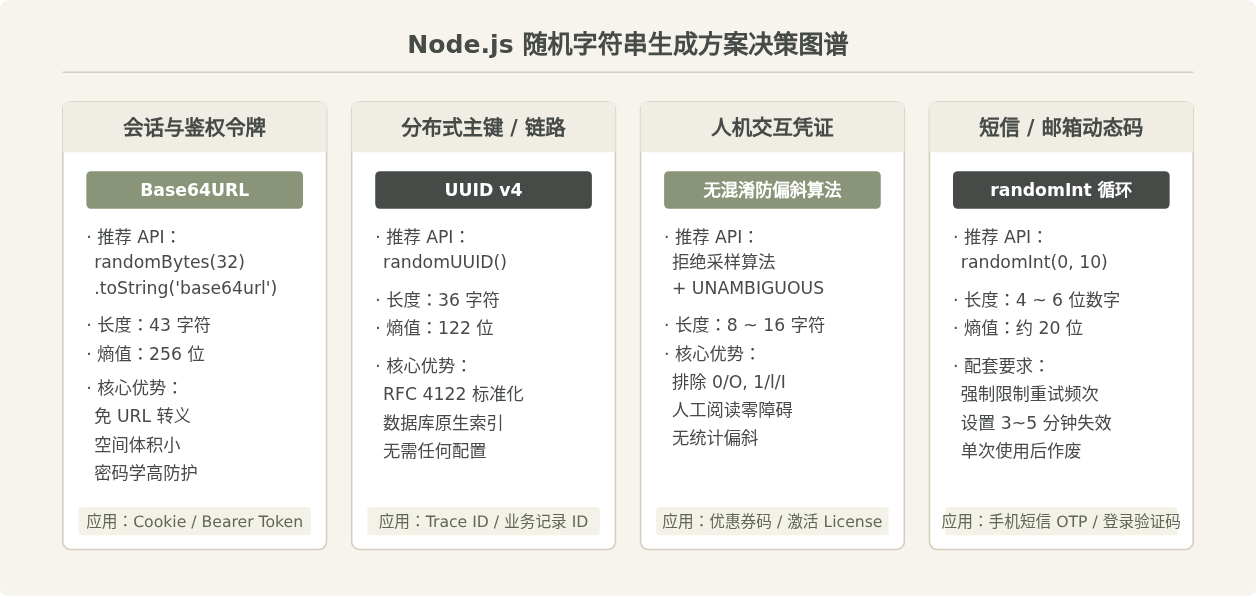
特点与场景:UUID v4 内部包含 122 位的密码学安全随机熵(另外 6 位用于标识版本和变体)。格式统一、被绝大部分数据库(如 PostgreSQL 的 UUID 类型)和日志追踪系统原生支持,非常适合作为全局链路请求 ID(Trace ID)或数据表主键。
2. 十六进制高强度字符串:randomBytes(n).toString('hex')
如果需要固定长度且仅包含数字和 a-f 的紧凑安全字符串(如重置密码 Token 或 HMAC 密钥),可以使用 randomBytes 转换为十六进制(Hex)。
import { randomBytes } from 'node:crypto';

// 生成 16 字节(128 位安全熵),编码后为 32 字符的十六进制字符串
const token16 = randomBytes(16).toString('hex');

// 生成 32 字节(256 位安全熵),编码后为 64 字符的十六进制字符串
const token32 = randomBytes(32).toString('hex');

console.log('16-byte Hex:', token16);
console.log('32-byte Hex:', token32);32-byte Hex: a1b2c3d4e5f60718293a4b5c6d7e8f90a1b2c3d4e5f60718293a4b5c6d7e8f90
3. Web 安全紧凑字符串:randomBytes(n).toString('base64url')
传统的 base64 编码包含 +、/ 和填充符 =,直接用于 URL 参数或 Cookie 时需要进行 URI 转义。Node.js 官方支持将 Buffer 直接转为 base64url(遵循 RFC 4648 §5,将 + 替换为 -,/ 替换为 _,并省略尾部 =)。
import { randomBytes } from 'node:crypto';

// 32 字节(256 位熵)经 Base64URL 编码后长度仅为 43 个字符
const sessionSecret = randomBytes(32).toString('base64url');
console.log('Base64URL Token:', sessionSecret);核心优势:在提供相同 256 位熵强度的情况下,Hex 格式需要 64 个字符,而 Base64URL 仅需要 43 个字符,空间体积缩减约 33%,且无需任何转义即可安全放入 HTTP Header、URL Query 或 Cookie 中。
crypto.randomBytes(size) 支持同步调用,也支持传入回调函数或通过 util.promisify 进行异步调用。当单次请求字节数较少(如 16~64 字节)时,同步调用的执行耗时仅在微秒级别,其 C++ 绑定的内部预取机制足以满足绝大多数场景。但如果系统在极高并发的单进程循环中一次性请求数兆字节的随机数,同步生成会短暂占用主线程,此时应优先考虑基于 Promise 的异步调用。
三、进阶实践:自定义字符集与消除“模偏差”(Modulo Bias)
许多实际业务需要更加可控的随机字符串。例如:
- 手机短信 / 邮件验证码:仅允许使用数字
0123456789。 - 用户优惠券码 / 激活码:为防止印刷或人眼识别混淆,需要排除易混淆字符(例如剔除
0与O、1与l、I)。 - 短链自定义 Slug:只使用特定 62 个大小写字母与数字。
警惕隐蔽的“模偏差”(Modulo Bias)陷阱
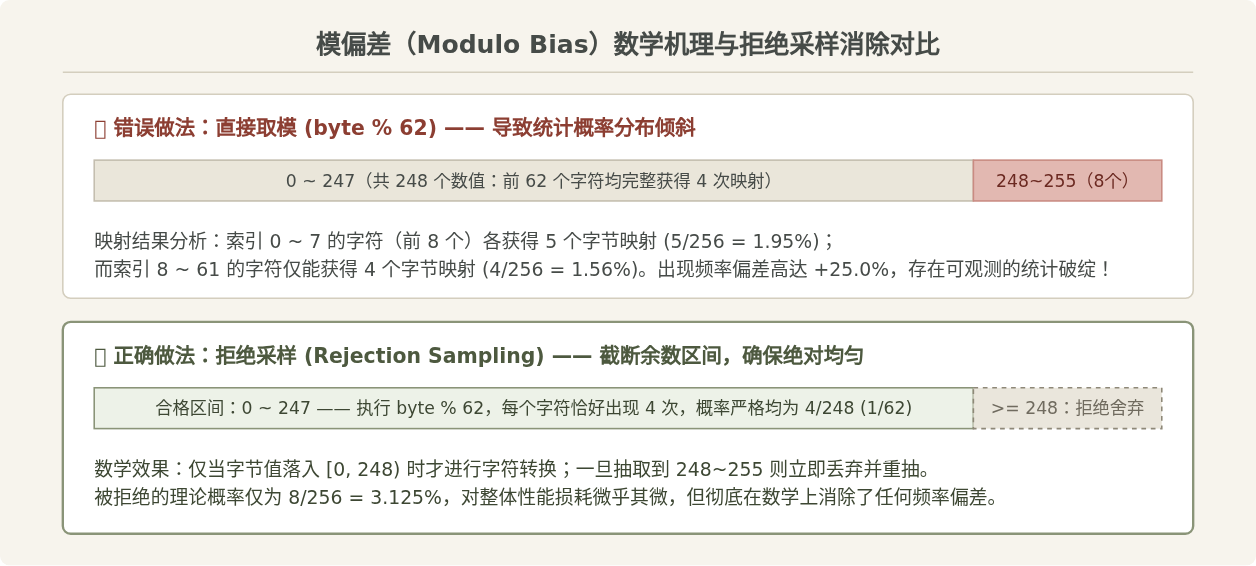
在实现自定义字符集时,常见的直觉写法是:先获取一个随机字节(0 到 255 的整数),然后直接对其执行取模运算:index = randomByte % alphabet.length。
这种做法看似均匀,实际上存在严重的模偏差(Modulo Bias)。一个字节能够表示的离散整数数量为 256 个(0 ~ 255)。如果字符集的长度无法被 256 整除,那么排在前面的字符被抽中的概率会显著高于后面的字符。
以常见的 62 个字符集(0-9, a-z, A-Z)为例:$256 \div 62 = 4$ 余 $8$。这意味着索引从 0 到 7 的这 8 个字符,在 0~255 的范围内各能匹配到 5 个不同的字节值;而索引从 8 到 61 的其余 54 个字符,各自只能匹配到 4 个字节值。
计算其概率差:$5 / 256 pprox 0.01953$,而 $4 / 256 = 0.015625$。前 8 个字符的出现概率比其他字符高出了整整 25%。在密码学分析中,这种不均衡的概率分布会大幅收窄暴力破解的搜索空间,使高强度随机字符串的实际安全性大打折扣。
生产级完整实现:无偏拒绝采样算法
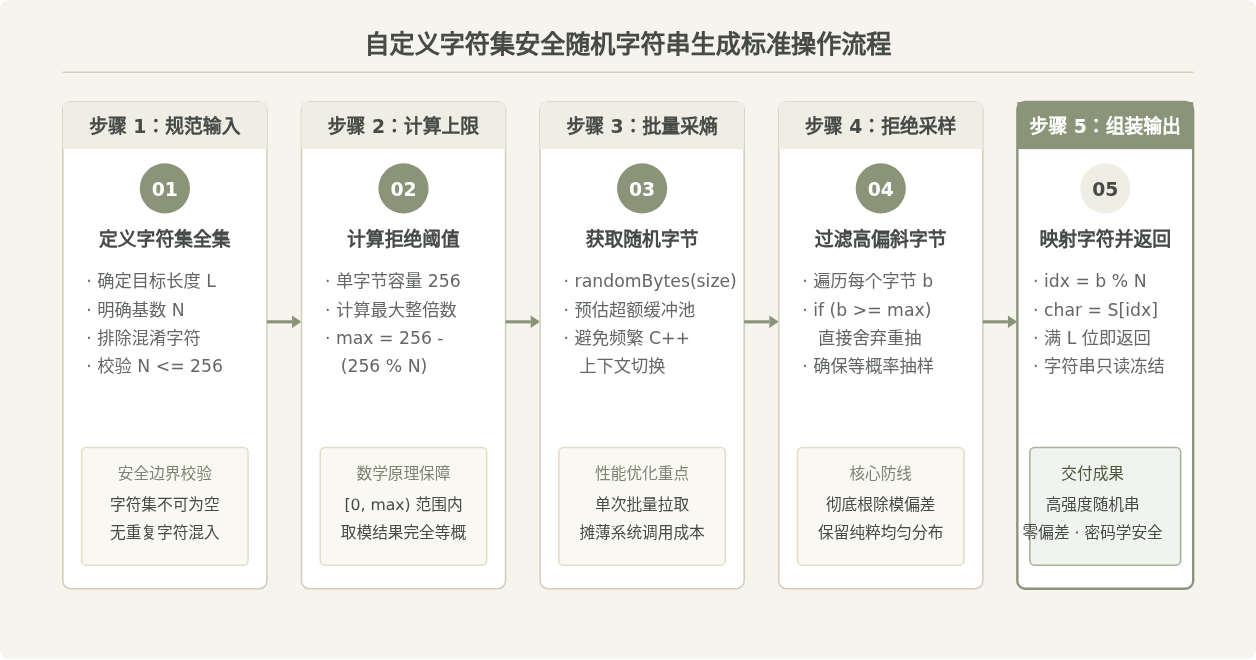
下面是一个可以直接复制并在 Node.js 生产环境中运行的高性能无偏随机字符串生成函数。它采用批量拉取字节(Buffered Rejection Sampling)策略,兼顾了单次生成与循环采样的性能:
import { randomBytes, randomInt } from 'node:crypto';

/**
 * 字符集常量预设
 */
export const CHARSETS = {
  // 基础数字(短信/验证码)
  NUMERIC: '0123456789',
  // 人眼防混淆字符集(排除了 0, O, 1, I, l)
  UNAMBIGUOUS: '23456789ABCDEFGHJKLMNPQRSTUVWXYZabcdefghijkmnopqrstuvwxyz',
  // 标准 Base62
  ALPHANUMERIC: '0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZabcdefghijklmnopqrstuvwxyz',
};

/**
 * 生成指定长度的高强度无偏随机字符串
 * @param {number} length 目标字符串长度
 * @param {string} alphabet 候选字符集(长度不超过 256)
 * @returns {string} 密码学安全的随机字符串
 */
export function generateSecureString(length, alphabet = CHARSETS.ALPHANUMERIC) {
  if (length <= 0) {
    throw new RangeError('长度必须为正整数');
  }
  const alphabetLength = alphabet.length;
  if (alphabetLength === 0 || alphabetLength > 256) {
    throw new RangeError('字符集长度必须在 1 到 256 之间');
  }

  // 快捷通道 1:字符集长度是 2 的幂次方时(如 16, 64),按位与运算天然无模偏差
  // 快捷通道 2:小规模短串生成也可直接使用 Node.js 内置已消除模偏差的 randomInt
  if (length <= 8) {
    let result = '';
    for (let i = 0; i < length; i++) {
      result += alphabet[randomInt(0, alphabetLength)];
    }
    return result;
  }

  // 批量高效采样:计算单字节最大有效阈值(256 能够被 alphabetLength 整除的最大倍数)
  const maxValidByte = 256 - (256 % alphabetLength);

  let result = '';
  // 估算批次大小:考虑到最多约 3%~20% 的拒绝率,分配稍大一点的缓冲池
  const batchMultiplier = Math.ceil(256 / maxValidByte);

  while (result.length < length) {
    const needed = length - result.length;
    const bufferSize = Math.max(needed * batchMultiplier, 16);
    const bytes = randomBytes(bufferSize);

    for (let i = 0; i < bytes.length && result.length < length; i++) {
      const byte = bytes[i];
      // 拒绝落入偏斜区间的字节
      if (byte < maxValidByte) {
        result += alphabet[byte % alphabetLength];
      }
    }
  }

  return result;
}
我们对上述函数的运行结果进行调用验证:
// 1. 生成 6 位纯数字安全短信验证码
const smsCode = generateSecureString(6, CHARSETS.NUMERIC);

// 2. 生成 16 位排除混淆字符的授权券码
const promoCode = generateSecureString(16, CHARSETS.UNAMBIGUOUS);

// 3. 生成 32 位高强度 Base62 业务令牌
const apiToken = generateSecureString(32, CHARSETS.ALPHANUMERIC);

console.log('SMS Code:', smsCode);
console.log('Promo Code:', promoCode);
console.log('API Token:', apiToken);Promo Code: K9mX2bW8Fp3vE4tH
API Token: 9xLt4W2mQzV8Kp7nR1sJ5cX3bA6dE0fH
四、安全评估与场景技术选型矩阵
在工程设计中,随机字符串的“强度”不仅取决于生成算法是否安全,还取决于安全熵(Entropy)的大小。
安全熵的计算公式为:$E = L imes \log_2(N)$,其中 $L$ 为字符串长度,$N$ 为字符集包含的字符数量。
- 短验证码(如 6 位纯数字):$E = 6 imes \log_2(10) pprox 19.93$ 位熵。即使算法本身是 CSPRNG,面对暴力穷举也仅有 100 万种组合,必须强绑定服务端的**频次限制(Rate Limiting)**与**短有效期(如 5 分钟失效)**。
- 会话令牌 / API Key(如 32 字符 Base62):$E = 32 imes \log_2(62) pprox 190.5$ 位熵。该强度远超目前全球算力的离线撞库上限,具备长效防护能力。
五、生产部署排查与注意事项
为了确保在真实服务集群中安全落地,开发者可以在代码审查中依照以下核对表逐项检查:
| 检查项 | 风险与后果 | 正确规范与防护方案 |
|---|---|---|
| 杜绝 Math.random | 内部种子可被逆向,推算出全部后续值,导致会话劫持 | 涉及凭证、安全校验的随机值,一律强制使用 node:crypto API。 |
| 拒绝简单取模 | 存在高达 25% 的模偏差,降低黑客破解难度 | 自定义字符集时使用拒绝采样(Rejection Sampling)或按位掩码。 |
| 时序攻击防御 | 使用 === 比较随机 Token 会因匹配速度差异泄露字符 |
比对两枚安全随机字符串时,必须使用 crypto.timingSafeEqual()。 |
| 容器环境熵枯竭 | 极早期容器启动瞬间缺少硬件熵,可能导致阻塞 | 现代 Linux 内核(5.6+)保证 /dev/urandom 初始化后永不阻塞,无需担忧。 |
当后端系统验证客户端回传的随机字符串(例如比对密码重置 Token、Webhook 签名凭据)时,切勿使用普通的 tokenA === tokenB 比较。JavaScript 的字符串全等比较在遇到第一个不同字符时会提前退出(Short-circuit),这种微秒级别的时间差异容易遭受时序攻击(Timing Attack)。正确做法是将两个字符串转为 Buffer,并使用 crypto.timingSafeEqual(bufA, bufB) 进行常数时间比较。
遵循上述原则,开发者不仅能在 Node.js 后端中快速产出高强度的安全随机字符串,更能在算法底层彻底规避统计偏斜与可预测性风险,为整个后端的身份认证体系构筑坚实的密码学防线。
在 NestJS 中使用管道验证数据与守卫控制访问权限
2026-11-05 12:43:41
Node.js环境中怎么使用axios或http模块发送GET请求
2026-11-03 21:57:15
Node.js环境下怎么实现JS反混淆自动化?常用库与CLI工具推荐
2026-11-03 21:15:54
解决JS逆向常见报错:缺少DOM环境导致代码运行失败
2026-11-03 20:41:59
JS脚本是什么:新手怎么编写并运行第一个JavaScript代码
2026-11-03 16:22:55