Node.js中url模块与querystring模块处理查询字符串的区别
深入对比Node.js中url模块与querystring模块在解析查询字符串时的核心区别,涵盖职责定位、前导问号处理、自定义分隔符、安全防护及现代WHATWG标准的演进选型。
url.parse() 与 querystring 均已被官方标记为遗留(Legacy)API,目前统一推荐使用符合 WHATWG 规范的 URL 与 URLSearchParams。

一、职责边界与处理对象的本质差异
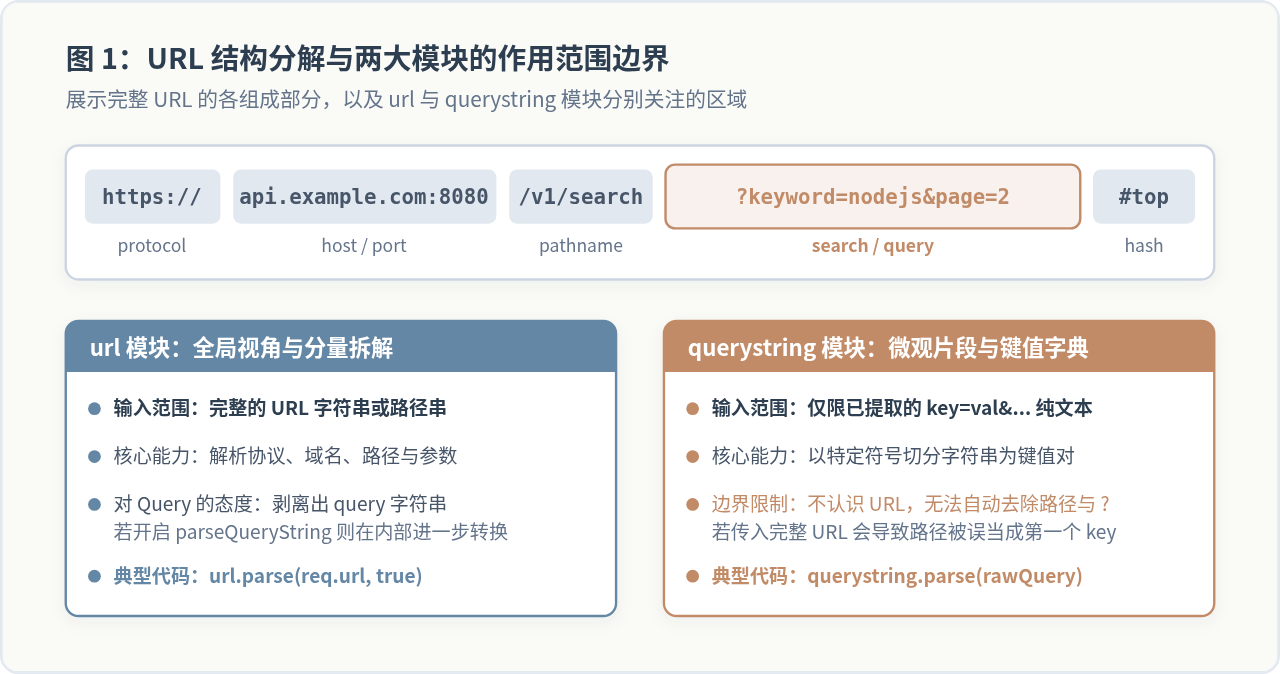
要透彻理解两者的差异,必须从它们各自的设计目标和输入要求切入。一个标准的完整 URL(如 https://api.example.com/search?keyword=node&page=1#top)包含协议(protocol)、主机(host)、路径(pathname)、查询参数(search/query)以及锚点(hash)等多个逻辑层级。
url 模块站在“全景资源定位符”的抽象层次上:它的输入可以是一条完整的网络地址或 HTTP 请求行中的路径信息。url 模块的核心任务是对这些不同层级的组件进行识别、切分与重新组装。对查询字符串而言,url 模块首先负责把它从整条字符串中“定位并提取”出来。
querystring 模块站在“纯文本序列化”的层次上:它完全不了解 HTTP 协议或 URL 规则,它的输入预期是一段形如 key1=value1&key2=value2 的纯粹键值对文本。如果直接把整条 URL 传递给 querystring.parse(),它并不会主动去查找问号 ?,而是把路径甚至协议头统统作为第一个键名的一部分进行处理。
二、解析流程与代码实现对比
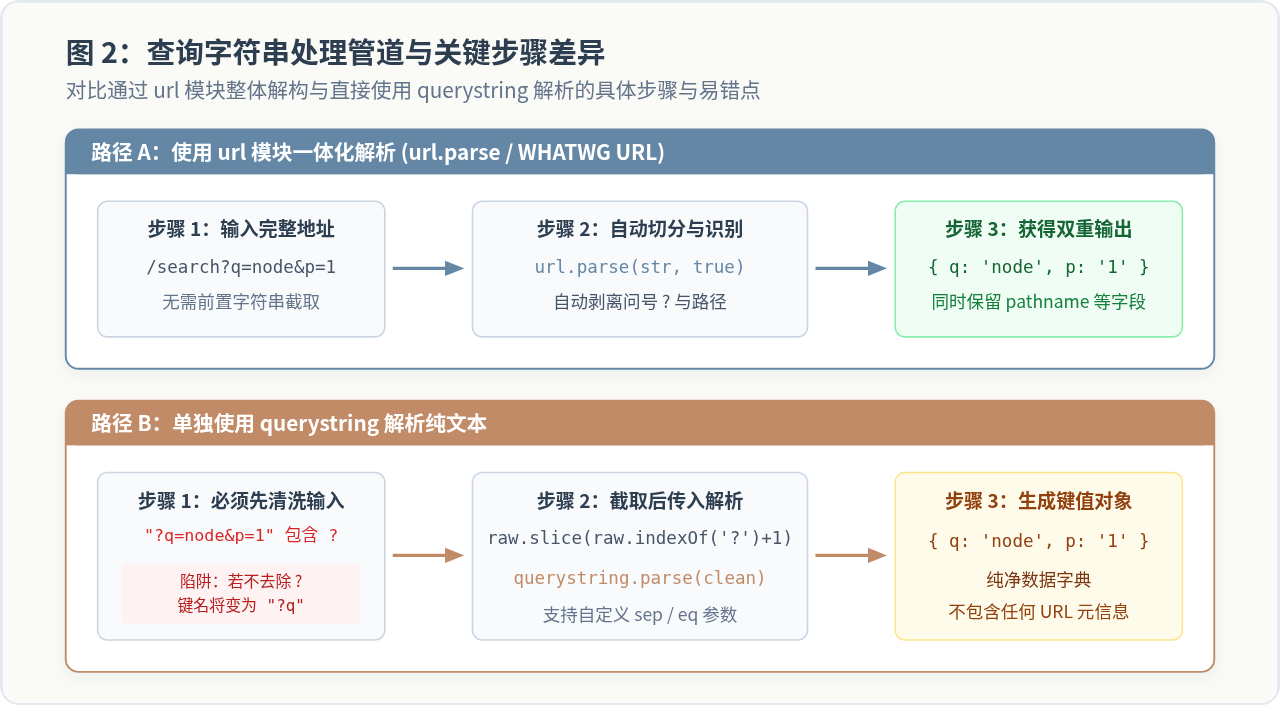
在历史代码或维护遗留系统时,开发者经常见到两种解析路径。我们通过具体的代码示例来观察输入和输出的直接差异。
1. 使用 url 模块处理查询字符串
在旧版 API 中,url.parse() 接收第二个布尔值参数 parseQueryString。若传入 true,该方法在分解 URL 的同时,底层会自动调用查询字符串解析器,将 query 字段直接转换成键值对象;若为 false(默认值),则 query 字段保持为未经解析的原始字符串。
const url = require('url');

// 示例输入:完整的相对请求路径
const rawRequestUrl = '/api/v1/articles?category=backend&tag=nodejs&tag=javascript';

// 第二个参数传 true,指示解析 query
const parsed = url.parse(rawRequestUrl, true);

console.log('pathname:', parsed.pathname);
console.log('query 对象:', parsed.query);
console.log('tag 参数类型:', Array.isArray(parsed.query.tag));
运行结果示例:
pathname: /api/v1/articles
query 对象: [Object: null prototype] { category: 'backend', tag: [ 'nodejs', 'javascript' ] }
tag 参数类型: true
2. 使用 querystring 模块处理查询字符串
querystring.parse() 必须直接传入纯参数文本。如果输入的文本中包含了前导问号 ?,或者包含了路径前缀,解析就会产生非预期的脏数据。
const querystring = require('querystring');

// 场景 1:错误示范——直接传入带问号的字符串
const badInput = '?category=backend&status=published';
const badResult = querystring.parse(badInput);
console.log('未剥离问号的结果:', badResult);

// 场景 2:规范用法——必须先剥离前导问号
const cleanInput = badInput.startsWith('?') ? badInput.slice(1) : badInput;
const goodResult = querystring.parse(cleanInput);
console.log('正确清洗后的结果:', goodResult);
运行结果示例:
未剥离问号的结果: [Object: null prototype] { '?category': 'backend', status: 'published' }
正确清洗后的结果: [Object: null prototype] { category: 'backend', status: 'published' }location.search 或第三方 Webhook 获取的查询字符串通常带有前导问号 ?。url.parse 会自动剥离问号,而 querystring.parse 则会严格把第一个等号左侧的所有字符视作键名,直接导致 result.category 为 undefined,只能通过 result['?category'] 读到值。
三、核心机制与边缘行为对比
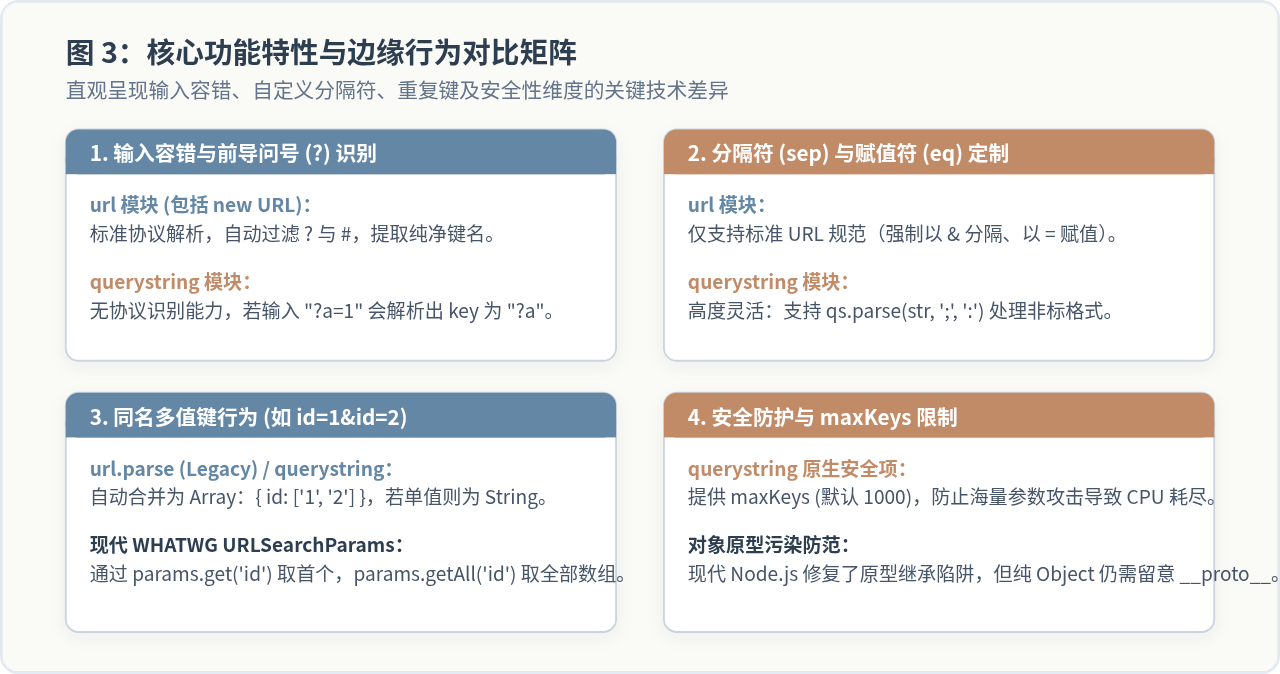
除了输入范围与前导符号处理外,两个模块在参数定制能力、同名参数聚合、编码兼容性以及防御机制上存在着显著区别:
| 对比维度 | url 模块 (url.parse) | querystring 模块 (qs.parse) |
|---|---|---|
| 输入类型 | 完整 URL 绝对地址、相对地址或路径串 | 仅限查询字符串纯文本(不含问号与路径) |
| 分隔符定制 | 仅支持标准规范(以 & 分隔、以 = 连接) |
支持自定义:qs.parse(str, sep, eq) |
| 同名多值键 | 底层调用 querystring,自动转为数组 ['a', 'b'] |
自动合并为数组;若只有一个值则保持为字符串 |
| 最大键数量限制 | 不可直接在 url.parse 传递选项配置 | 支持 maxKeys 配置(默认 1000),防范 Hash 碰撞 DoS |
| 自定义解码函数 | 不支持传入自定义 decode 函数 | 支持传入自定义 decodeURIComponent 覆盖默认解码 |
| 官方维护状态 | Legacy(遗留 API),官方建议迁移 | Legacy(遗留 API),官方建议迁移 |
1. 自定义分隔符的能力
在某些非标准的旧系统协议或特定格式的数据交互中,参数之间可能使用分号 ; 隔开,键值之间使用冒号 : 连接(例如 filter;category:tech;level:senior)。url 模块完全无法解析此类非标文本,而 querystring.parse(str, ';', ':') 可以轻松解耦这类特殊结构:
const qs = require('querystring');
const customData = 'mode:test;flag:1;sort:desc';

const result = qs.parse(customData, ';', ':');
console.log('自定义分隔符解析:', result);
// 输出示例:[Object: null prototype] { mode: 'test', flag: '1', sort: 'desc' }
2. 安全防护与解析深度
querystring.parse() 支持设置 maxKeys(默认最多解析 1000 个键)。这一机制最初是为了防范恶意的 Hash 碰撞拒绝服务攻击(Hash Collision DoS)。如果客户端上传超长且包含数万个参数的请求体,querystring 会在达到上限时直接截断,避免 Node.js 主线程在哈希计算上发生阻塞挂起。
四、规范演进与现代 WHATWG 替代方案
为什么 Node.js 官方不再推崇旧版 url.parse() 与 querystring?
在 Node.js 早期,浏览器与服务端对于 URL 的解析并没有一份极其严格且统一的规范实现。Node.js 旧版 url 模块的内部实现使用了大量的正则表达式和宽松的字符串拆分,这在过去曾引发多次安全隐患(如主机名混淆、认证绕过与 CVE 漏洞)。同时,querystring 的行为也与浏览器内置标准存在细微出入。
为了解决标准分裂和跨平台一致性,Node.js 全面引入了 WHATWG URL 标准。在现代 Node.js(Node 10+,当前 LTS 版本原生标配)中,URL 和 URLSearchParams 已经是挂载在全局作用域的顶级类,无需任何 require 即可直接调用。
1. 替代 url.parse:使用 new URL()
// 原生全局 WHATWG URL 对象
const myUrl = new URL('https://api.example.com/search?keyword=node&filter=active#results');

console.log('协议:', myUrl.protocol);   // 'https:'
console.log('主机:', myUrl.host);       // 'api.example.com'
console.log('路径:', myUrl.pathname);   // '/search'
console.log('获取参数:', myUrl.searchParams.get('keyword')); // 'node'
2. 替代 querystring:使用 new URLSearchParams()
若只需要处理查询字符串本身,直接实例化 URLSearchParams 即可。它原生支持前导问号容错,同时提供了符合规范的操作迭代器:
// 即使带上前导问号,也能正确解析,无需手动 slice
const params = new URLSearchParams('?title=javascript&sort=asc&tag=web&tag=node');

console.log(params.get('title'));        // 'javascript'
console.log(params.getAll('tag'));       // ['web', 'node'] - 清晰明确的多值处理
console.log(params.has('sort'));         // true

// 序列化输出标准查询串
params.append('page', '2');
console.log(params.toString());          // 'title=javascript&sort=asc&tag=web&tag=node&page=2'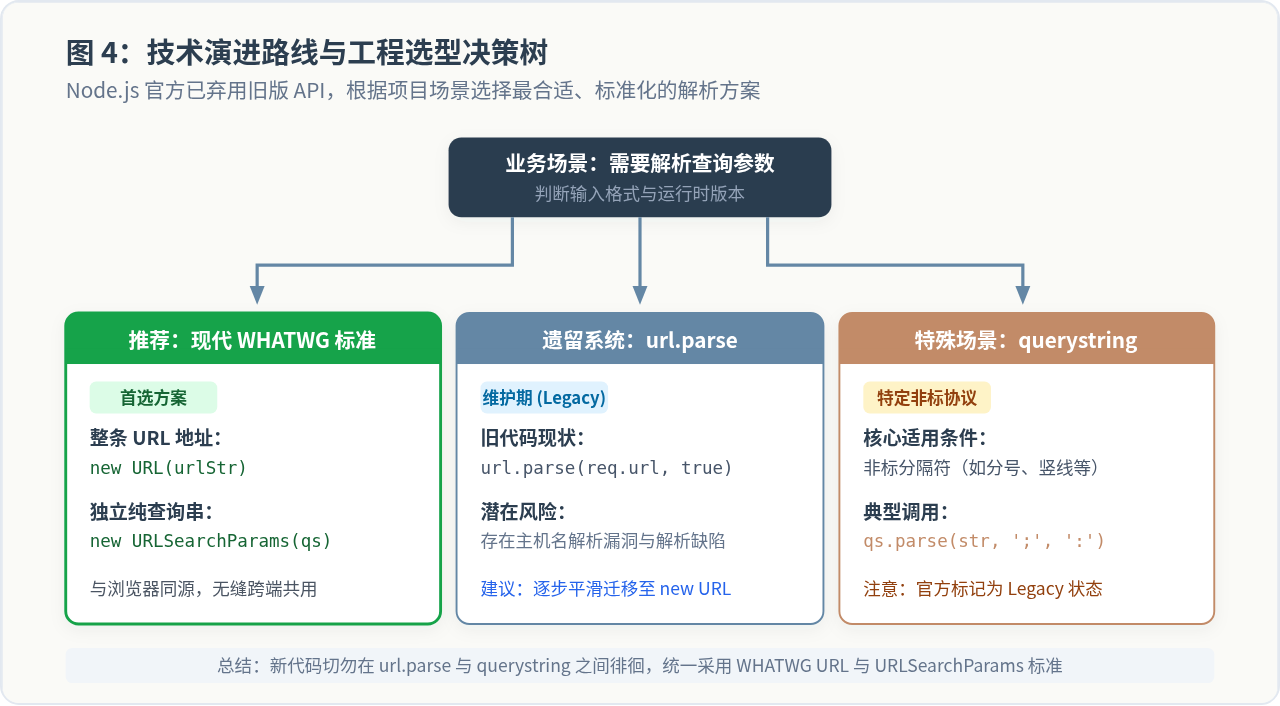
五、工程实践中的选型总结
在面对不同类型的项目与开发任务时,可以根据以下具体条件作出清晰判断:
- 新项目与日常业务开发:统一使用现代
URL和URLSearchParams。它们与浏览器端前端代码标准完全同源,支持无缝前后端共用工具函数,且拥有更严谨的编码标准与更高的安全性。 - 维护存量 Express/Koa 遗留工程:如果代码库中大量使用了
req.query或url.parse(req.url, true),需知晓其底层解析行为,特别是注意同名键会自动变数组的特性;排查请求异常时,优先确认中间件中是否未剥离前导问号导致键名被污染。 - 处理非标准分隔符文本:如果确实需要解析由分号、竖线或自定义符号分隔的古老格式报文,
querystring.parse()的自定义分隔符参数仍然是最便捷的备选工具。
Node.js中使用path模块获取文件名
2026-11-05 15:15:15
JavaScript(JS)主要用来做什么
2026-11-05 10:10:47
怎么修改Node.js和npm的全局安装路径与缓存目录
2026-11-04 19:48:28
NW.js 常见问题排查:Node 模块加载失败与版本兼容解决
2026-11-04 11:22:45
JS获取文件名并去除扩展名的方法
2026-11-04 09:36:27