JavaScript怎么用URLSearchParams获取URL参数
详细介绍在JavaScript中如何使用原生URLSearchParams接口解析和获取URL查询参数,包括基础读取、重名参数处理、键值遍历、自动解码及常见开发陷阱与应对方案。
在现代 Web 开发中,解析浏览器地址栏或特定链接中的查询参数(Query String)已不再需要手写繁琐的正则表达式或进行多次 split('&') 字符串分割。现代 JavaScript 原生提供了 URLSearchParams 接口,能够以标准化、健壮且自带字符解码的方式直接读取、遍历和操作 URL 参数。本文将从快速上手、标准操作流程、核心 API 差异到容易踩坑的边界细节,详细拆解其具体用法。
一、认识 URLSearchParams 与查询字符串
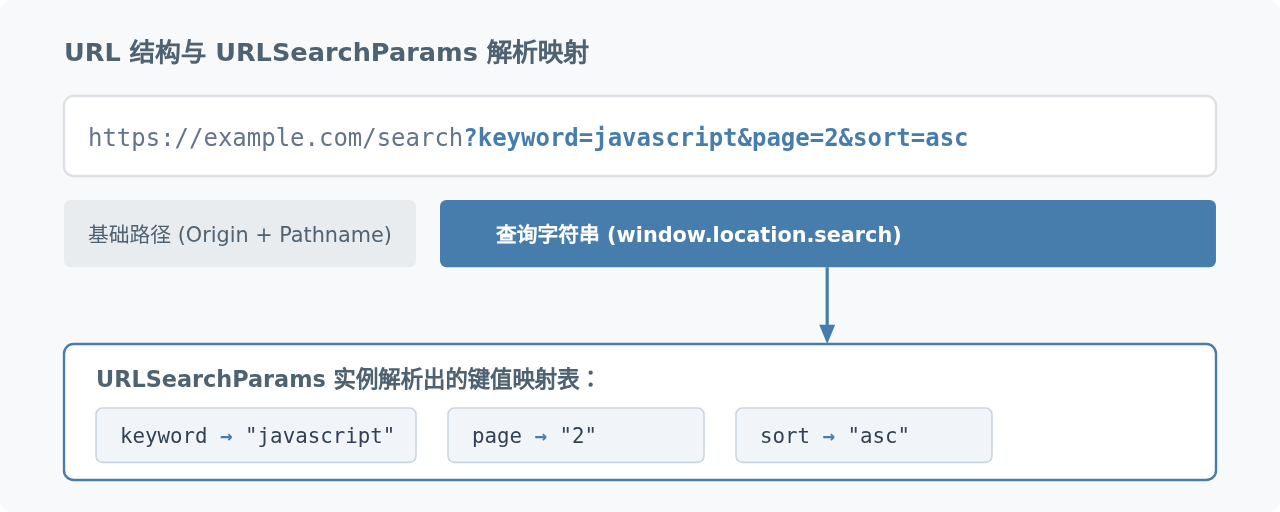
一个标准的 Web URL 通常由协议(protocol)、主机(host)、路径(pathname)和查询字符串(search)等部分构成。查询字符串始于问号 ?,其内部是以 键=值 形式存在并通过 & 连接的键值对。URLSearchParams 的设计目标正是专门接管这串查询字符的解析与键值转换。
二、基础操作:获取 URL 参数的标准步骤
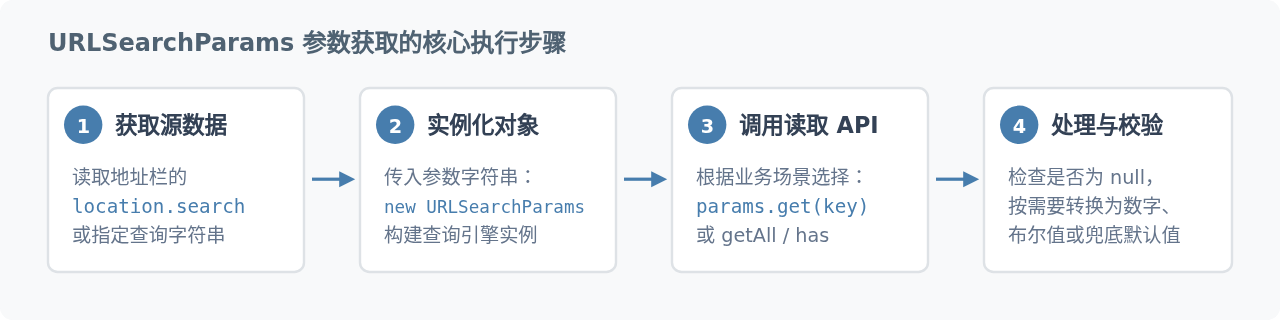
在实际浏览器环境中,用 URLSearchParams 获取参数一般遵循四个关键环节:确定并获取查询字符串、创建实例、调用取值方法、对返回值进行安全与类型处理。
1. 获取当前页面 URL 参数的标准写法
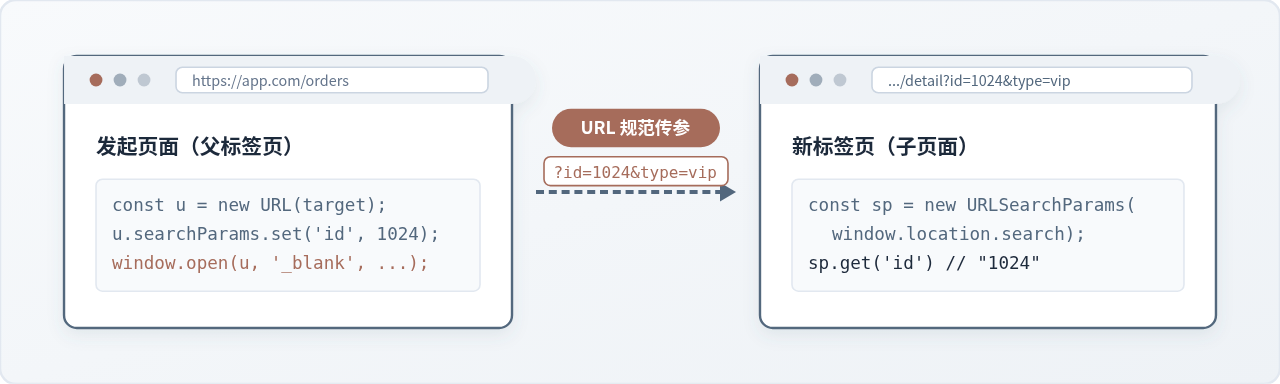
在浏览器页面中,直接通过 window.location.search 即可获取问号及其后的查询字符串。将它直接传递给 new URLSearchParams(),构造函数会自动剥离最前面的问号:
// 假设当前地址为:https://example.com/detail.html?product_id=8921&from=recommend

// 1. 获取查询字符串并实例化
const searchParams = new URLSearchParams(window.location.search);

// 2. 使用 get() 读取指定名称的参数
const productId = searchParams.get('product_id'); // 返回 "8921"
const fromSource = searchParams.get('from');       // 返回 "recommend"

// 3. 读取不存在的参数
const category = searchParams.get('category');    // 返回 null
2. 读取任意完整链接中的参数
如果你手头拿到的是一个完整的外部链接字符串,而不是当前页面的 window.location,最推荐的做法是结合浏览器的 URL 构造函数配合使用:
const targetUrl = 'https://api.service.com/v1/users?role=admin&active=true';

// 推荐方式:通过 new URL() 的 searchParams 属性直接获取
const parsedUrl = new URL(targetUrl);
const role = parsedUrl.searchParams.get('role');     // "admin"
const isActive = parsedUrl.searchParams.get('active'); // "true"
三、核心方法与不同读取场景
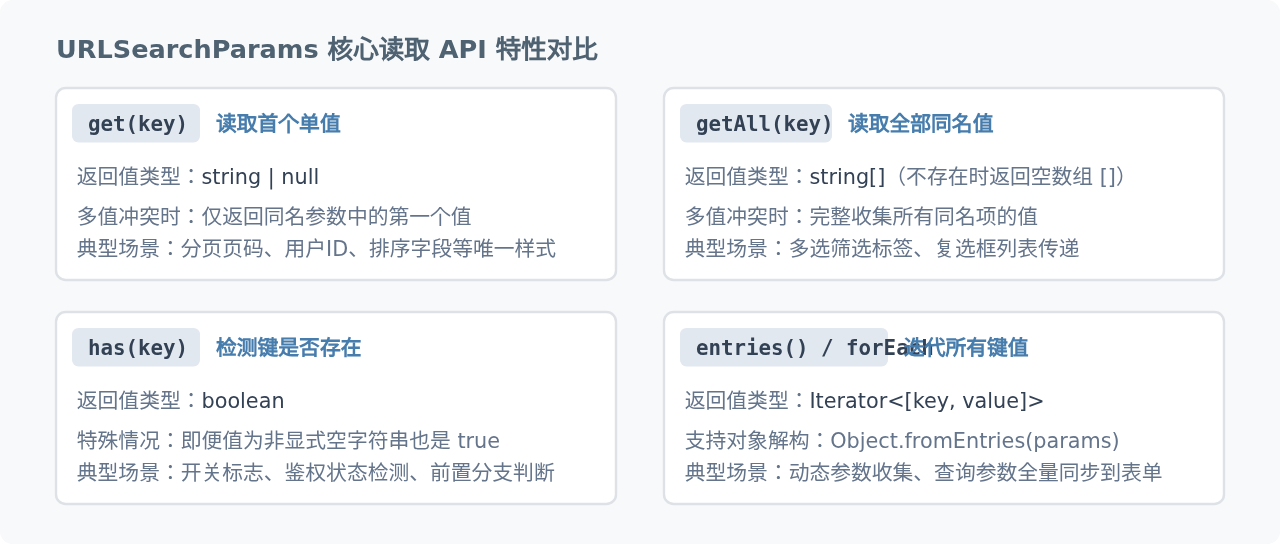
除了最基础的 get() 之外,URLSearchParams 还提供了一组针对不同业务场景的完整 API。理解这些方法的返回值和行为差异,能帮助我们更优雅地处理复杂的 URL 结构。
1. 处理多个重名参数:使用 getAll()
在商品筛选或搜索场景中,URL 经常包含重复的键名,例如 ?tag=javascript&tag=react&tag=css。如果使用 get('tag'),它只会返回第一个 "javascript"。此时必须使用 getAll() 来获取完整的数组:
const query = '?tag=javascript&tag=react&tag=css';
const params = new URLSearchParams(query);

const firstTag = params.get('tag');      // "javascript"
const allTags = params.getAll('tag');    // ["javascript", "react", "css"]

// 如果查询一个完全不存在的参数
const authors = params.getAll('author'); // 返回 [](空数组,而不是 null)
2. 检测参数是否存在:使用 has()
has() 用于判断指定的参数键是否存在于 URL 中。这在判断某些开关型标志位(Flag)时非常便利:
const query = '?debug&mode=simple';
const params = new URLSearchParams(query);

console.log(params.has('debug')); // true(即使没有等号和值,键依然存在)
console.log(params.has('token')); // false
3. 遍历所有参数与快速转换为普通 JavaScript 对象
URLSearchParams 实现了可迭代协议(Iterable),因此支持直接使用 for...of 循环,或者通过 Object.fromEntries() 一键转换为普通键值对对象:
const query = '?city=Beijing&limit=20&offset=0';
const params = new URLSearchParams(query);

// 方式一:for...of 遍历
for (const [key, value] of params) {
  console.log(`${key}: ${value}`);
}

// 方式二:快速转化为普通字面量对象
const paramObj = Object.fromEntries(params.entries());
console.log(paramObj);
// 输出:{ city: "Beijing", limit: "20", offset: "0" }
4. 自动解码特性的便利与保障
在旧有的手动解析代码中,我们常常需要手动调用 decodeURIComponent() 处理转义字符,还容易漏掉将 + 还原为空格。而 URLSearchParams 严格按照规范执行:
- URL 编码的中文(例如
%E5%89%8D%E7%AB%AF)会自动解码为"前端"。 - 查询字符串规范中用于表示空格的
+号,也会被自动转换为空格。
const query = '?search=web+frontend&tag=%E6%8A%80%E6%9C%AF';
const params = new URLSearchParams(query);

console.log(params.get('search')); // "web frontend" (+ 被正确转为空格)
console.log(params.get('tag'));    // "技术" (无需手动 decodeURIComponent)
四、常见开发陷阱与注意事项
URLSearchParams 并不是完整 URL 解析器,它的入参预期是仅包含查询部分的字符串。如果直接写 new URLSearchParams("https://domain.com/index?a=1"),它会将 https://domain.com/index?a 整个前缀误识别为第一个键的名字。因此处理完整 URL 时,务必先通过 new URL(fullUrl).searchParams 或 window.location.search 取出查询段。
无论 URL 中的值写得多么像数字或布尔值,
params.get() 返回的始终是 string 或者 null。params.get('is_vip') 返回的是 "false" 时,在 if ("false") 条件判断中会被当做真值(Truthly)处理!必须进行显式类型转换:
// 错误用法
if (params.get('is_vip')) { ... } // 哪怕 URL 是 ?is_vip=false,此处也会执行!

// 正确用法
const isVip = params.get('is_vip') === 'true';
const pageIndex = Number(params.get('page')) || 1;在采用 Hash 路由模式的单页面应用(如部分 Vue/React 老项目)中,URL 可能会形如
https://domain.com/#/dashboard?userId=123。此时
window.location.search 的值其实是空字符串,因为 ? 位于 #(Hash)之后,浏览器会将其视为 window.location.hash 的一部分。针对这种格式,需要截取 hash 内部的参数串:
// 从 Hash 中提取参数
const hashString = window.location.hash; // "#/dashboard?userId=123"
const queryIndex = hashString.indexOf('?');

if (queryIndex !== -1) {
  const hashSearch = hashString.slice(queryIndex);
  const params = new URLSearchParams(hashSearch);
  console.log(params.get('userId')); // "123"
}
五、总结与使用决策速查
在平时的业务开发中,选择合适的处理路径能避免绝大部分参数读取 Bug。以下是针对各类场景的执行总结与决策流程:
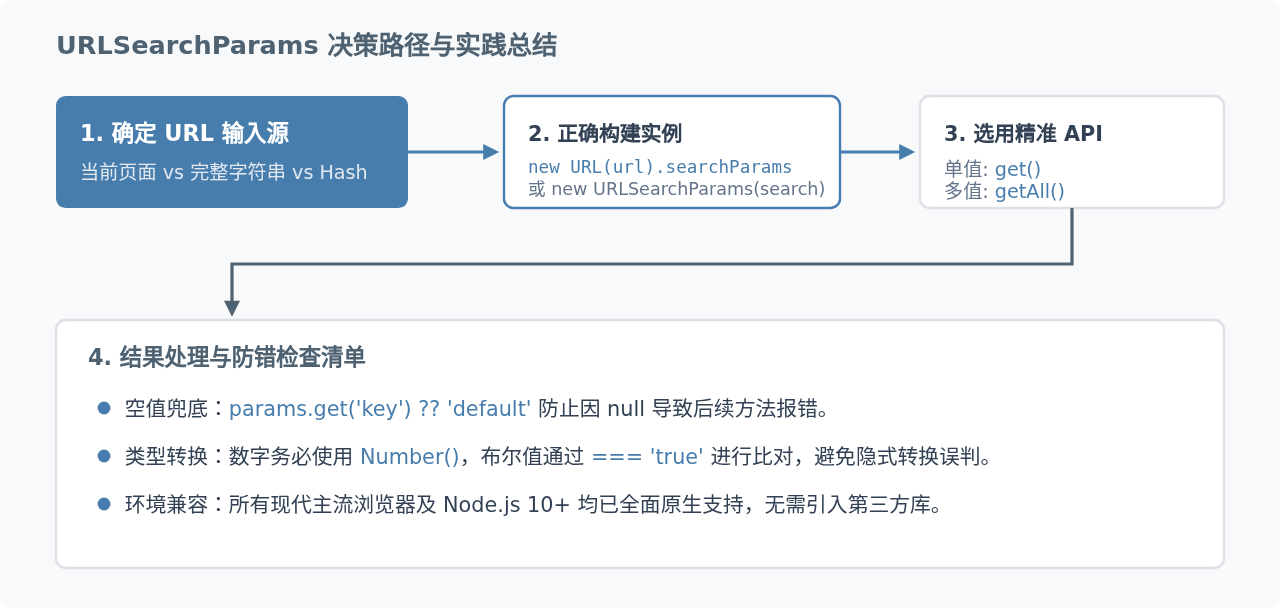
| 场景需求 | 推荐使用方式 | 返回值格式与特性 |
|---|---|---|
| 读取页面单个标准参数 | new URLSearchParams(location.search).get('key') |
返回 string,若不存在则返回 null |
| 读取多选同名参数 | params.getAll('tag') |
返回 string[],若不存在返回空数组 [] |
| 检查某个参数是否存在 | params.has('key') |
返回 boolean,无值参数(如 ?debug)同样为 true |
| 获取所有参数并序列化为对象 | Object.fromEntries(params) |
返回普通 Object 对象,方便解构取值 |
| 解析任意完整 URL 字符串 | new URL(urlStr).searchParams.get('key') |
规避将域名与路径误当成参数名的解析缺陷 |
掌握以上使用细节后,在日常业务中处理分页、搜索筛选、状态跳转或外部渠道追踪等 URL 参数提取任务时,便能以最精简、规范且健壮的原生代码完成需求。
JavaScript零基础入门:从环境搭建到运行第一段代码
2026-11-05 15:29:58
HTML链接中javascript:void(0)的作用及现代替代方案
2026-11-05 10:07:47
在线调试 JS 时怎么引入 jQuery 或 Vue 等第三方库
2026-11-05 08:53:56
原生JavaScript实现简易颜色选择器原理与代码
2026-11-03 23:22:19
JS原生表单序列化:FormData与URLSearchParams用法详解
2026-11-03 23:13:21
相关标签: