JS怎么实现页面强制刷新
深入解析在现代JavaScript中实现页面强制刷新的正确方法。阐明location.reload(true)在现代标准中已被废弃的现状,并提供时间戳穿透与Service Worker缓存清理的完整可运行方案。
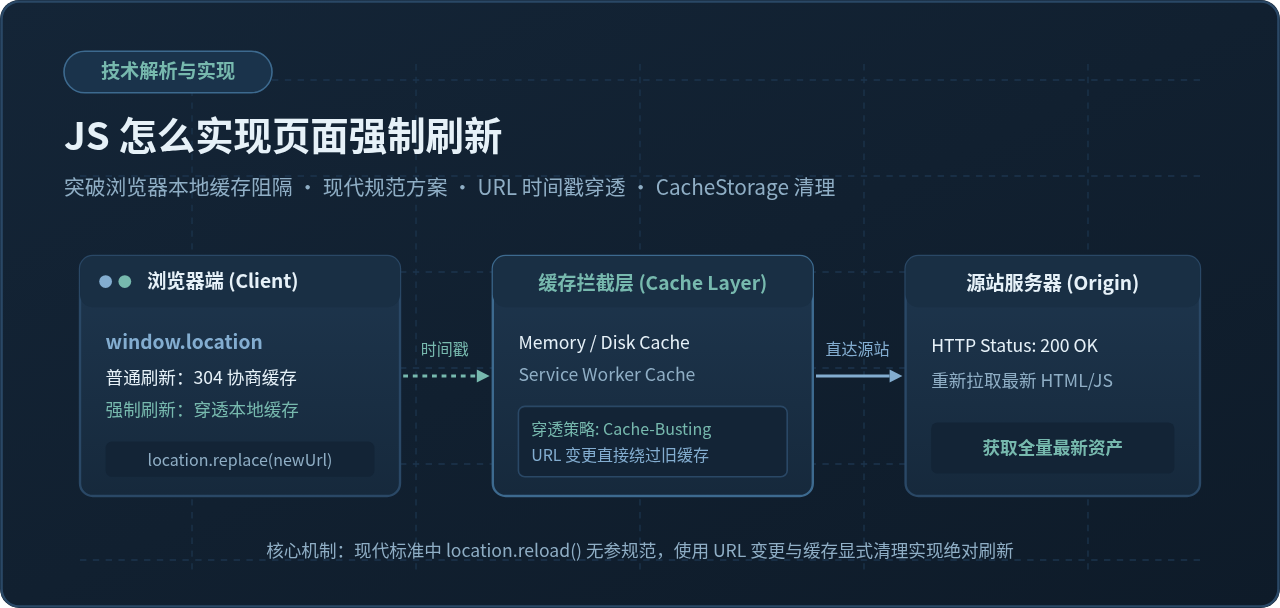
假设你刚刚在服务器部署了前端项目的修复补丁,但部分用户反馈界面依然停留在旧版本;或者你在单页面应用中检测到用户登录凭据失效,需要彻底清除运行态并重新向服务端获取完整的页面资源。在这些具体场景下,开发者通常希望通过 JavaScript 代码直接触发“强制刷新”。
核心答案在于:在现代浏览器规范中,JavaScript 并不存在一个原生、通用且必定绕过 HTTP 磁盘缓存的单行参数方法。历史上常见的 location.reload(true) 早已被 W3C 与 WHATWG 规范废弃,现代浏览器传入该参数仅会执行普通刷新。要真正使用 JavaScript 实现“强制刷新”,当前最可靠的标准方案是基于 URL 的 Cache-Busting 机制(注入动态时间戳并用 location.replace() 导航);若项目中启用了 Service Worker 离线缓存,则必须协同清理 CacheStorage。
一、概念辨析:普通刷新与“强制刷新”的本质差异
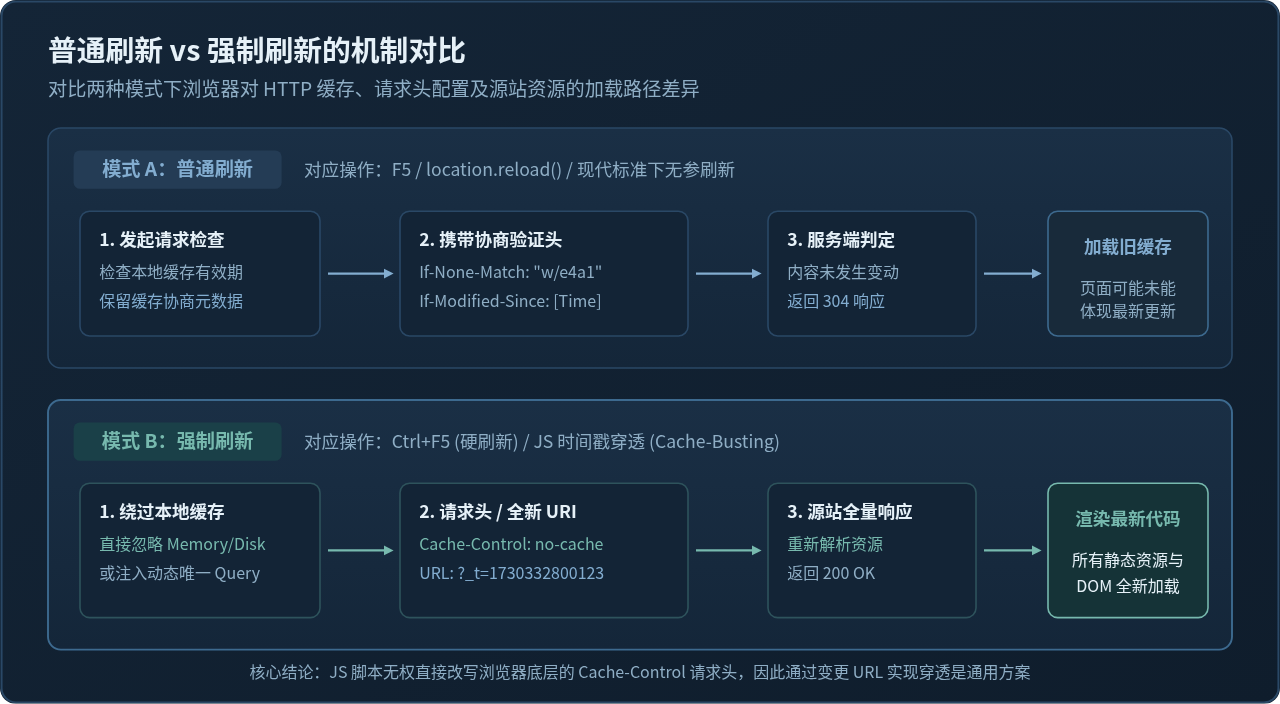
要理解如何用代码实现强制刷新,必须先看清浏览器在处理“刷新”时的底层网络行为。普通用户在键盘上按下的 F5 与 Ctrl+F5(macOS 上为 Cmd+Shift+R),触发的是完全不同的网络协商策略:
- 普通刷新(F5 / 标准
location.reload()):浏览器允许重用已建立的本地缓存。它会根据缓存策略发起条件请求,在请求头中携带If-None-Match(对应服务端的 ETag)或If-Modified-Since(对应最后修改时间)。如果服务端检测到资源未改变,会直接返回304 Not Modified,浏览器继续沿用磁盘或内存中的旧文件。 - 用户端强制刷新(Ctrl+F5 / 硬刷新):浏览器会主动在 HTTP 请求头中添加
Cache-Control: no-cache和Pragma: no-cache,并剔除所有条件协商头。这相当于通知沿途的所有代理服务器和源站服务器:“不要给我任何缓存,完整重新发送一份最新的 200 响应”。
浏览器的安全模型对运行在沙箱中的普通 JavaScript 做了严格限制:页面内的脚本无法直接篡改浏览器底层网络栈发送的受限请求头(如强制插入 Cache-Control 导航头)。因此,JavaScript 无法凭空在协议层“模拟”用户按下硬刷新的快捷键,必须借助语义等价的方式迫使浏览器丢弃旧缓存。
二、历史误区:为什么 location.reload(true) 不再有效?
在许多早期的教程或遗留代码库中,你常常能看到类似 location.reload(true) 的写法。其背后的设计初衷是:早期的部分浏览器(如老版本 Firefox 与 Netscape)提供了一个非标准的布尔参数 forceGet,当传入 true 时,尝试要求客户端重新向服务端发送 GET 请求。
然而,这一参数从未成为标准规范。在 WHATWG 维护的现行 HTML Living Standard 中,Location.reload() 被明确定义为不接受任何参数的方法:
// WHATWG 规范标准定义
[Exposed=Window]
interface Location {
  [CEReactions] void reload();
};
现代浏览器(包括 Google Chrome、Apple Safari、Microsoft Edge 以及现代版本的 Firefox)已全面严格遵循该规范。如果在现代浏览器中执行:
// 现代浏览器中的实际表现:
location.reload(true); // 参数 true 会被引擎直接忽略,等同于 location.reload()现代浏览器不会对 location.reload(true) 抛出运行时错误,但传入的布尔值会被静默忽略。它的执行效果与普通无参 location.reload() 完全一致,依然会命中 304 协商缓存或强缓存。如果你期望通过传参 true 解决线上用户的缓存残留,该方案已经完全失效。
三、现代可靠方案:基于 URL 时间戳的缓存击穿 (Cache-Busting)
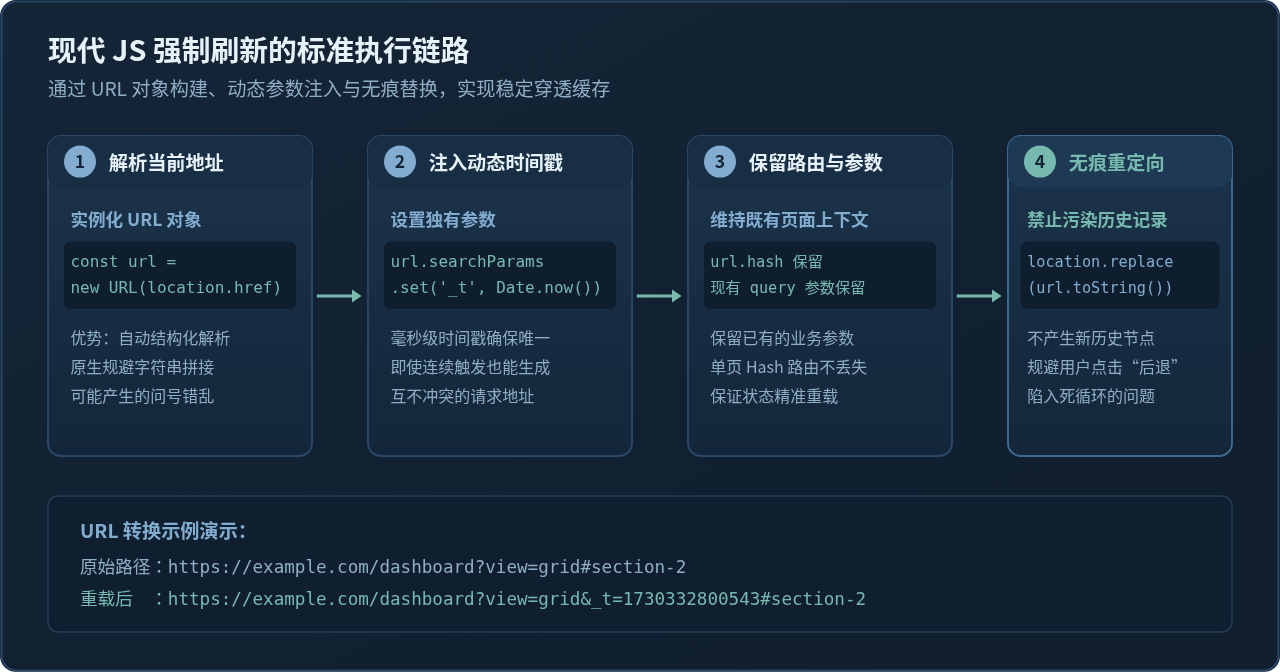
既然无法直接改写导航请求头,最符合现代 Web 标准且跨浏览器完全一致的做法,是让请求的 URL 发生变化——即 Cache-Busting(缓存击穿)技术。
浏览器在管理 HTTP 缓存时,是以完整的请求 URI(包括查询参数 Query String)作为缓存索引键(Cache Key)的。当我们在 URL 的参数中注入一个全新的毫秒级时间戳或唯一随机数时,浏览器会判定该资源为一个从未访问过的全新地址,从而彻底绕过现有的本地 Disk Cache 与 Memory Cache,向服务端索取 200 OK 的新鲜内容。
完整代码实现
在编写该逻辑时,有两处细节至关重要:
- 优先使用现代
URL与URLSearchParamsAPI:避免原始字符串切分或正则替换,确保自动保留原有的查询参数以及前端路由所需的hash锚点。 - 使用
window.location.replace()代替window.location.href:replace()会替换当前的历史记录条目,而不是追加一条新记录。这样可以防止用户在强制刷新后点击浏览器的“后退”按钮时,又退回到带旧时间戳的页面从而陷入循环。
/**
 * 现代标准:基于时间戳的页面强制刷新
 * @param {string} paramKey 注入的缓存击穿参数名,默认 '_force_reload'
 */
function forceReloadPage(paramKey = '_force_reload') {
  // 1. 基于当前地址构造标准 URL 对象
  const currentUrl = new URL(window.location.href);

  // 2. 注入或更新高精度动态时间戳
  currentUrl.searchParams.set(paramKey, Date.now().toString());

  // 3. 使用 replace 替换当前历史记录并触发重新导航
  window.location.replace(currentUrl.toString());
}
下面是一个可用于生产环境、包含重复触发保护的更完善封装:
// 实际执行示例
function performHardReload() {
  try {
    const url = new URL(window.location.href);

    // 生成毫秒时间戳加随机数,杜绝并发调用重叠
    const uniqueToken = Date.now() + '_' + Math.random().toString(36).slice(2, 7);
    url.searchParams.set('_t', uniqueToken);

    // 维持 hash(对 Vue Router / React Router Hash 模式非常关键)
    // URL 对象在序列化为 toString() 时会自动附带现有 hash
    window.location.replace(url.toString());
  } catch (error) {
    // 降级保护:若极端环境下 URL 构造失败,退回普通重载
    window.location.reload();
  }
}

// 触发强制刷新
// performHardReload();使用标准 new URL() 构建时,hash 部分会被完整保留在 URL 末尾。例如原地址为 https://app.com/?tab=1#/detail/5,添加时间戳后会精确变为 https://app.com/?tab=1&_t=1730332800000#/detail/5,不会破坏基于 Hash 的前端路由状态。
四、进阶场景:Service Worker 与 CacheStorage 的彻底清理
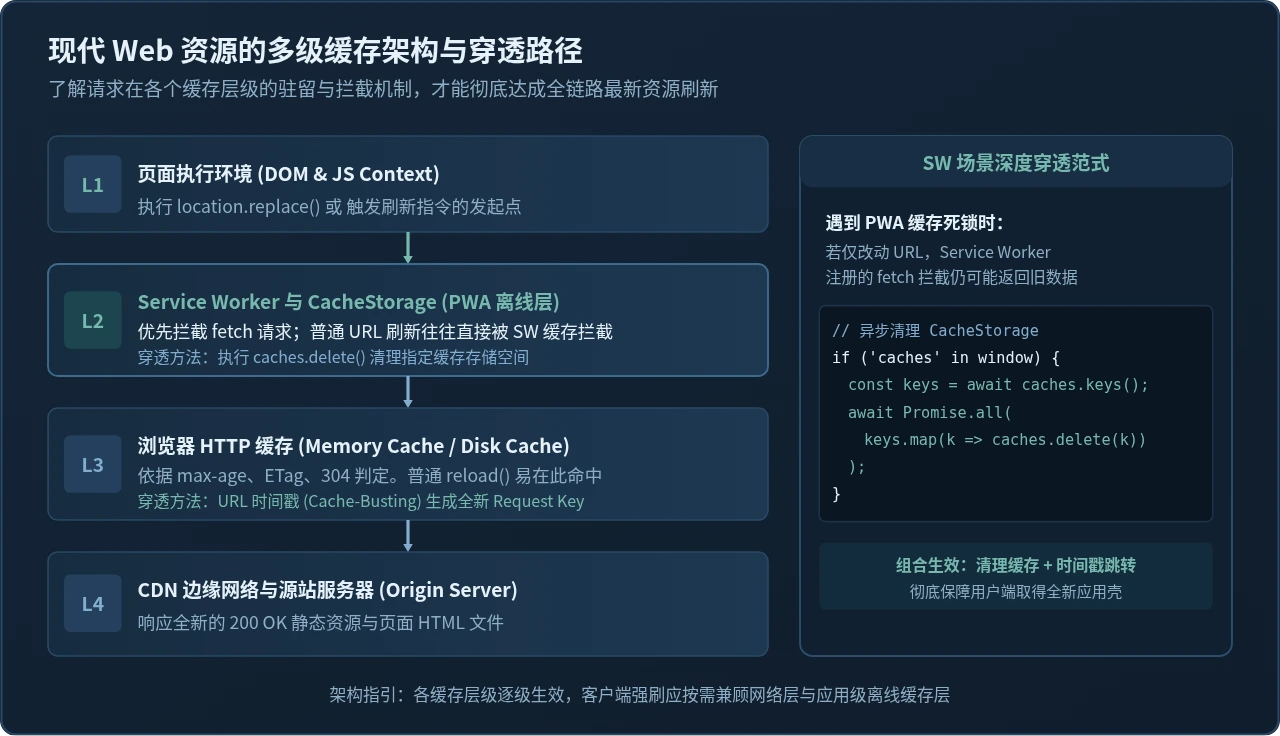
如果你的应用是一套渐进式 Web 应用(PWA),或者在构建中引入了 Workbox / Service Worker,单纯在页面中修改 URL 参数可能依然无法拿到最新资源。这是因为 Service Worker 的运行优先级高于浏览器标准 HTTP 缓存层:
Service Worker 会拦截页面发起的所有 fetch 请求。许多离线优先(Cache-First)策略会先在 CacheStorage 中匹配页面入口(如 index.html),只要匹配到离线缓存,就不会向网络发出请求。
结合 Service Worker 缓存清理的深度强刷
在此类应用中,强制刷新的正确流程应为:先清空 CacheStorage 存储,再要求 Service Worker 实例立即更新,最后执行页面重定向:
/**
 * 包含 Service Worker 与 CacheStorage 清理的深度强制刷新
 */
async function forceReloadPWA() {
  // 第一步:清空 CacheStorage 中保存的全部离线缓存条目
  if ('caches' in window) {
    try {
      const cacheNames = await caches.keys();
      await Promise.all(
        cacheNames.map(name => {
          return caches.delete(name);
        })
      );
    } catch (e) {
      // 容错处理:不阻断后续导航
    }
  }

  // 第二步:触发所有已注册 Service Worker 的强制更新检查
  if ('serviceWorker' in navigator) {
    try {
      const registrations = await navigator.serviceWorker.getRegistrations();
      for (const registration of registrations) {
        await registration.update();
      }
    } catch (e) {
      // 容错处理
    }
  }

  // 第三步:结合 URL 时间戳完成无痕刷新
  const url = new URL(window.location.href);
  url.searchParams.set('_pwa_refresh', Date.now().toString());
  window.location.replace(url.toString());
}
五、工程化视角:前端强制刷新 vs 服务端缓存策略
需要客观认识到:在客户端使用 JS 代码频繁进行强制刷新,通常是对系统缓存设计缺陷的一种补救手段。在健壮的现代 Web 架构中,页面的更新应当由工程化构建与 HTTP 协议协同完成,而不是依赖客户端强刷脚本。
行业标准的防缓存设计规范
-
HTML 入口文件:强协商,永不强缓存
在 Nginx、Apache 或 CDN 配置中,必须确保 HTML 文件绝不设置长期的max-age:
当 HTML 不被强缓存时,用户每次普通刷新都会向服务器验证 HTML,只要有新部署,立刻能拉取到最新的 HTML。# 针对 index.html 等 HTML 入口文件的 Nginx 配置 location ~* \.html$ { add_header Cache-Control "no-cache, no-store, must-revalidate"; add_header Pragma "no-cache"; expires 0; } -
JS 与 CSS 静态资产:基于内容哈希(Content Hash)的长期缓存
现代构建工具(如 Vite、Webpack、Rollup)会自动给编译出的 JS/CSS 文件名注入内容哈希(例如app.b8c2d1.js)。当业务逻辑发生变动,文件名必然变更;新的 HTML 指向新的文件名,浏览器自然会请求全新文件,从根本上杜绝了 JS 缓存冲突。 -
应用内部的版本检查与温和通知机制
单页面应用在用户不关闭标签页长期使用时,前端工程可以通过定时轮询version.json或监听 WebSocket 事件。当发现服务端构建时间更新时,在页面右下角弹出提示:“系统有新版本可用,[点击立即更新]”,由用户主动触发performHardReload(),体验远优于突兀的自动刷屏。
六、常见刷新方式对比与选型指南
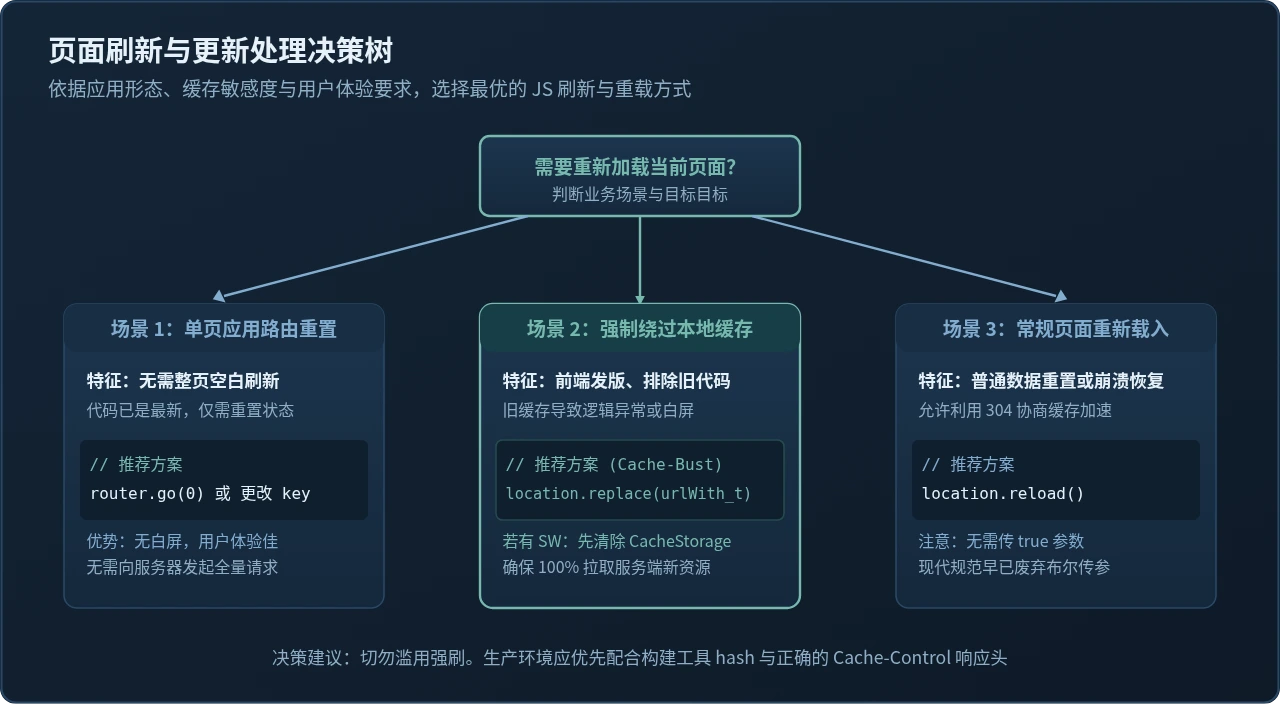
为了帮助读者根据不同的业务诉求准确选择实现方式,下表对前端常见的几种刷新技术进行了横向对比:
| 实现方式 | 代码示例 | 是否穿透 HTTP 强缓存 | 对历史记录的影响 | 主要适用场景 |
|---|---|---|---|---|
| 时间戳替换(推荐) | location.replace(newUrlWithTimestamp) |
是(因 URL 变化生成新 Cache Key) | 无影响(直接替换当前条目) | 前端更新后强制重新加载、解决旧代码逻辑异常 |
| 标准页面重载 | location.reload() |
否(遵循普通 304 协商缓存) | 无影响(在当前页面重载) | 常规页面数据重置、临时错误重试 |
| 废弃语法(不推荐) | location.reload(true) |
否(参数被忽略,等同普通重载) | 无影响 | 旧代码遗留,现代开发中应停止使用 |
| History 重载 | history.go(0) |
否(等同普通重载) | 无影响 | 部分老旧跨端框架或 WebView 兼容写法 |
| PWA 组合清理 | caches.delete() + 变更 URL |
是(兼顾离线层与网络层) | 无影响 | 启用了 Service Worker / 离线包的渐进式 Web 应用 |
七、常见问题答疑 (FAQ)
1. 在 URL 后面追加时间戳会不会导致 CDN 缓存穿透,加大服务器负载?
是的,这正是 Cache-Busting 的双刃剑效应。如果全网数万并发用户在同一时刻因为脚本逻辑添加了各自不同的毫秒时间戳,CDN 无法将这些不同的 URL 合并为一个缓存对象,所有请求都会直接打到源站服务器。因此,动态时间戳刷新只应在用户遇到错误、主动点击“更新版本”等低频特定场景下触发,切勿将其作为页面初始化的常规流程。
2. 单页面应用(Vue/React)只想重置当前页面数据,有必要整页强制刷新吗?
没有必要。整页刷新会导致浏览器重新解析 HTML、重新下载并编译整个 JavaScript Bundle,伴随明显的白屏与卡顿。如果仅仅是想恢复初始状态:
- 在 Vue 中:可以利用
<router-view :key="$route.fullPath"/>重新挂载组件,或者通过 Pinia/Vuex 的$reset()方法恢复初始状态。 - 在 React 中:通过修改根组件的
key属性强制卸载并重挂载子树,即可在纯内存中完成“组件级刷新”,保留极速响应体验。
3. 刷新后 URL 里多了一个 _t 参数,如何优雅地去掉它?
如果业务对 URL 的整洁度有要求,可以在页面重新加载完毕后,通过 HTML5 的 history.replaceState() 悄悄将 _t 参数抹去,这不会触发再次刷新:
// 页面加载完成后清理时间戳参数
window.addEventListener('load', () => {
  const currentUrl = new URL(window.location.href);
  if (currentUrl.searchParams.has('_t')) {
    currentUrl.searchParams.delete('_t');
    // 使用 replaceState 静默更新地址栏,不触发导航与刷新
    window.history.replaceState({}, document.title, currentUrl.toString());
  }
});
核心要点总结
实现“JS 页面强制刷新”的核心要点可以凝练为以下三条原则:
- 认清标准现状:
location.reload(true)已被现代规范完全废除,不要再依赖它来绕过缓存。 - 掌握通用方案:使用
new URL()注入唯一时间戳,并使用window.location.replace()导航,是当前兼容性最好、能够 100% 穿透本地 HTTP 缓存的纯前端解法。 - 注重工程治理:真正的无缝更新应靠 HTML 的
no-cache策略与构建工具的资产指纹(Content Hash)协同解决,从根本上减少前端依赖强刷的频次。
点击JS链接直接运行不下载?前端实现.js文件强制下载的三种方法
2026-11-05 12:12:23
怎么封装一个通用的JS创建元素辅助函数
2026-11-05 11:41:41
Swiper.js 怎么监听滑动结束并获取当前索引
2026-11-05 10:57:15
HTML、CSS和JS的关系:Web前端三件套怎么协作
2026-11-04 15:41:40
JS动态创建a标签模拟点击与window.open打开新标签页的区别
2026-11-04 12:10:54