突破浏览器并发限制:JavaScript提升并行下载速度的技巧
深入解析浏览器同源并发请求限制机制,结合JavaScript异步控制、域名分片、HTTP/2多路复用与大文件Range分片切片,系统介绍提升浏览器并行下载速度的实用技巧与代码实践。
在前端应用中同时发起大量文件下载或资源拉取时,请求往往不会同时开始传输,而是在网络面板中呈现出明显的排队等待(Queueing)状态。这是因为主流浏览器在 HTTP/1.1 协议下对同一域名设置了并发连接数限制(通常为 6 个)。要提升整体并行下载吞吐量,核心路径在于:前端通过调度池精确控制请求节奏,配合 HTTP/2 多路复用、多域名分片(Domain Sharding)、Range 分片下载以及 Web Worker 离网处理,将带宽利用率与 CPU 处理能力发挥到极致。
一、浏览器同源并发限制的底层机制与表现
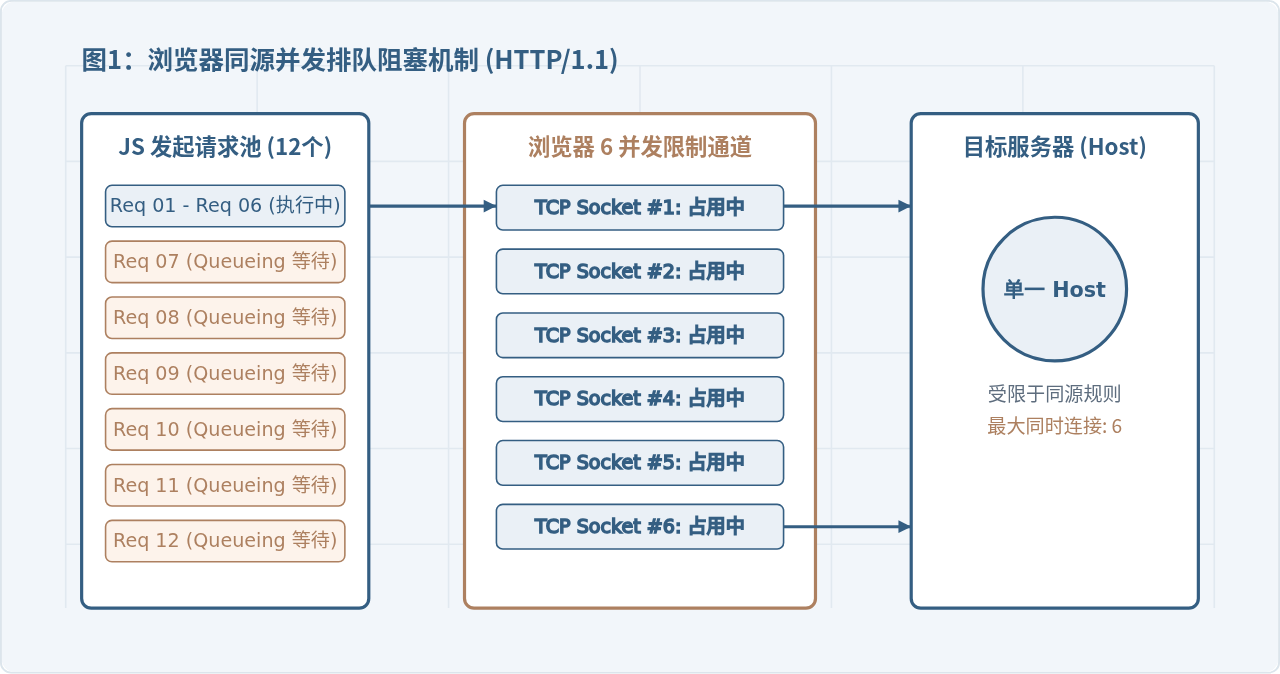
当客户端向同一个域名发起数十个 HTTP/1.1 请求时,浏览器底层只会为该 Host 打开最多 6 个 TCP 连接。超出数量的请求会被压入浏览器的连接队列,处于 Stalled 或 Queueing 状态,直到前序连接完成当前响应并被复用。
这种机制的初衷是避免单一客户端发起大量连接耗尽客户端本地端口及服务器套接字资源,但面对由大量切片、高清图集或批量附件构成的现代 Web 应用时,排队阻塞会导致网络带宽长期处于非饱和状态,显著拉长总等待时间。
二、核心技巧一:域名分片(Domain Sharding)绕过主机限制
浏览器施加的并发上限是针对“协议 + 域名 + 端口”维度的。这意味着,如果将静态资源分布在不同的子域名下(例如 cdn1.example.com、cdn2.example.com、cdn3.example.com),每个子域名均可独立获得 6 个并发通道,整体通道数即可呈倍数扩充。
1. 域名哈希调度算法
在前端通过 JavaScript 批量下载静态图片或数据块时,应使用一致的散列算法将资源 ID 均匀分配给不同的域名节点,避免某一子域名被过度挤占:
// 预设静态资源可用子域名
const CDN_DOMAINS = [
  'https://cdn1.example.com',
  'https://cdn2.example.com',
  'https://cdn3.example.com',
  'https://cdn4.example.com'
];

// 基于文件名或索引计算散列
function getShardedUrl(resourcePath, index) {
  const domainIndex = Math.abs(index) % CDN_DOMAINS.length;
  return `${CDN_DOMAINS[domainIndex]}${resourcePath}`;
}注意:配置域名分片时,子域名必须在服务端配置正确的跨域资源共享(CORS)响应头(如 Access-Control-Allow-Origin: *),否则虽然绕过了连接数限制,但 JavaScript 无法读取返回的二进制数据。
三、核心技巧二:采用 HTTP/2 / HTTP/3 多路复用
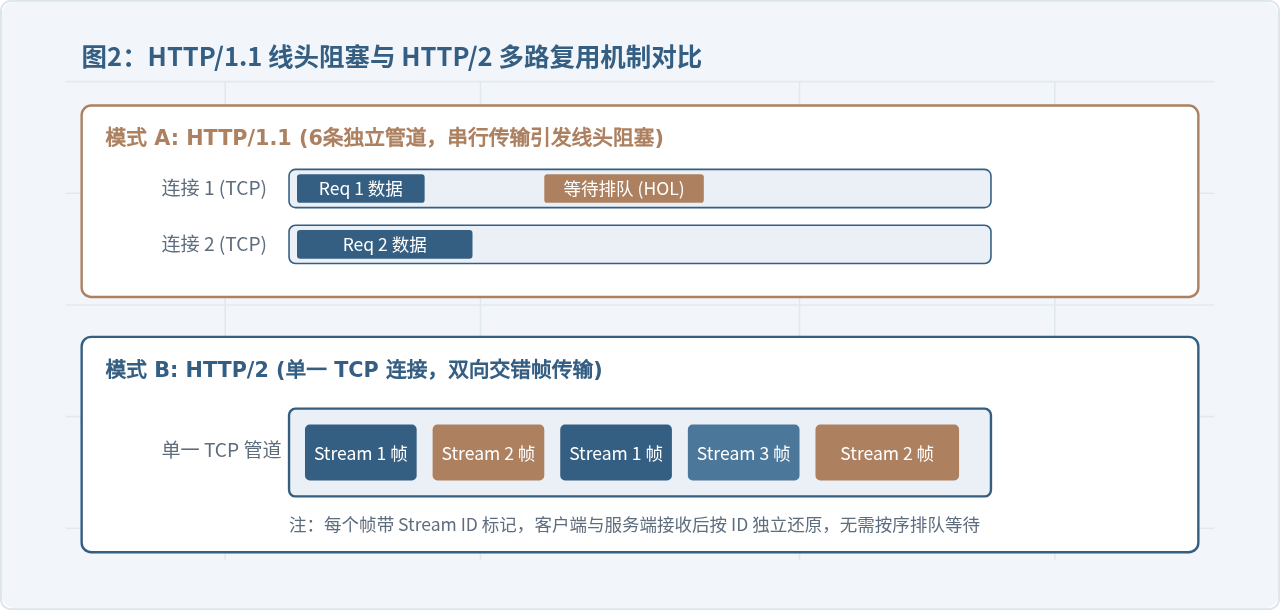
HTTP/2 和 HTTP/3 从协议层重构了传输模型。在 HTTP/2 中,客户端与服务端之间仅需建立一条单一的 TCP 连接,所有请求与响应均被拆分为带有独立流 ID(Stream ID)的二进制帧在同一连接上交错传输。
在开启 HTTP/2 的环境中,浏览器对同一 Host 的请求不再受 6 个 TCP 连接的物理限制,理论上可在一个连接内并发处理上百个数据流。此时无需进行域名分片,反而应当合并域名,消除多域名的 DNS 解析与握手延迟。
四、核心技巧三:JavaScript 大文件 Range 分片切片下载
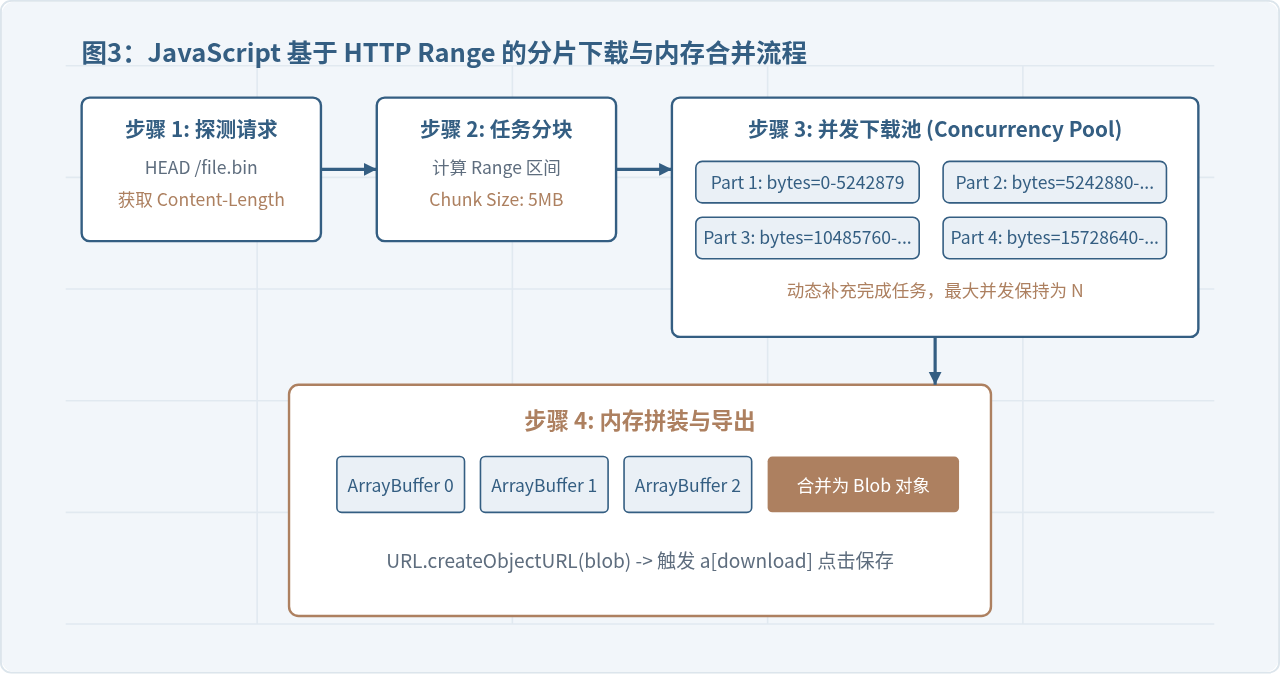
当下载单个超大文件(例如数百兆的文件、离线模型或视频包)时,单连接受限于单 TCP 窗口增长和丢包重传。利用 HTTP Range 协议头,JavaScript 可以在前端将文件逻辑切分为多个 Block,发起并发下载并在内存中拼接合并。
1. 执行步骤分解
- 探针请求(HEAD/GET):向服务器发送 HEAD 请求,检查响应头中的
Accept-Ranges: bytes并读取Content-Length获取文件总字节数。 - 分片划分:根据文件大小计算分片数量(例如每个分片 5MB~10MB)。
- 并发拉取:通过设置请求头
Range: bytes=start-end,并发请求各个分片返回的206 Partial Content。 - 重组与保存:使用
Uint8Array或Blob将所有块按顺序拼接,并通过URL.createObjectURL触发文件下载。
2. 并发下载与合并代码实现
/**
 * 带有并发上限的下载任务执行器
 */
async function parallelDownload(chunks, limit, onProgress) {
  const results = new Array(chunks.length);
  let currentIndex = 0;
  let finishedCount = 0;

  async function worker() {
    while (currentIndex < chunks.length) {
      const index = currentIndex++;
      const chunk = chunks[index];

      const response = await fetch(chunk.url, {
        headers: { Range: `bytes=${chunk.start}-${chunk.end}` }
      });

      if (!response.ok && response.status !== 206) {
        throw new Error(`分片 ${index} 下载失败: ${response.status}`);
      }

      results[index] = await response.arrayBuffer();
      finishedCount++;
      if (onProgress) onProgress(finishedCount, chunks.length);
    }
  }

  // 启动 limit 个工作协程
  const workers = Array.from({ length: Math.min(limit, chunks.length) }, () => worker());
  await Promise.all(workers);

  return results;
}

/**
 * 分片下载大文件并导出
 */
async function downloadLargeFile(fileUrl, chunkSize = 5 * 1024 * 1024, concurrency = 4) {
  // 1. 获取文件大小
  const headRes = await fetch(fileUrl, { method: 'HEAD' });
  const contentLength = headRes.headers.get('content-length');
  if (!contentLength) throw new Error('服务器未提供 content-length 标头');

  const totalSize = parseInt(contentLength, 10);
  const chunks = [];

  for (let start = 0; start < totalSize; start += chunkSize) {
    const end = Math.min(start + chunkSize - 1, totalSize - 1);
    chunks.push({ url: fileUrl, start, end });
  }

  // 2. 并发拉取分片
  const buffers = await parallelDownload(chunks, concurrency, (done, total) => {
    console.log(`进度: ${(done / total * 100).toFixed(1)}%`);
  });

  // 3. 组装并触发浏览器下载
  const blob = new Blob(buffers, { type: 'application/octet-stream' });
  const blobUrl = URL.createObjectURL(blob);
  const anchor = document.createElement('a');
  anchor.href = blobUrl;
  anchor.download = 'downloaded_file.bin';
  anchor.click();
  URL.revokeObjectURL(blobUrl);
}
五、核心技巧四:结合 Web Worker 规避主线程卡顿
当并发下载多个分片并且每个分片达到数兆或数十兆时,主线程执行大量的 ArrayBuffer 读写、解压缩或散列校验容易引发页面掉帧(Jank)。将网络拉取及数据合并逻辑移入 Web Worker 中执行,能够实现网络 I/O 与 UI 渲染的高效隔离。
在 Worker 内部下载完成后,使用 postMessage(data, [data]) 进行可转移对象(Transferable Objects)传递,零拷贝将底层内存指针移交给主线程,实现性能最优化。
六、实践总结与方案选型决策
针对不同的业务场景,突破并发限制的技术方案存在不同的适用条件与边界:
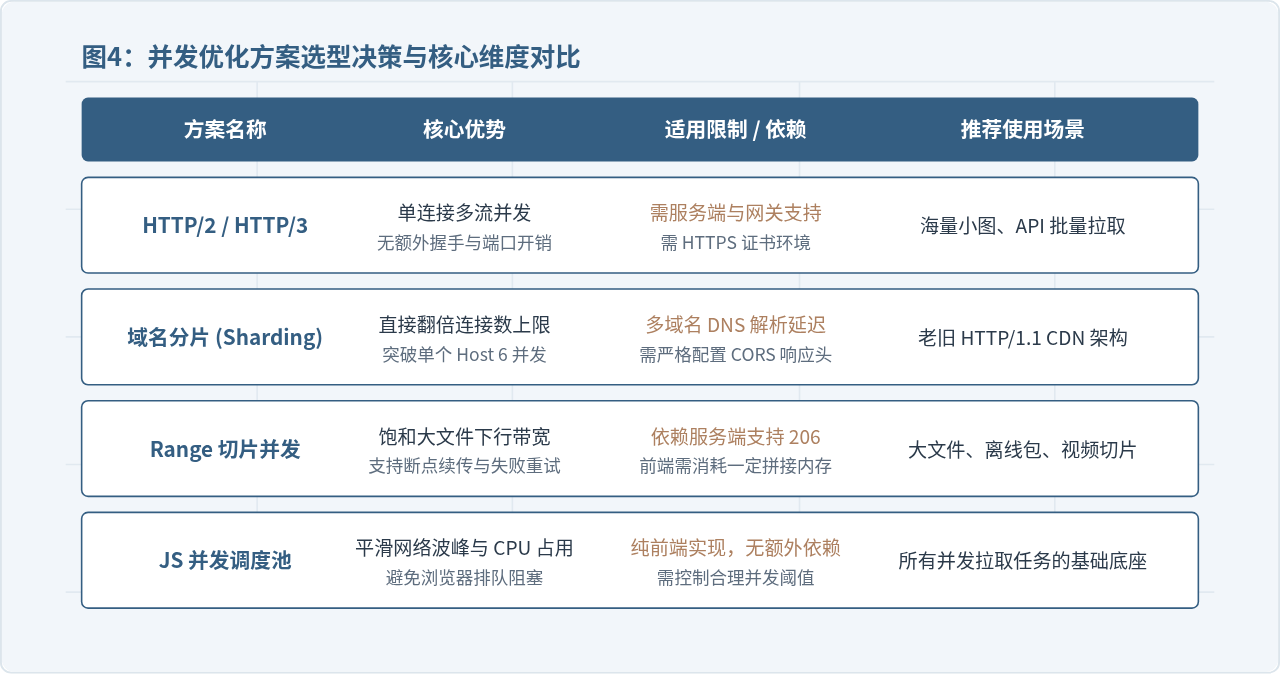
总结而言,在面对现代 Web 应用的大量并行请求时,不要盲目通过 Promise.all 一次性发起数百个请求导致网络阻塞;在基础设施层面,优先开启 HTTP/2 或 HTTP/3 消除同源 6 连接限制;对于超大文件,采用 Range 分片配合前端固定容量的并发池,才能在保证浏览器页面平稳流畅的前提下,最大化利用用户带宽提升整体下载效率。
为什么JS调用reload后页面没有立即更新
2026-11-05 13:38:29
crypto-js 加密结果与 Java/Python 后端不一致怎么解决
2026-11-05 12:09:48
js文件缓存导致代码不更新怎么强制刷新
2026-11-04 22:30:24
JS逆向调试技巧:编写Hook脚本监控加密函数输入输出
2026-11-04 10:42:46
Babylon.js 性能优化技巧:实例化网格与遮挡剔除
2026-11-03 23:43:22