JS Map与Object的区别及选型建议
深入对比 JavaScript 中 Map 与 Object 在键类型、原型污染、遍历顺序、增删性能及序列化方面的底层区别,并提供具体的架构选型建议与决策指南。
Map 与普通 Object 表面上都承担“键值映射”的功能,但两者的底层定位截然不同:Object 本质是语言核心的实体记录与属性载体,天然承载原型链与隐藏类机制;而 Map 是 ES2015 专门为哈希集合与高频动态字典打造的纯粹集合容器。本文从键类型约束、原型污染防范、键值排序、增删性能及序列化生态等核心维度展开对比,并提供可落地的工程选型建议。

一、核心维度对比:Map 与 Object 的本质区别
在 ES2015 之前,开发者普遍使用 {}(Object)作为通用哈希表。随着应用复杂度提升,Object 原生作为“通用字典”暴露出了键类型单一、继承原型链干扰以及缺乏高效统计等缺陷。要准确选型,首先需要掌握两者在六大维度的根本差异:
| 对比维度 | Map (键值集合) | Object (实体与结构体) |
|---|---|---|
| 键的类型 | 支持任意类型:对象、DOM 节点、函数、数字、Symbol 等 | 仅支持 String 与 Symbol;其他类型强制转为字符串 |
| 原型与默认键 | 无默认键,不包含原型链干扰,天然杜绝原型污染 | 默认继承自 Object.prototype,含 toString、constructor 等键 |
| 遍历顺序 | 严格保证按照元素的插入顺序进行迭代 | 优先升序遍历整数索引,再遍历普通字符串键,最后遍历 Symbol |
| 容量统计 | 内置 map.size 属性,直接返回元素数,复杂度为 O(1) |
需调用 Object.keys(obj).length,构建临时数组,复杂度为 O(N) |
| 迭代协议 | 原生实现 Iterable 协议,直接支持 for...of 与解构 |
未实现可迭代协议,需借助 Object.keys() 或 Object.entries() |
| JSON 序列化 | 无内置 JSON 支持,需手动转换为数组或对象结构中转 | 原生受 JSON.stringify() 与 JSON.parse() 完整支持 |
二、底层机制剖析:从键解析到寻址原理
理解为什么不能简单把 Object 当作 Map 替代品,核心在于引擎底层的寻址机制和键转换逻辑。
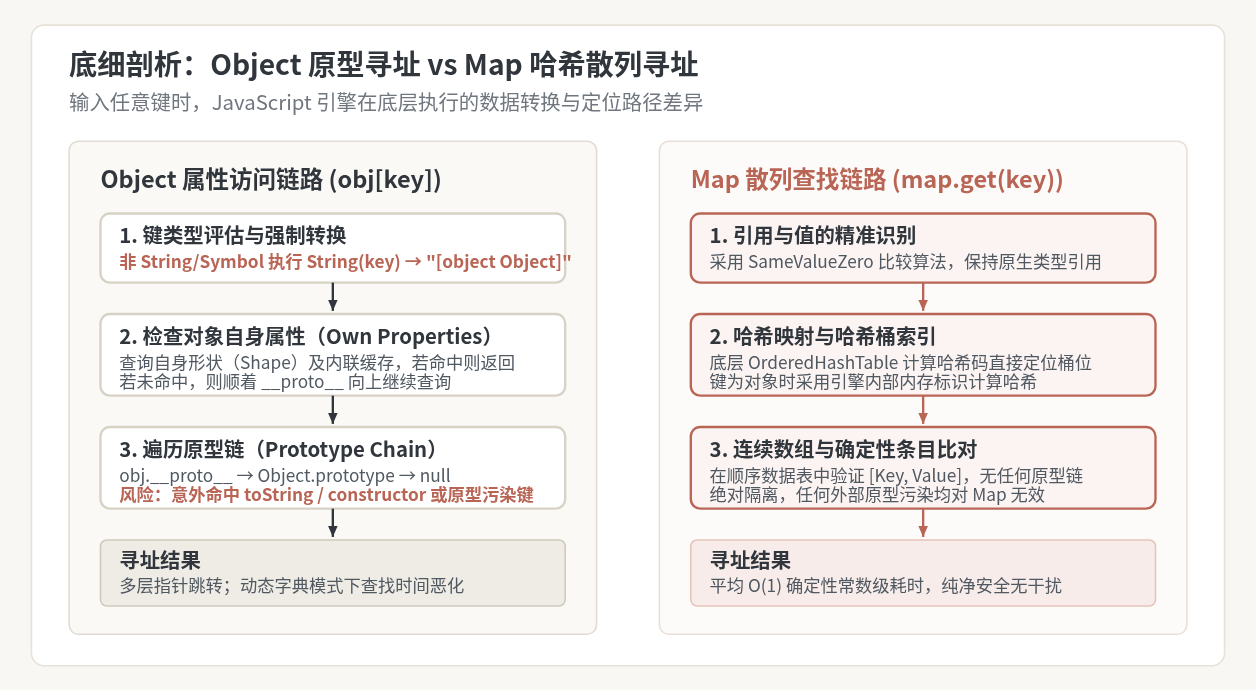
1. 键类型强转引发的“键覆盖”问题
当开发者尝试将复杂对象作为 Object 的键时,JavaScript 会隐式调用其 toString() 方法。普通对象转换后的结果均为固定字符串 "[object Object]",这会导致所有不同的对象键互相覆盖:
// 错误示例:Object 导致键相互覆盖
const obj = {};
const userA = { id: 101, name: "Alice" };
const userB = { id: 102, name: "Bob" };

obj[userA] = "Project Lead";
obj[userB] = "Architect";

console.log(obj[userA]); // 输出 "Architect",userA 被 userB 意外覆盖!
console.log(Object.keys(obj)); // 输出: ["[object Object]"]

// 正确方案:Map 保留对象引用标识
const map = new Map();
map.set(userA, "Project Lead");
map.set(userB, "Architect");

console.log(map.get(userA)); // 输出 "Project Lead"
console.log(map.get(userB)); // 输出 "Architect"
console.log(map.size);       // 输出 2
Map 底层使用 SameValueZero 算法对键进行等值校验。在 Map 中,两个对象键只有在引用指向同一内存地址时才视为相同;同时,NaN 与 NaN 在 Map 中被视为相等,-0 与 +0 也被视为相等。
2. 原型污染(Prototype Pollution)与安全性
普通对象创建时继承自 Object.prototype。如果直接使用未过滤的用户输入作为键(例如解析 URL 参数或表单配置),用户输入诸如 "constructor"、"__proto__" 或 "toString" 时,会产生意外行为甚至引发安全漏洞:
const registry = {};

function checkRole(roleName) {
  if (registry[roleName]) {
    return registry[roleName];
  }
  return "default-role";
}

// 攻击或意外输入触发原型方法
console.log(checkRole("toString")); // 返回 [Function: toString],逻辑被意外旁路!
使用 Map 则完全不存在此类隐患,因为 map.has() 仅检测容器内部实际写入的键,绝对不会向上追溯任何原型属性。
Object.create(null) 创建无原型对象,或者使用 ES2022 的 Object.hasOwn(obj, key) 代替 obj.hasOwnProperty(key) 与 in 操作符。
三、日常操作全流程对比与实践步骤
在日常业务编码中,数据结构的常用操作主要涵盖:初始化、键值写入、读取、判空与尺寸统计、删除和迭代遍历。两者的语法模式存在鲜明的代际差异:
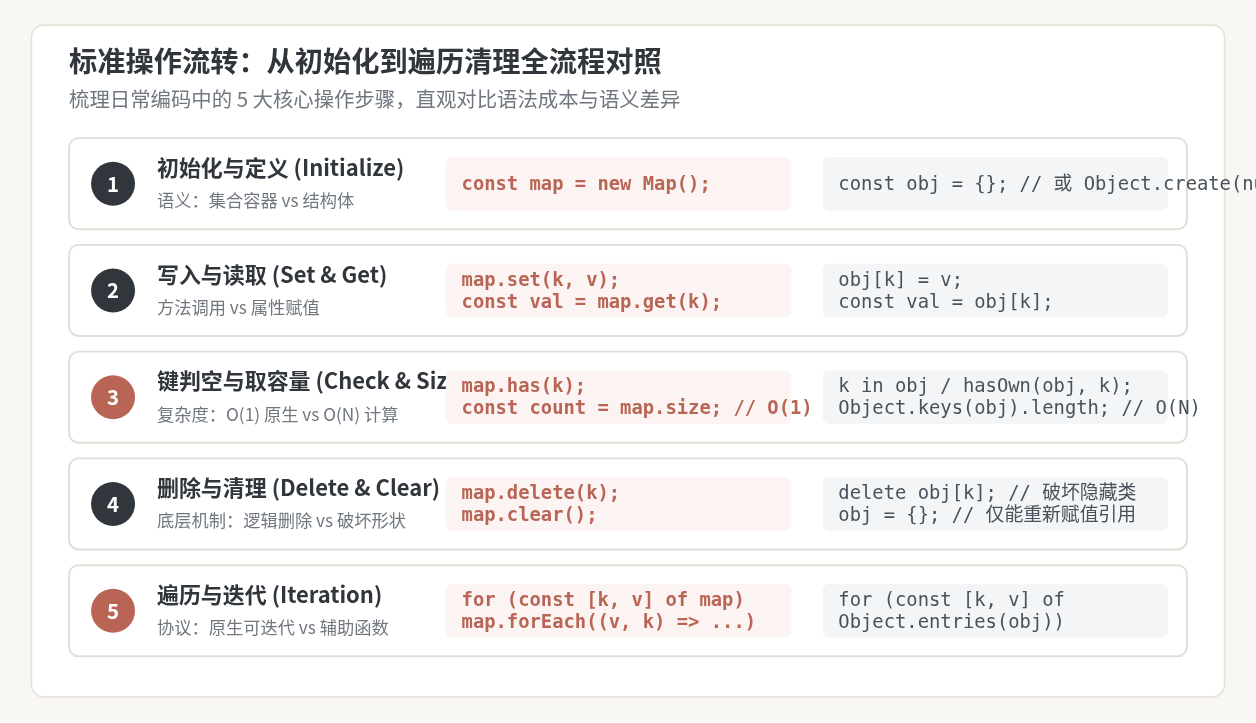
// ==================== 1. 初始化 ====================
const map = new Map([
  ["role", "admin"],
  ["timeout", 3000]
]);
const obj = {
  role: "admin",
  timeout: 3000
};

// ==================== 2. 增改与读取 ====================
map.set("retries", 3);
const mapVal = map.get("retries"); // 3

obj.retries = 3;
const objVal = obj.retries;        // 3

// ==================== 3. 键检测与容量 ====================
const hasRetryInMap = map.has("retries");    // true, O(1)
const mapSize = map.size;                    // 3, O(1)

const hasRetryInObj = Object.hasOwn(obj, "retries"); // true
const objSize = Object.keys(obj).length;     // 3, 需要生成数组,O(N)

// ==================== 4. 删除与重置 ====================
map.delete("retries"); // 成功删除返回 true
map.clear();           // 一键彻底清空

delete obj.retries;    // 删除属性,返回 true
// obj 无法一键清空已有属性,只能重新赋值引用: obj = {};

// ==================== 5. 遍历操作 ====================
// Map 原生可迭代,直接解构键值对
for (const [key, value] of map) {
  console.log(`Map: ${key} -> ${value}`);
}

// Object 需要提取 entries 数组辅助遍历
for (const [key, value] of Object.entries(obj)) {
  console.log(`Obj: ${key} -> ${value}`);
}
四、引擎底层性能机制:隐藏类退化 vs 闭散列表
在性能测试中,很多开发者发现:在小规模、只读的场景下,Object 的属性访问速度甚至略快于 Map;但一旦涉及频繁的动态添加与 delete 删除,Object 的耗时会急剧上升。这种现象源于 V8 等现代 JavaScript 引擎的优化策略。
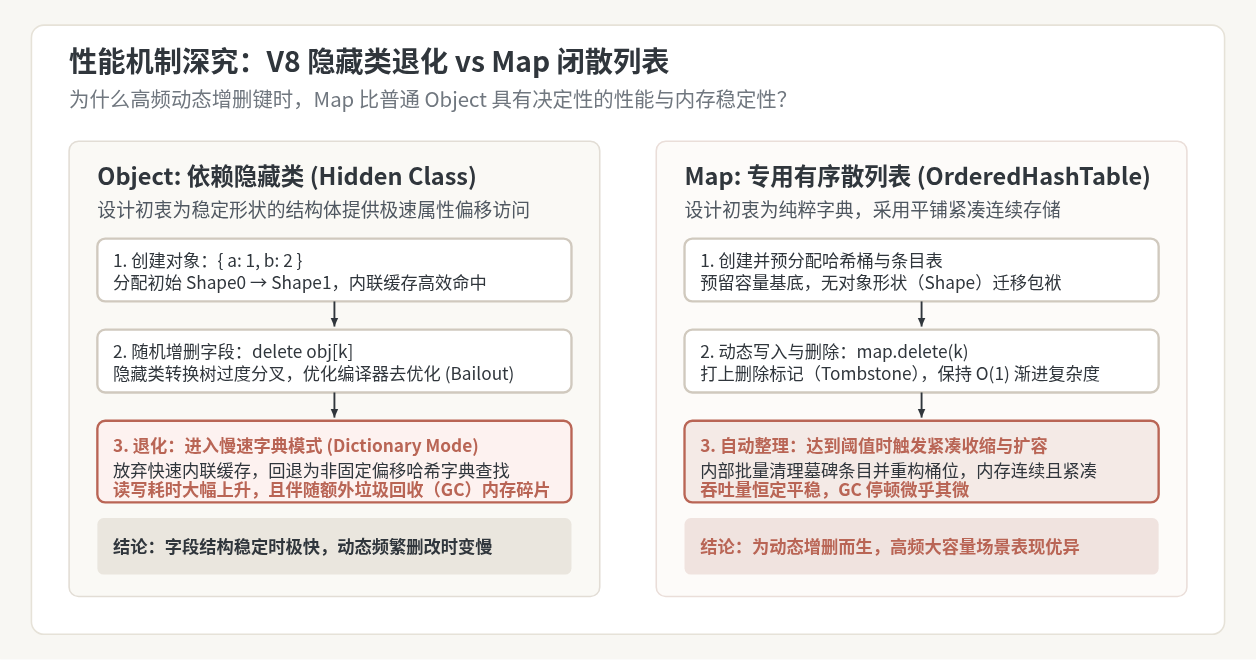
1. V8 隐藏类(Hidden Class)与字典模式(Dictionary Mode)
现代引擎在执行 obj.x 时,依赖对象内部的形状指针(Shape / Map)和内联缓存(Inline Cache)。当对象属性结构固定时,引擎可以将属性访问编译为固定的内存偏移量寻址,速度逼近 C 语言结构体。
然而,使用 delete obj[key] 动态剔除属性时,会打乱属性偏移链条。为了避免生成极其庞大的形状转换树,引擎会主动放弃优化,将对象降级为慢速字典模式(Slow Dictionary Mode)。降级后,不仅后续所有读写性能大幅下降,还会引发更多的垃圾回收(GC)开销。
2. Map 的稳定 O(1) 设计
Map 在引擎底层基于专门设计的连续紧凑有序散列表(如 V8 的 OrderedHashTable)实现。当调用 map.delete(key) 时,底层仅仅是在对应的数据槽位写入一个“墓碑标记”(Tombstone),其时间复杂度保持稳定的 O(1)。当碎片达到一定比例时,引擎会一次性在内存中执行平移紧凑整理,吞吐量极其稳定,无去优化(Deoptimization)代价。
五、工程架构选型决策指南
选择数据结构并非追求“绝对先进”,而是让技术特征精确匹配业务需求。以下提供决策流与明确的选型边界:
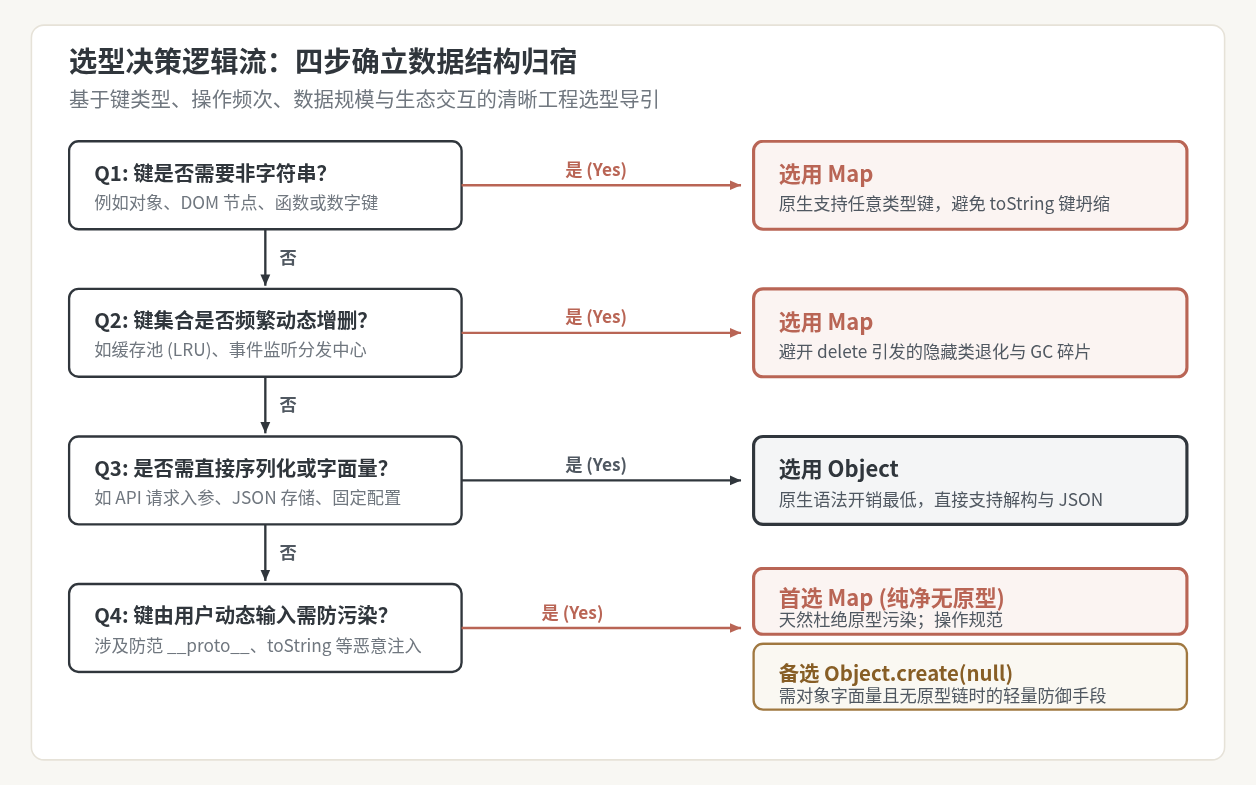
1. 毫不犹豫选择 Map 的场景
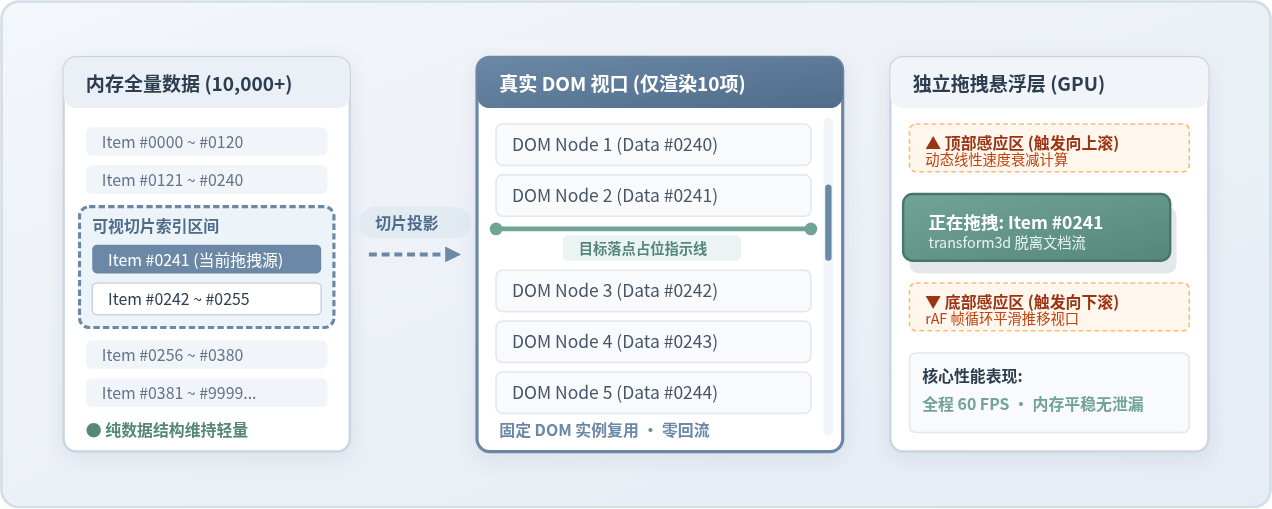
- 非字符串作为键:需要使用 DOM 元素建立元数据映射(如虚拟滚动视口管理、事件绑定注册表),或使用对象引用作为缓存 Key。
- 高频、动态的增删场景:实现 LRU 缓存系统、长连接 Session 会话管理、发布/订阅事件总线。这类场景若使用 Object 会反复触发
delete导致隐藏类频繁退化。 - 集合规模未知且经常需要统计数量:需要频繁调用
size计算池子容量,Map 能够消除Object.keys().length带来的O(N)遍历与临时数组内存分配。 - 严格要求遍历与插入一致:需要严格遵循 FIFO(先进先出)逻辑的队列排队机制。
2. 坚守使用 Object 的场景
- 固定结构的实体与记录(Records / Models):例如用户信息实体
{ id, name, age, email }。这类场景字段结构固定,Object 的隐藏类优化能提供最快属性读取,且代码可读性最高。 - 依赖原生 JSON 序列化:API 请求载荷(Payload)、存储到 localStorage 的配置项。Object 支持
JSON.stringify()直接序列化,而 Map 必须通过Array.from(map.entries())或Object.fromEntries(map)进行中转。 - 利用对象展开与解构赋值:需要频繁使用解构特性如
const { id, ...rest } = config,字面量语法在开发体验上远优于 Map 的方法调用。
3. 避免两种常见的极端误区
误区一:把所有普通配置对象全部重构成 Map。Map 虽然性能强劲,但创建实例的内存基准开销(Base Overhead)高于普通字面量对象。对于仅有两三个静态字段的配置项,盲目改写为 new Map() 不仅增加内存消耗,还会丧失编译期字段提示与解构便利。
误区二:在大量动态写入时用普通对象配合 delete。部分开发者因习惯 delete obj[k] 而抗拒 Map,在几万条数据的实时流处理中,对象的字典模式降级与 GC 暂停会带来肉眼可见的帧率波动。此时重构为 Map 是立竿见影的性能优化手段。
六、总结速查表
| 场景需求 | 推荐选择 | 核心理由 |
|---|---|---|
| API 请求参数、JSON 数据传输、持久化配置 | Object | 原生支持 JSON 序列化与字面量语法,开发体验最佳 |
| 高频增删数据的内存缓存池(如 LRU Cache) | Map | delete 操作为 O(1),无 V8 隐藏类退化与额外 GC 压力 |
| DOM 节点、对象引用与状态信息的绑定 | Map (或 WeakMap) | 原生支持非字符串键,避免隐式转换导致的键覆盖 |
| 接收外部用户未知输入建立动态字典 | Map | 无默认原型链,从根源杜绝原型污染攻击 |
| 字段固定的业务数据实体 (Data Entity) | Object | V8 内联缓存极速寻址,支持优雅的对象解构与展开 |
crypto-js 处理 Base64 和 Hex 编码转换的正确姿势
2026-11-05 16:39:11
ammo.js 内存管理:避免 Wasm 环境下的内存泄漏技巧
2026-11-05 10:21:09
JS几种补零方法的性能对比与选择建议
2026-11-04 21:17:50
JS数组去重最佳实践:Set、filter与reduce实现方案
2026-11-04 10:57:15
基准元素选择策略对 JavaScript 快速排序性能的影响
2026-11-03 22:37:29
相关标签: