JavaScript下载速度计算为何波动大?滑动窗口算法解析
深入解析前端JavaScript在计算下载速度时数值剧烈波动的底层网络与运行时原因,详细讲解时间滑动窗口算法(Sliding Window)的数学原理与生产级代码实现。
在前端实现大文件下载进度条或测速仪表盘时,开发者常会发现直接依据两个连续数据包的传输差量计算出的即时速度极其不稳定,数值在几十KB/s与几十MB/s之间频繁剧烈跳变。解决该问题的工程方案是采用基于时间跨度的滑动窗口算法(Time-based Sliding Window),通过维护一个限定时间范围(如近1至2秒)内的采样点队列,丢弃过期数据并对有效窗口内的字节总量与时间跨度求商,从而在抑制突发毛刺的同时保留对网络变化的敏锐响应。
一、为什么常规下载速度计算会出现剧烈抖动?
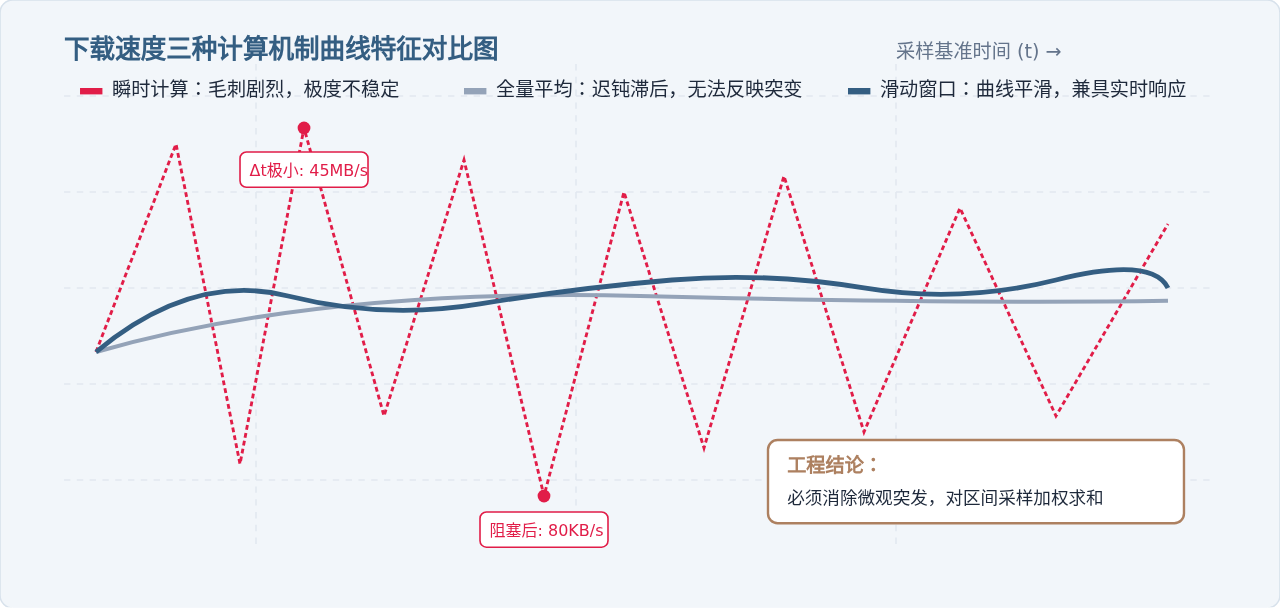
很多开发者在初次实现下载测速时,往往习惯直接采用瞬时增量公式:记录上一次触发数据回调的时间 t_prev 与已接收字节数 loaded_prev,当新的数据块到达时,获取当前时间 t_now 与 loaded_now,并以 (loaded_now - loaded_prev) / (t_now - t_prev) 作为当前下载速度。这种做法在理论上成立,但在真实的浏览器和网络运行环境中会产生严重失真。
导致瞬时测速剧烈抖动的主要原因包括:
- 网络传输层的突发性与批处理机制:底层 TCP 协议存在滑动窗口调节、慢启动以及 Nagle 算法,操作系统的网络协议栈和网卡驱动并非均匀递送每一个数据包,而是将若干到达的数据合并成批次后上报给用户态进程。
- 微小时间差导致的极度放大效应:在微观时间轴上,由于浏览器主线程任务调度(包括宏任务与微任务排队)、垃圾回收等因素,两个
ProgressEvent或ReadableStream数据块到达的时间差Δt可能只有数毫秒甚至不足 1 毫秒。如果一个 64KB 的数据块恰好延迟了 1ms 到达,瞬时算出的速度就会达到每秒数十兆字节;紧接着由于缓冲区排空,下一个块在 200ms 后才到达,瞬时速度便骤降至 300KB/s。 - 累计平均速度的局限性:若改用全流程平均公式
total_loaded / total_elapsed_time,虽然数值极度稳定,但当下载进行数分钟后,分母与分子基数极大,此时若用户网络发生断崖式下跌或提速,累计平均速度需要极长时间才能反映出来,完全失去了实时测速的意义。
二、滑动窗口算法的核心原理与设计思路
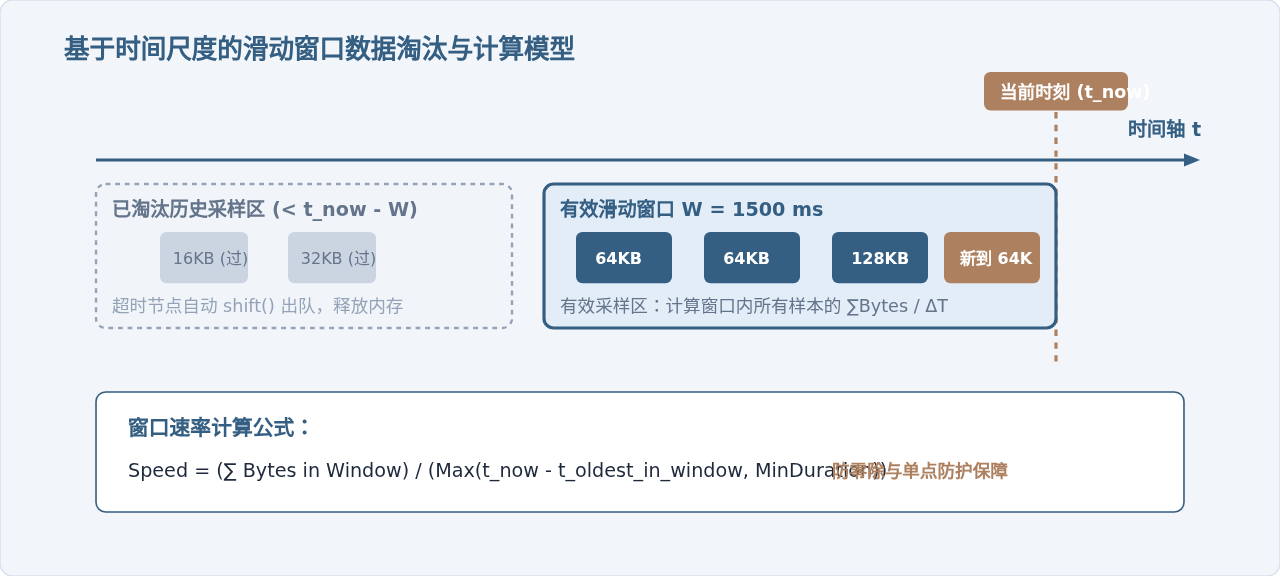
滑动窗口算法在测速场景中的本质是:仅关注当前时刻前的一个固定时间宽度(Window Span,通常设为 1000ms 到 2000ms)内的网络传输表现。当有新数据到达时,将其推入采样队列;同时检查队列首部,凡是时间戳早于 (当前时间 - 窗口宽度) 的历史采样记录均直接出队丢弃。
在设计该算法时,有两个关键技术决策需要明确:
- 时间跨度窗口 VS 采样计数窗口:切勿使用“固定保留最近 N 个数据块”的计数窗口。因为当网络完全阻塞时,数据块不会到达,计数窗口内的历史数据永远不会被剔除,导致展示的速度一直停留在停滞前的数值;而以时间为基准的窗口,即便没有新块进入,随着时间的流逝,旧采样也会因超时被逐个淘汰,速度能够自然、真实地衰减归零。
- 窗口宽度的权衡(Trade-off):窗口过小(例如小于 300ms),仍旧会被突发分包抖动影响;窗口过大(例如大于 5000ms),会导致速度指示器对带宽变化的响应变得迟缓。在实际 Web 应用与大文件下载场景中,1000ms 至 1500ms 是平滑度与灵敏度的黄金平衡区间。
三、完整的 JavaScript 滑动窗口测速类实现
为了在实际项目中方便复用,我们将滑动窗口测速逻辑封装为一个独立的 DownloadSpeedTracker 类。该类内部维护队列,并在每次存入数据或获取当前速率时,自动清理超出窗口有效期的记录。
/**
 * 生产级时间滑动窗口下载速度计算器
 */
class DownloadSpeedTracker {
  /**
   * @param {number} windowSpanMs 滑动窗口时长(毫秒),推荐 1000 - 2000 ms
   */
  constructor(windowSpanMs = 1500) {
    this.windowSpanMs = windowSpanMs;
    // 队列结构保存元素: { timestamp: number, bytes: number }
    this.samples = [];
    this.totalBytesInWindow = 0;
  }

  /**
   * 记录新增下载的数据块大小
   * @param {number} bytes 本次接收的字节数增量
   */
  record(bytes) {
    if (bytes <= 0) return;
    const now = performance.now();
    this.samples.push({ timestamp: now, bytes });
    this.totalBytesInWindow += bytes;
    this._purgeExpired(now);
  }

  /**
   * 清除超出当前窗口时间范围的历史记录
   * @private
   */
  _purgeExpired(now) {
    const threshold = now - this.windowSpanMs;
    while (this.samples.length > 0 && this.samples[0].timestamp < threshold) {
      const expired = this.samples.shift();
      this.totalBytesInWindow -= expired.bytes;
    }
    // 浮点数累加防护,防止连续操作出现微小负数误差
    if (this.totalBytesInWindow < 0 || this.samples.length === 0) {
      this.totalBytesInWindow = 0;
    }
  }

  /**
   * 获取当前滑动窗口内的平均下载速率 (Bytes/s)
   * @returns {number}
   */
  getCurrentSpeed() {
    const now = performance.now();
    this._purgeExpired(now);

    if (this.samples.length < 2) {
      // 样本数过少时无法计算有效时间差,若有单样本则按微小间隔估算或返回已有瞬时估算
      return this.samples.length === 1 ? (this.samples[0].bytes * 1000) / this.windowSpanMs : 0;
    }

    const oldestTimestamp = this.samples[0].timestamp;
    // 计算窗口内实际经历的时间跨度(秒),设立保底阈值避免除以0
    const durationSeconds = Math.max((now - oldestTimestamp) / 1000, 0.05);
    return this.totalBytesInWindow / durationSeconds;
  }

  /**
   * 格式化输出易读的速率字符串
   * @returns {string} 例如 "5.24 MB/s", "820.50 KB/s"
   */
  getFormattedSpeed() {
    const speed = this.getCurrentSpeed();
    if (speed >= 1024 * 1024) {
      return (speed / (1024 * 1024)).toFixed(2) + " MB/s";
    }
    if (speed >= 1024) {
      return (speed / 1024).toFixed(2) + " KB/s";
    }
    return speed.toFixed(0) + " B/s";
  }

  /**
   * 重置测速状态
   */
  reset() {
    this.samples = [];
    this.totalBytesInWindow = 0;
  }
}
在现代 Fetch API 与 ReadableStream 中接入
在现代前端开发中,下载通常基于 fetch 发起流式传输。我们通过迭代 reader.read() 读取分块(Chunk),将每个分块的字节长度喂入测速器:
async function downloadWithSpeedTracking(url, onProgress) {
  const tracker = new DownloadSpeedTracker(1500);
  const response = await fetch(url);

  if (!response.ok) throw new Error("下载请求失败: " + response.statusText);

  const totalLength = Number(response.headers.get("content-length")) || 0;
  const reader = response.body.getReader();
  let receivedBytes = 0;

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;

    const chunkSize = value.byteLength;
    receivedBytes += chunkSize;

    // 记录采样
    tracker.record(chunkSize);

    // 回传进度信息
    if (typeof onProgress === "function") {
      onProgress({
        receivedBytes,
        totalBytes: totalLength,
        percent: totalLength ? ((receivedBytes / totalLength) * 100).toFixed(1) : null,
        currentSpeed: tracker.getFormattedSpeed()
      });
    }
  }

  return receivedBytes;
}
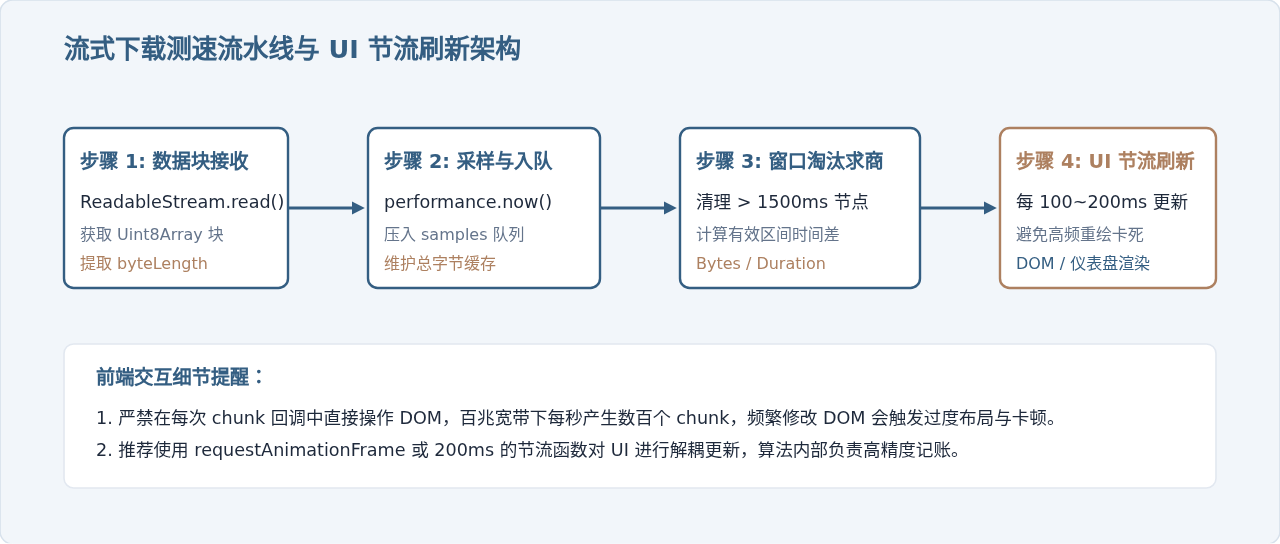
四、工程落地中的边界场景与防御策略
在生产环境中运行滑动窗口测速器时,还需防范以下常见边界异常:
1. 网络彻底停滞(Stall)时的速率归零
当用户的 Wi-Fi 突然断开或服务器暂停发包时,reader.read() 会处于长时间等待状态,不会有新的 record() 调用。如果直接读取上次计算的结果,UI 上的速度就会定格在停滞前的数值。解决方案是在 UI 刷新定时器中主动调用 getCurrentSpeed(),此时方法内的 _purgeExpired(now) 会依据当前墙上时间清除过期节点。当停滞时间超过 windowSpanMs 时,队列彻底清空,速度自然归零。
2. 高精度时间戳的选择
务必使用 performance.now() 而非 Date.now()。Date.now() 依赖系统本地时钟,在操作系统时间自动同步或用户调整时区时可能发生回拨,甚至出现负数时间跨度;而 performance.now() 是严格单调递增的单调时间戳(Monotonic Clock),精度可达微秒级,能有效防止时间倒流造成的速度计算崩溃。
五、测速算法对比与选型决策
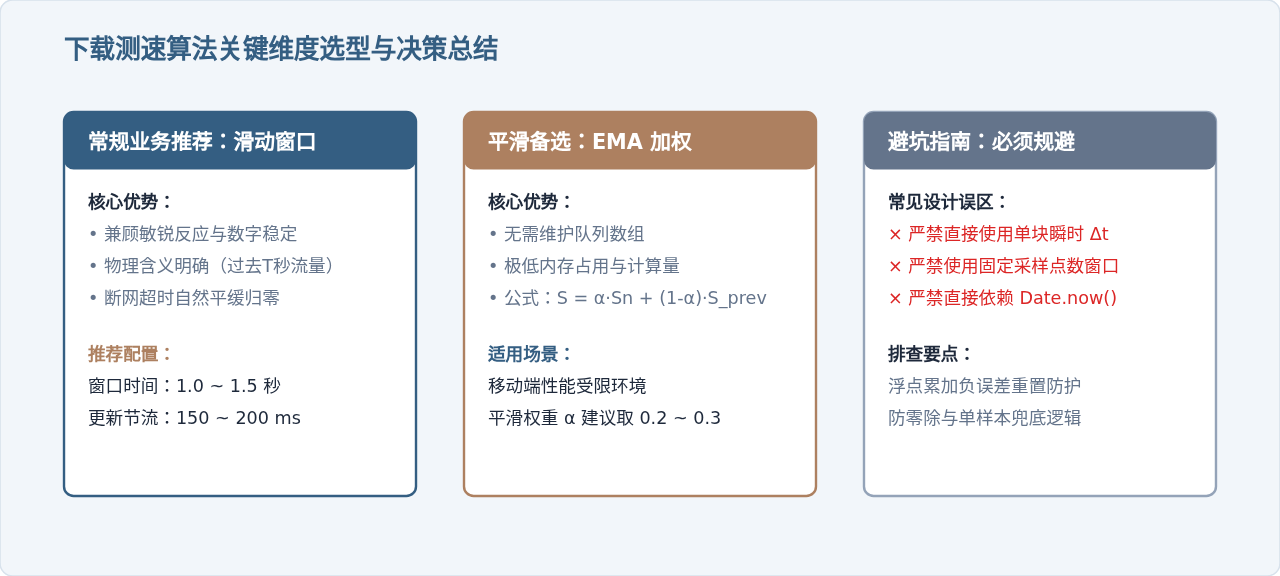
为了在不同业务场景下选用最合适的测速方案,我们对主流方案进行综合评估:
| 算法类型 | 响应灵敏度 | 抗抖动平滑度 | 实现复杂度 | 典型适用场景 |
|---|---|---|---|---|
| 瞬时增量法 | 极高(实时反映单块) | 极差(严重毛刺) | 极低(仅需两个变量) | 极慢速轮询传输、单包调试 |
| 全量累计平均 | 极低(后期几乎凝固) | 极高(完全无抖动) | 极低(总量/总耗时) | 任务完成后的结算统计、总体平均速度 |
| 时间滑动窗口 | 高(平滑可配,响应迅速) | 良好(毛刺完全被吸收) | 中等(需维护定长队列) | 大文件下载仪表盘、视频缓冲测速、常规应用 |
| 指数移动平均 (EMA) | 中等偏高 | 优秀 | 低(递归权重计算) | 嵌入式设备、极端低内存环境、码率自适应切换 |
综上所述,JavaScript 计算下载速度时的大幅波动并非网络本身的实际带宽在每毫秒都发生巨变,而是底层网络分包交付机制、操作系统协议栈批处理以及主线程调度微小时间差共同作用导致的数学失真。通过引入基于时间维度的滑动窗口算法,并配合 UI 节流机制,能够彻底解决数值乱跳的现象,向用户呈现专业、平稳且灵敏的测速体验。
UmiJS 项目构建速度优化与打包体积精简技巧
2026-11-04 22:37:09
原生JS操作DOM与Vue/React虚拟DOM的本质区别
2026-11-04 17:52:27
怎么使用console.group和table优化JS日志可读性
2026-11-03 23:14:34
基于AST抽象语法树的JS代码反混淆实战教程
2026-11-03 21:22:24
JS手机号输入校验的性能优化与用户体验提升
2026-11-03 19:19:19