基于AST抽象语法树的JS代码反混淆实战教程
深入讲解基于Babel抽象语法树(AST)进行JavaScript代码反混淆的系统方法,涵盖常量折叠、字符串数组解密、花指令剥离与控制流平坦化还原的实战代码与工程实现。

JavaScript 代码反混淆的核心在于通过解析器将高度扭曲的字符流转换为结构化的抽象语法树(AST),利用树遍历机制消除人工混淆算子(如编码转换、常量膨胀、字符串字典化、代理花指令与控制流平坦化),最终重新生成具有高度语义可读性的原始代码。本文以业界通用的 Babel 工具链为基础,按照由浅入深的工程化还原路径,完整展示从环境配置、特征匹配、AST 节点重构到最终代码生成的可执行实战方案。
一、AST 反混淆核心逻辑与工作环境搭建
传统的正则表达式或简单字符串替换在面对复杂混淆代码时极易失效,因为混淆器会动态注入局部作用域、打乱执行顺序并复用相同的变量标识符。正则表达式无法感知语法上下文(例如一个标识符是变量定义、函数调用还是对象键名),强制替换往往导致语法崩坏。而抽象语法树(Abstract Syntax Tree,简称 AST)是源代码语法结构的树状表现形式,通过树形节点精确表达表达式、语句、作用域与闭包依赖,是解决代码混淆的确定性手段。
在 Node.js 生态中,Babel 提供了业界最完备的 AST 操控工具集。进行 AST 反混淆实战前,需通过 npm 安装核心套件:
# 在工程根目录下安装 Babel 核心 AST 操作依赖库
npm install @babel/parser @babel/traverse @babel/types @babel/generator
基础反混淆执行脚手架通常由读取源码、语法解析、树遍历变换与代码重新序列化四大环节构成。基础模板文件 deobfuscate.js 如下:
const fs = require('fs');
const parser = require('@babel/parser');
const traverse = require('@babel/traverse').default;
const t = require('@babel/types');
const generator = require('@babel/generator').default;

// 1. 读取混淆源码
const sourceCode = fs.readFileSync('obfuscated.js', 'utf-8');

// 2. 解析为 AST 语法树
const ast = parser.parse(sourceCode, {
  sourceType: 'module',
  allowReturnOutsideFunction: true
});

// 3. 核心遍历与改写处理(此处挂载各个专项 Visitor)
// traverse(ast, visitor);

// 4. 将净化后的 AST 重新序列化为可读 JavaScript
const { code: cleanCode } = generator(ast, {
  jsescOption: { minimal: true } // 保证中文字符与常规字符不转为 Unicode 转义形式
});

fs.writeFileSync('restored.js', cleanCode);
console.log('代码反混淆完成,输出文件:restored.js');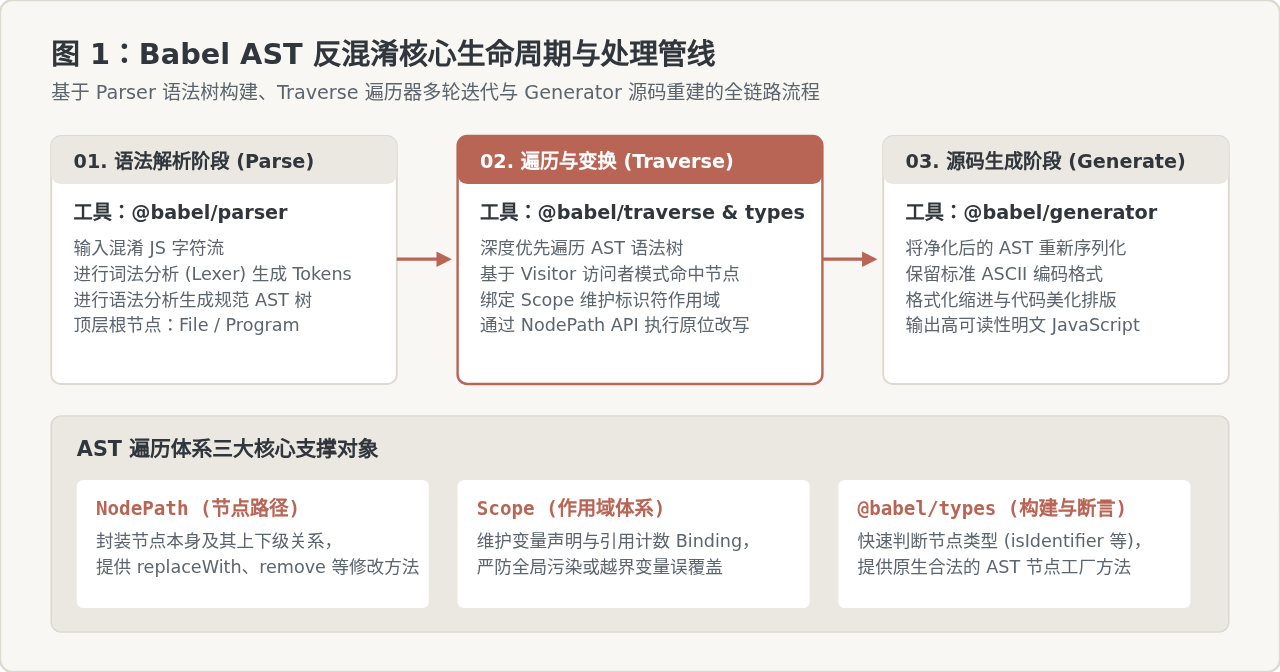
在整个生命周期中,NodePath 对象是 AST 转换的核心。它不仅包含了当前 AST 节点的属性,还记录了节点的父节点、兄弟节点及所处的作用域(Scope)。通过 path.replaceWith()、path.replaceWithMultiple() 与 path.remove(),开发者可以实现原地语法树重构。
二、混淆代码逆向还原的标准递进工序
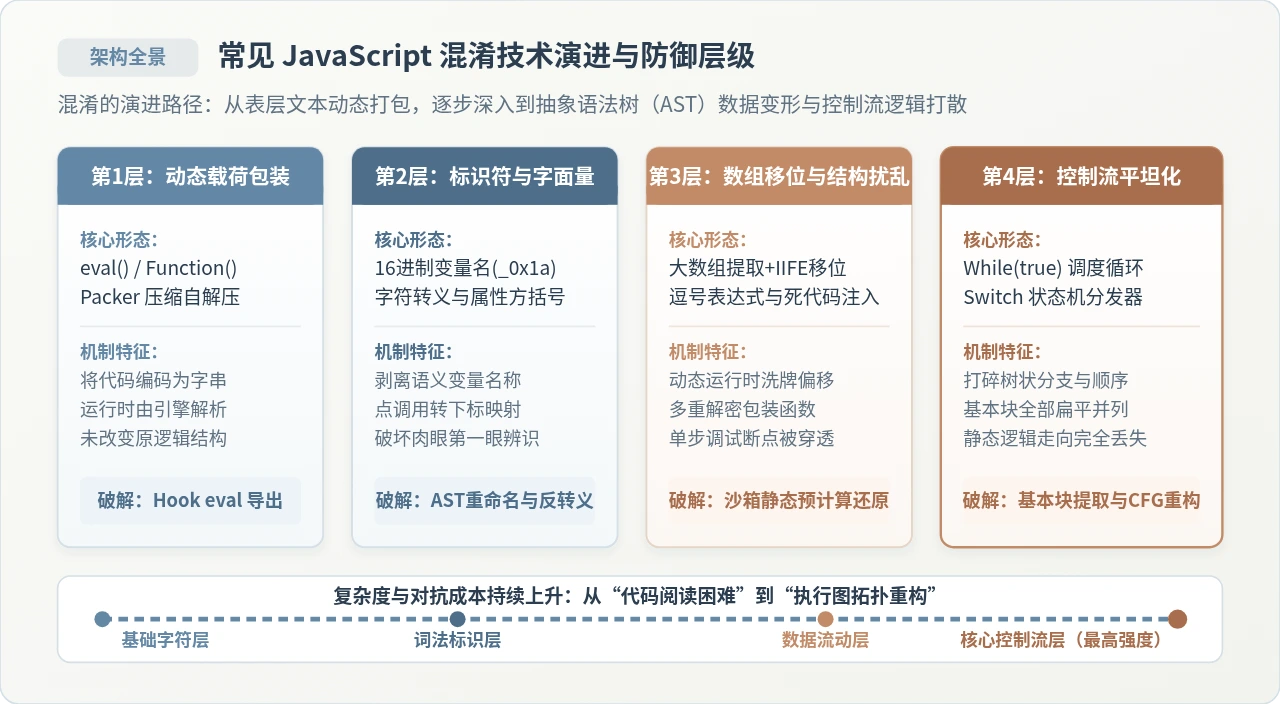
面对混合了多层防护的复杂脚本(如 js-obfuscator、obfuscator.io 等输出代码),不能无序地套用规则。反混淆必须遵守严格的依赖倒置顺序:外层通常是字面量混淆与加密数组,底层则是基于解密字符串运转的控制流平坦化与业务逻辑。如果过早处理控制流,状态分发计算尚未还原,遍历将无法理清分支关系;反之,若先净化底层逻辑,上层加密函数可能会干扰代码结构。
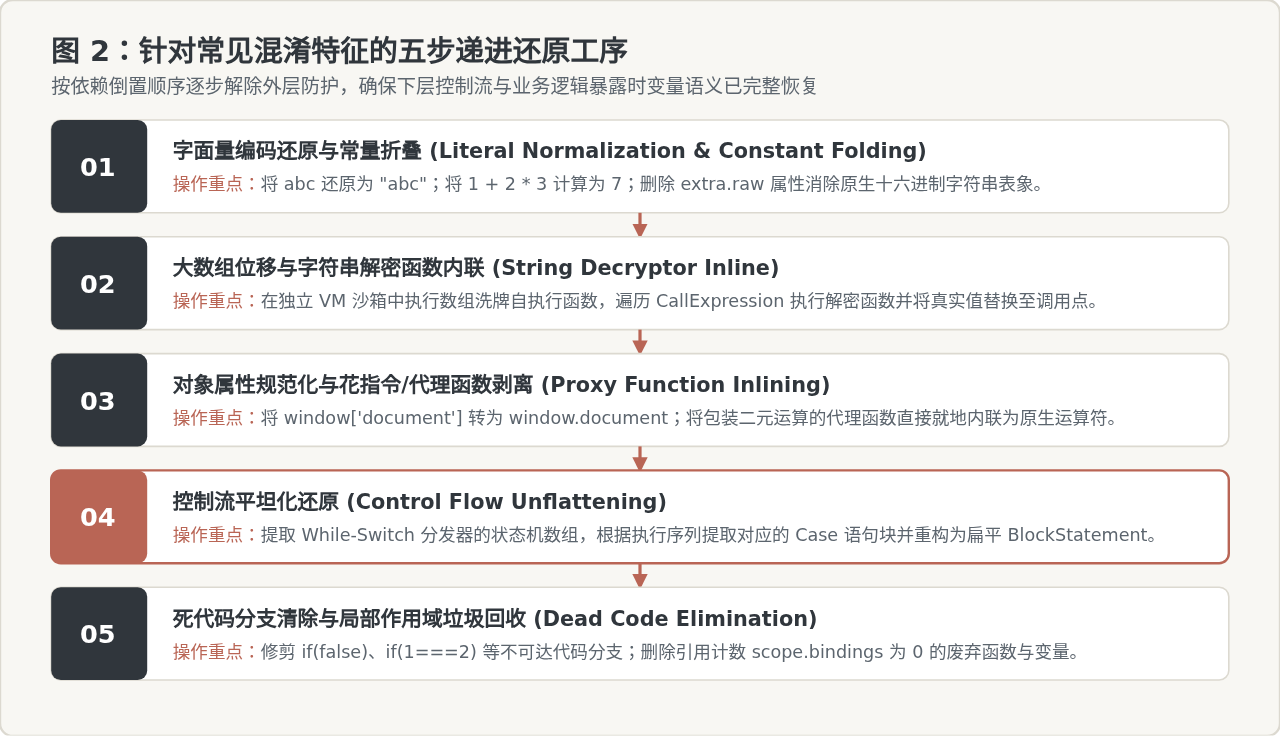
标准的反混淆流水线包含五个不可逆的阶段:
- 字面量规范化与常量折叠:消除十六进制、Unicode 转义表示,提前计算静态二元运算。
- 大数组位移与解密函数内联:在受控沙箱中执行自执行数组乱序函数,将所有解密调用就地还原为纯文本字面量。
- 属性访问规范化与代理函数消除:将方括号访问转为标准点语法,把封装基础运算符的花指令函数内联回调用点。
- 控制流平坦化重构:解构 While-Switch 分发循环,依据状态数组拓扑还原为线性的顺序代码。
- 死代码与冗余绑定剔除:修剪无法到达的分支,并回收引用计数归零的垃圾变量与函数。
三、实战一:字面量规范化与静态常量折叠
混淆器最基础的伎俩是将普通的数字和字符串转化为非十进制形式或冗长的计算式,例如将 100 写作 0x64,或将 "hello" 转化为 'hello',并把简单的条件判定拆解为 1 + 2 * 3 === 7。Babel 解析这些节点时,会在 AST 的 extra.raw 属性中保留原始文本。
1. 消除十六进制与原始编码表示
只需在遍历 NumericLiteral 与 StringLiteral 节点时删除其 extra 字段,Babel 生成器就会默认采用标准规范格式重新输出:
// 阶段一:清理字面量原始转义文本
const cleanLiteralsVisitor = {
  'NumericLiteral|StringLiteral'(path) {
    if (path.node.extra) {
      delete path.node.extra;
    }
  }
};
2. 静态常量表达式就地求值(Constant Folding)
混淆代码中经常充斥着无实际语义的计算表达式(如 ![] + [] 或 3 * 8 + 4)。Babel 提供了 path.evaluate() 方法,专门用于在静态分析阶段评估表达式是否为确定值。当 evaluate().confident 为 true 时,说明该表达式不依赖运行时动态环境,可安全替换为常量字面量节点:
// 阶段一:二元表达式与一元静态计算折叠
const constantFoldingVisitor = {
  'BinaryExpression|UnaryExpression'(path) {
    // 忽略可能造成无限循环或除以零的异常表达式
    if (path.node.operator === '/' && path.node.right.value === 0) return;

    const res = path.evaluate();
    if (res.confident) {
      // 将确定的计算结果转为合法的 AST 字面量节点
      path.replaceWith(t.valueToNode(res.value));
    }
  }
};在使用 path.evaluate() 时,务必确认表达式不包含全局变量或未绑定的标识符。对于 -0、Infinity 或超过浮点精度的超大整数,需要单独做防御判断,避免在转换过程中丢失数值符号或发生精度截断。
四、实战二:大数组位移与字符串解密函数内联
现代商业混淆器(如 js-obfuscator)最为标志性的结构是全局大数组 + 自执行乱序洗牌函数 + 索引解密包装函数三件套。所有代码中的核心字符串均被抽离到该数组中,并通过类似 _0x4b2c('0x1') 的形式动态读取。
1. 混淆结构典型特征
在混淆文件最开头,通常可以观察到如下固定三元结构:
// 1. 大数组定义
var _0x21a4 = ['token', 'secret', 'POST', 'https://api.domain.com'];

// 2. 数组乱序位移自执行函数 (IIFE)
(function(_0x4b2c, _0x1a8) {
  var _0x3e1 = function(_0x9d) {
    while (--_0x9d) {
      _0x4b2c.push(_0x4b2c.shift());
    }
  };
  _0x3e1(++_0x1a8);
}(_0x21a4, 0x1f4));

// 3. 解密函数入口
var _0x12ab = function(_0x3c, _0x5f) {
  _0x3c = _0x3c - 0x0;
  return _0x21a4[_0x3c];
};
2. 利用 Node.js vm 模块受控沙箱提取解密函数
不要尝试用 AST 去重写复杂的数组乱序算法,最稳定、最高效的工程做法是:通过 AST 提取前三个节点的源码,在独立的 Node.js vm 沙箱中执行,然后用 AST 遍历所有解密调用并批量填回明文。
const vm = require('vm');

// 提取前三个关键节点:大数组、IIFE 乱序函数、解密函数
const decryptCodeNodes = ast.program.body.slice(0, 3);
const decryptCode = decryptCodeNodes.map(node => generator(node).code).join('
');

// 在安全沙箱上下文中运行解密预备代码
const sandbox = {};
vm.createContext(sandbox);
vm.runInContext(decryptCode, sandbox);

// 获取解密函数的函数名标识符(以第三个节点为例)
const decryptFnName = decryptCodeNodes[2].declarations[0].id.name;

// 遍历所有对该解密函数的调用点进行就地回填
traverse(ast, {
  CallExpression(path) {
    if (t.isIdentifier(path.node.callee, { name: decryptFnName })) {
      // 获取调用入参(例如 '0x0', '0x1')
      const args = path.node.arguments.map(arg => arg.value);

      // 在沙箱中直接执行解密函数获取原始真实字符串
      const decryptedValue = sandbox[decryptFnName](...args);

      // 替换为纯文本 StringLiteral
      path.replaceWith(t.stringLiteral(decryptedValue));
    }
  }
});

// 回填完成后,删除开头的三个前置解密支持节点
ast.program.body.splice(0, 3);
五、实战三:成员访问规范化与对象代理函数消除
混淆器为了进一步破坏代码的词法可读性,会将普通的对象属性访问强制改写为方括号加混淆字符串(如 window['document']['cookie']),并创建大量一次性的“代理字典”用于封装简单的加减乘除或函数调用。
1. 方括号属性访问规范化
当 MemberExpression 的 computed 为 true(即方括号形式),且属性名为符合 JS 标识符命名规范的纯英文字符串时,可以将其转换为标准的点调用(computed = false):
const memberNormalizeVisitor = {
  MemberExpression(path) {
    const prop = path.node.property;
    if (path.node.computed && t.isStringLiteral(prop)) {
      // 检查属性名是否为合法标识符(非保留字且满足命名规则)
      if (/^[a-zA-Z_$][a-zA-Z0-9_$]*$/.test(prop.value)) {
        path.node.property = t.identifier(prop.value);
        path.node.computed = false;
      }
    }
  }
};
2. 代理花指令函数(Proxy Functions)内联消除
混淆器常常生成如下形式的对象:
var _0x1a8f = {
  "add": function(a, b) { return a + b; },
  "invoke": function(fn, arg) { return fn(arg); }
};
// 调用点:_0x1a8f["add"](x, y);
消除代理函数的算法分两步:首先遍历收集代理字典中的映射规则,随后找到调用点原地替换为对应的原生表达式:
const inlineProxyVisitor = {
  VariableDeclarator(path) {
    // 匹配形如 var obj = { ... } 的字典声明
    if (!t.isObjectExpression(path.node.init)) return;
    const objName = path.node.id.name;
    const properties = path.node.init.properties;

    const proxyMap = new Map();
    properties.forEach(prop => {
      const key = prop.key.value || prop.key.name;
      const fn = prop.value;
      if (t.isFunctionExpression(fn)) {
        const body = fn.body.body;
        if (body.length === 1 && t.isReturnStatement(body[0])) {
          proxyMap.set(key, {
            args: fn.params.map(p => p.name),
            expr: body[0].argument
          });
        }
      }
    });

    if (proxyMap.size === 0) return;

    // 获取当前变量绑定的作用域引用
    const binding = path.scope.getBinding(objName);
    if (!binding) return;

    binding.referencePaths.forEach(refPath => {
      const memberPath = refPath.parentPath;
      if (!memberPath || !memberPath.isMemberExpression()) return;
      const callPath = memberPath.parentPath;
      if (!callPath || !callPath.isCallExpression()) return;

      const propName = memberPath.node.property.value || memberPath.node.property.name;
      if (!proxyMap.has(propName)) return;

      const { expr } = proxyMap.get(propName);
      const callArgs = callPath.node.arguments;

      // 若为二元运算,还原为原生二元表达式
      if (t.isBinaryExpression(expr)) {
        callPath.replaceWith(t.binaryExpression(expr.operator, callArgs[0], callArgs[1]));
      }
      // 若为普通函数调用,还原为直接调用
      else if (t.isCallExpression(expr)) {
        callPath.replaceWith(t.callExpression(callArgs[0], callArgs.slice(1)));
      }
    });

    // 替换完成后移除代理对象自身定义
    path.remove();
  }
};
六、实战四:控制流平坦化(Control Flow Flattening)重构实战
控制流平坦化是最能阻碍人工逆向分析的混淆技术。它打破了程序原有的代码行进逻辑(顺序、分支、嵌套),将全部执行块切割为碎片放入一个巨大的 switch-case 结构中,外层套上 while(true) 死循环,由一个状态数组变量(如 "3|1|0|2".split('|'))在每次循环后自增决定下一个执行哪个 case。
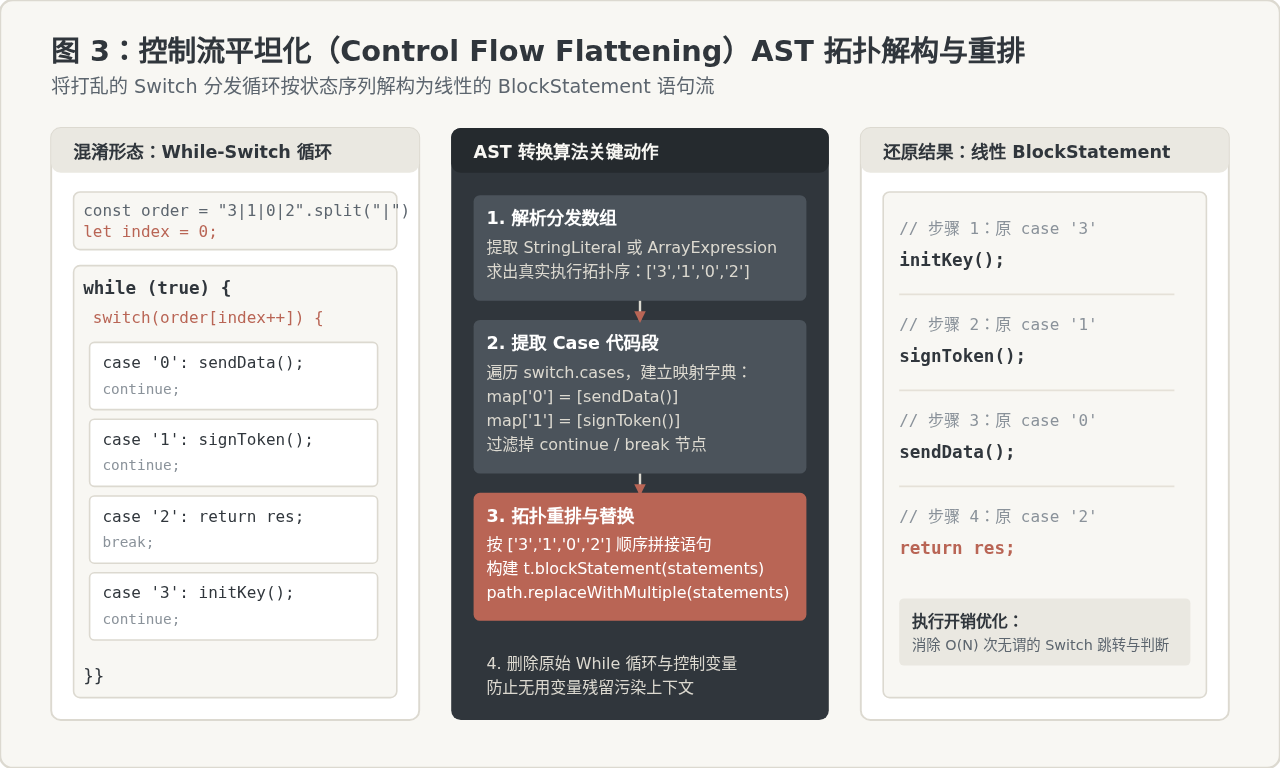
1. 模式识别与特征匹配
控制流平坦化的 AST 特征具有强规律性:
- 外层为
WhileStatement(判别条件恒为真,例如true或!![])。 - 循环体内部首个有效节点必定为
SwitchStatement。 switch的判别表达式形如orderArray[index++]。- 紧邻
WhileStatement的上方存在状态字符串声明(如var order = "3|1|0|2".split('|'))。
2. 拓扑重排与 BlockStatement 原位替换
逆向还原的关键在于直接解析状态数组,按其声明的拓扑序列重新拼装语句块:
const unflattenControlFlowVisitor = {
  WhileStatement(path) {
    const { test, body } = path.node;
    // 判别式是否为 while(true) 或 while(!![])
    if (!t.isBooleanLiteral(test, { value: true }) && !t.isUnaryExpression(test)) return;
    if (!t.isBlockStatement(body)) return;

    const switchNode = body.body[0];
    if (!t.isSwitchStatement(switchNode)) return;

    // 获取 Switch 判别式驱动变量
    const discriminant = switchNode.discriminant;
    if (!t.isMemberExpression(discriminant)) return;

    // 往上查找状态数组定义的同级兄弟节点
    const prevSibling = path.getPrevSibling();
    if (!prevSibling || !prevSibling.isVariableDeclaration()) return;

    // 提取状态序列,例如 "3|1|0|2"
    let dispatchList = [];
    const declarator = prevSibling.node.declarations[0];
    if (t.isCallExpression(declarator.init)) {
      // 形如 "3|1|0|2".split('|')
      const callee = declarator.init.callee;
      if (t.isMemberExpression(callee) && callee.property.name === 'split') {
        const strVal = callee.object.value;
        const sep = declarator.init.arguments[0].value;
        dispatchList = strVal.split(sep);
      }
    }

    if (dispatchList.length === 0) return;

    // 将 switch 内部所有的 case 建立以索引为 key 的映射表
    const caseMap = new Map();
    switchNode.cases.forEach(c => {
      const caseKey = c.test.value;
      // 过滤掉末尾的 continue 或 break 语句
      const cleanStatements = c.consequent.filter(stmt => {
        return !t.isContinueStatement(stmt) && !t.isBreakStatement(stmt);
      });
      caseMap.set(String(caseKey), cleanStatements);
    });

    // 按照状态数组序列重构顺序语句流
    const orderedStatements = [];
    dispatchList.forEach(key => {
      const stmts = caseMap.get(String(key));
      if (stmts) {
        orderedStatements.push(...stmts);
      }
    });

    // 用展平后的顺序代码块替换整个 While 循环
    path.replaceWithMultiple(orderedStatements);

    // 清除前置的状态数组定义变量
    prevSibling.remove();
  }
};
七、实战五:死代码与无用分支剔除
经过前述四轮还原后,代码结构已完全清晰,但会遗留大量由于常量折叠引发的死代码分支(例如 if (false) { ... } else { ... })以及未使用的无用变量。此时需进行最后一道“清洗工序”:
const deadCodeCleanVisitor = {
  // 1. 清理恒真/恒假的 If 条件分支
  IfStatement(path) {
    const res = path.get('test').evaluate();
    if (res.confident) {
      if (res.value) {
        // 条件恒真,保留 consequent 分支
        path.replaceWith(path.node.consequent);
      } else {
        // 条件恒假,保留 alternate 分支(若存在)
        if (path.node.alternate) {
          path.replaceWith(path.node.alternate);
        } else {
          path.remove();
        }
      }
    }
  },

  // 2. 清理引用计数为 0 的孤立变量定义
  VariableDeclarator(path) {
    const binding = path.scope.getBinding(path.node.id.name);
    if (binding && !binding.referenced && binding.constant) {
      path.remove();
    }
  }
};
八、AST 反混淆实战演进与避坑指南
将上述所有独立 Visitor 整合为多轮管道时,开发者往往会遇到一些反混淆工程中的隐蔽陷阱:
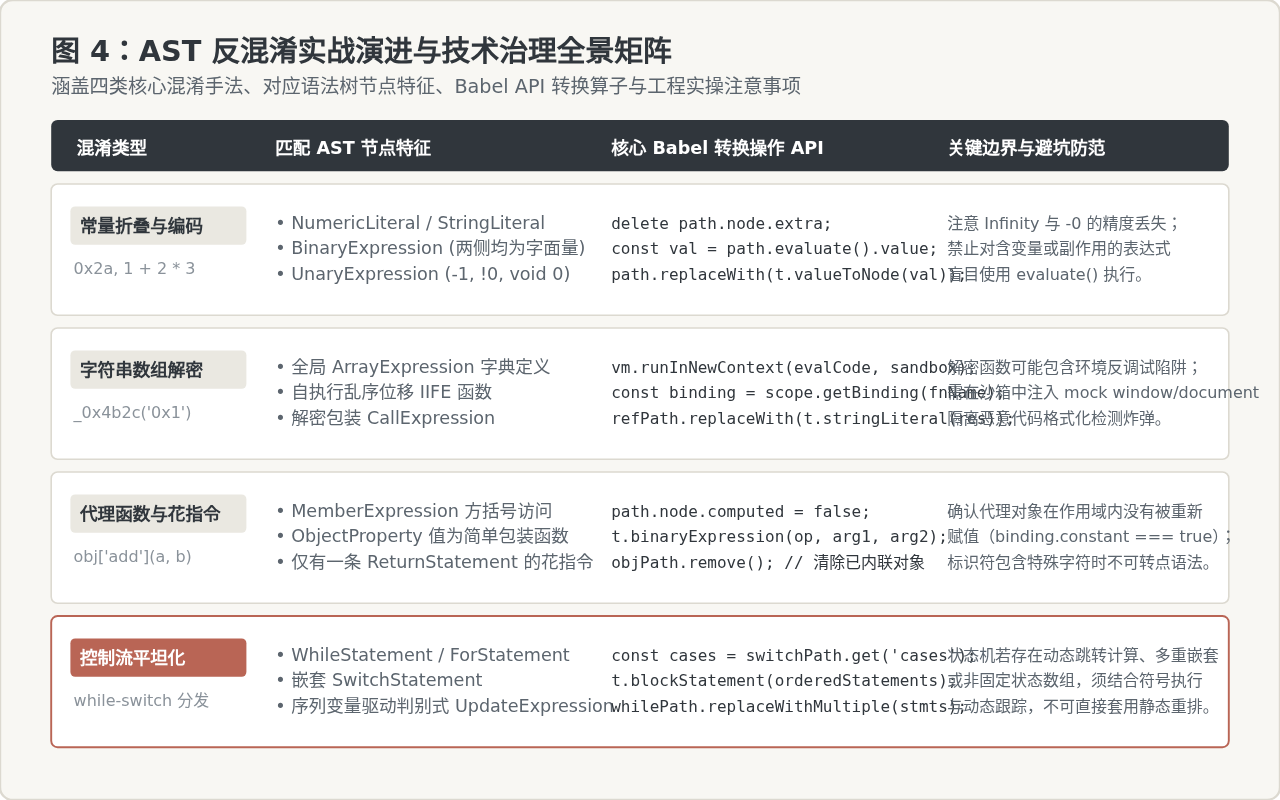
1. 反调试与原型链格式化检测炸弹
许多商业混淆器会在全局注入针对函数 toString() 的检测机制(例如正则匹配 /\w+ *\(\) *{\w+ *['|"].+['|"].*}/)。如果代码被美化、格式化或换行,该正则就会触发无限递归 debugger 或内存溢出炸弹。应对方案:在通过 Babel Generator 输出代码前,先全局定位并删除包含 RegExp、debugger 与 setInterval 的反调试自执行函数。
2. 标识符冲突与作用域漂移(Scope Drift)
混淆器频繁使用无意义的单字母变量名(如多次复用 a、b、c)。在执行替换时,切忌使用简单的全局名称匹配,必须调用 path.scope.getBinding(name) 严格限制在当前词法作用域内部操作,防止内层同名变量意外破坏外层闭包变量。
3. AST 修改后的 Path 缓存同步
当通过 replaceWith 或 remove 大幅度修改 AST 结构后,Babel 内部的 Path 树缓存可能尚未实时刷新,导致后续的 Visitor 获取到过时的节点信息。在完成重大结构变动(如控制流平坦化解构)后,建议调用 path.scope.crawl() 强制重新扫描当前作用域的引用绑定,或采用分批多遍遍历(Multiple Passes)策略,确保每次变换都在最新、稳定的语法树上进行。
UmiJS 项目构建速度优化与打包体积精简技巧
2026-11-04 22:37:09
原生JS操作DOM与Vue/React虚拟DOM的本质区别
2026-11-04 17:52:27
怎么使用console.group和table优化JS日志可读性
2026-11-03 23:14:34
JS手机号输入校验的性能优化与用户体验提升
2026-11-03 19:19:19
Vue 3 与 React 项目中集成 Leaflet.js 的最佳实践与内存泄漏规避
2026-11-03 19:01:07