

Node.js环境下的JavaScript报错与浏览器端有何不同
对比分析Node.js与浏览器运行环境下JavaScript报错的核心差异,涵盖未捕获异常对生命周期的不同破坏程度、操作系统级SystemError与DOMException等独有错误体系、全局捕获机制及调试排查方式。
在不同运行环境下,一段出现异常的 JavaScript 代码会引发截然不同的后果:在浏览器中,一个未捕获的报错通常只会导致当前事件回调中断或局部组件白屏,页面与标签页仍能正常响应用户交互;而在 Node.js 环境下,未捕获的异常或被拒绝的 Promise 默认会直接触发致命退出事件,导致整个后台服务进程立刻终止(Exit Code 1)。造成这种差异的根本原因,在于两者面向的宿主设计目标不同——浏览器追求用户交互的可用性与容错隔离,而 Node.js 作为服务端后台,追求状态确定性与防脏数据扩散。
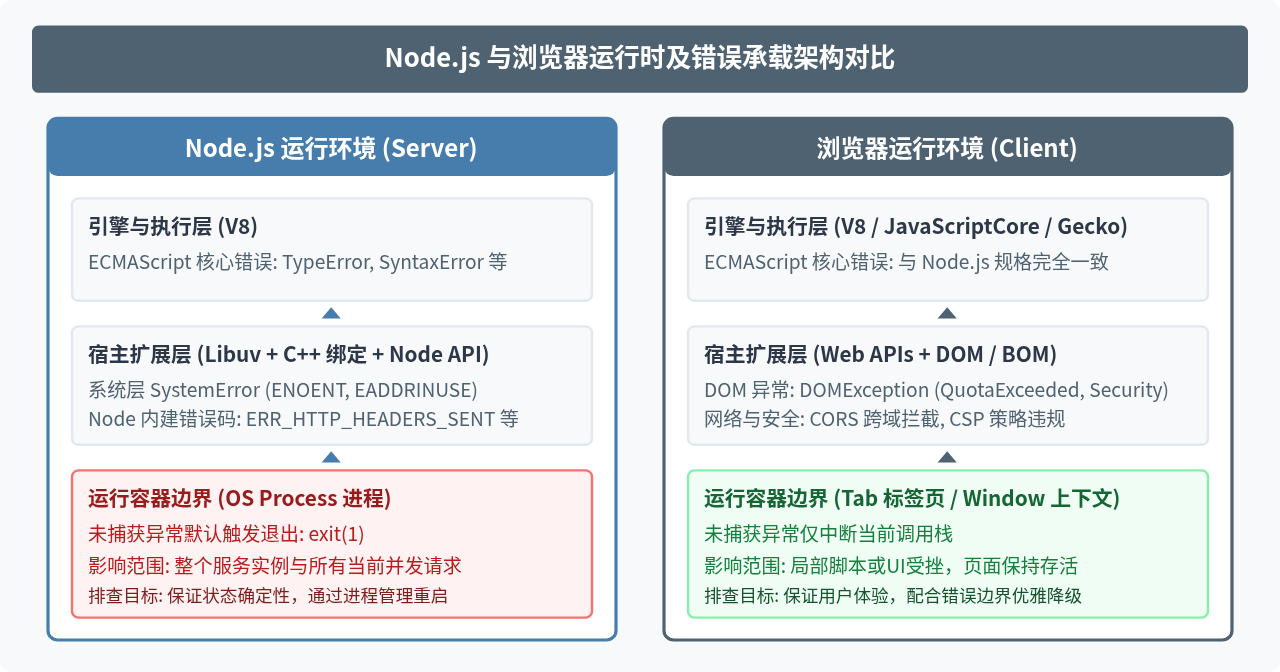
一、错误类型的构成差异:通用标准与宿主独有扩展
虽然两者都运行 ECMAScript 标准,但各自的错误体系在基础核心之外分化出了截然不同的分支。
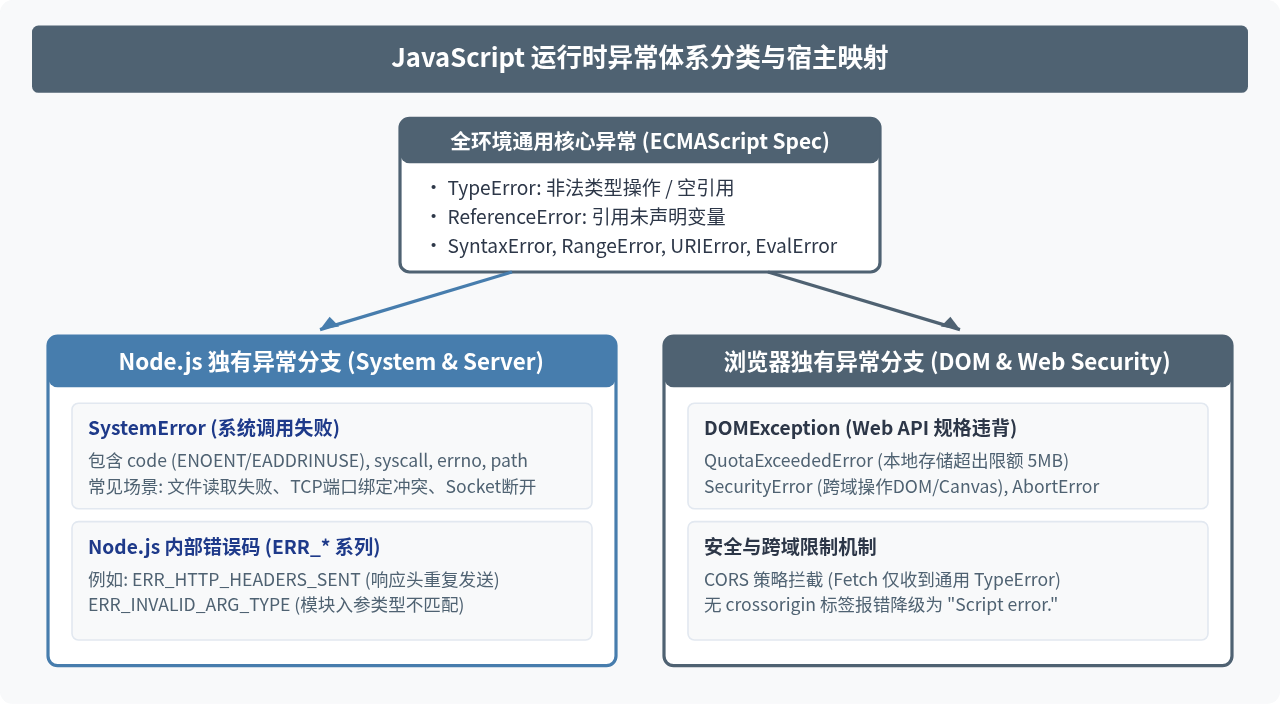
1. 共同的 ECMAScript 核心错误
凡是语言内置的基础语法与逻辑错误,在 Node.js 和现代浏览器中的行为与名称是完全一致的。例如:
ReferenceError:引用了未声明的变量。TypeError:在非预期类型的值上执行了非法操作(如调用undefined上的方法)。SyntaxError:代码文本不符合语法解析规则。RangeError:数值越界或递归调用栈溢出(Maximum call stack size exceeded)。
2. Node.js 独有的 SystemError 与错误编码体系
Node.js 直接与底层操作系统打交道,因此封装了一套由操作系统系统调用(syscall)派生出的 SystemError。当文件读写失败、网络端口被占或连接超时时,Node.js 产生的错误对象不仅包含 message 和 stack,还会包含操作系统级别的字段:
code:标准错误字符串标识,如ENOENT(找不到文件或目录)、EADDRINUSE(端口已被占用)、ECONNREFUSED(连接被拒绝)。errno:系统原生错误数字编号。syscall:触发报错的具体底层系统调用名称,如open、bind、connect。path/address/port:涉及的具体文件系统路径或网络端点。
此外,Node.js 自带模块内部定义了严格的以 ERR_* 命名的静态错误代码。例如重复发送 HTTP 响应头时会抛出 ERR_HTTP_HEADERS_SENT,传入非法类型参数时抛出 ERR_INVALID_ARG_TYPE。通过匹配 error.code 进行防御性判断,是 Node.js 错误处理的标准实践。
3. 浏览器独有的 DOMException 与安全限制错误
浏览器并不暴露底层的 POSIX 系统调用,其独有错误主要由 Web APIs、安全沙箱和文档模型产生:
DOMException:调用 Web API 违反规格时抛出。常见名称包括QuotaExceededError(localStorage 存储超限)、SecurityError(跨域操作 DOM 或画布污损)、AbortError(Fetch 请求被 AbortController 中断)。- CORS 跨域错误:当通过
fetch或XMLHttpRequest访问未配置有效 CORS 响应头的接口时,浏览器会拦截响应并报网络错误。出于隐私安全保护,脚本内的catch块只能捕获一个通用的TypeError: Failed to fetch,无法读取详细的跨域原因,具体违规细节只展示在浏览器开发者工具控制台中。 - 静态资源加载失败:
<script>、<img>或<link>标签因 404、网络中断或 CSP 拦截导致加载失败时,错误不会向外抛入常规 JavaScript 代码的try-catch栈,而是触发该 DOM 节点自身的error事件。 - 跨域脚本报错限制(Script error.):当加载来自第三方 CDN 的脚本且未配置
crossorigin属性时,若该脚本发生未捕获异常,宿主出于防信息泄露机制,全局window.onerror接收到的报错信息会被故意脱敏为模糊的"Script error.",行号和列号全部显示为 0。
二、未捕获异常的生命周期影响:进程崩溃与局部中断
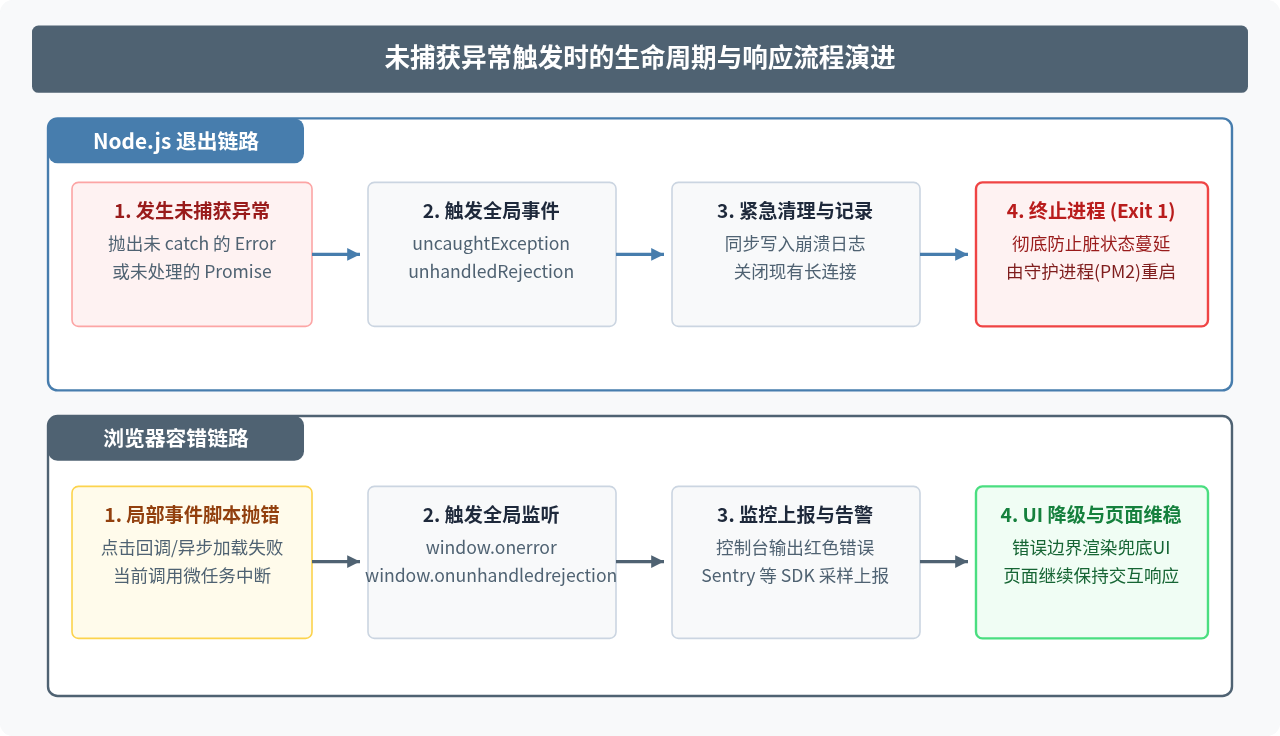
在日常开发中,最具实质影响的区别并不在于 try-catch 能够拦截什么,而在于当开发者“遗漏”了异常捕获时,宿主环境会做出什么反应。
1. Node.js:快速失败(Fail-Fast)与进程退出
在 Node.js 中,一旦某个未捕获异常冒泡至事件循环最顶层,或者一个 Promise 发生了 rejection 且没有 .catch() 处理,默认行为是向标准错误输出堆栈,并执行 process.exit(1) 退出整个进程。
// 示例:Node.js 中的未捕获异常
setTimeout(() => {
  throw new Error('异步定时器内抛出未捕获异常');
}, 100);

// 终端输出:
// /app/server.js:2
//   throw new Error('异步定时器内抛出未捕获异常');
//   ^
// Error: 异步定时器内抛出未捕获异常
//     at Timeout._onTimeout (/app/server.js:2:9)
// [Process exited with code 1]
很多初学者会尝试通过全局监听 process.on('uncaughtException', handler) 来强行吞掉异常、阻止程序退出:
// 危险的反模式:不要试图在 Node.js 中强行忽略异常继续运行!
process.on('uncaughtException', (err) => {
  console.error('捕获到了异常,但我选择忽略它:', err.message);
  // 不调用 process.exit(),继续让服务跑着
});
Node.js 官方文档明确将上述做法列为严重反模式。原因在于:未捕获异常发生时,整个 JavaScript 虚拟机的上下文可能处于未完成或不一致的状态(例如某个文件句柄打开了一半、数据库事务未提交、互斥锁未释放、闭包中的内存结构损坏)。继续运行该进程,将极易导致后续请求遭遇死锁、内存泄露或把错误的数据写入数据库。因此,Node.js 的最佳实践是:记录致命日志 -> 释放关键资源 -> 退出进程 -> 依靠外部守护进程(PM2、Docker 或 Kubernetes Pod)重启拉起全新干净的实例。
2. 浏览器:保护用户界面的高容错设计
浏览器的首要职责是保障终端用户的交互连续性。一个网页可能加载了来自几十个不同开发者的脚本、广告代码、统计 SDK。如果任何一个脚本的小报错都会导致整个标签页自毁关闭,用户正在编辑的表单、未保存的文稿就会立即丢失。
因此在浏览器中:
- 单个事件回调抛出异常,只会终止当前调用栈的后续语句,浏览器事件循环不会中断。
- 下一个鼠标点击、键盘输入或定时器依然能够照常执行。
- 未捕获的 Promise 拒绝会触发
unhandledrejection事件,并在开发者工具控制台以红色文字呈现,但不会打断主线程渲染。 - 现代前端框架(如 React 的 Error Boundary)更进一步,利用组件级生命周期将错误隔离在受损的局部树内,同时展示备用提示界面,其余组件完全不受牵连。
三、全局异常捕获 API 的定义与语义对比
两个环境都提供了在全局层面捕获遗漏异常的接口,但由于事件模型不同,对应的 API 与参数也有所区别:
| 对比维度 | Node.js 环境 | 浏览器端环境 |
|---|---|---|
| 同步未捕获异常 | process.on('uncaughtException', (err, origin) => {}) |
window.onerror = (message, source, lineno, colno, error) => {} 或 window.addEventListener('error', handler) |
| 未处理 Promise 拒绝 | process.on('unhandledRejection', (reason, promise) => {}) |
window.addEventListener('unhandledrejection', (event) => {}),通过 event.reason 获取 |
| DOM/静态资源加载错误 | 不支持(无 DOM 概念,由各模块 'error' 事件承担) |
只能在捕获阶段监听 window.addEventListener('error', handler, true),不会冒泡 |
| 默认终止后果 | 打印栈追踪至 stderr,立即退出当前进程(Exit Code 1) | 向开发者工具 Console 打印红色错误信息,保持页面存活 |
| 阻止默认行为能力 | 注册监听器即阻止立即崩溃(但不推荐以此维持运行) | 回调中返回 true 或执行 event.preventDefault() 可抑制控制台默认报错输出 |
四、堆栈信息、调试方式与环境排查路径
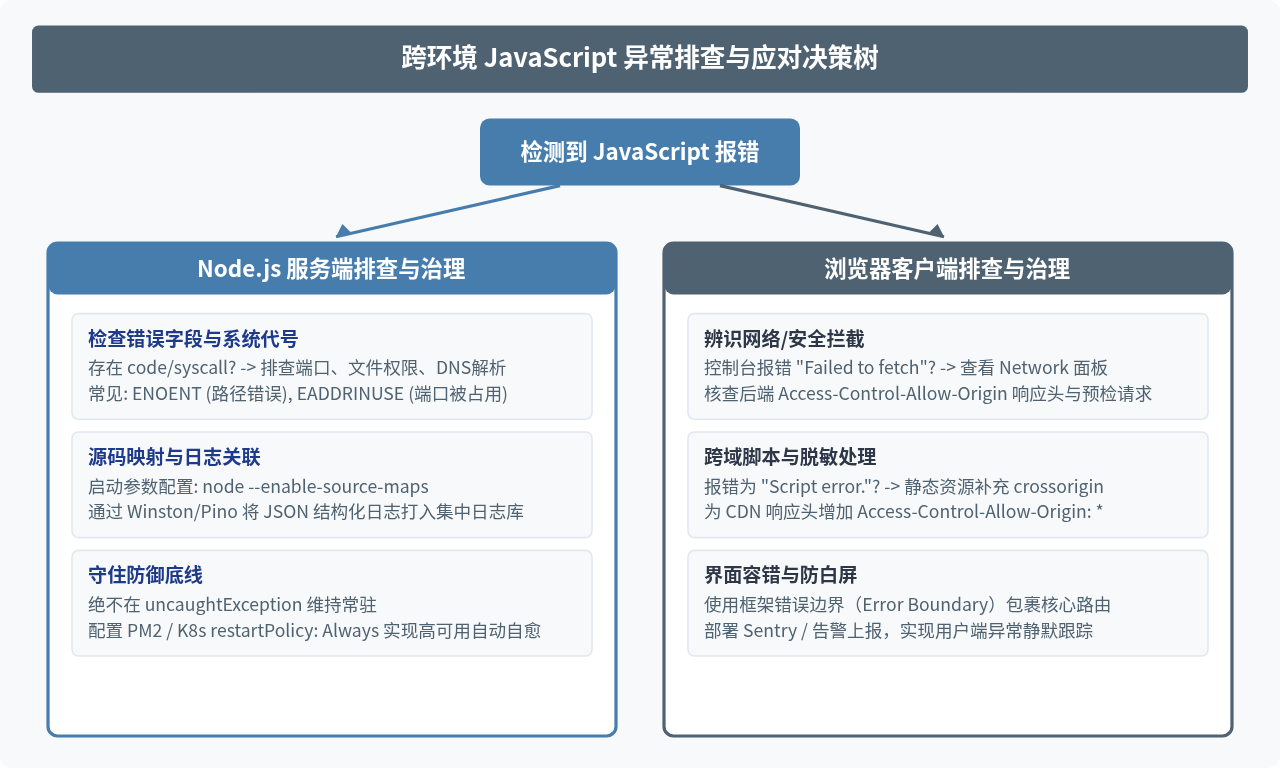
出现错误后,如何定位问题并获取第一手诊断线索,在两端也有不同的技术链路。
1. 终端纯文本与标准输出流
在 Node.js 中,所有的错误堆栈默认直接以 UTF-8 文本形式写入进程的 process.stderr。这使得它非常契合日志文件轮转、集中式日志收集系统(如 ELK、Datadog、Loki)。由于服务端代码常经过 TypeScript 编译或打包,原生输出的行号可能会偏移:
- Node.js 12.12.0+ 已原生支持 Source Maps,只需在启动命令中加上
--enable-source-maps:
此时 Node.js 会自动根据node --enable-source-maps dist/server.js.map文件将堆栈定位映射回原始.ts源码位置。 - 可以使用
node --inspect或--inspect-brk启动应用,通过 Chrome 浏览器地址栏访问chrome://inspect挂载可视化调试器,在服务端代码中下断点并实时检查作用域变量。
2. 浏览器 DevTools 图形化调试体验
浏览器端具有无与伦比的交互式排查工具。除了控制台打印,DevTools 提供了:
- 内建 Source Map 自动关联:点击报错行号直接跳转至经过解包还原的高亮源代码,并在旁边标注局部变量当前的值。
- 网络面板(Network)联合排查:当脚本报
TypeError: Failed to fetch时,直接切换至 Network 面板查看 HTTP 状态码、请求头、响应体、Timing 瀑布流以及 CORS 预检(OPTIONS)请求的状态。 - Pause on exceptions(异常时自动暂停):可以在开发者工具中开启“在发生异常时暂停代码执行”,让执行流直接停在抛错瞬间,无需预先手动下断点。
五、实际开发中的防护与避坑准则
在理解了两者的差异后,编写跨端或专用代码时可以遵循以下明确的处理规则:
- 不要把浏览器的“容错习惯”带到服务端:在浏览器里遗漏一个异步
catch可能只是控制台多一行红字,而在 Node.js 里会导致服务整个停摆。任何可能失败的异步 I/O、数据库操作和外部 HTTP 调用,必须使用try-catch或.catch()显式处理,或者由统一的 Web 框架中间件(如 Express/Koa/NestJS 的全局异常过滤器)兜底捕获。 - 错误码优先于正则匹配错误信息:在 Node.js 中判断错误原因时,永远先判断
err.code === 'ENOENT',而不是判断err.message.includes('no such file')。由于错误消息文本可能会随 Node.js 版本或操作系统语言发生微调,依赖静态code属性才能保证代码的高可用与跨版本稳定性。 - 服务端重在隔离与快速重启,客户端重在兜底与友好告知:Node.js 应用应坚决配合进程守护工具实施“崩溃即重启”,避免脏内存引发更大破坏;前端页面则应部署错误边界和友好的“页面加载失败,请点击重试”按钮,避免将代码技术堆栈直接甩给普通用户。
Node.js 安装配置与第一个 HTTP 服务器编写
2026-11-05 11:41:40
怎么使用 nvm 管理并平滑升级 Node.js 版本
2026-11-04 23:15:07
Node.js 怎么使用 zlib 模块解压 gzip 和 deflate
2026-11-03 23:40:50
直接覆盖安装还是用版本管理器?Node.js 升级方式对比
2026-11-03 22:59:07
Express.js 是什么:Node.js Web 框架核心概念与适用场景
2026-11-03 20:00:12
相关标签:







