

Node.js 怎么使用 zlib 模块解压 gzip 和 deflate
深入讲解在 Node.js 中如何使用内置 zlib 模块解压 gzip 和 deflate 数据。涵盖 Buffer 内存解压、Stream 管道流解压、标准 deflate 与 raw deflate 的底层差异以及常见报错排查。
一、gzip 与 deflate 的核心差异与 API 对应关系
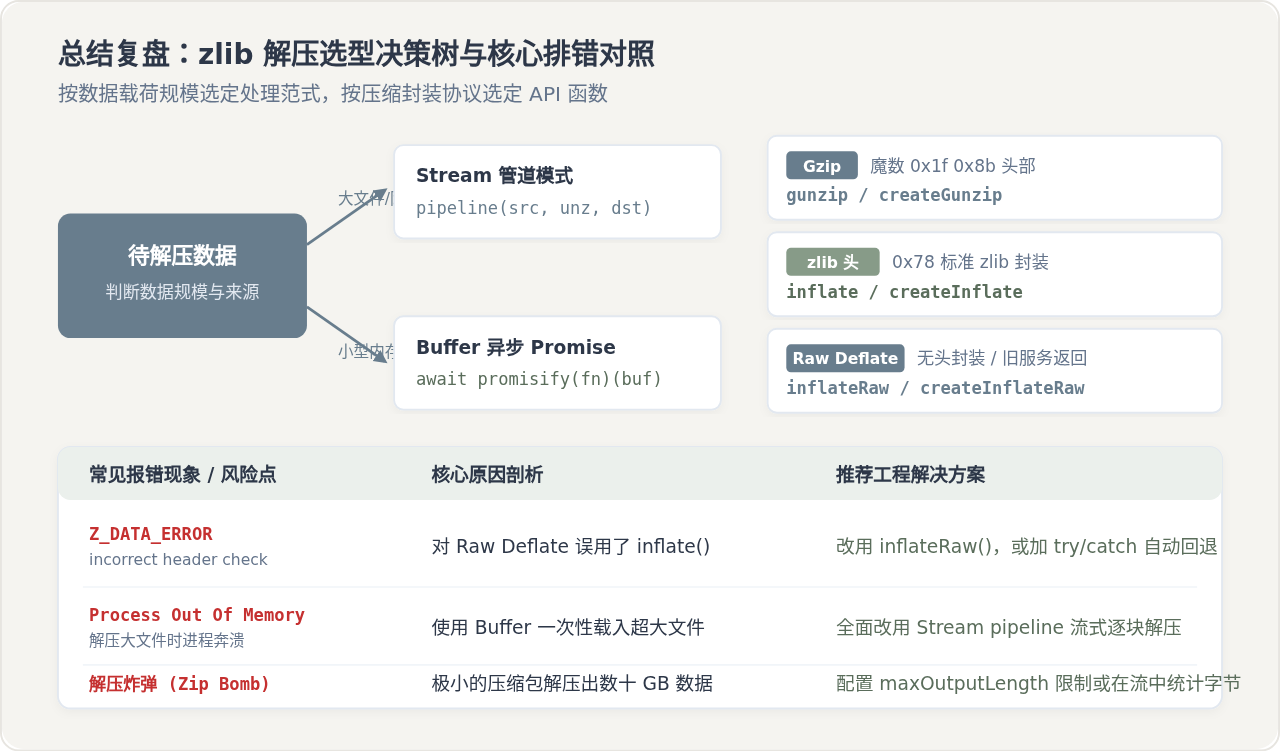
许多开发者在调用 Node.js 的 zlib 时,最常遇到的挫折是明明拿到了 deflate 格式的数据,调用 zlib.inflate() 却报错 incorrect header check。要正确选用解压方法,必须先理解 gzip 和 deflate 在数据包装层面的本质区别。
在算法层面上,gzip 与 deflate 的核心压缩算法都是 DEFLATE 算法(结合了 LZ77 算法与哈夫曼编码)。它们的主要差异体现在数据外层的“容器封装”(即头部与尾部校验信息):
- gzip(RFC 1952):包含固定为
0x1F 0x8B的 2 字节魔数(Magic Number)、时间戳、文件名以及 8 字节的尾部(包含 CRC-32 校验和与解压前原始大小)。Node.js 中统一通过gunzip/createGunzip处理。 - 标准 Deflate / zlib 格式(RFC 1950):包含 2 字节的 zlib 头部(常以
0x78开头,定义了压缩级别与窗口大小)以及 4 字节的 Adler-32 校验尾部。Node.js 中通过inflate/createInflate处理。 - 原始 Deflate / Raw Deflate(RFC 1951):没有任何文件头,也没有任何校验尾,只有纯粹的 DEFLATE 压缩数据块。历史上微软 IIS 服务器或部分压缩包内部存储直接输出该格式。Node.js 中必须通过
inflateRaw/createInflateRaw处理。
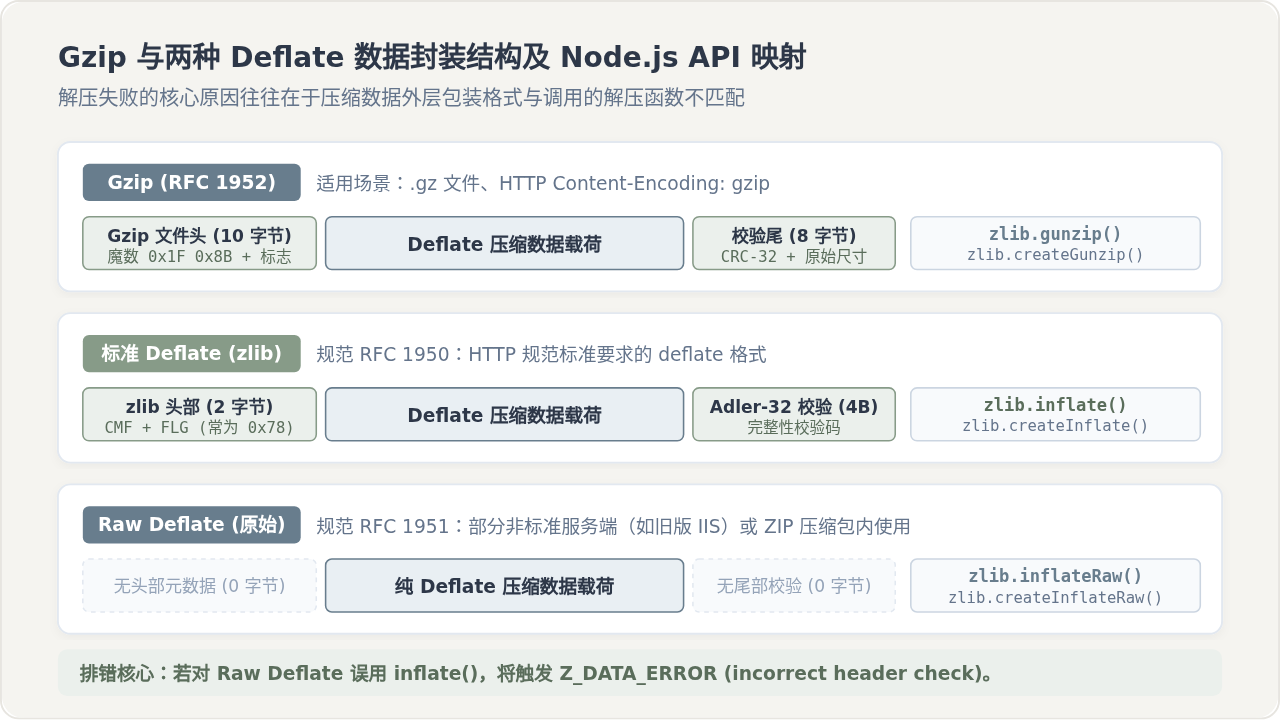
| 压缩格式 | 规范标准 | 头部特征 | Buffer 解压 API | Stream 解压 API |
|---|---|---|---|---|
| Gzip | RFC 1952 | 0x1F 0x8B(10 字节头) |
zlib.gunzip |
zlib.createGunzip |
| Deflate (zlib) | RFC 1950 | 0x78 0x01 / 0x9C / 0xDA(2 字节头) |
zlib.inflate |
zlib.createInflate |
| Raw Deflate | RFC 1951 | 无任何头部元数据(0 字节) | zlib.inflateRaw |
zlib.createInflateRaw |
二、Buffer 内存数据解压(异步与 Promise 化)
如果待解压数据已经在内存中(例如小体积的 API 响应载荷、数据库中存储的压缩字段),推荐使用 Buffer 方式处理。Node.js 默认提供的 zlib.gunzip 与 zlib.inflate 采用回调函数签名 (err, result) => {}。在现代异步编程中,推荐使用 node:util 的 promisify 转换为 async/await 语法。
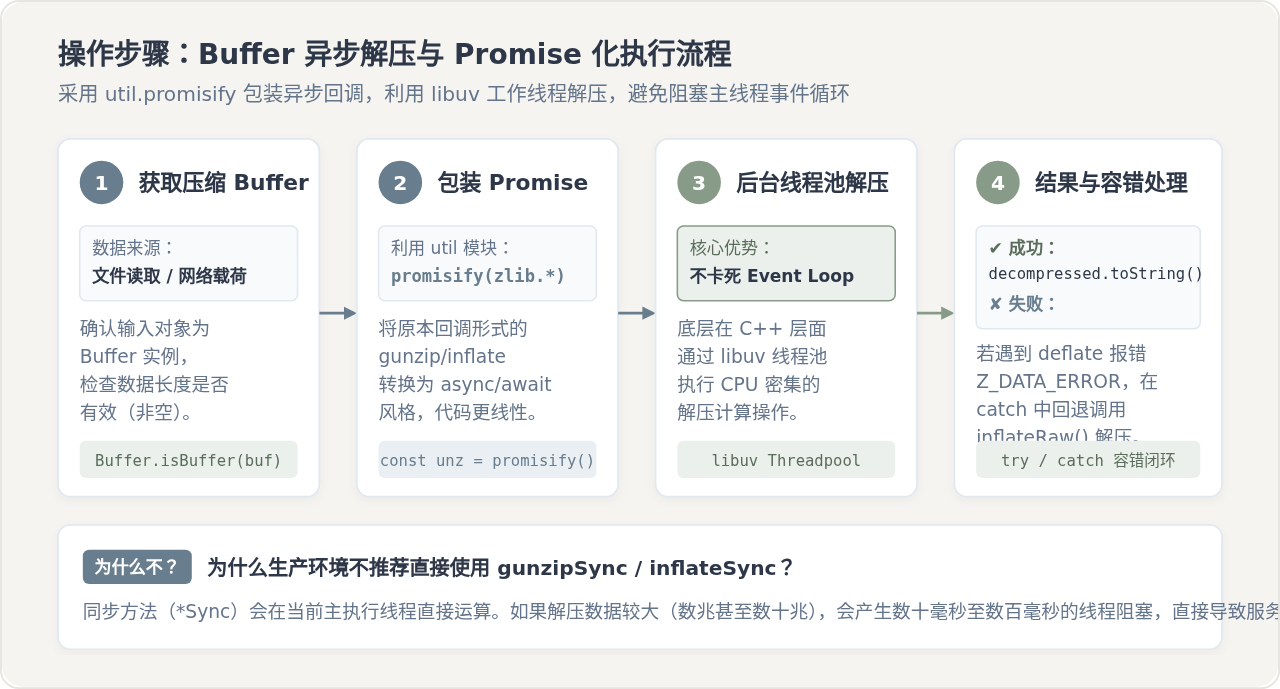
1. 解压 Gzip Buffer 完整示例
下面的代码演示如何将一个已经经过 gzip 压缩的 Buffer 异步还原为原始字符串,并对潜在的错误进行捕获:
import zlib from 'node:zlib';
import { promisify } from 'node:util';

// 转换为 Promise 函数
const gunzipAsync = promisify(zlib.gunzip);

async function decompressGzip(compressedBuffer) {
  if (!Buffer.isBuffer(compressedBuffer) || compressedBuffer.length === 0) {
    throw new TypeError('输入必须为非空的 Buffer 实例');
  }

  try {
    // 在 libuv 线程池中后台执行解压,不阻塞事件循环
    const decompressed = await gunzipAsync(compressedBuffer);
    return decompressed.toString('utf-8');
  } catch (error) {
    // 捕获损坏数据或非 gzip 格式引起的解压异常
    throw new Error(`Gzip 解压失败: ${error.message}`);
  }
}

// 验证示例
const originalText = 'Hello, Node.js zlib!';
const sampleGzip = zlib.gzipSync(Buffer.from(originalText));

decompressGzip(sampleGzip).then((result) => {
  console.log('解压成功:', result); // 输出: Hello, Node.js zlib!
});
2. 解压 Deflate Buffer 与格式自动回退
在处理 HTTP 请求返回的 Content-Encoding: deflate 时,常常无法提前得知对方发送的是标准 zlib 封装还是原始 raw deflate。最佳工程实践是:优先尝试 zlib.inflate(),若捕获到 Z_DATA_ERROR(通常 code 为 'Z_DATA_ERROR'),则自动降级使用 zlib.inflateRaw():
import zlib from 'node:zlib';
import { promisify } from 'node:util';

const inflateAsync = promisify(zlib.inflate);
const inflateRawAsync = promisify(zlib.inflateRaw);

async function decompressDeflate(compressedBuffer) {
  if (!Buffer.isBuffer(compressedBuffer) || compressedBuffer.length === 0) {
    throw new TypeError('输入必须为非空的 Buffer 实例');
  }

  try {
    // 首先尝试标准 RFC 1950 (带有 zlib 包装头)
    const decompressed = await inflateAsync(compressedBuffer);
    return decompressed.toString('utf-8');
  } catch (err) {
    // 针对头部缺失导致的错误,自动尝试 Raw Deflate (RFC 1951)
    if (err.code === 'Z_DATA_ERROR') {
      const rawDecompressed = await inflateRawAsync(compressedBuffer);
      return rawDecompressed.toString('utf-8');
    }
    throw err;
  }
}

// 验证示例:测试 Raw Deflate 数据
const rawDeflateData = zlib.deflateRawSync(Buffer.from('原始 Deflate 内容'));
decompressDeflate(rawDeflateData).then((res) => {
  console.log('自适应解压结果:', res); // 成功回退并输出: 原始 Deflate 内容
});zlib.gunzipSync() 和 zlib.inflateSync() 虽然简单直观,但它们在当前执行线程同步解压。解压算法属于 CPU 密集型任务,当数据达到数十兆时,会导致 Node.js 主线程停顿,阻塞所有的并发网络请求。因此,同步方法仅适合本地构建脚本或 CLI 离线工具。
三、Stream 流式解压(大文件与网络传输)
当解压几十兆至数吉字节的文件,或者处理 HTTP 响应流时,绝不能将整个数据读取到内存中再解压,否则会迅速耗尽进程内存(OOM)。此时应当使用 Node.js 的流式管道(Stream Pipeline)。
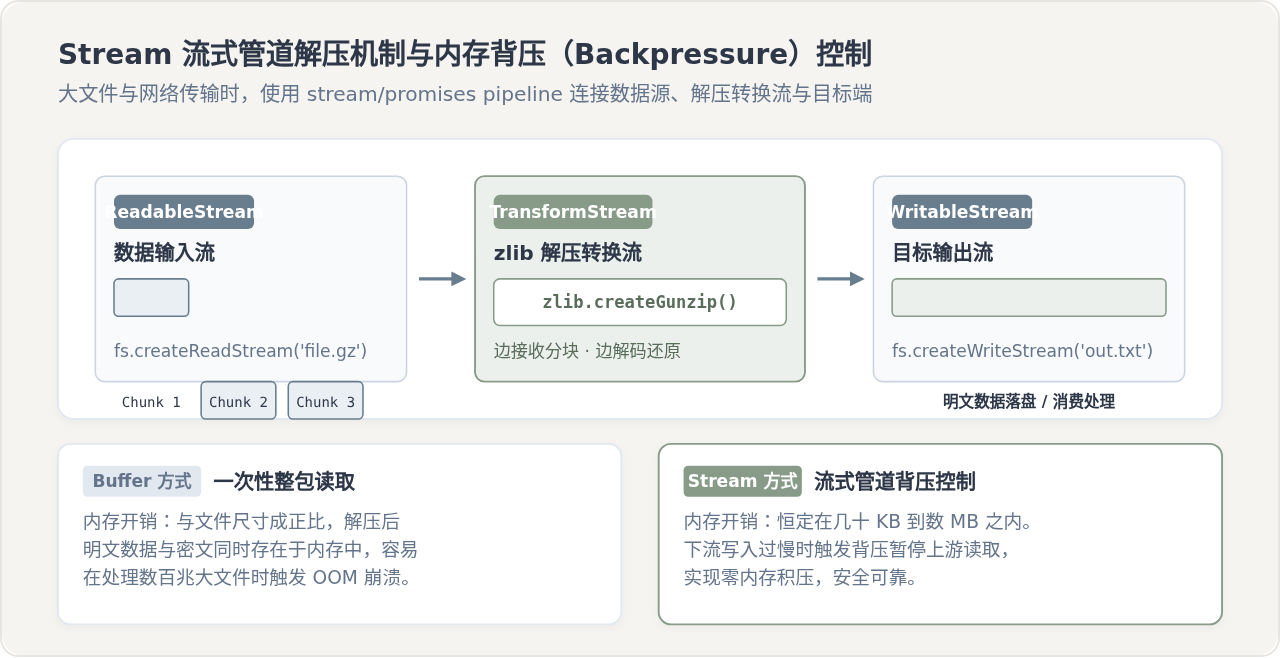
1. 大文件流式解压示例
使用 node:stream/promises 中的 pipeline,可以安全地将输入文件流、解压转换流和输出文件流连接起来。一旦发生读取、解压或写入错误,pipeline 会自动销毁所有流并释放文件描述符:
import fs from 'node:fs';
import zlib from 'node:zlib';
import { pipeline } from 'node:stream/promises';

async function extractGzipFile(sourcePath, destinationPath) {
  const readStream = fs.createReadStream(sourcePath);
  const gunzipStream = zlib.createGunzip();
  const writeStream = fs.createWriteStream(destinationPath);

  try {
    // 管道按块传输(Chunk 通常为 64KB),内存占用恒定
    await pipeline(readStream, gunzipStream, writeStream);
    console.log('文件解压完成并已安全落盘');
  } catch (error) {
    console.error('流式解压过程中断:', error.message);
    throw error;
  }
}

// 示例调用:
// await extractGzipFile('archive.tar.gz', 'archive.tar');
2. 处理 HTTP 响应中的 gzip / deflate 压缩流
当使用 Node.js 原生 node:http 发起请求时,服务端如果返回了压缩数据,响应头中的 content-encoding 会标明压缩类型。下面的代码展示了如何根据响应头动态选择解压流:
import http from 'node:http';
import zlib from 'node:zlib';

function fetchAndDecompress(url) {
  http.get(url, (res) => {
    const encoding = res.headers['content-encoding'];
    let stream = res;

    // 根据服务端 Content-Encoding 选择匹配的解压转换流
    if (encoding === 'gzip') {
      stream = res.pipe(zlib.createGunzip());
    } else if (encoding === 'deflate') {
      // 使用 createUnzip 可以同时兼容 gzip 与带 zlib 头的 deflate
      stream = res.pipe(zlib.createInflate());
    }

    const chunks = [];
    stream.on('data', (chunk) => chunks.push(chunk));
    stream.on('end', () => {
      const body = Buffer.concat(chunks).toString('utf-8');
      console.log('响应解析完成,总字符数:', body.length);
    });
    stream.on('error', (err) => {
      console.error('解压或网络流发生错误:', err.message);
    });
  });
}
四、常见报错与安全注意事项
1. zlib.createUnzip() 的适用边界
Node.js 提供了 zlib.unzip() 和 zlib.createUnzip()。它的特点是能够自动检测头部:如果数据以 gzip 魔数开头就按 gzip 解压,如果是 zlib 头部就按 deflate 解压。但需要强调的是,unzip 不支持 Raw Deflate(无头压缩)。如果遇到无头数据,仍然会抛出错误。
2. 防范解压炸弹(Zip Bomb / Decompression Bomb)
在接收不受信任的外部压缩包或请求体时,攻击者可能构造数 KB 大小但解压后膨胀为数十 GB 的恶意数据。为了防止服务器内存被撑爆,可以在创建解压流或调用解压方法时,传入 maxOutputLength 选项限定最大解压输出字节数:
// 限制最大解压体积为 10MB,超出则立即抛出 ERR_BUFFER_TOO_LARGE 错误
const safeGunzip = promisify(zlib.gunzip);
try {
  const safeBuffer = await safeGunzip(inputBuffer, {
    maxOutputLength: 10 * 1024 * 1024 // 10 MB
  });
} catch (err) {
  if (err.code === 'ERR_BUFFER_TOO_LARGE') {
    console.error('警告:解压数据超过预设的安全上限,已中断处理');
  }
}
Node.js 安装配置与第一个 HTTP 服务器编写
2026-11-05 11:41:40
怎么使用 nvm 管理并平滑升级 Node.js 版本
2026-11-04 23:15:07
直接覆盖安装还是用版本管理器?Node.js 升级方式对比
2026-11-03 22:59:07
Express.js 是什么:Node.js Web 框架核心概念与适用场景
2026-11-03 20:00:12
VS Code怎么一键运行Js脚本?Code Runner插件配置步骤
2026-11-03 15:42:30







