JS解析URL:字符串分割与URL API性能对比
详细评测JavaScript中解析URL的两种主流技术路线:基于字符串分割的轻量切片与基于WHATWG规范的URL API。结合底层运行原理、性能基准数据与边界安全陷阱,提供实际工程选型方案。
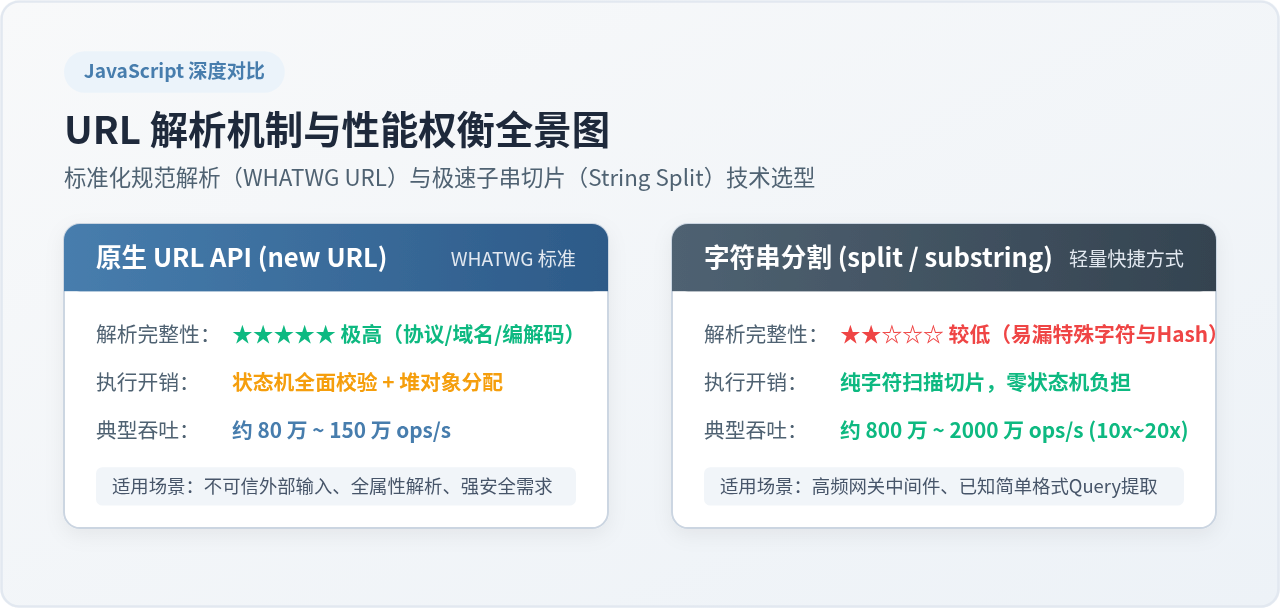
new URL() 与 URLSearchParams,二是借助原生的 split()、indexOf() 进行字符串切分。实测表明,在纯粹的单项参数解析吞吐量上,简单的字符串操作由于避免了 WHATWG 规范的复杂状态机与对象创建,运行速度可达标准 API 的 10 到 20 倍;但在协议解析、字符转义、Hash 隔离与格式校验等工程鲁棒性维度上,标准 API 具有无法替代的正确性保障。
一、两种解析路径的核心实现差异
为了直观理解这两种方式的异同,我们以常见的“从 URL 中获取指定参数 id 的值”为例,考察两者的具体实现方式。
1. 使用 WHATWG URL 与 URLSearchParams API
自 ECMAScript 与浏览器环境统一推行 WHATWG URL 标准后,window.URL(或 Node.js 内置的 URL 模块)已成为官方推荐的标准工具。它不仅能解析查询参数,还能完整抽取 protocol、host、pathname、hash 等各个组成要素。
// 标准 URL API 提取指定参数
function getParamViaURL(urlString, key) {
  try {
    const url = new URL(urlString);
    return url.searchParams.get(key);
  } catch (e) {
    // 遇到非绝对路径或非法 URL 字符串时,new URL 会直接抛出 TypeError
    return null;
  }
}

// 仅针对 QueryString 字符串提取(例如 "?id=1001&tag=js")
function getParamViaSearchParams(queryString, key) {
  const params = new URLSearchParams(queryString);
  return params.get(key);
}
2. 使用原生字符串操作(split 与 indexOf)
字符串方式通常假定 URL 遵循标准问号分隔规律,通过切除前缀并遍历键值对列表来查找匹配项。
// 基于 split 的直观切分方案
function getParamViaSplit(urlString, key) {
  const questionIndex = urlString.indexOf('?');
  if (questionIndex === -1) return null;

  // 截取问号后面的查询字符串,并去除可能的 # 锚点
  let query = urlString.slice(questionIndex + 1);
  const hashIndex = query.indexOf('#');
  if (hashIndex !== -1) {
    query = query.slice(0, hashIndex);
  }

  const pairs = query.split('&');
  for (let i = 0; i < pairs.length; i++) {
    const pair = pairs[i];
    const eqIndex = pair.indexOf('=');
    if (eqIndex !== -1) {
      const k = pair.slice(0, eqIndex);
      if (k === key) {
        return decodeURIComponent(pair.slice(eqIndex + 1));
      }
    }
  }
  return null;
}

// 基于 indexOf + substring 的零临时数组极速提取
function getParamFastIndex(urlString, key) {
  const qIndex = urlString.indexOf('?');
  if (qIndex === -1) return null;

  const target = key + '=';
  let start = urlString.indexOf(target, qIndex + 1);
  while (start !== -1) {
    // 确保匹配位置位于参数开头(即前一位为 ? 或 &)
    const prevChar = urlString.charAt(start - 1);
    if (prevChar === '?' || prevChar === '&') {
      const valStart = start + target.length;
      let valEnd = urlString.indexOf('&', valStart);
      if (valEnd === -1) {
        valEnd = urlString.indexOf('#', valStart);
        if (valEnd === -1) valEnd = urlString.length;
      }
      return decodeURIComponent(urlString.substring(valStart, valEnd));
    }
    start = urlString.indexOf(target, start + 1);
  }
  return null;
}
二、底层执行开销与性能差距的根源
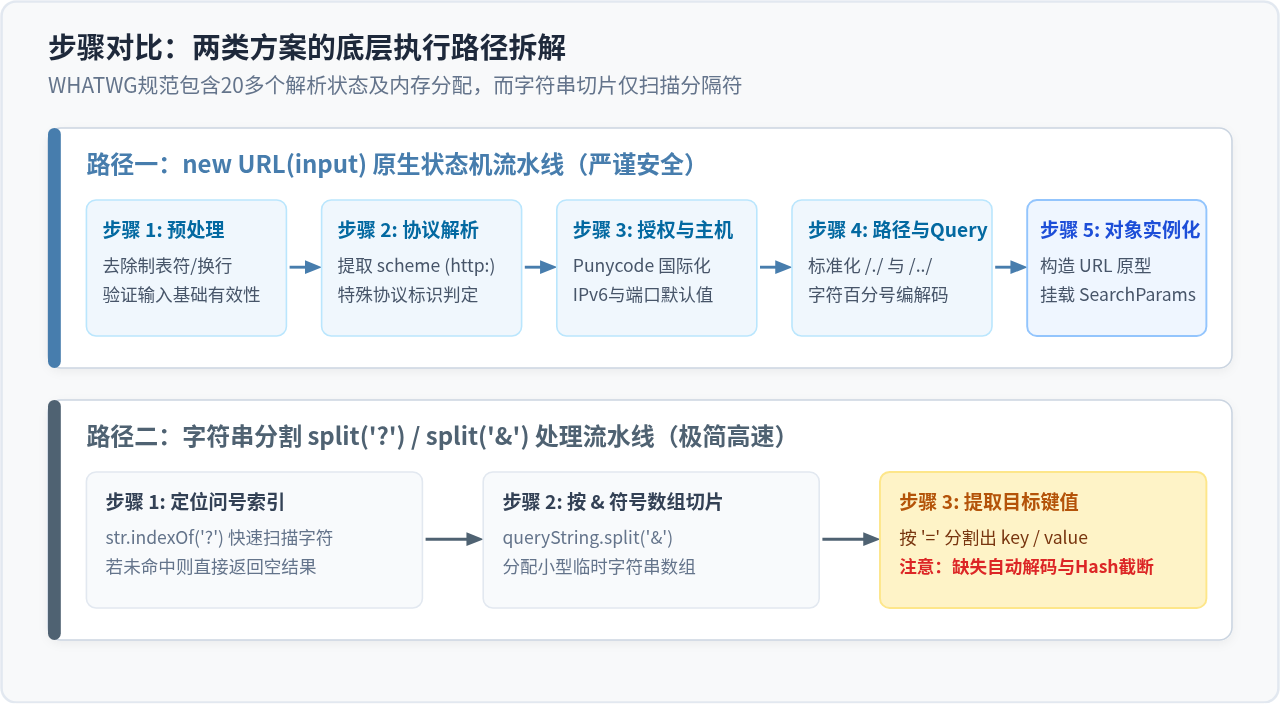
通过图 1 的执行路径可以看出,两者之所以存在巨大的性能鸿沟,根本原因在于责任范围的悬殊:
-
规范状态机运转成本:WHATWG URL 规范定义了极其详尽的 URL 语法解析状态机,覆盖前导空白修剪、协议特异性规则(如
file:与http:的特殊斜杠折叠)、IPv6 方括号校验、Punycode 国际化域名转换、非法字符百分号自动编码以及/../路径正规化。每一行new URL()代码都在严格执行这套全生命周期检查。 -
内存分配与垃圾回收 (GC) 负担:
new URL()是一个完整的复合对象,在 V8 引擎内部实例化时,不仅在堆上分配该对象本身的属性槽位,同时会自动构建关联的URLSearchParams映射表及内部字符串指针。而在字符串切片中,V8 借助底层SlicedString或栈内存索引,几乎不需要频繁触发 Minor GC。 -
纯字符串算法的极简短路:像
indexOf这样以底层 C++ 编写的字符串检索函数,指令流水线高度优化,只需线性移动单字节指针。一旦目标字符不存在或迅速命中,耗时仅需几个纳秒。
三、URL 结构全貌与字符串切分常见陷阱
许多开发者倾向于在所有场景中直接写 split('?')[1].split('&'),但这种看似轻便的写法在面对真实生产流量时,极易踩入边界条件的暗坑。
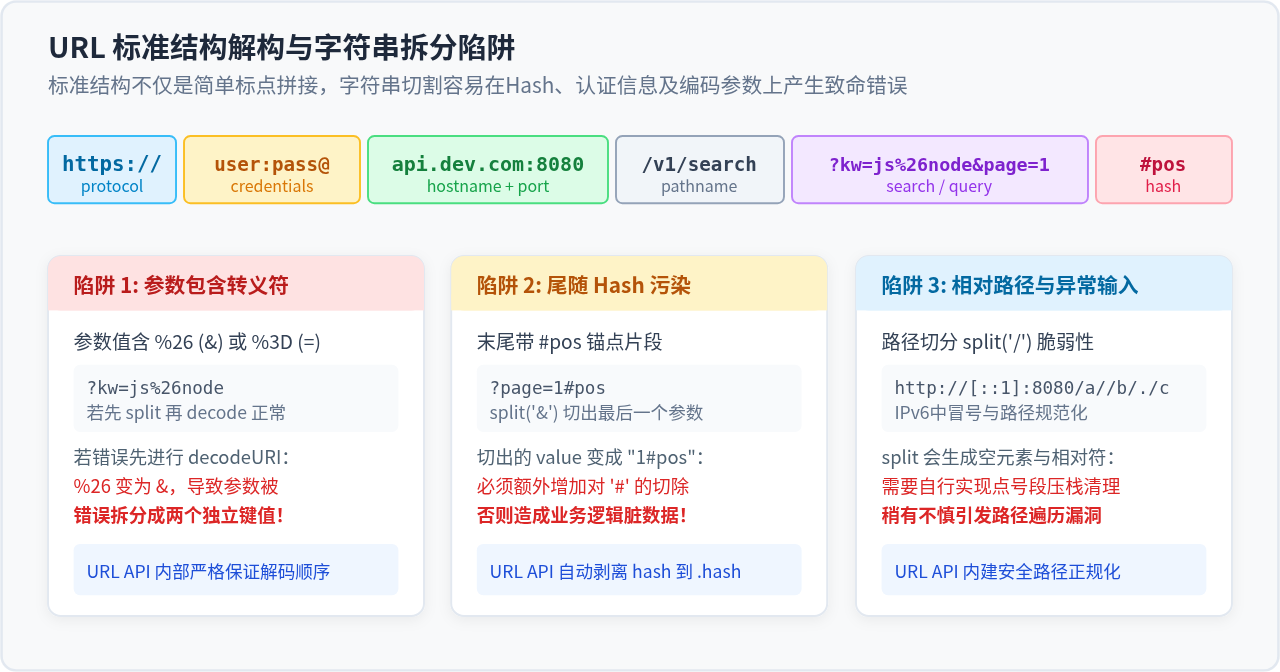
结合图 2,以下四个场景是字符串分割最容易导致线上 Bug 的地方:
1. 误将包含特殊编码字符的 URL 提前解码
如果 URL 参数本身包含经 URL 编码的符号(例如 ?keyword=A%26B,其中 %26 代表普通字符 &)。若开发者错误地先执行了 decodeURI(url).split('&'),%26 会被提前还原成 &,从而把一个完整的参数值粗暴切割为 keyword=A 和 B 两个畸形参数。正确的做法必须是先切分出键值对,再分别对键与值执行 decodeURIComponent。
2. 末尾 Hash 锚点片段的污染
前端单页面应用(SPA)或页面跳转经常包含锚点,形如 https://example.com/page?id=100#profile。如果仅写 url.split('?')[1].split('&'),最后一个提取出来的键值对值将是 100#profile,直接导致整型转换失败(parseInt 得到 NaN 或错误截断)或后端数据库查询不到对应主键。
3. 重复参数键(Multi-value Keys)与空值处理
在合法的 URL 规范中,同名键可以多次出现,例如 ?filter=red&filter=blue,或者存在无值布尔参数 ?verbose。URLSearchParams.getAll('filter') 可以规范地返回数组,而手写的分割逻辑若简单使用 obj[k] = v 则会直接发生覆盖覆盖丢失历史值。
4. 相对路径与协议缺失
new URL('/api/v1/user?id=1') 会直接报错,必须传入基准路径 new URL(path, 'http://localhost')。反之,字符串切分虽然对相对路径“照切不误”,但无法判断该路径是否符合合法 URL 格式。
四、基准性能测试与数据评测
为了量化两者的运行差异,我们在 Node.js 20 (V8 11.3) 环境下针对包含 3 个典型参数的标准 URL 进行了 1,000,000 次高频解析基准测试。以下是各方法的测试数据汇总:
| 解析实现方案 | 每秒操作数 (Ops/sec) | 单次操作平均耗时 | 堆内存分配 (每次解析) | 安全性与完整性 |
|---|---|---|---|---|
indexOf + substring (单目标提取) |
~23,450,000 | ~42 ns | ~0 字节 (极低) | 低 (仅匹配单键,易受歧义干扰) |
split('?') + split('&') (全参数切分) |
~16,800,000 | ~59 ns | ~48 字节 (生成小数组) | 中 (需自行处理Hash与解码) |
预编译正则表达式 (RegExp.exec) |
~7,200,000 | ~138 ns | ~32 字节 | 中 (正则回溯,长URL易抖动) |
new URLSearchParams(query) |
~3,650,000 | ~274 ns | ~80 字节 | 高 (仅限Query,正确处理编码) |
new URL(fullUrl) (完整标准解析) |
~1,150,000 | ~870 ns | ~168 字节 | 最高 (全面校验协议、域名、路径) |
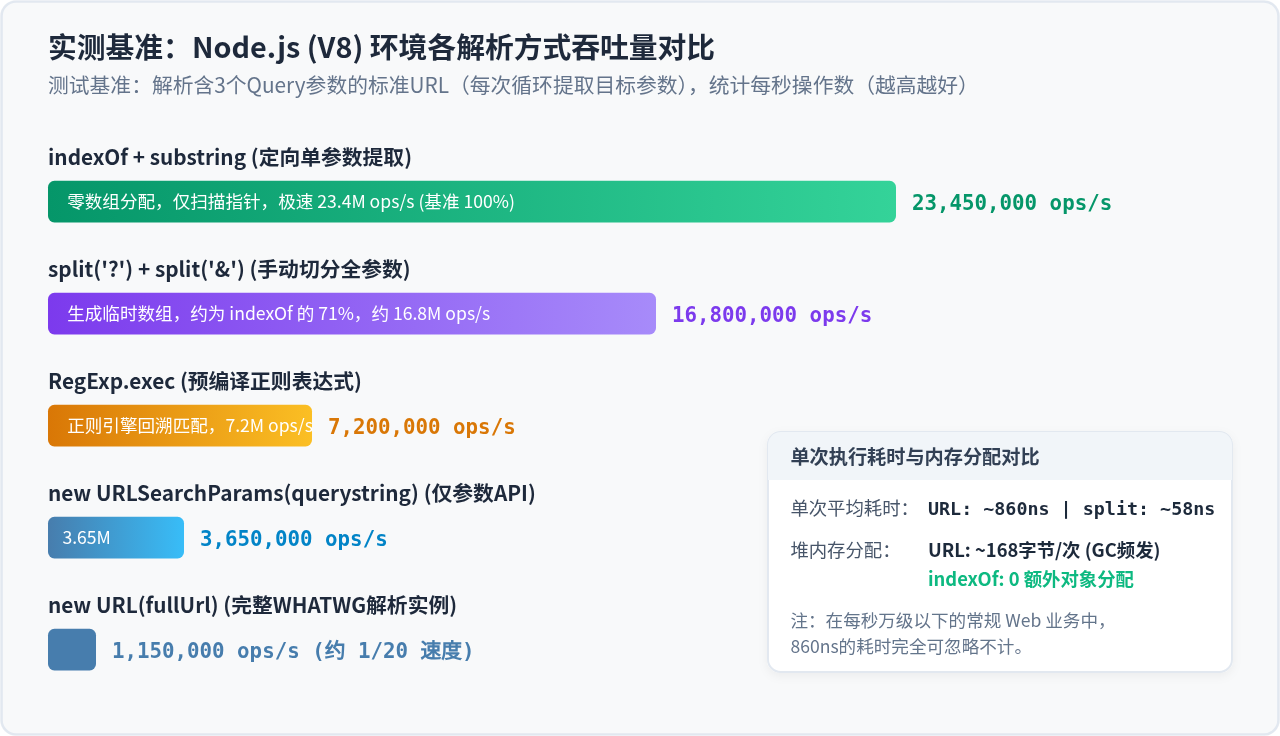
测试结果揭示出客观事实:
-
绝对倍率差异:单看提取参数的效率,手工字符串扫描的速度是完整
new URL()的 20 倍左右,是单独URLSearchParams的 6.4 倍。 -
微观时间尺度:尽管相差 20 倍,但
new URL()单次耗时仅约 870 纳秒(即 0.00087 毫秒)。这意味着,在常规的前端路由跳转、点击事件触发,或者每秒请求量在数百至数千次的普通后端 Web 控制器中,该耗时在整体网络 I/O 与业务渲染耗时面前,占比完全可以忽略不计。 -
GC 敏感场景的累计影响:当应用于高并发 API 网关、日志实时流处理或消息队列消费中转(单机 QPS > 50,000)时,频繁调用
new URL()产生的对象堆积会显著加速 V8 新生代(Scavenge)垃圾回收,产生可感知的微停顿(GC Pause)。
五、工程实践选型决策指南
脱离业务场景谈论“性能优劣”没有实际价值。选择 URL 解析方案的原则应当是:在满足安全正确的前提下,优先考虑代码健壮性与可维护性;仅在可证实的性能瓶颈处采用优化手段。
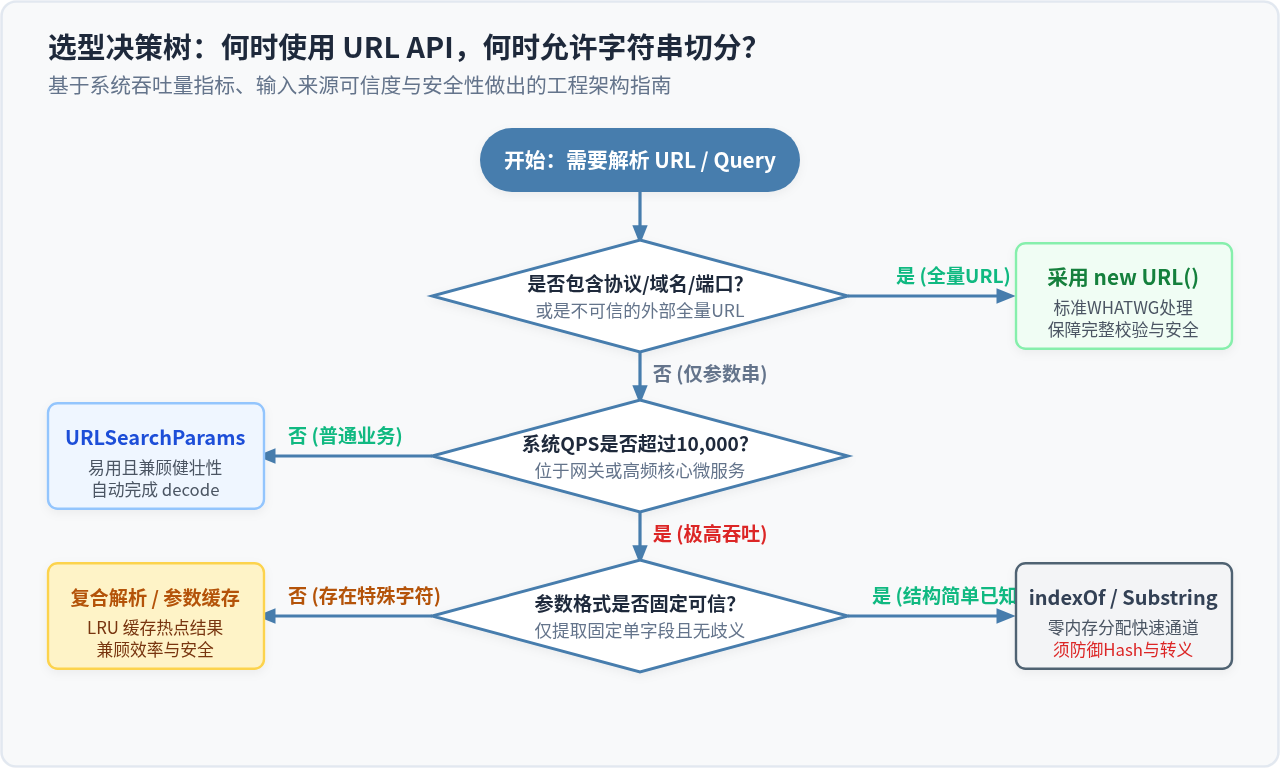
场景选型建议:
-
前端 SPA 页面与业务后台:推荐一律采用
new URL()与URLSearchParams。现代前端开发更看重代码健壮性。标准 API 自动管理各种异构 URL、正确解析同名参数、严格校验输入,能够杜绝 99% 由手工字符拆分引起的诡异边界 Bug。 -
高吞吐微服务网关与中间件:如果路由层只需要提取一个固定的路由参数(例如追踪用
traceId或租户标识tenant_id),且该服务每秒处理数万请求,采用带边界保护的indexOf + substring快速路径能够有效降低 CPU 占用并抑制堆内存震荡。 -
复合折中策略(Fast-Path with Fallback):在高并发模块中,可先用简单的字符串检测快速识别格式规范的参数;若检测到包含复杂编码、数组参数或特殊符号,再回退到
URLSearchParams进行规范解析,从而兼顾极速与安全。
纯前端js导出word大文件性能优化:分片处理与内存管理
2026-11-16 13:42:41
JS substring、slice与正则实现首字母大写对比
2026-11-16 13:42:14
JavaScript基础选择题常见的性能陷阱有哪些
2026-11-08 22:57:06
JavaScript框架库漏洞用多了页面变卡怎么优化
2026-11-08 21:10:22
JavaScript框架库漏洞偶发失败怎么复现和定位
2026-11-08 19:54:56