

JS substring、slice与正则实现首字母大写对比
深入对比 JavaScript 中使用 slice、substring 与正则表达式实现首字母大写的技术方案,剖析 API 索引机制、负数陷阱、执行性能及边界安全,提供不同场景下的工程选型建议。
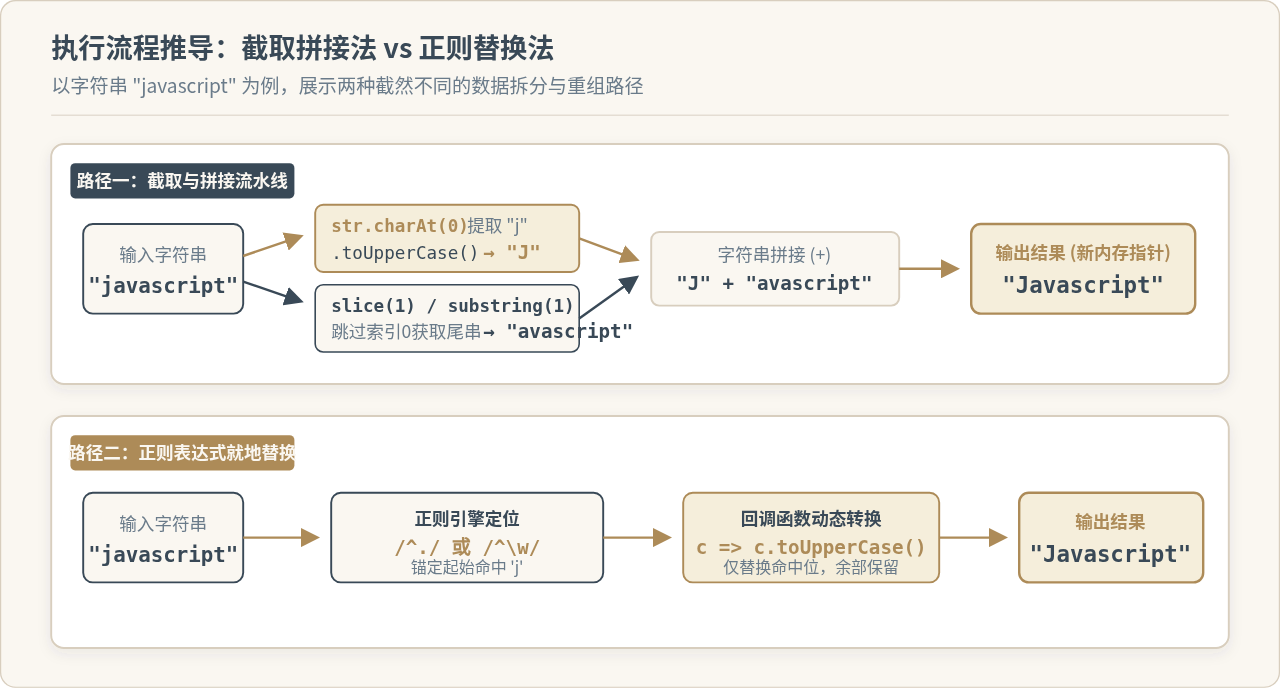
slice 与 substring 方案,以及基于模式匹配的正则表达式 replace 方案。前两者依赖“取首字母大写 + 截取后续子串”的拼接流水线,但在负数索引支持与参数倒序容错机制上存在本质差异;后者则依托正则引擎的原生捕获与回调替换,代码精简且能直接扩展至多词 Title Case 转换。理解这三者的机制边界、性能权衡与异常防护,是编写健壮前端字符处理代码的必备功底。
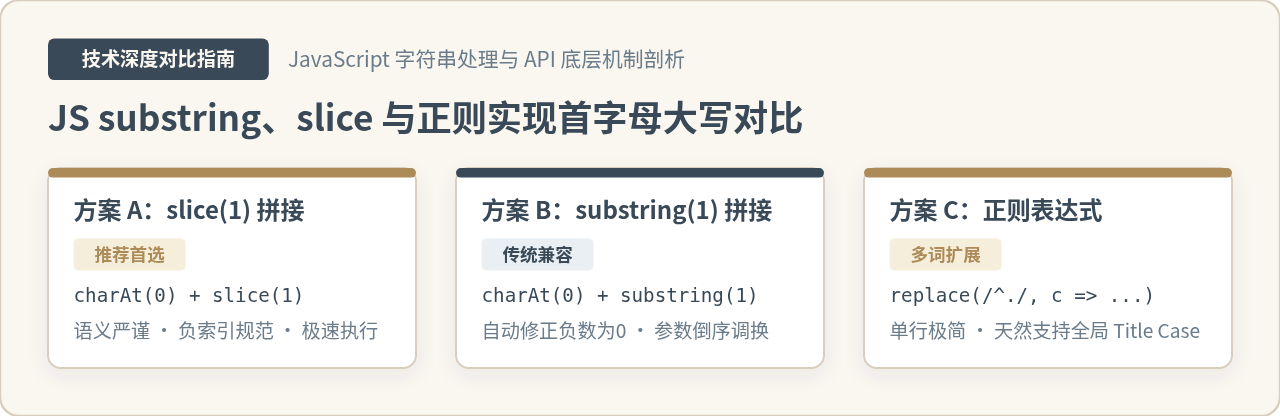
一、方案实现与代码拆解
将字符串首字母大写本质包含两个动作:定位并转换首个有效字符,以及安全地保留其余子串。下面分别给出三种方式的基准实现代码与关键细节。
1. 基于 slice(1) 的拼接实现
该方案是现代 JavaScript 开发中使用最为广泛的惯用写法。通过安全提取索引为 0 的字符转换大写后,调用 slice(1) 截取从索引 1 直到末尾的所有字符:
function capitalizeBySlice(str) {
  if (!str) return '';
  return str.charAt(0).toUpperCase() + str.slice(1);
}

// 运行测试
console.log(capitalizeBySlice('javascript')); // "Javascript"
console.log(capitalizeBySlice('a'));          // "A"
console.log(capitalizeBySlice('')); // ""str.charAt(0) 而非 str[0]?当处理空字符串
"" 时,"".charAt(0) 会返回空字符串 "",调用 "".toUpperCase() 依然是 "",随后拼接 "".slice(1)(同样为 "")可安全返回空串;而 ""[0] 会得到 undefined,直接执行 undefined.toUpperCase() 会引发致命的 TypeError。
2. 基于 substring(1) 的拼接实现
substring 是 ECMAScript 早期即存在的传统 API,其首字母大写的代码结构与 slice 几乎一致:
function capitalizeBySubstring(str) {
  if (!str) return '';
  return str.charAt(0).toUpperCase() + str.substring(1);
}

// 运行测试
console.log(capitalizeBySubstring('frontend')); // "Frontend"
console.log(capitalizeBySubstring(''));         // ""
在正向提取剩余子串时,substring(1) 和 slice(1) 的行为完全一致。两者的核心分歧在于对非法参数、负数以及参数顺序的处理逻辑。
3. 基于正则表达式的 replace 实现
利用 String.prototype.replace 与正则表达式,可以在不手动分割字符串的情况下,直接定位目标字符并执行局部变换:
// 方式 A:匹配字符串绝对起始字符
function capitalizeByRegex(str) {
  return str ? str.replace(/^./, (char) => char.toUpperCase()) : '';
}

// 方式 B:精准匹配首个英文单词字符(防止首位为特殊符号时误触)
function capitalizeWordChar(str) {
  return str ? str.replace(/^[a-z]/i, (char) => char.toUpperCase()) : '';
}

console.log(capitalizeByRegex('node')); // "Node"
console.log(capitalizeByRegex(''));     // ""
正则方案的一大亮点是天生具备极高的灵活性,通过微调匹配表达式,可以瞬间支持全句每个词的首字母大写,而无需通过 split(' ') 拆分成数组重新循环。
二、深入机制剖析:slice 与 substring 的本质差异
初学者常误以为 slice 与 substring 只是同一个功能的不同命名,实则两者在规范定义、底层参数归一化及异常控制上有着截然不同的设计哲学。
1. 负数索引的处理逻辑(Negative Index)
在 JavaScript 规范中,slice 具有现代数组与类序列的通用特性,支持传入负整数作为从末尾倒数的索引:
str.slice(-n)会被自动换算为str.slice(str.length - n)。例如长度为 8 的字符串,slice(-3)等价于slice(5)。str.substring(-n)则采用了极其古老的容错设计:任何小于 0 或为 NaN 的参数都会被强制静默转换为 0。因此substring(-3)实际上等价于substring(0),直接截取并返回整个字符串。
2. 参数顺序倒置(start > end)的处理逻辑
当传入两个参数且起始索引大于结束索引时,两者的表现形成鲜明对比:
slice(4, 1):保持严格的方向语义。因为起始位置在结束位置之后,区间无效,直接返回空字符串""。substring(4, 1):会自动在内部调换两个参数的位置,将其实际转换为substring(1, 4)执行,从而截取索引 1 到 4 之间的子串。
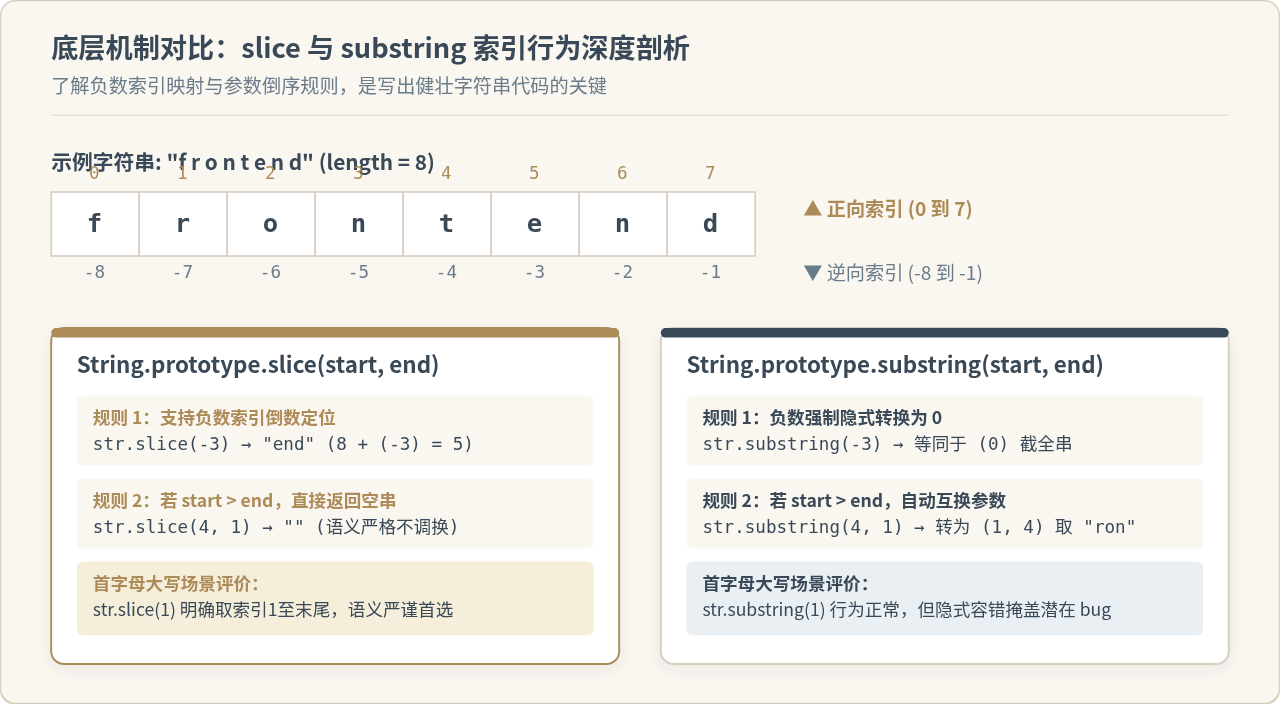
slice 而非 substring?substring 的自动调换参数和负数变 0 特性,表面上是“宽容错误”,但在实际大型工程中极易掩盖索引计算出现的逻辑 Bug;而 slice 在 String 与 Array 上的 API 行为高度统一、语义严谨,且支持负向切片,因此符合现代 ECMAScript 规范的最佳实践。
三、正则表达式的深度能力:单词与全局单词大写
当需求从“单个纯单词首字母大写”升级到“整个句子中每个单词首字母大写”(常见于英文标题格式化 Title Case、姓名标准化等)时,slice 和 substring 的局限性便显露出来。
1. 全词首字母大写的实现对比
如果使用截取拼接法处理长句 "hello world wide web",必须先按空格将字符串拆分为数组,遍历每一项分别截取拼接,最后重新 join(' '):
// 截取拼接法处理多词
function titleCaseBySlice(str) {
  if (!str) return '';
  return str
    .split(' ')
    .map(word => word.charAt(0).toUpperCase() + word.slice(1))
    .join(' ');
}
而借助正则表达式的词边界元字符 与全局匹配标记 g,仅需一行代码即可高雅达成:
// 正则全局单词边界法
function titleCaseByRegex(str) {
  if (!str) return '';
  return str.replace(/[a-z]/gi, (char) => char.toUpperCase());
}

console.log(titleCaseByRegex('hello world wide web'));
// 输出: "Hello World Wide Web"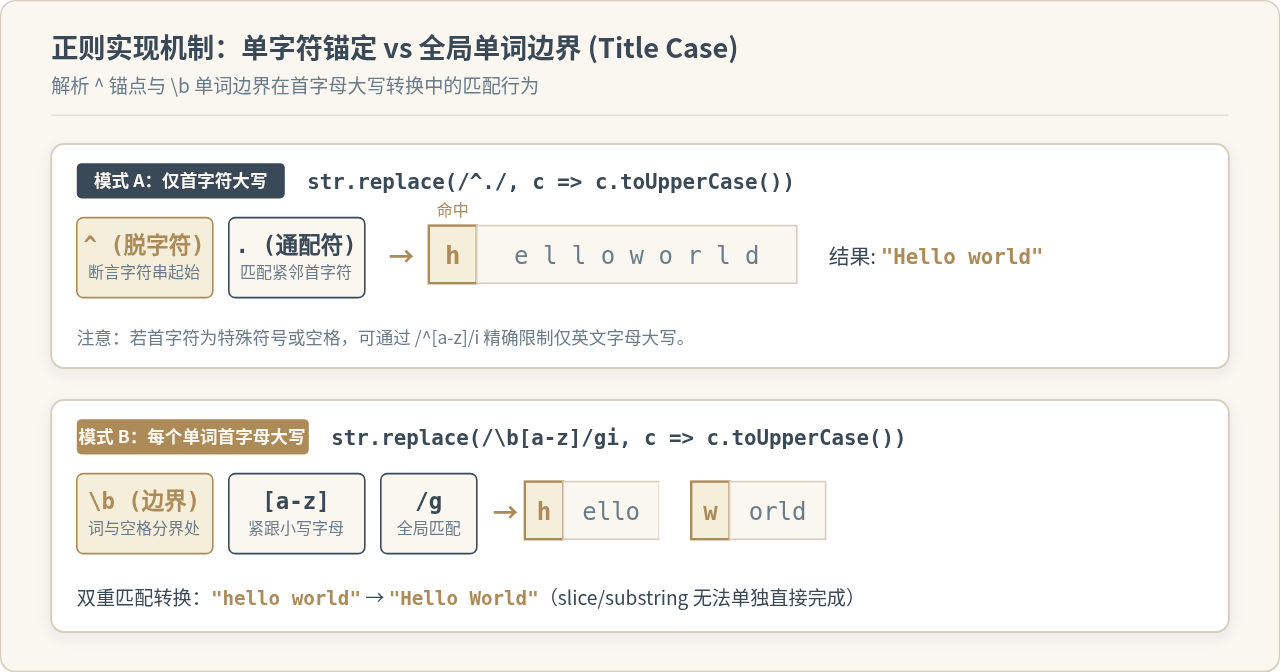
四、全维度技术指标对比
为了帮助开发者在不同技术场景下做出最佳决策,我们从语法复杂度、边界健壮性、多词支持能力及 V8 引擎底层性能等维度进行横向对比:
| 对比维度 | charAt(0) + slice(1) | charAt(0) + substring(1) | str.replace(/^./, ...) |
|---|---|---|---|
| 代码实现行数 | 需判空,1~2 行 | 需判空,1~2 行 | 单表达式,1 行搞定 |
| 空字符串安全性 | 结合 charAt(0) 极其安全返回 "" | 结合 charAt(0) 极其安全返回 "" | 空串天然不匹配,安全返回 "" |
| 负数索引支持 | 原生支持,负数表示倒数定位 | 不支持,所有负数强制归零 | 通过正则量词和断言控制 |
| 单词执行性能 (Ops/sec) | 极高(原生 V8 字符串指针直接切片) | 极高(与 slice 处于同一数量级) | 中等(创建正则及回调函数开销) |
| 全句多词扩展能力 | 繁琐(需借助 split/map/join) | 繁琐(需借助 split/map/join) | 原生支持(添加 与 /g 标志) |
| 语言生态规范推荐度 | ★★★★★(官方及大厂编码规范首推) | ★★☆☆☆(遗留 API,现代项目少用) | ★★★★☆(字符处理标准工具库利器) |
五、工程实践中的注意事项与常见边界陷阱
1. 空值防崩溃防御(Nullish Safety)
在实际业务数据流中,传入的参数可能为 null、undefined 或数字类型。为了避免直接调用字符串方法抛出异常,推荐采用现代可选链与逻辑空合并操作:
// 健壮型工程通用首字母大写函数
export function capitalize(str) {
  if (typeof str !== 'string' || str.length === 0) {
    return '';
  }
  return str.charAt(0).toUpperCase() + str.slice(1);
}
2. 国际化与特殊字符转换(Locale Awareness)
标准的 toUpperCase() 遵循通用 Unicode 规则,但在某些语言环境下存在特殊字母大小写转换规则。例如土耳其语中,小写字母 "i" 转为大写是带点的 "İ",而非标准拉丁字母的 "I"。
如果面向国际化或特定语种业务,建议使用 toLocaleUpperCase() 并显式指定区域标识(Locale):
const word = 'istanbul';
// 默认环境
console.log(word.charAt(0).toUpperCase() + word.slice(1));
// 输出: "Istanbul"

// 土耳其语环境
console.log(word.charAt(0).toLocaleUpperCase('tr-TR') + word.slice(1));
// 输出: "İstanbul"
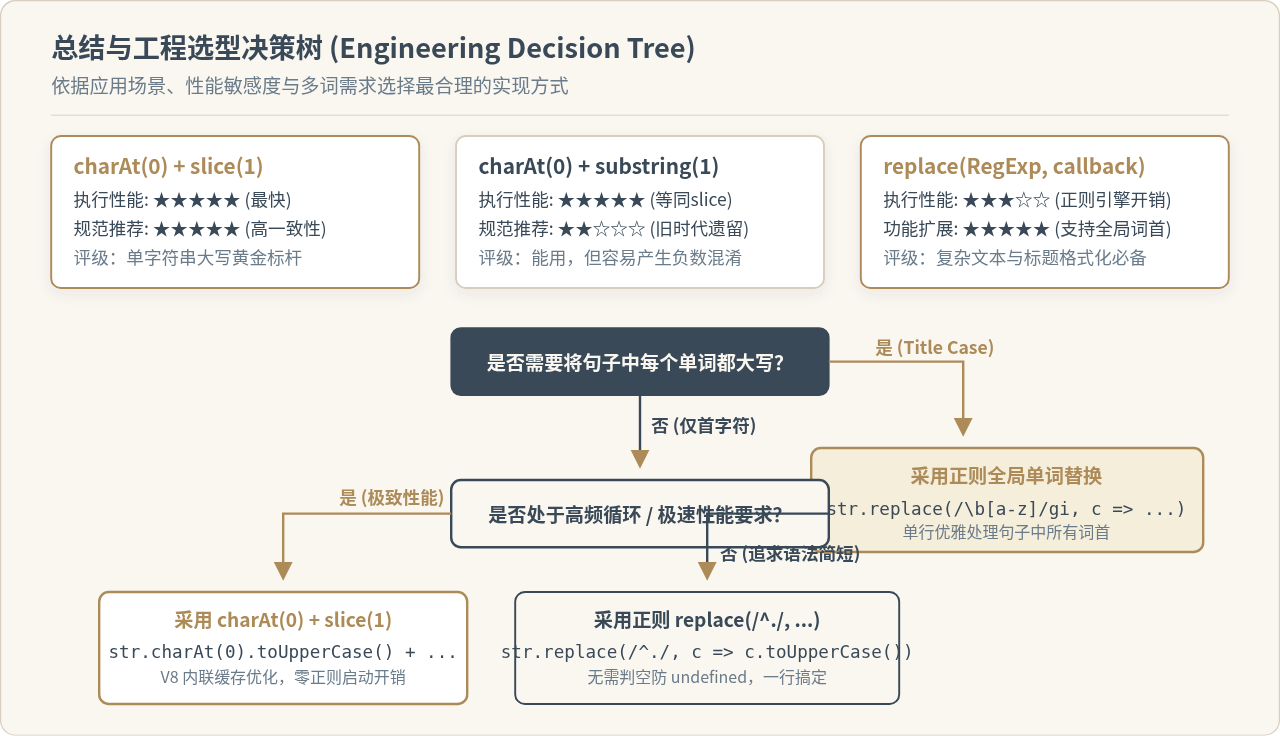
六、总结与选型建议
综合来看,三种方案各有其不可替代的场景定位:
- 常规单字符串大写(首推
slice):在绝大多数业务场景下,推荐使用str.charAt(0).toUpperCase() + str.slice(1)。它执行速度最快,内存开销最小,且具备最严谨的 API 行为。 - 弃用或避免新写
substring:尽管substring(1)也能完成任务,但因其对负数的非直观修正以及参数自动翻转机制,现代前端开发规范已普遍建议全面改用slice。 - 全句标题格式化或复杂文本匹配(首推
replace):当涉及句子中所有单词首字母大写、或者需要根据复杂模式过滤非英文字符时,正则表达式str.replace(/[a-z]/gi, ...)是开发效率最高、代码表达力最强的解法。
纯前端js导出word大文件性能优化:分片处理与内存管理
2026-11-16 13:42:41
JS解析URL:字符串分割与URL API性能对比
2026-11-16 13:24:07
JavaScript基础选择题常见的性能陷阱有哪些
2026-11-08 22:57:06
JavaScript框架库漏洞用多了页面变卡怎么优化
2026-11-08 21:10:22
JavaScript框架库漏洞偶发失败怎么复现和定位
2026-11-08 19:54:56







