Node.js不适合做什么?CPU密集型任务的处理建议
深入解析 Node.js 为什么不适合在主线程执行 CPU 密集型任务,剖析单线程事件循环阻塞机制与雪崩风险,并提供 worker_threads、子进程隔离、消息队列异步解耦等完整改造示例与选型决策指南。
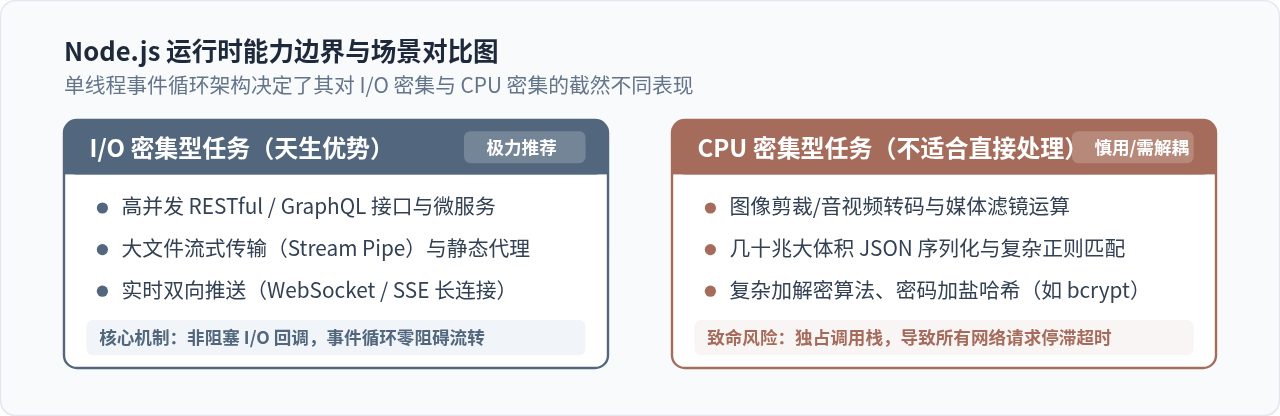
Node.js 的核心设计基于单线程事件循环(Event Loop)与非阻塞 I/O,这让它在处理高并发网络请求、API 网关及实时通信时表现出众;然而,一旦遇到需要长时间独占 CPU 运算的场景(例如音视频转码、超大 JSON 序列化、复杂加密与图像矩阵运算),执行线程会被持续阻塞,导致整个服务进程无法响应其他正常网络请求。面对这类任务,不能任由其直接在主线程同步执行,通常可采用 worker_threads 线程池、child_process 进程隔离、或基于消息队列的独立计算服务完成平滑解耦。
一、为什么 Node.js 天生不适合直接运行 CPU 密集型任务?
要理解这个限制,必须直面 Node.js 底层的运行模型。虽然 Node.js 底层依靠 libuv 维护着多线程工作池来支撑文件 I/O、DNS 解析和部分加密操作,但开发者所书写的 JavaScript 代码本质上是在 单个主线程(Main Thread) 的调用栈中串行执行的。
在标准的 Web 服务链路中,网络 I/O、数据库查询等操作会将实际耗时委托给操作系统内核或驱动,主线程交出控制权继续轮询下一个请求。但如果一个路由处理函数中包含一个耗时 800 毫秒的复杂数学运算或大循环,JavaScript 引擎在这 800 毫秒内将全力以赴计算该逻辑,调用栈处于完全占满状态。
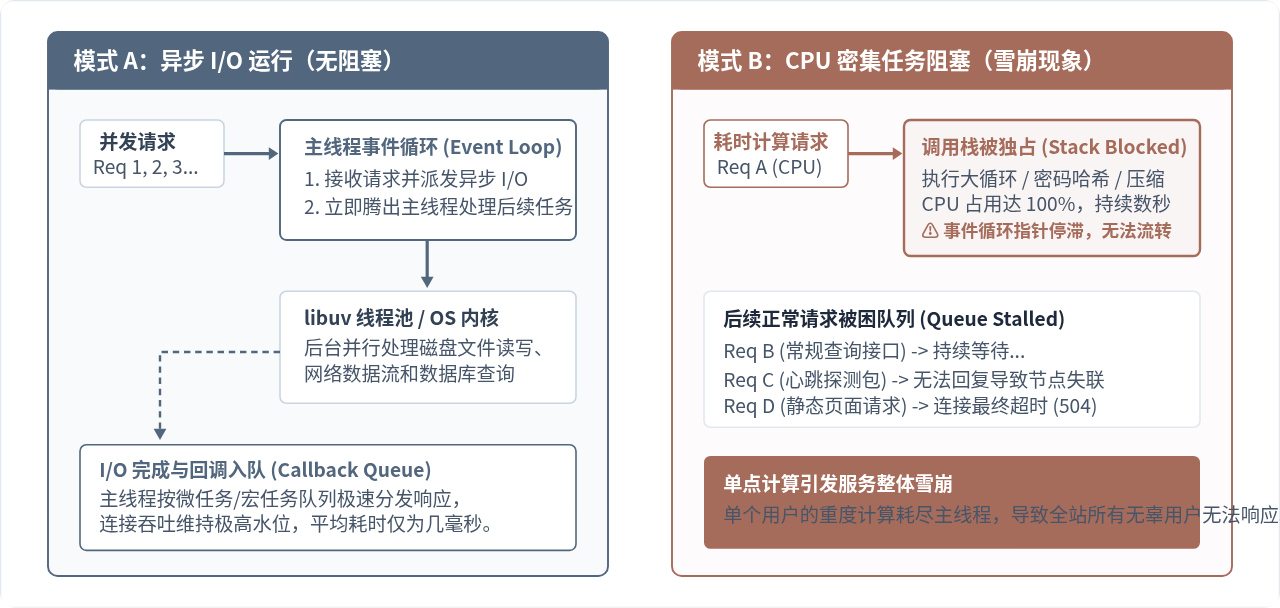
在这段阻塞时间内,事件循环彻底停滞。即便后续到达的只是静态资源请求或简单的内存查询,也会被困在任务队列中无法执行。对于外部客户端而言,所有接口的响应延迟陡增,甚至直接触发反向代理(如 Nginx)的 504 Gateway Timeout 超时中断。
二、日常开发中容易忽视的 CPU 密集型陷阱
很多开发者误以为只有 3D 渲染、机器学习模型推理才算 CPU 密集型任务,但在实际业务系统中,以下几种常见操作同样会悄然吞噬 CPU 算力:
-
超大体积 JSON 序列化与解析:
调用
JSON.parse()或JSON.stringify()解析数十兆以上的统计报表或复杂数据包时,该过程完全由 V8 引擎在主线程同步完成,耗时可达数百毫秒至数秒。 - 正则表达式灾难性回溯(ReDoS): 结构欠妥的正则表达式在匹配特定异常文本时,回溯计算次数呈指数级膨胀,瞬间将单个 CPU 核心占满至 100%。
-
同步密码加盐哈希(如 bcrypt):
用户注册登录时采用
bcrypt.hashSync()。由于加盐算法故意设计了较高的计算复杂度以防御暴力破解,若在主线程同步调用,并发十几个登录请求就会拖垮整个 API 节点。 - 服务进程内的媒体裁剪与加水印: 直接在 Web API 路由里使用 JavaScript 代码或未配置多线程的库遍历像素 Buffer,极易造成大面积请求排队。
keep-alive 心跳探测频繁超时,首先应当排查主线程是否存在上述同步计算逻辑。
三、方案一:使用内置工作线程(worker_threads)
Node.js 从 v10.5.0 起引入并在后续版本成熟的 worker_threads 模块,是解决进程内计算瓶颈的首选利器。工作线程运行在同一个系统进程内,每个 Worker 拥有独立的 V8 实例与事件循环,但内存相互隔离(支持通过 SharedArrayBuffer 共享内存)。
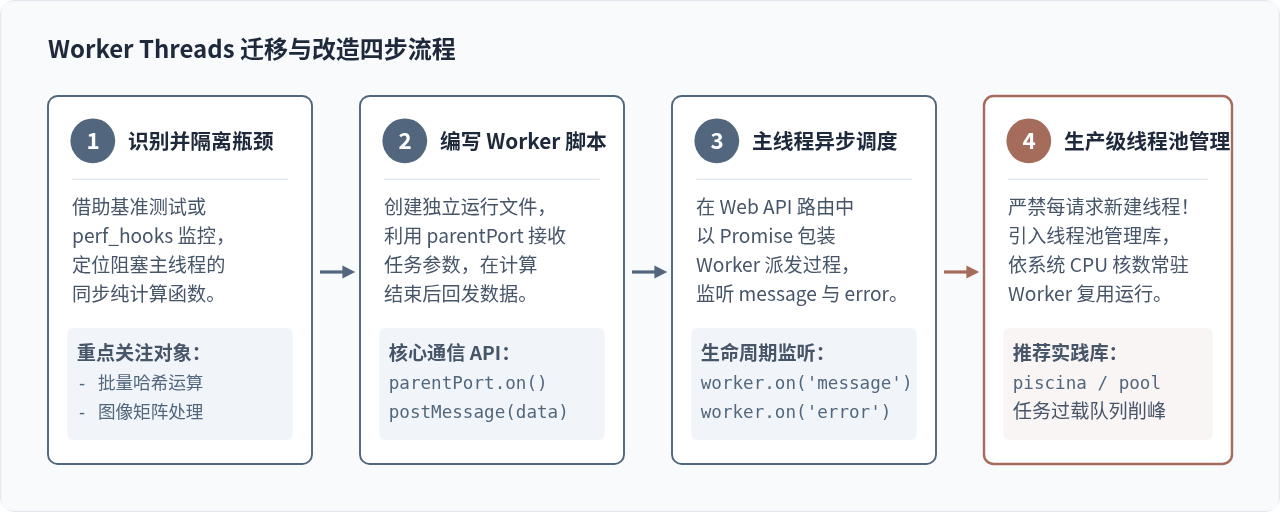
1. 编写独立计算工作文件
创建独立的 calc-worker.js,专注处理计算逻辑,并通过 parentPort 与主线程收发数据:
// calc-worker.js
const { parentPort } = require('node:worker_threads');

// 模拟密集型计算:寻找范围内的素数
function findPrimes(max) {
  const primes = [];
  for (let i = 2; i <= max; i++) {
    let isPrime = true;
    for (let j = 2; j * j <= i; j++) {
      if (i % j === 0) {
        isPrime = false;
        break;
      }
    }
    if (isPrime) primes.push(i);
  }
  return primes;
}

// 监听主线程派发的任务数据
parentPort.on('message', (taskData) => {
  const { max, taskId } = taskData;
  const result = findPrimes(max);
  // 计算完成,将结果发送回主线程
  parentPort.postMessage({ taskId, count: result.length });
});
2. 主线程异步调度 Worker
在主线程服务中,通过 new Worker() 实例化工作线程,并通过 Promise 封装异步等待逻辑:
// server.js
const http = require('node:http');
const path = require('node:path');
const { Worker } = require('node:worker_threads');

function runWorkerTask(taskData) {
  return new Promise((resolve, reject) => {
    const workerPath = path.resolve(__dirname, 'calc-worker.js');
    const worker = new Worker(workerPath);

    worker.postMessage(taskData);

    worker.on('message', (data) => {
      resolve(data);
      worker.terminate(); // 任务结束关闭线程
    });

    worker.on('error', reject);
    worker.on('exit', (code) => {
      if (code !== 0) reject(new Error(`Worker stopped with exit code ${code}`));
    });
  });
}

const server = http.createServer(async (req, res) => {
  if (req.url === '/compute') {
    try {
      const result = await runWorkerTask({ taskId: Date.now(), max: 2000000 });
      res.writeHead(200, { 'Content-Type': 'application/json' });
      res.end(JSON.stringify({ status: 'success', data: result }));
    } catch (err) {
      res.writeHead(500, { 'Content-Type': 'text/plain' });
      res.end(`Calculation Error: ${err.message}`);
    }
  } else {
    // 普通轻量请求即便在计算执行期间,依然能毫秒级即时响应
    res.writeHead(200, { 'Content-Type': 'text/plain' });
    res.end('Hello from non-blocking main thread!');
  }
});

server.listen(3000, () => {
  console.log('Server is running on port 3000');
});每个 Worker 线程的启动都伴随着 V8 引擎上下文的初始化与内存分配,频繁创建销毁 Worker 线程所消耗的 CPU 甚至会超过计算本身。在生产环境中,推荐使用 mature 的开源线程池库(如
piscina 或 poolifier),根据机器的 CPU 物理核心数固定常驻工作线程。
四、方案二:进程隔离与外部服务解耦
当计算任务极度消耗资源、依赖已有命令行二进制工具,或者存在内存泄漏、甚至偶发崩溃风险时,线程间共享同一进程空间反而成了安全隐患。此时应采用更高层级的隔离方案。
1. 子进程隔离(child_process)
使用 child_process.spawn 或 child_process.fork 调用外部系统进程(如 FFmpeg、ImageMagick、Pandoc 或 Python 脚本)。子进程运行在独立的 OS 进程空间,即使遇到段错误(Segmentation fault)或内存耗尽被操作系统 OOM Killer 杀掉,Node.js Web 主服务进程依然安然无恙。
2. 架构级解耦:消息队列与独立计算微服务
对于企业级高并发系统,最健壮的方案是将 CPU 密集型任务完全从 Web API 网关层剥离,引入消息队列(如 Redis + BullMQ、RabbitMQ)实现异步化削峰填谷。
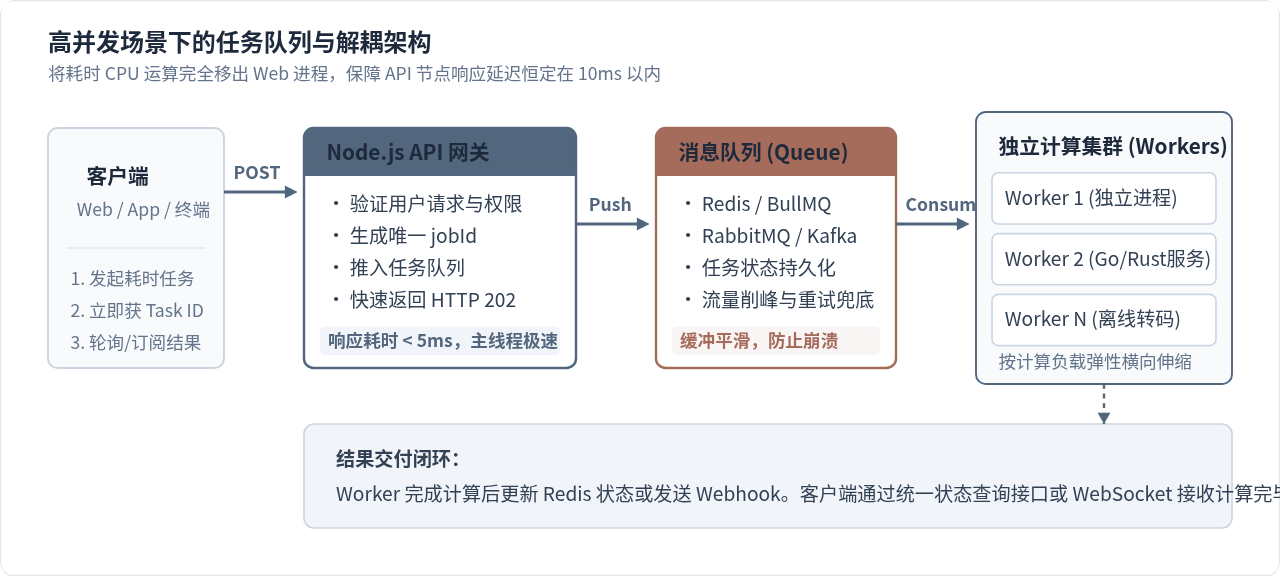
在该架构下:
- 客户端发起高开销运算请求,Node.js API 网关完成鉴权与入参校验后,生成唯一
jobId并快速推入队列。 - 网关立即向客户端返回
HTTP 202 Accepted及jobId,全程耗时通常小于 5ms,主线程完全无压力。 - 后端的 Worker 计算集群(可用 Go、Rust、C++ 或专门的 Node.js 实例实现)平稳消费队列中的任务。
- 计算完毕后将数据持久化至数据库或 Redis,并通过 WebSocket 或客户端轮询接口交付最终结果。
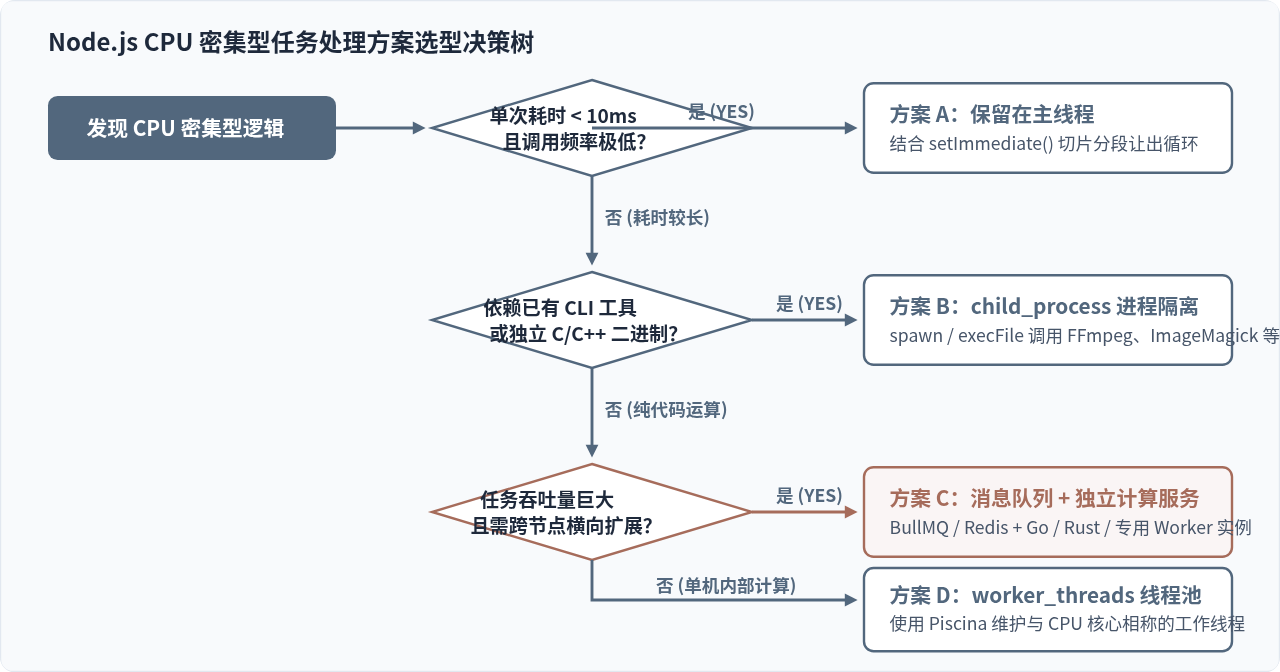
五、方案选型矩阵与决策建议
面对不同的计算复杂度与并发规模,选择最匹配的工程方案能够避免过度设计或性能崩溃:
| 方案 | 内存与开销 | 隔离级别 | 适用场景 | 注意事项 |
|---|---|---|---|---|
| 主线程分片 (setImmediate) | 极低(单进程) | 无隔离 | 偶发、可切分的小数据循环累加 | 单次分片执行时间需控制在 10ms 以内 |
| worker_threads 线程池 | 中等(~30MB/线程) | 内存隔离(同一进程) | 高频中等计算(如 JSON 压缩、算法运算) | 避免跨线程大量克隆数据,优先用 Buffer/TypedArray |
| child_process 子进程 | 较高(~40-80MB/进程) | 进程级独立隔离 | 调用外部命令行工具(如 FFmpeg 音视频转码) | 注意控制最大并发子进程数,防止把服务器 CPU 撑爆 |
| 消息队列 + 独立计算服务 | 需配套基础设施 | 系统级解耦与独立扩缩容 | 高并发大规模复杂任务(如 PDF 生成、大模型调用) | 需设计异步交付闭环(轮询接口、Webhook 或 WebSocket) |
六、生产环境运行监控建议
为了防止未知重度逻辑拖慢主线程,可在服务中集成 Node.js 内置的 perf_hooks 模块,持续监控事件循环延迟:
const { monitorEventLoopDelay } = require('node:perf_hooks');

// 创建事件循环延迟采样直方图,分辨率为 20 毫秒
const histogram = monitorEventLoopDelay({ resolution: 20 });
histogram.enable();

// 定期上报指标至监控系统(如 Prometheus)
setInterval(() => {
  const meanDelayMs = (histogram.mean / 1e6).toFixed(2);
  const p99DelayMs = (histogram.percentile(99) / 1e6).toFixed(2);

  if (p99DelayMs > 50) {
    console.warn(`[EventLoop Alert] P99 Delay high: ${p99DelayMs}ms, Mean: ${meanDelayMs}ms`);
  }
  histogram.reset();
}, 5000);
当 p99DelayMs 持续超过 50 毫秒时,说明当前主线程正在经受 CPU 密集型任务的冲击,此时应及时触发告警并按上述决策树完成逻辑拆分与隔离。
Node.js有官方安卓版App吗?澄清服务端运行时的平台限制
2026-11-12 09:34:02
Windows系统安装Node.js及配置环境变量详细步骤
2026-11-11 15:40:56
彻底卸载旧版Node.js以解决新版本安装冲突
2026-11-11 15:40:29
Linux服务器安装Node.js:二进制安装包与包管理器部署步骤
2026-11-11 15:40:19
javascript下载安装手机版常见的坑和规避办法有哪些
2026-11-08 09:14:54