JS解析大体积Excel文件内存溢出怎么办
深入剖析JavaScript在解析大体积.xlsx文件时内存溢出(OOM)的底层原因,对比全量加载与流式事件驱动架构的本质差异,并提供基于Node.js Stream的行级消费与背压控制落地方案。
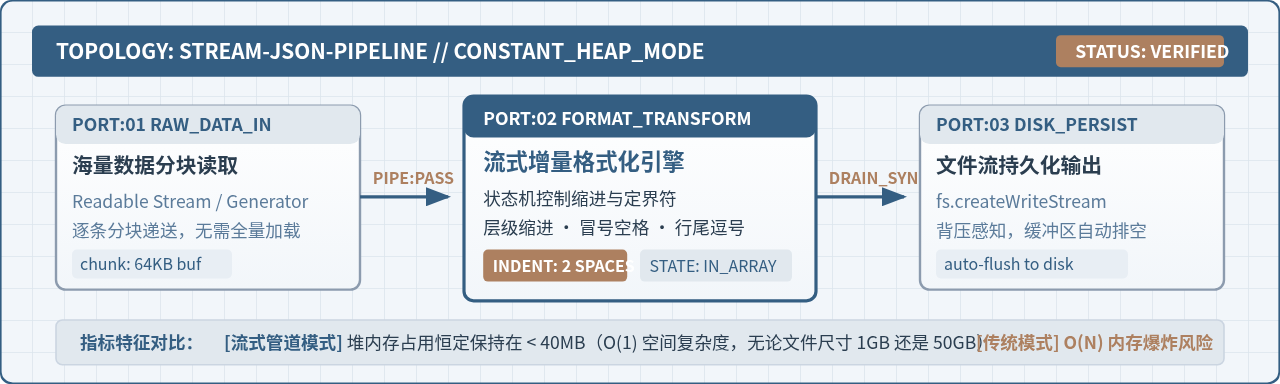
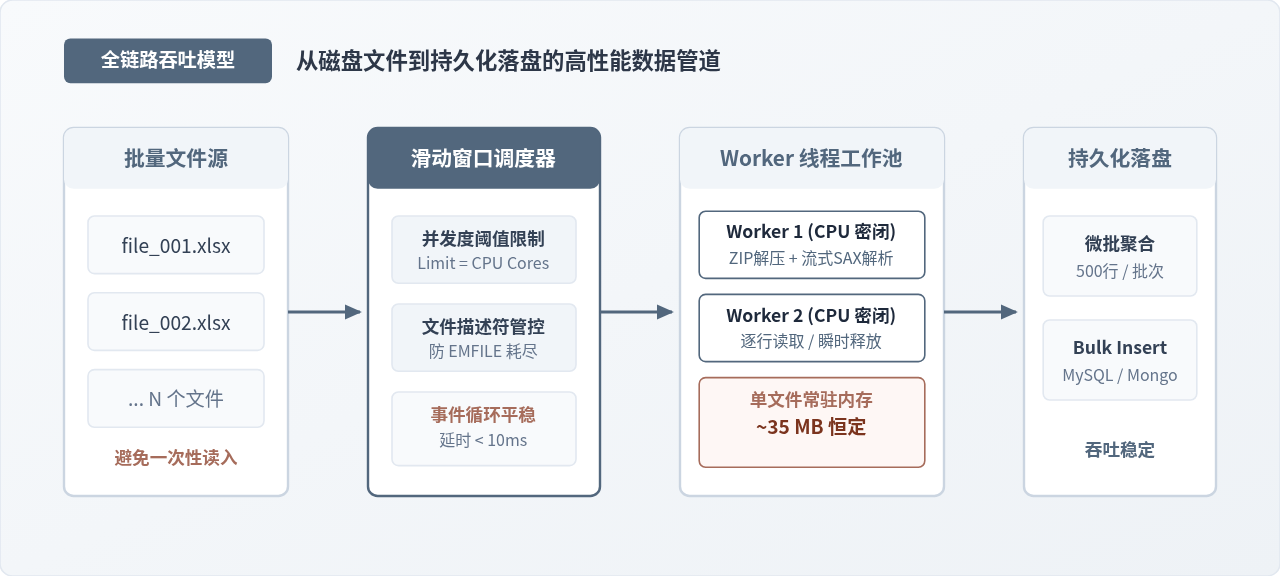
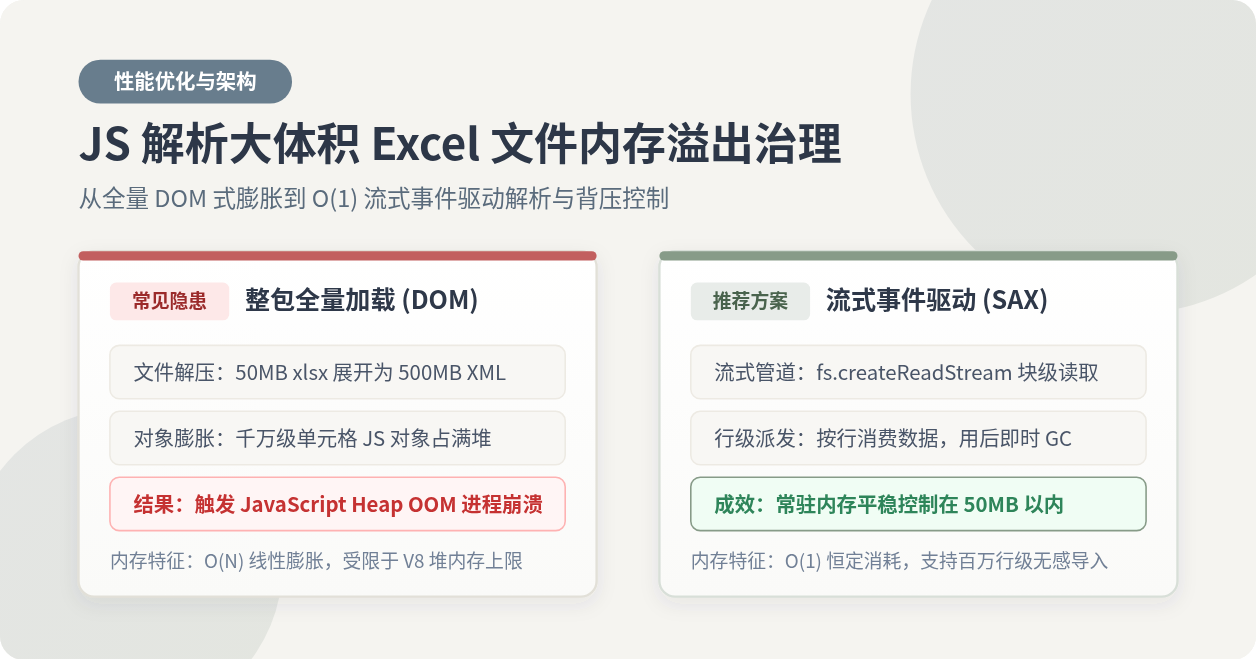
JavaScript heap out of memory),根本原因在于常用库默认采用“全量 DOM 树加载”方式,即把压缩的 .xlsx 归档解压并在 V8 堆内存中展开为庞大的单元格对象树。解决该问题的根本路径,是将“整包内存加载”重构为“基于 Stream 的行级事件驱动解析(Streaming / SAX)”,配合背压控制(Backpressure)、分批入库(Batch Chunking)以及进程/线程隔离,使常驻内存消耗从与数据规模成正比的 O(N) 恒定降低至平稳的 O(1) 常数级。
一、内存溢出的根源:.xlsx 的物理结构与 V8 内存放大效应
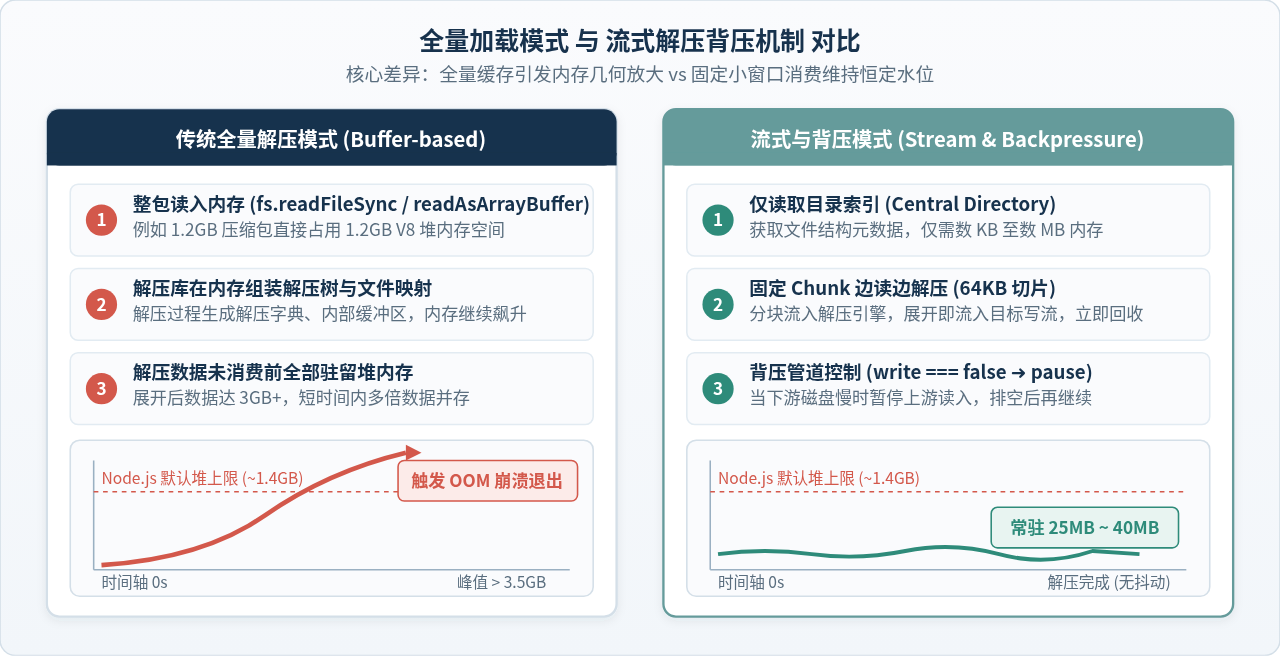
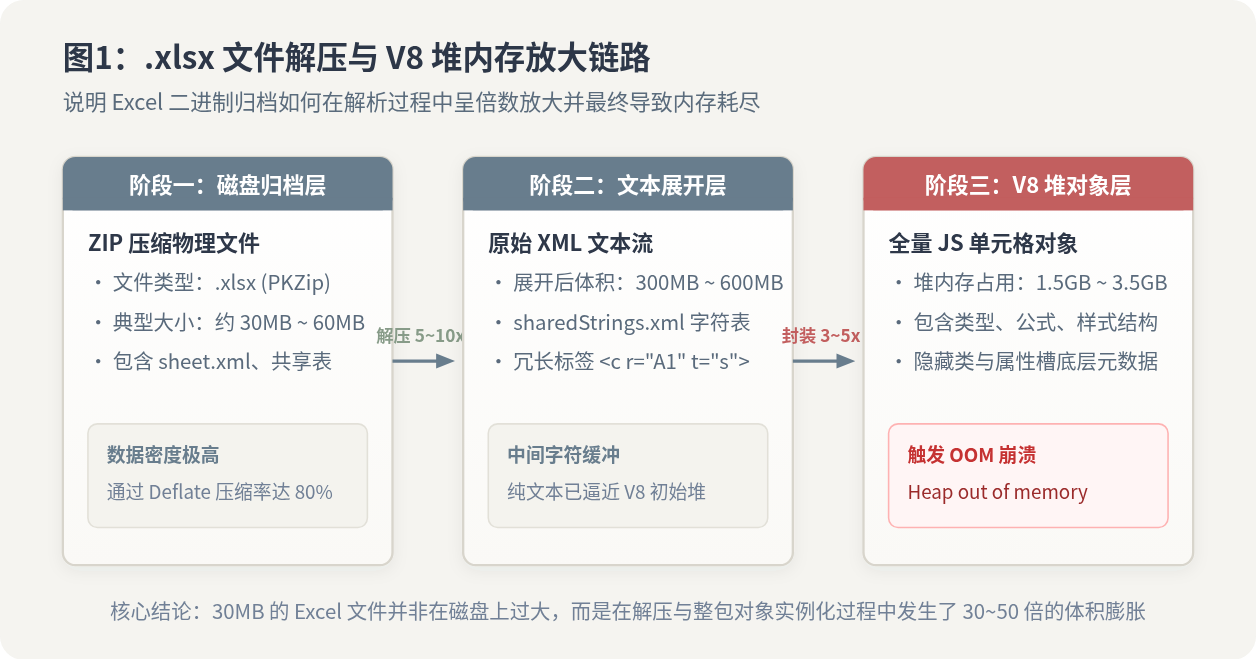
很多开发者在遇到大文件崩溃时,直觉上会认为是“文件大小”超出了系统内存,例如一个 40MB 的 Excel 文件,理论上远小于 Node.js 默认 1.4GB~2GB 的堆内存限制。然而,这种理解忽略了 .xlsx 格式在解压与对象化过程中的剧烈膨胀。
现代 Excel 文件本质上是一个遵循 OpenXML 标准的 ZIP 压缩包,内部包含多个子文件,最核心的是存放表格结构的 xl/worksheets/sheet1.xml 以及存放去重文本的 xl/sharedStrings.xml。在解析过程中,文件经历了两级明显的内存放大:
- 物理文本放大(5~10 倍):由于 ZIP 的高效压缩,40MB 的
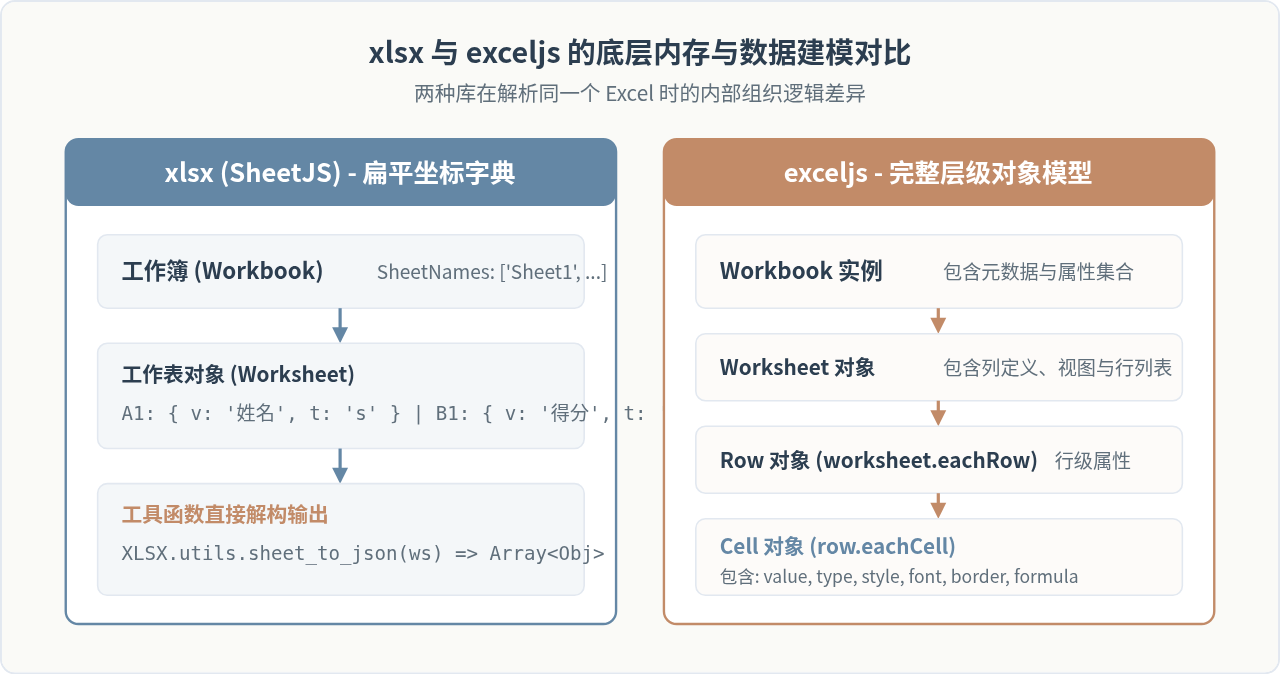
.xlsx解压后,原始 XML 文本体积通常在 300MB 到 600MB 之间。 - V8 堆对象结构放大(20~50 倍):当使用传统库(例如常规模式下的 SheetJS / XLSX.readFile)解析时,解析器会将庞大的 XML 字符串反序列化为 JavaScript 运行时对象。一个单元格不仅仅是一个字符串或数字,它通常被封装为包含类型标识、计算公式、样式索引和坐标引用等属性的复合 Object。V8 引擎为每个 Object 分配隐藏类(Shape/Hidden Class)、属性槽和堆空间指针,额外的底层元数据开销使得一个 50 万行、20 列的表格可能产生数千万个离散的堆对象,迅速榨干 V8 堆空间并触发崩溃。
二、范式对比:全量解析模式 vs 流式事件驱动模式
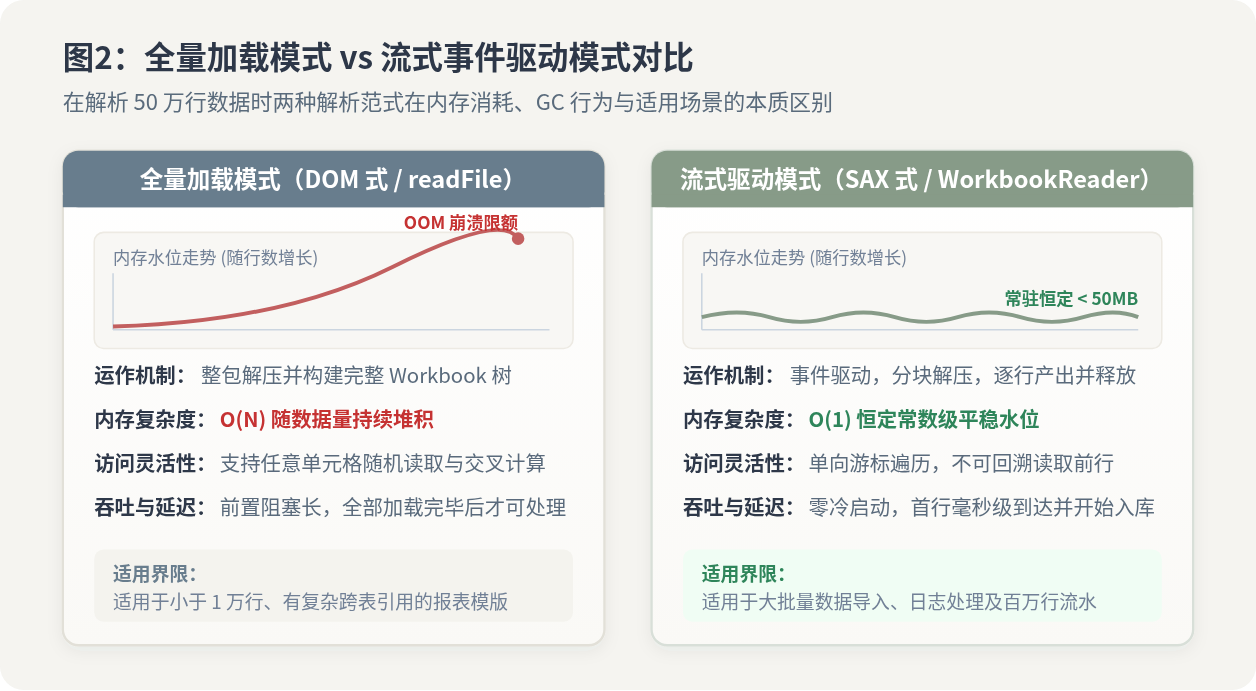
要从架构上消除内存溢出,必须理解两种不同的解析范式在处理大批量数据时的行为特征及其权衡。
| 比较维度 | 全量加载模式(DOM 风格) | 流式事件驱动模式(SAX 风格) |
|---|---|---|
| 核心机制 | 整包读取到内存,反序列化为整簿 AST/对象树 | 块级流式解压,按行触发事件并即时移交释放 |
| 内存消耗 | O(N),随行数线性剧增,极易 OOM |
O(1),常驻内存恒定(通常 30MB~80MB) |
| 首行延迟 | 高,必须等待全量解压和对象解析完毕 | 低,首块流解析完成即可开始消费首行数据 |
| 随机访问 | 支持(可任意获取 sheet['A1'] 或跨表计算) |
不支持(单向流式游标,已读行不可回退) |
| GC 压力 | 持续攀升,老生代无法释放导致频繁 Full GC | 轻微,绝大多数对象在新生代即被迅速回收 |
| 推荐场景 | 小型模板导出、复杂跨表公式联动(< 1万行) | 超大明细导入、日志归档处理、数据入库(> 1万行) |
两种模式的根本差异在于空间换灵活性与时间与空间正交解耦的选择。全量模式为了满足跨单元格公式计算和双向遍历,必须持有整张表的完整拓扑结构;而在绝大多数数据导入场景中,业务逻辑只需要逐行读取数据并存入数据库,行与行之间彼此独立,此时流式模型是唯一合理的工程选择。
三、服务端 (Node.js) 落地实践:基于 Stream 的行级消费与背压控制
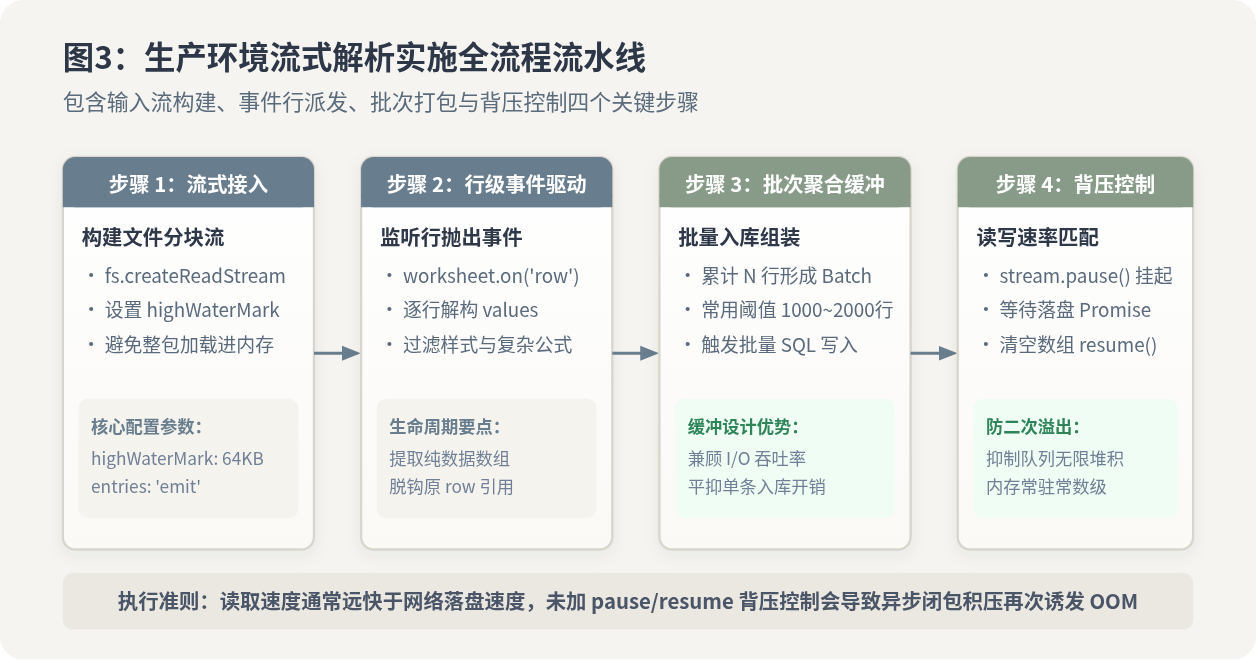
在 Node.js 服务端,最稳健的大文件 Excel 解析方案是使用支持 Stream 的解析库(例如 exceljs 的 WorkbookReader)。通过直接接入操作系统的文件读取流,以事件驱动的方式按行消费。
1. 完整生产级代码实现
以下示例展示了如何在 Node.js 环境中建立流式解析管道,并实现分批聚合(Batching)与异步背压控制(Backpressure):
// parseExcelStream.js
const fs = require('fs');
const ExcelJS = require('exceljs');

/**
 * 模拟将数据批次写入数据库的操作
 * @param {Array<Array>} batchRows - 当前累积的一批行数据
 */
async function saveBatchToDatabase(batchRows) {
  // 模拟真实场景中的网络 I/O 或数据库批量 INSERT 操作
  return new Promise((resolve) => setTimeout(resolve, 50));
}

/**
 * 流式解析大体积 Excel 文件
 * @param {string} filePath - Excel 文件的本地物理路径
 */
async function processLargeExcelFile(filePath) {
  console.log(`[开始解析] 目标文件: ${filePath}`);
  const startTime = Date.now();

  // 1. 创建文件底层读取流,避免一次性载入 Buffer
  const fileStream = fs.createReadStream(filePath, {
    highWaterMark: 64 * 1024 // 64KB 读缓冲区
  });

  // 2. 初始化 ExcelJS 流式工作簿读取器
  const workbookReader = new ExcelJS.stream.xlsx.WorkbookReader(fileStream, {
    entries: 'emit',
    sharedStrings: 'cache',
    styles: 'ignore', // 核心优化:忽略样式解析,减少无用对象实例化
    hyperlinks: 'ignore'
  });

  let totalProcessedRows = 0;
  let batchBuffer = [];
  const BATCH_SIZE = 1000; // 每 1000 行聚合为一个批次入库

  // 3. 监听工作表派发事件
  for await (const worksheetReader of workbookReader) {
    console.log(`[进入工作表] Sheet ID: ${worksheetReader.id}`);

    // 4. 逐行异步迭代读取
    for await (const row of worksheetReader) {
      // 提取纯数据数组(注意 row.values 的第 0 项为空槽位)
      const rowValues = Array.isArray(row.values) ? row.values.slice(1) : [];
      batchBuffer.push(rowValues);
      totalProcessedRows++;

      // 5. 达到批次阈值时,执行落盘并施加背压
      if (batchBuffer.length >= BATCH_SIZE) {
        // 挂起输入流读取,防止数据库写入滞后导致内存积压
        fileStream.pause();

        const currentBatch = batchBuffer;
        batchBuffer = []; // 立即置空缓冲池,解除对前批数据的引用

        await saveBatchToDatabase(currentBatch);

        // 落盘完成后恢复流读取
        fileStream.resume();
      }
    }
  }

  // 6. 处理尾部剩余不足一个 Batch 的数据
  if (batchBuffer.length > 0) {
    await saveBatchToDatabase(batchBuffer);
    batchBuffer = [];
  }

  const durationSec = ((Date.now() - startTime) / 1000).toFixed(2);
  const memUsageMB = (process.memoryUsage().heapUsed / 1024 / 1024).toFixed(2);
  console.log(`[解析完成] 共处理 ${totalProcessedRows} 行,耗时 ${durationSec} 秒,当前堆占用: ${memUsageMB} MB`);
}

// 执行示例
// processLargeExcelFile('./large_dataset_500k.xlsx').catch(console.error);
- 样式忽略参数
styles: 'ignore':大体积数据导入通常仅关注纯数据内容,如果不显式声明忽略样式,解析器会为每个单元格解析字体、填充色和边框对象,导致额外的堆对象开销。 - 显式切断引用
batchBuffer = []:在调用异步持久化方法时,必须确保旧数组不再被外层作用域引用,使 V8 的 Scavenge GC 可以随时回收已处理的行。 - 背压控制(Backpressure):读取磁盘 XML 的速度(数百兆/秒)通常远快于网络写入数据库的速度(每批几十毫秒)。如果不调用
fileStream.pause(),未决的 Promise 闭包会堆积在事件循环任务队列中,形成“伪流式、真溢出”的二次内存泄漏。
四、浏览器前端环境的特殊考量与边界
如果业务强行要求在浏览器前端解析用户上传的大体积 Excel 文件(如 50MB 以上),开发者将面临更加苛刻的限制:
- 主线程与 UI 冻结:即便没有直接触发 OOM,解压与循环解析长达数十秒的计算任务也会独占 JavaScript 单线程,导致浏览器界面完全失去响应、无法点击甚至弹出“页面无响应”弹窗。
- 内存上限更低:现代桌面浏览器(如 Chrome)单个标签页通常有严格的可用内存配额(通常在 1.5GB 左右,移动端更低),且垃圾回收策略由浏览器统一调度,更容易遭遇强制崩溃崩溃。
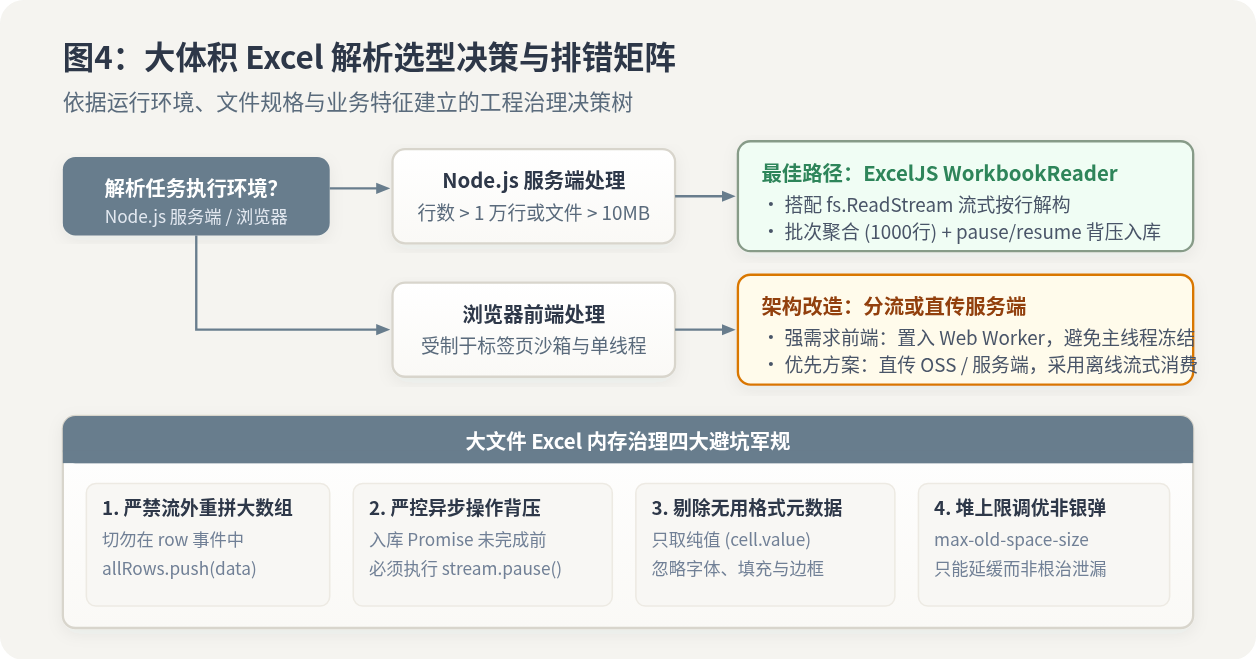
1. 首选架构方案:对大于 20MB 的 Excel 文件,前端直接通过直传(Presigned URL)上传至对象存储(OSS/S3),由服务端在后台异步流式处理并通知进度,前端仅展示轮询状态。
2. 次选 Worker 方案:若因网络限制必须在前端解析,必须将解析逻辑封装进 Web Worker,并在 Worker 中使用流式解析库,确保主渲染线程平滑,同时监控内存水位。
五、技术选型决策与排错避坑清单
在工程排错和日常维护中,针对大文件 Excel 导出与解析,建议遵循以下决策树与四大避坑原则:
常见排错陷阱与对策
- 陷阱一:使用了流式解析器,但在外层收集大数组。
很多开发者代码写成reader.on('row', row => allData.push(row)),这让流式架构瞬间退化为全量内存存储,流式处理带来的内存节省被彻底抵消。正确做法是按批次写入磁盘临时文件或数据库。 - 陷阱二:迷信
--max-old-space-size命令行参数。
部分团队在报错后简单地加上node --max-old-space-size=8192 app.js。该参数只是调高了堆内存上限,对于线性增长的O(N)算法,当文件由 50MB 增长到 150MB 时,内存依然会耗尽;并且堆内存越大,V8 进行全量垃圾回收(Major GC Mark-Sweep)时造成的停顿时间(Stop-The-World)越长,会导致接口严重超时。 - 陷阱三:复杂共享字符串表(sharedStrings.xml)溢出。
若 Excel 文件包含数百万个互不相同的文本单元格,共享字符字典本身可能会占用数百兆内存。对于这种极端场景,如果业务允许,应推动上游数据源直接导出为纯文本CSV格式,彻底绕过 XML 解压与字典查找的开销。
六、总结与落地检验
处理“JS 解析大体积 Excel 文件内存溢出”并非靠微观的语法调优,而是需要完成从 DOM 全量解析向 SAX 流式管道的架构迁移:
- 看清本质:了解
.xlsx的 ZIP 物理压缩与 V8 堆对象膨胀原理,不被表面磁盘文件大小迷惑。 - 接入流式:服务端采用
ExcelJS.stream.xlsx.WorkbookReader等支持流式解析的工具库,切断全表引用的生命周期。 - 把控背压:在每批数据入库未完成时主动挂起读取流(
pause),写入成功后再恢复(resume),平抑读写速度差。 - 剔除冗余:显式关闭样式、超链接与批注解析,保持堆对象的高纯度。
在实施以上方案后,可以通过 process.memoryUsage().heapUsed 进行实测验证。正确的流式管道在处理百万行 Excel 文件时,内存曲线应表现为稳定的小幅锯齿状(分配批次后立即被 GC 回收),常驻内存稳定维持在几十兆字节,从而彻底根治大文件解析导致的进程退出与服务崩溃。
Java和JavaScript的应用场景分工:后端企业级开发与Web前端交互
2026-11-05 15:57:34
除了浏览器和Node.js,还有哪些轻量级Js脚本运行工具?
2026-11-04 17:38:24
无需后端:用JavaScript实现简单网站的本地数据存储
2026-11-03 23:03:30
Node.js 下载慢或官网打不开怎么办
2026-11-03 18:19:37
JS相对路径转绝对URL的三种可靠方法
2026-11-03 16:37:52