Node.js环境下怎么高效批量解析Excel
深入解析在Node.js环境下高效批量解析Excel文件的技术路径,涵盖流式SAX解析、滑动窗口并发控制、Worker Threads多线程算力卸载与微批次持久化架构。
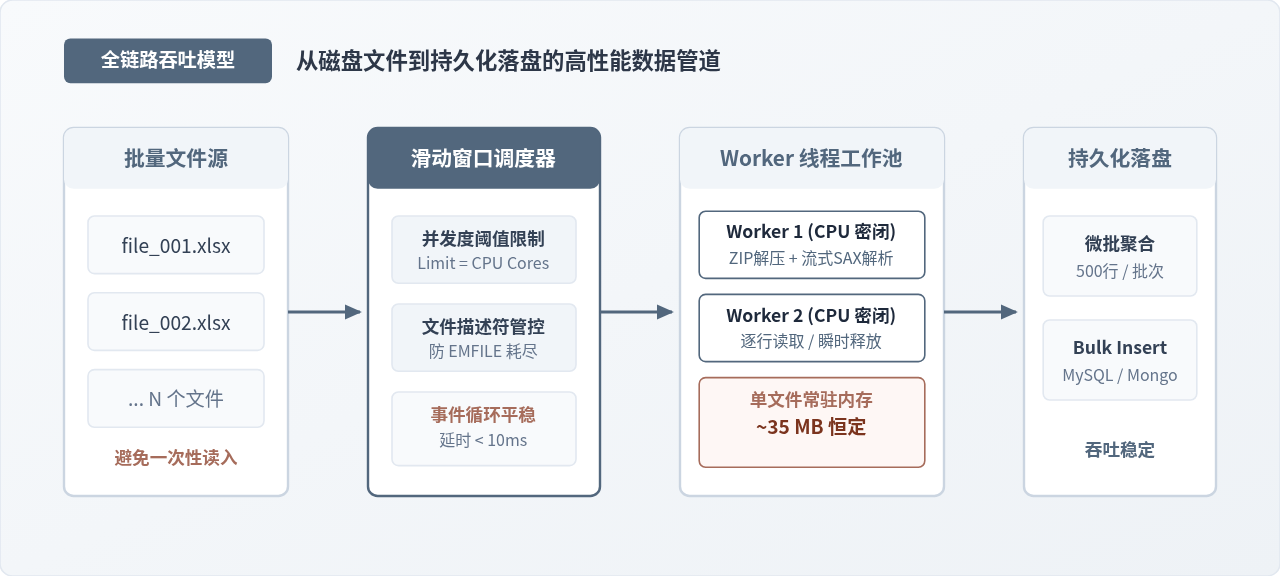
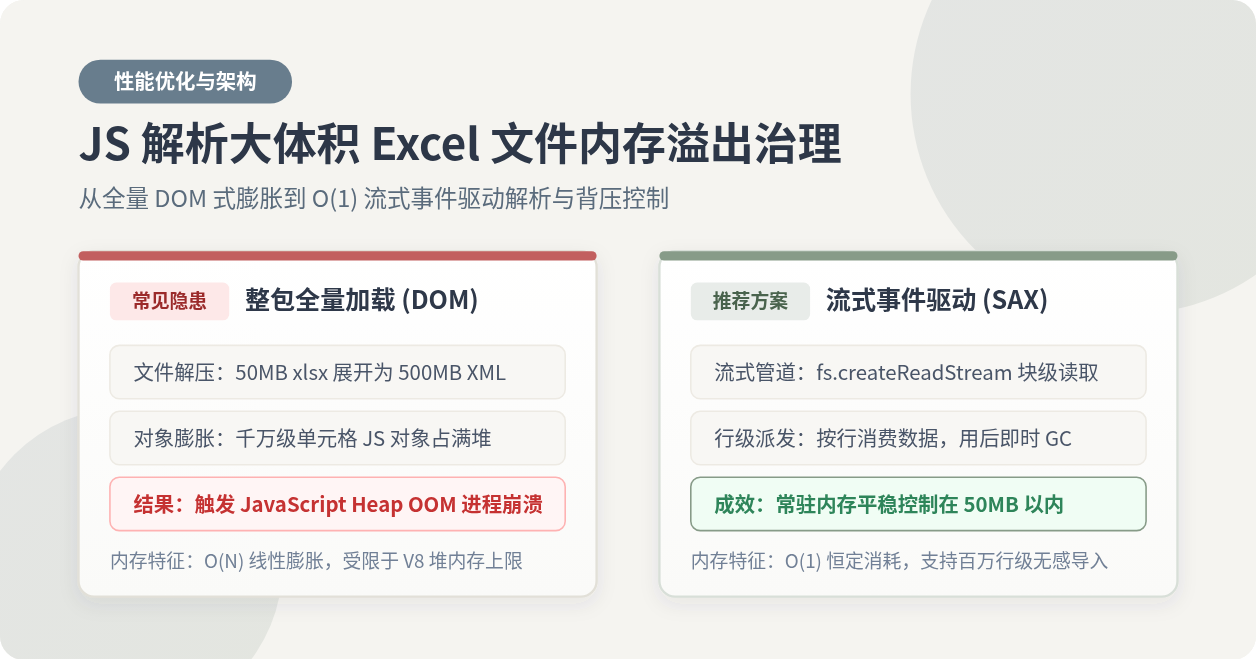
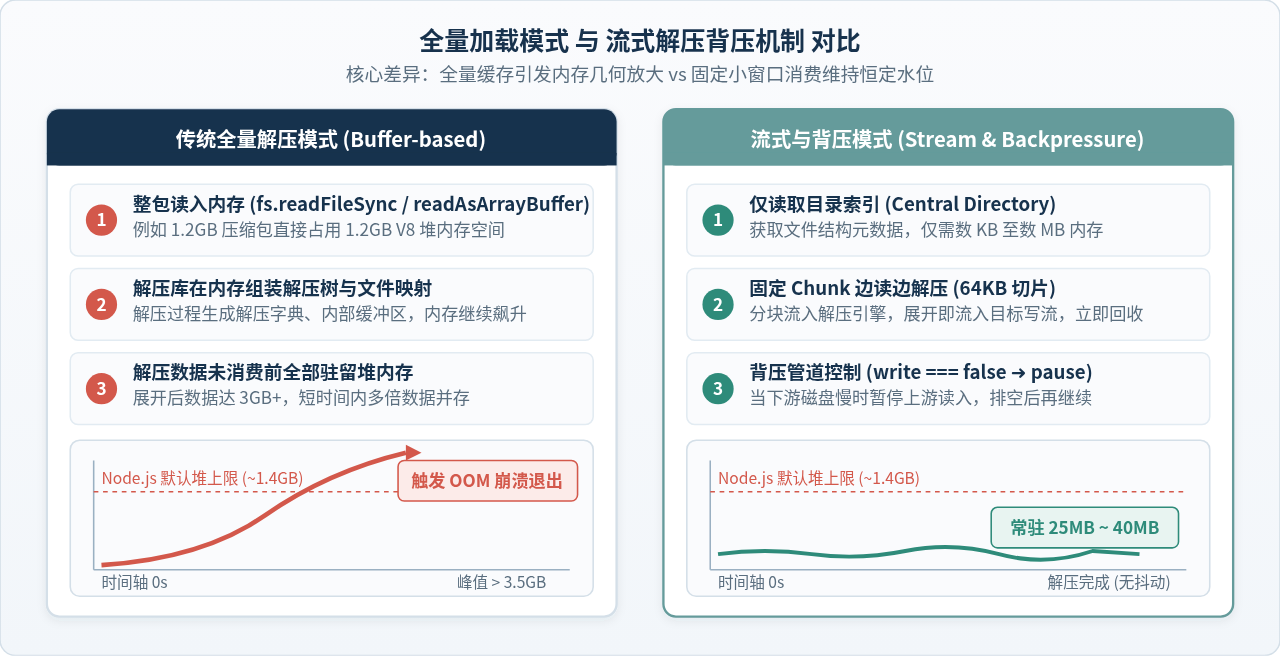
Promise.all 直接遍历目录。一个压缩后仅 20MB 的 .xlsx 文件,解压展开为底层 XML 并转为 JavaScript 对象后,可能在 V8 堆中瞬间膨胀至 300MB 到 600MB;当并发读取十几个文件时,进程会瞬间击穿 Node.js 默认堆上限,抛出 JavaScript heap out of memory 异常直接退出,同时单线程同步解压还会导致整个事件循环完全冻结。高效批量解析的破局关键,在于将全量内存加载转为流式 SAX 逐行解析,并结合滑动窗口并发控制与 Worker Threads 算力隔离。
一、内存暴涨与事件循环停顿:朴素批处理为何崩溃
很多开发者初次遇到批量导入需求时,习惯使用 fs.readdir 获取文件列表,随后通过 xlsx.readFile() 或 node-xlsx.parse() 一次性把所有文件读入。在处理十几个微型模板文件时一切正常,但当文件数量增加到几百个,或者遇到单表包含十几万行的大型报表时,服务便频繁崩溃。
要理解崩溃的根本原因,必须先看 .xlsx 文件的内部构造。.xlsx 本质是一个包含多个 XML 文件的 ZIP 压缩包,主要由工作簿定义(workbook.xml)、共享字符串表(sharedStrings.xml)以及工作表数据(sheet1.xml)构成。
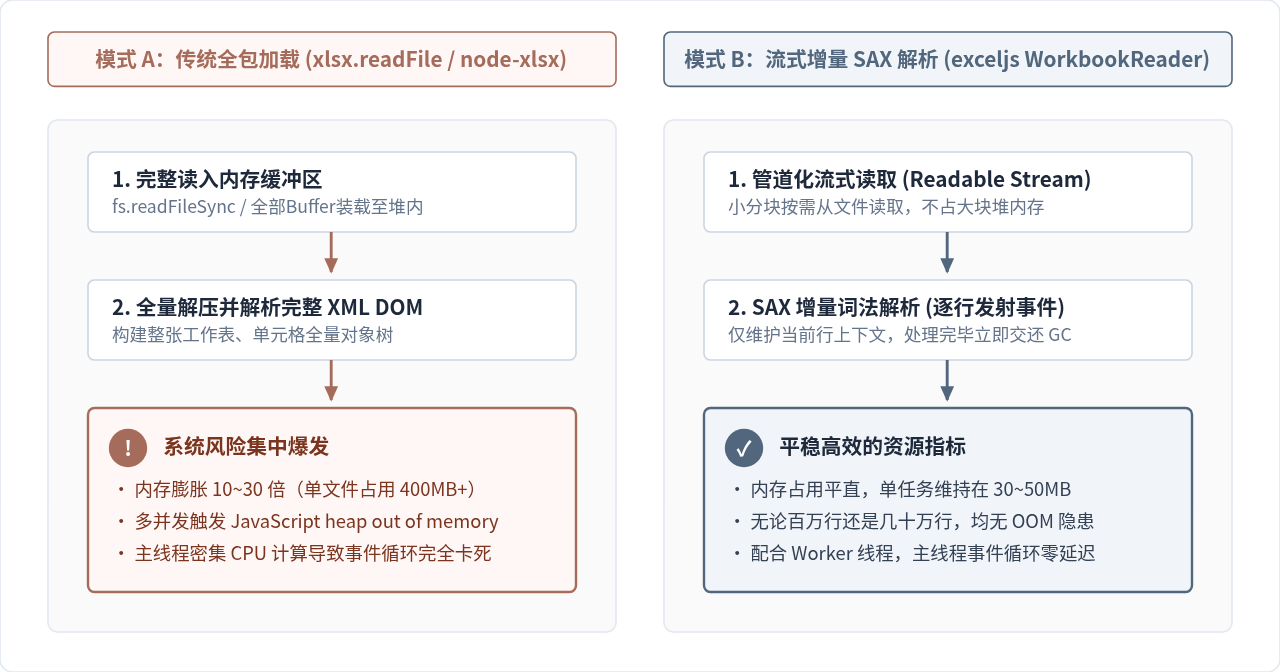
- 对象暴增与堆内存枯竭:传统读取库为了便于使用,会把整个 XML 结构完全解包,将单元格坐标、格式、公式和值统统封装为独立的 JavaScript 对象保存在树形结构中。在 V8 引擎中,每个普通对象都带有固定的原型链和隐式类(Hidden Class)开销,数据体积呈数倍到数十倍膨胀。
- CPU 密集操作阻塞事件循环:ZIP 文件的流解压(zlib inflate)以及庞大 XML 字符串的词法分析是高度消耗 CPU 的同步操作。在 Node.js 单线程模型下,如果直接在主线程执行密集的 XML 解析,其他异步 I/O、HTTP 请求应答以及健康检查定时器将被完全阻塞,导致服务发生雪崩式超时。
二、核心解析策略:从整包加载转向流式 SAX 解析
在 Node.js 中解决内存瓶颈的首要原则是:只在内存中保留当前正在处理的数据。
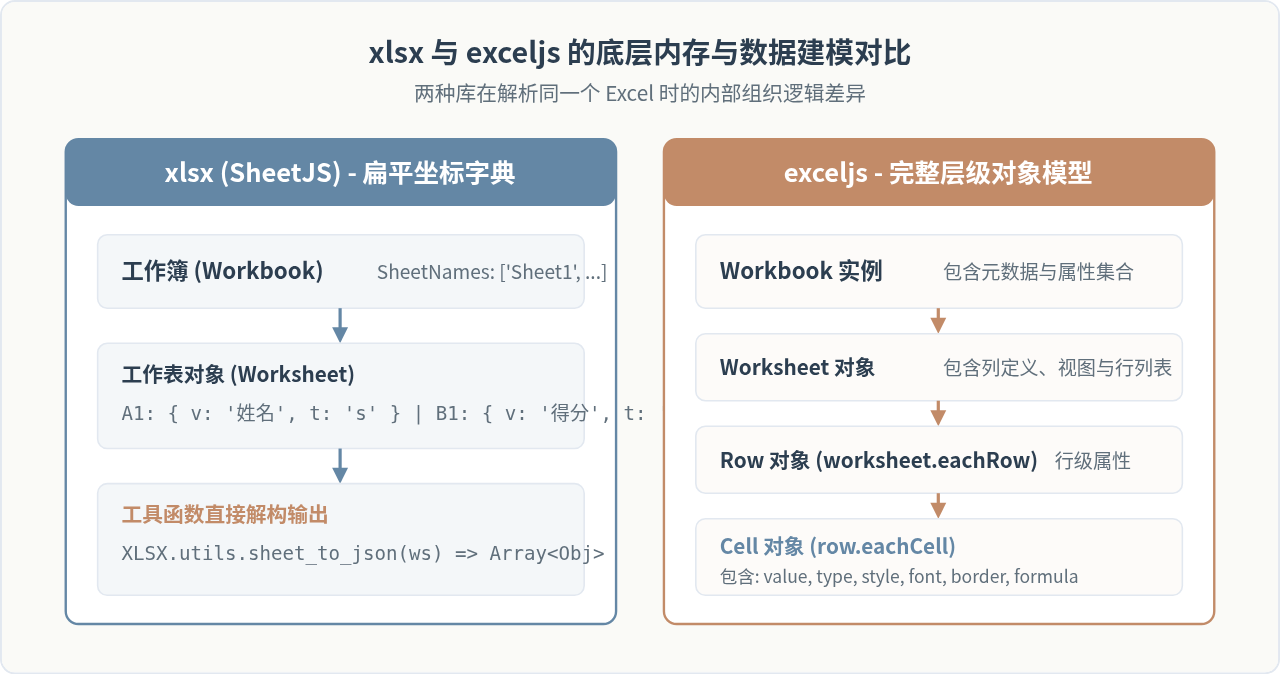
主流库 exceljs 内部提供了成熟的流式解析器 exceljs.stream.xlsx.WorkbookReader。与常规的 workbook.xlsx.readFile() 不同,WorkbookReader 采用基于事件驱动的 SAX 词法解析器。它监听底层的输入流,在解压 XML 时遇到 <row> 标签即触发一次行事件,在行结束时把数据封装为简单的行对象抛出,随后丢弃该节点的引用。
下面是单文件流式读取的最简原型示例,体会其通过事件处理行数据的机制:
// 基础流式解析原型示例(单文件)
const ExcelJS = require('exceljs');

async function parseExcelStream(filePath, onRowParsed) {
  const options = {
    entries: 'emit',
    sharedStrings: 'cache', // 缓存共享字符映射,提升解析速度
    worksheets: 'emit'
  };

  const workbookReader = new ExcelJS.stream.xlsx.WorkbookReader(filePath, options);

  for await (const worksheetReader of workbookReader) {
    if (worksheetReader.name !== 'Sheet1') {
      // 遇到不需要的工作表,跳过读取流以节约 CPU
      worksheetReader.destroy();
      continue;
    }

    for await (const row of worksheetReader) {
      // row.values 即为当前行的原始数组,提取后立即交由业务处理
      // 处理完当前行后,V8 能够快速在新生代 GC 中回收其对象
      onRowParsed(row.values);
    }
  }
}
在这个模型中,不论 Excel 文件包含 1,000 行还是 1,000,000 行,驻留在内存中的只有解压流缓冲区和当前解析出的那一行数据,内存占用曲线始终呈平直的低水位状态。
三、批量架构设计:并发控制与微批次流转
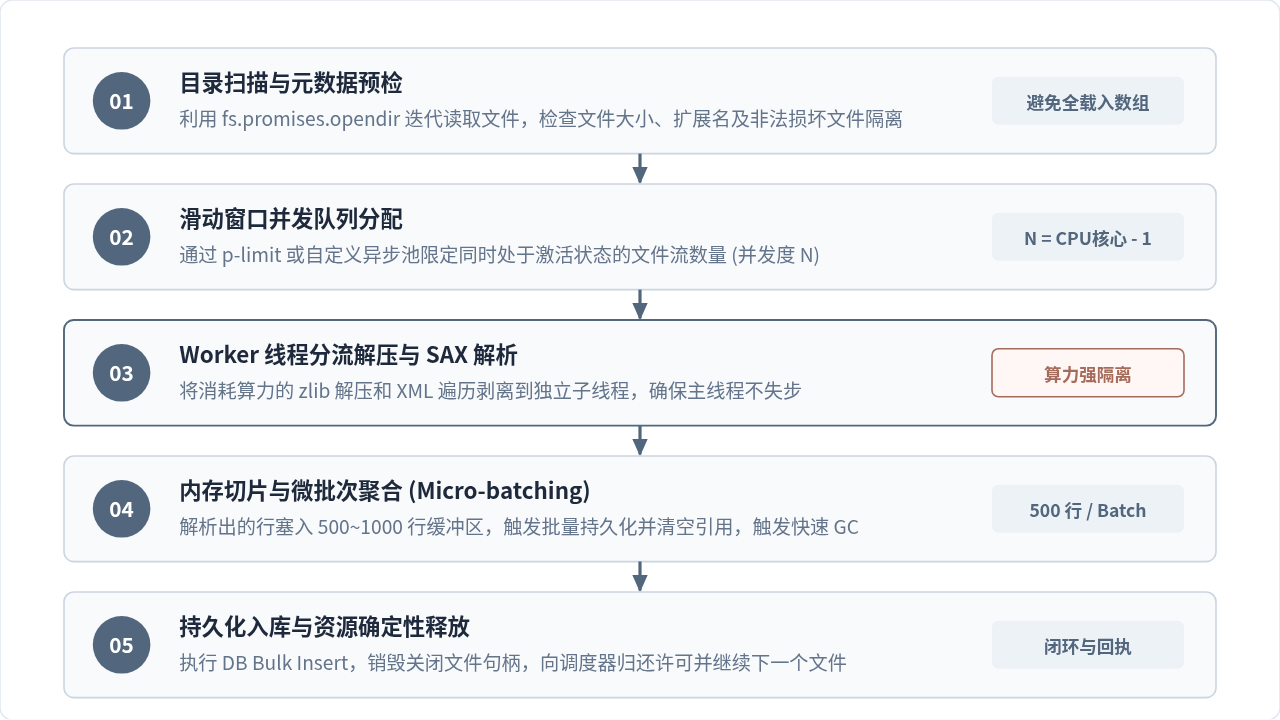
当我们将流式解析应用到数百甚至数千个文件时,如果写出 await Promise.all(files.map(parseExcelStream)),依然会导致严重问题:
- 系统文件描述符耗尽:操作系统对进程同时打开的文件数量有严格限制(通常上限为 1024 或更高)。如果同时打开上千个读文件流,会立即抛出
EMFILE: too many open files错误。 - 累积内存突破阈值:即使单个流解析器只占用 35MB 内存,100 个流并发运行也会瞬时占用 3.5GB 内存,再度击穿 V8 堆内存上限。
因此,必须在批量处理管线中引入滑动窗口并发控制,并且在数据持久化端引入微批次(Micro-batching)机制。
四、算力卸载:利用 Worker Threads 隔离 CPU 密集型开销
即便单文件流式解析能够压制内存,解压和 XML 解析的 CPU 占用依然存在。如果在一个 Web 服务的同一个主线程中处理这批文件,用户发来的 HTTP 请求会遭遇数秒甚至数十秒的无响应。
Node.js 提供的 worker_threads 模块是解决这一问题的工业级标准方案:
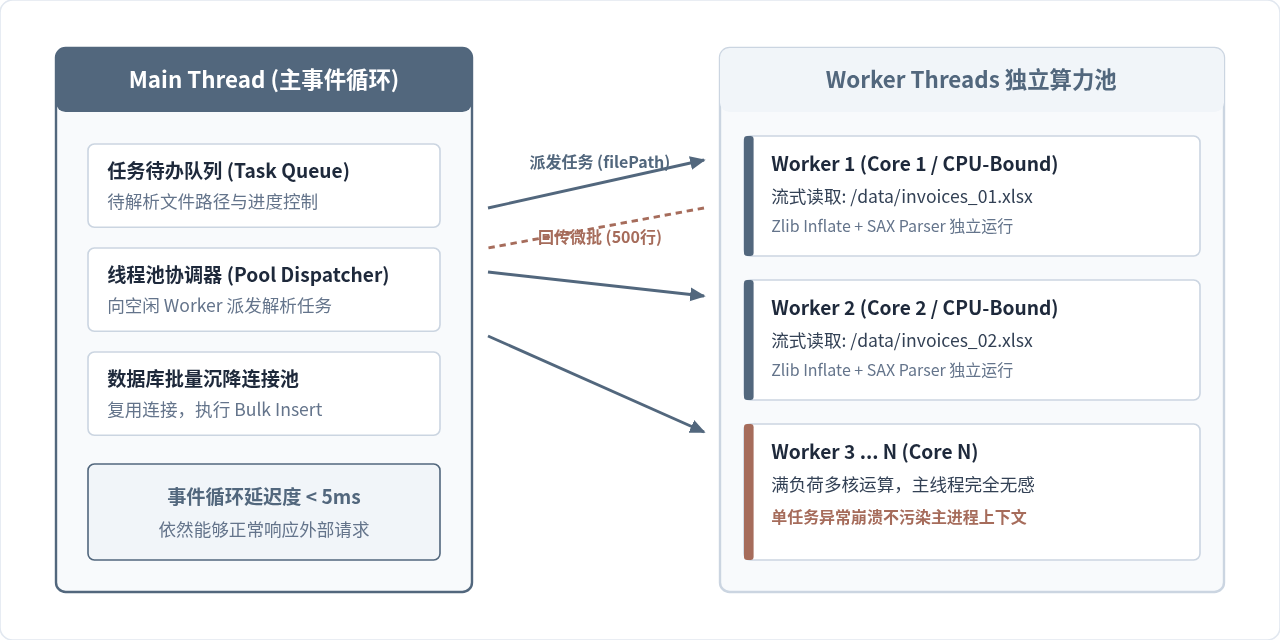
- 主线程职责:专注轻量级的任务分发、统计监控、网络通信与数据库连接池复用。
- Worker 线程职责:专注执行独立的 Node.js 读文件流创建、zlib 解压缩以及 SAX 逐行解析,将解析好的数据成批发送回主线程或直接在子线程消费。
五、完整工程落地代码:多线程流式批处理实现
接下来通过一套完整、可运行的代码,展示从目录文件发现、Worker 线程池初始化、流式行解析,到主线程批量消费与内存控制的全过程。代码拆分为工作线程脚本 excel-worker.js 与主调度脚本 batch-processor.js。
1. 子线程代码:excel-worker.js
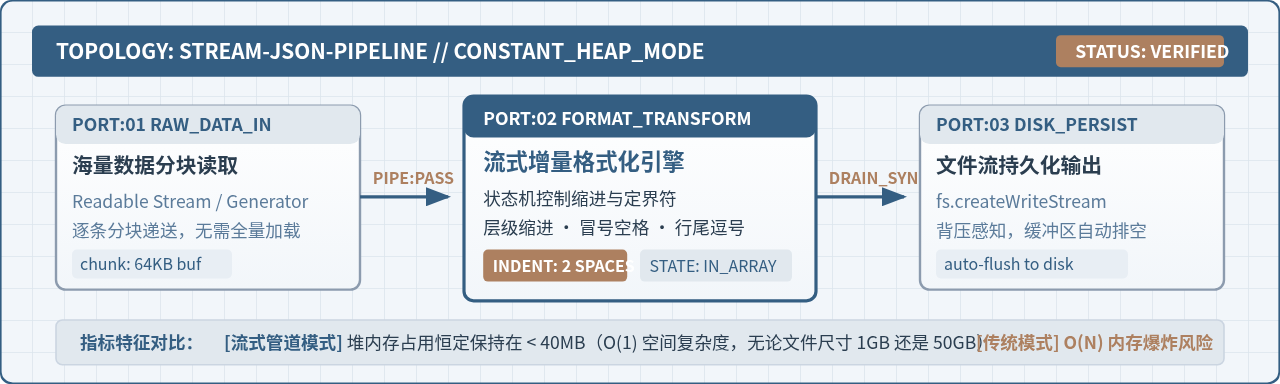
子线程负责接收主线程下发的文件路径,创建 WorkbookReader 逐行解析,并将行数据按指定块大小(例如每 500 行)聚合后,通过 parentPort.postMessage 发送给主线程:
// excel-worker.js
// 运行环境:Node.js 18+ 原生 worker_threads 模块
const { parentPort, workerData } = require('node:worker_threads');
const ExcelJS = require('exceljs');

const BATCH_SIZE = 500; // 每 500 行作为一次微批次回传

async function processFile(filePath) {
  const options = {
    entries: 'emit',
    sharedStrings: 'cache',
    worksheets: 'emit'
  };

  const workbookReader = new ExcelJS.stream.xlsx.WorkbookReader(filePath, options);
  let batchBuffer = [];
  let totalRows = 0;

  for await (const worksheetReader of workbookReader) {
    for await (const row of worksheetReader) {
      // 过滤空白行
      if (!row || !row.values || row.values.length === 0) continue;

      // 提取纯净数据数组(注意:ExcelJS 的 row.values 第 0 项通常为空)
      const rowData = Array.isArray(row.values) ? row.values.slice(1) : [];
      batchBuffer.push(rowData);
      totalRows++;

      if (batchBuffer.length >= BATCH_SIZE) {
        // 向主线程回传当前微批数据
        parentPort.postMessage({
          type: 'DATA_CHUNK',
          filePath,
          chunk: batchBuffer
        });
        // 彻底释放本批次数组引用,允许 V8 立即 GC
        batchBuffer = [];
      }
    }
  }

  // 发送剩余尾部数据
  if (batchBuffer.length > 0) {
    parentPort.postMessage({
      type: 'DATA_CHUNK',
      filePath,
      chunk: batchBuffer
    });
    batchBuffer = [];
  }

  // 告知主线程该文件解析完成
  parentPort.postMessage({
    type: 'COMPLETED',
    filePath,
    totalRows
  });
}

// 接收主线程的派发指令
parentPort.on('message', async (message) => {
  if (message.type === 'START_FILE') {
    try {
      await processFile(message.filePath);
    } catch (err) {
      parentPort.postMessage({
        type: 'ERROR',
        filePath: message.filePath,
        error: err.message
      });
    }
  }
});
2. 主线程代码:batch-processor.js
主线程管理线程池,按 CPU 核心数动态实例化 Worker,并通过简单的队列将待解析目录下的文件逐个下发,收到微批数据后执行持久化逻辑:
// batch-processor.js
const fs = require('node:fs/promises');
const path = require('node:path');
const os = require('node:os');
const { Worker } = require('node:worker_threads');

// 线程池最大并发度建议:保留 1 个核心给系统与主线程
const CONCURRENCY_LIMIT = Math.max(1, os.cpus().length - 1);

// 模拟数据库批量插入操作
async function saveRowsToDatabase(filePath, rows) {
  // 在实际业务中,此处调用 Knex、Prisma 或原生 SQL 驱动执行 INSERT INTO ... VALUES (...)
  // 模拟少量 I/O 耗时
  return new Promise((resolve) => setTimeout(resolve, 5));
}

class ExcelBatchPipeline {
  constructor(workerScriptPath, concurrency = CONCURRENCY_LIMIT) {
    this.workerScriptPath = workerScriptPath;
    this.concurrency = concurrency;
    this.queue = [];
    this.activeWorkers = 0;
  }

  // 扫描输入目录
  async collectFiles(dirPath) {
    const dir = await fs.opendir(dirPath);
    const files = [];
    for await (const dirent of dir) {
      if (dirent.isFile() && dirent.name.endsWith('.xlsx')) {
        files.push(path.join(dirPath, dirent.name));
      }
    }
    return files;
  }

  async run(dirPath) {
    const files = await this.collectFiles(dirPath);
    console.log(`[Pipeline] 发现目标文件 ${files.length} 个,启动并发线程数: ${this.concurrency}`);
    this.queue = files;

    const startTime = Date.now();
    let completedFiles = 0;
    let totalRowsProcessed = 0;

    return new Promise((resolve, reject) => {
      const checkDone = () => {
        if (completedFiles === files.length) {
          const duration = ((Date.now() - startTime) / 1000).toFixed(2);
          console.log(`[Pipeline] 全部完成! 耗时: ${duration}s, 累计入库行数: ${totalRowsProcessed}`);
          resolve();
        }
      };

      const spawnWorkerTask = () => {
        if (this.queue.length === 0) return;
        if (this.activeWorkers >= this.concurrency) return;

        const currentFile = this.queue.shift();
        this.activeWorkers++;

        const worker = new Worker(this.workerScriptPath);

        worker.postMessage({ type: 'START_FILE', filePath: currentFile });

        worker.on('message', async (msg) => {
          if (msg.type === 'DATA_CHUNK') {
            await saveRowsToDatabase(msg.filePath, msg.chunk);
          } else if (msg.type === 'COMPLETED') {
            completedFiles++;
            totalRowsProcessed += msg.totalRows;
            console.log(`[Success] 文件解析完成: ${path.basename(msg.filePath)} (共 ${msg.totalRows} 行)`);
            worker.terminate();
            this.activeWorkers--;
            spawnWorkerTask();
            checkDone();
          } else if (msg.type === 'ERROR') {
            console.error(`[Error] 文件解析异常: ${path.basename(msg.filePath)}, 错误: ${msg.error}`);
            worker.terminate();
            completedFiles++;
            this.activeWorkers--;
            spawnWorkerTask();
            checkDone();
          }
        });

        worker.on('error', (err) => {
          console.error(`[Worker Crash] 线程异常:`, err);
          worker.terminate();
          this.activeWorkers--;
          spawnWorkerTask();
        });
      };

      // 预先填充全部并发槽位
      for (let i = 0; i < this.concurrency; i++) {
        spawnWorkerTask();
      }
    });
  }
}

// 执行批处理
async function main() {
  const targetDir = path.resolve(__dirname, './excel_input_dir');
  const workerFile = path.resolve(__dirname, './excel-worker.js');

  const pipeline = new ExcelBatchPipeline(workerFile);
  await pipeline.run(targetDir);
}

main().catch(console.error);
六、生产环境避坑指南与参数调优
在批量处理企业实际导出的 Excel 文件时,往往会遭遇各种格式细节和边缘场景,以下是经过验证的避坑要点:
1. 警惕共享字符串表(sharedStrings.xml)内存陷阱
Excel 为节约磁盘体积,默认把单元格中的文本统一存放在 sharedStrings.xml。如果某批文件包含几百万条不重复的唯一文本串(如流水号、UUID),该字符串表展开后的体积也会极大。
ExcelJS.stream.xlsx.WorkbookReader 的配置中,默认选项 sharedStrings: 'cache' 会在内存中以哈希结构缓存所有字符串。如果遇到超大型字符串字典,可以评估改用专用的轻量级流式解析器(例如 xlsx-stream-reader),直接在 XML 流遇到 <t> 文本节点时行级读取,避免预装载全量字符串表。
2. 公式单元格与计算缓存
在流式读取时,由于没有完整构建跨工作表的引用拓扑,流式解析器通常不会重新执行公式计算。它读取的是该单元格上次保存时的缓存值(cell.result)。如果需要读取公式文本本身,需访问 cell.formula。在做数据校验时,务必明确业务字段需要的是最终结果还是公式原文。
3. 日期时区漂移与序号偏移
Excel 存储日期的底层机制是从 1900 年 1 月 1 日开始的天数浮点数(例如 45230.5)。解析器在将其转换为 JavaScript Date 对象时,会受到 Node.js 进程当前 TZ 环境变量的影响。为了避免跨时区服务器导致的日期偏移一天的问题,在读取日期列时,优先获取格式化后的原始字符串,或在转换为时间戳前统一校准 UTC 偏移。
4. 异常隔离:单个坏文件不得阻塞整个批次
在处理第三方上报的文件时,经常混杂着损坏的 ZIP 文件、加密的 Excel、或者伪装成 .xlsx 的 HTML/CSV 文件。如果缺乏隔离,一个文件的解析异常就会抛出全局未捕获异常导致批量任务中断。在上述架构中,Worker 线程的 try...catch 结合 worker.terminate() 实现了天然的故障隔离,出错的文件被即时记录到错误清单中,调度器立刻填补下一个文件继续执行。
总结
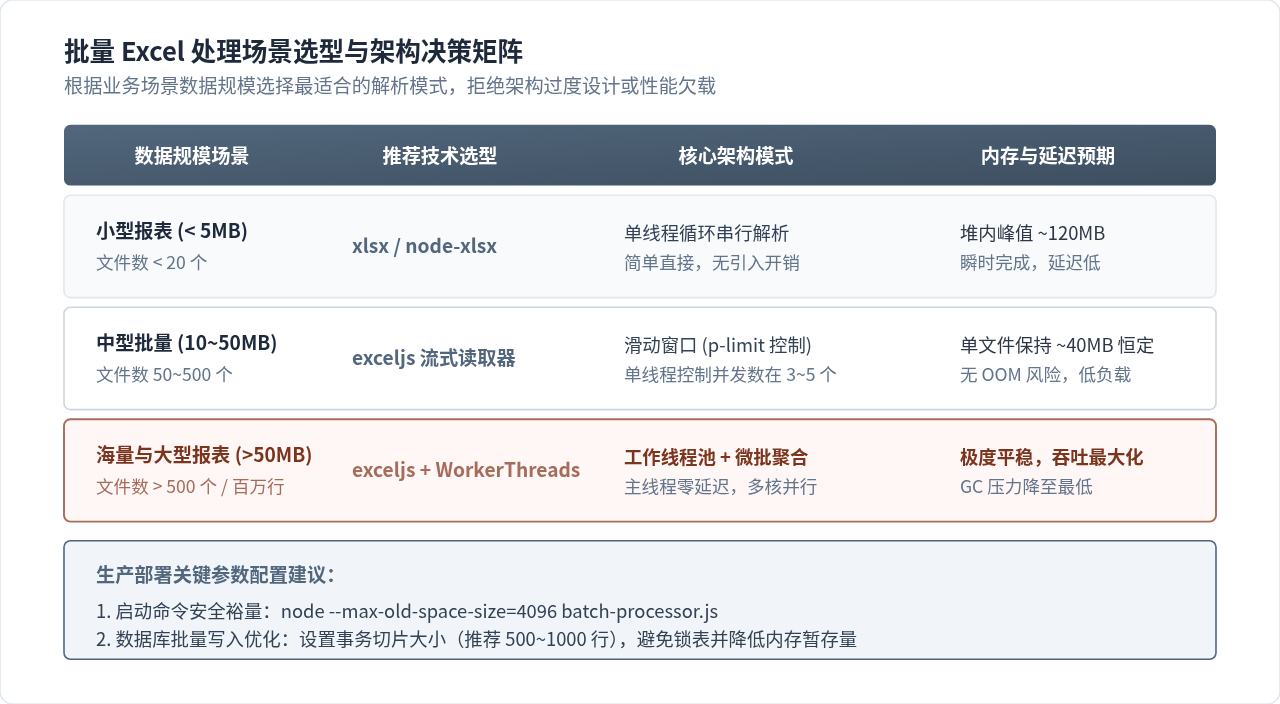
在 Node.js 环境下高效批量解析 Excel,并不是简单地给脚本分配更大的堆内存(--max-old-space-size),因为单纯增大内存只能延缓崩溃,无法解决 CPU 密集解析对事件循环的封锁。
真正可靠的高性能方案遵循清晰的架构分层:
- 解析层:采用
exceljs.stream.xlsx.WorkbookReader等流式 SAX 解析器,按行消费、即刻释放,将单任务内存锁死在极低的恒定水位; - 调度层:利用滑动窗口严格控制激活文件句柄数与并发度,杜绝文件描述符与瞬间内存击穿;
- 算力层:将解压与 XML 字符遍历的重计算分发至
worker_threads线程池,充分发挥多核性能,保持服务主事件循环的敏捷与健壮。
UmiJS 项目构建速度优化与打包体积精简技巧
2026-11-04 22:37:09
原生JS操作DOM与Vue/React虚拟DOM的本质区别
2026-11-04 17:52:27
怎么使用console.group和table优化JS日志可读性
2026-11-03 23:14:34
基于AST抽象语法树的JS代码反混淆实战教程
2026-11-03 21:22:24
JS手机号输入校验的性能优化与用户体验提升
2026-11-03 19:19:19