JVM编译执行 vs JS解释执行:Java与JavaScript运行原理详解
深入解析 Java JVM 与 JavaScript 引擎的运行原理,破除编译执行与解释执行的传统误区,详解两者的字节码、JIT分层编译、类型系统与性能优化机制。
在技术讨论和入门学习中,“Java是编译执行的,而JavaScript是解释执行的”是一句被频繁引用的定论。然而在现代工程实践中,这种截然二分的观点早已严重偏离技术现实。现代 HotSpot JVM 和 V8 引擎内部都集成了字节码解释器和多级即时编译器(JIT),两者都走在“混合执行”的道路上。理解两者的根本差异,不能只停留在“是否需要 javac 编译”的表面,而必须深入分析静态类型与动态类型的约束、字节码设计的出发点,以及 JIT 编译器在性能推导与去优化(Deoptimization)上的设计分歧。
一、传统认知误区与现代混合执行体系
早期的语言实现往往非黑即白:C/C++ 通过静态编译器将源码一次性翻译成目标平台的原生机器码;早期的 JavaScript(如 SpiderMonkey 初始版本)则是纯粹的树遍历或字节码解释器,逐行读取脚本逐行解释执行。这种历史背景形成了“编译型语言运行快、解释型语言灵活性高但速度慢”的传统印象。
但在现代主流运行时中,无论是服务端的 Java 还是浏览器与 Node.js 中的 JavaScript,都已经演变为混合执行引擎:
- 解释执行的优势在于启动开销低:无需等待漫长的机器码生成,解析完语法即可立即执行第一行逻辑。
- 编译执行的优势在于运行效率高:经过优化的原生机器码可以直接由 CPU 硬件指令流水线处理,消除了解释器的循环调度开销。
因此,现代 JVM 和现代 JS 引擎都选择结合两者的长处:先以较小的代价快速启动,在运行过程中动态监控“热点代码(Hot Spot)”,再对高频执行的代码块进行机器码层级的即时编译。
二、Java 的运行原理:从源码到混合执行流水线
Java 程序的完整生命周期分为两个截然不同的阶段:运行前的“静态编译期”与运行时的“虚拟机执行期”。
在编译期,开发者使用 javac 命令将 .java 源代码编译成统一规范的 .class 字节码文件。字节码是一种中间表示(IR),它基于栈式虚拟机的指令集,与底层操作系统和 CPU 架构完全解耦。这一步完成了所有的语法检查、静态类型检查、常量折叠与语法糖展开。
在运行期,Java 虚拟机(JVM)负责载入并执行这些字节码。JVM 不会简单地将整个 class 文件直接翻译成机器码,而是通过一套分步流水线逐步执行。
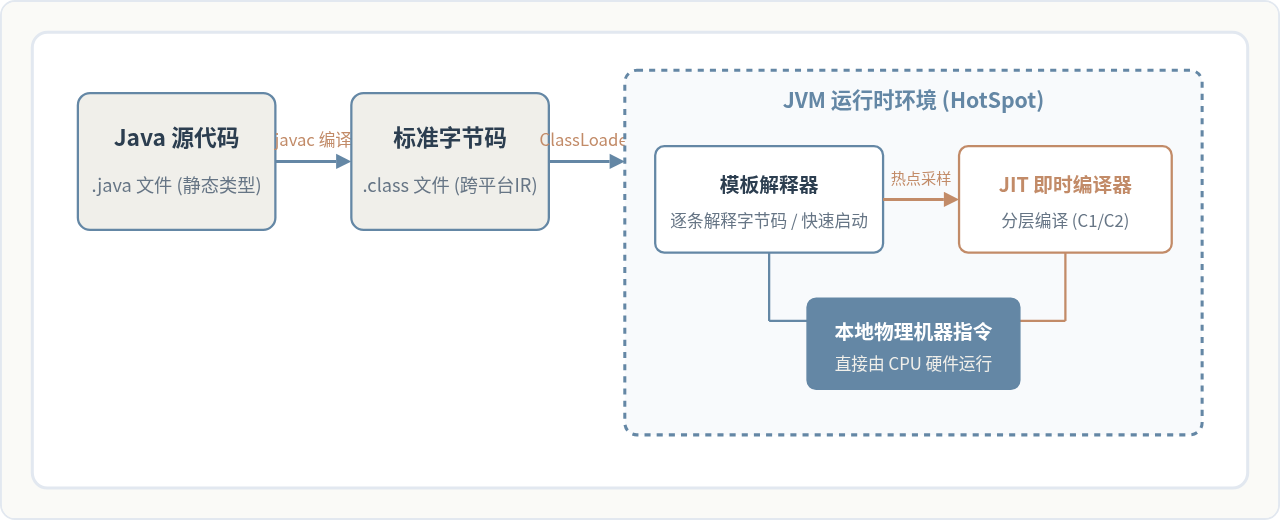
如流程图所示,Java 的运行步骤如下:
- 前端静态编译:
javac验证语义与类型系统,输出平台无关的字节码。 - 类加载与字节码校验:类加载器读取
.class二进制流,字节码验证器确保没有破坏内存安全的操作。 - 解释器初次执行:HotSpot 采用模板解释器(Template Interpreter),直接将字节码对应到预生成的机器码模版,省去前端解析开销,立刻开始执行程序。
- 性能分析与热点探测:通过方法调用计数器和回边计数器(循环检测),收集代码执行频次。
- JIT 编译为物理代码:当方法或循环体的调用次数越过阈值,JVM 后台启动 JIT 编译线程,生成针对当前 CPU 架构优化后的纯机器指令,存入 CodeCache 中供后续直接调用。
三、HotSpot JVM 内部机制:分层编译与优化器协同
在 Java 8 及更高版本中,HotSpot 默认开启了“分层编译(Tiered Compilation)”。分层编译将执行过程细分为不同的层次,让解释器与多个编译器协同作战:
- 第 0 层(Interpreter):纯解释执行,并负责收集初步的性能剖析数据(Profiling Info)。
- 第 1-3 层(C1 Client Compiler):偏向快速编译。C1 拥有局部的基本优化手段(如公共子表达式消除、内联缓存),可以在极短时间内生成机器码,使程序快速摆脱低效的纯解释状态。
- 第 4 层(C2 Server Compiler / Graal):全局重度优化。C2 会耗费相对较多的 CPU 和内存资源进行全局数据流分析、方法内联(Inlining)、逃逸分析(Escape Analysis)、标量替换(Scalar Replacement)以及循环展开。
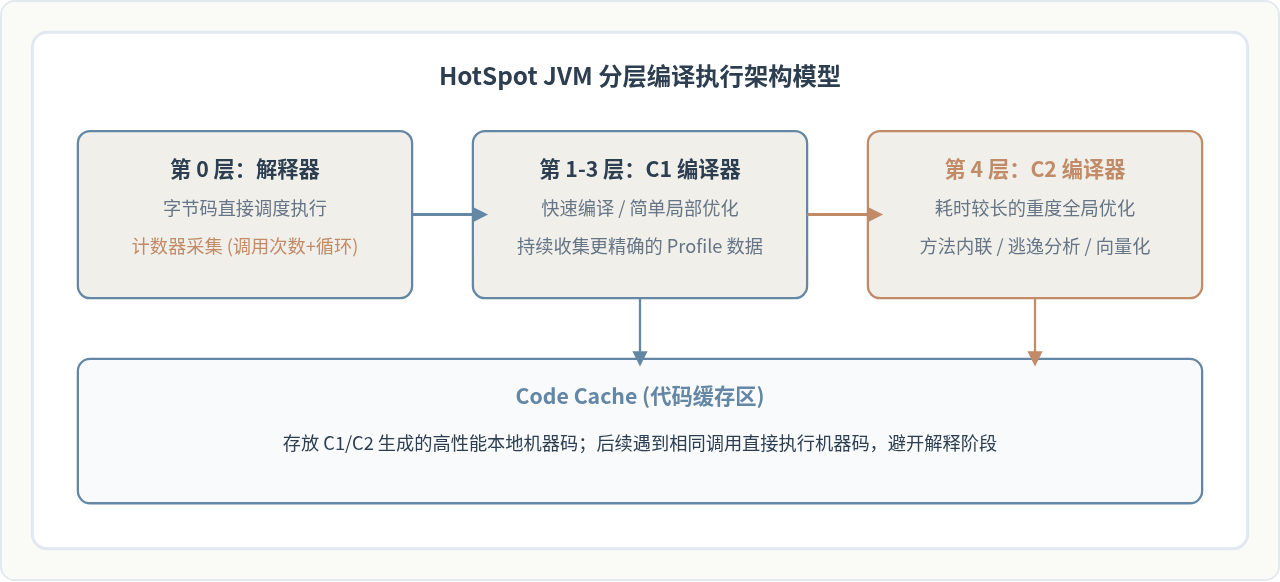
因为 Java 具有严格的静态类型系统,编译期已经确定了所有类、字段偏移和方法签名。在 C2 进行优化时,关于“对象结构”和“方法分派”的假设极为稳定,这使得 Java 生成的本地代码具有极强的确定性和极高吞吐上限。
四、JavaScript 的运行原理:从 AST 到 V8 引擎管线
与 Java 不同,JavaScript 规范(ECMAScript)并没有要求预编译为平台无关的二进制文件。在浏览器或 Node.js 环境中,JS 引擎直接接收 UTF-8 编码的原始字符串源码。
以 Chrome 和 Node.js 所依赖的 Google V8 引擎为例,其现代流水线主要由三个核心组件构成:Parser(解析器)、Ignition(字节码解释器)和 TurboFan(优化编译器)。
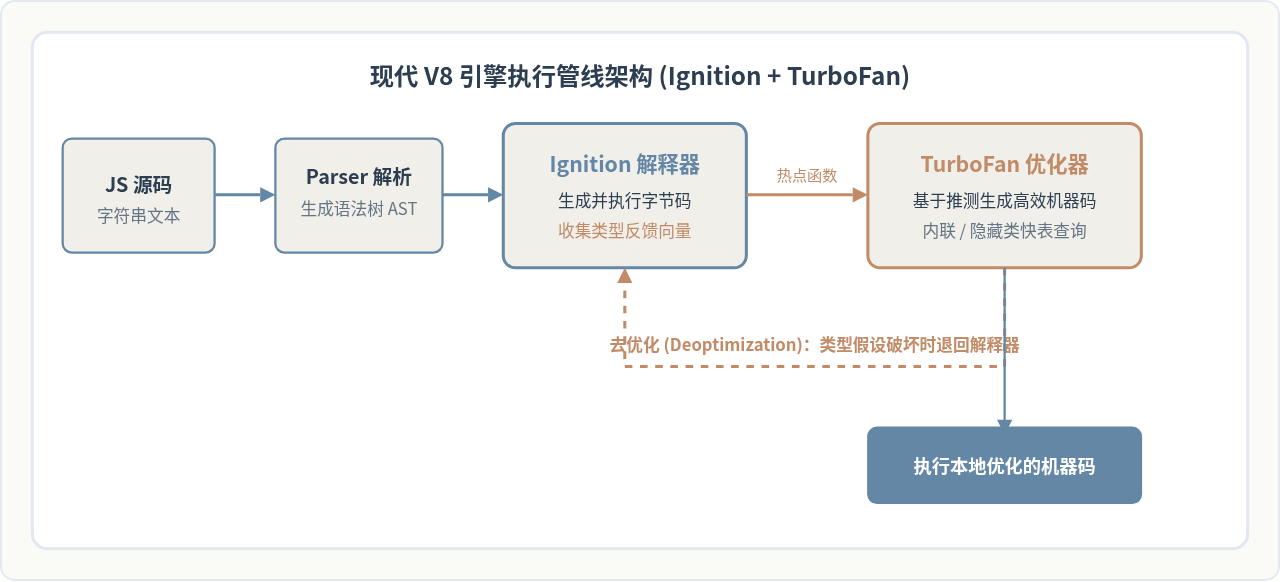
V8 执行 JavaScript 的具体步骤包括:
- 词法与语法解析:Parser 将源码文本解析为抽象语法树(AST)。为了缩短页面首屏加载时间,V8 采用懒解析(Pre-parser),未立即执行的函数仅做语法合法性扫描。
- Ignition 生成字节码:AST 输入到 Ignition 解释器中,翻译成精简的字节码(Bytecode)序列并开始执行。字节码所占内存仅为 AST 的约四分之一,这大幅减轻了移动设备与弱网环境下的内存压力。
- 内联缓存与类型反馈:在解释执行字节码的同时,Ignition 在反馈向量(Feedback Vector)中记录每一个操作点的结构信息。例如对象访问
obj.x是否始终具有相同的形状(隐藏类 Hidden Class / Shape),加法运算a + b输入的是纯整数、浮点数还是字符串。 - TurboFan 投机编译:一旦某段函数成为热点,TurboFan 读取字节码及其关联的类型反馈信息,基于“假设类型永远不变”的乐观推测,将其编译为高度优化的物理机器码。
- 去优化(Deopt)反退:如果代码在某次调用中传入了不同类型的参数(例如一直传入整数的函数忽然收到一个字符串),TurboFan 的类型假设立即失效,CPU 必须立刻放弃执行优化的机器码,将上下文完整还原(Bailout)并回退到 Ignition 解释器继续执行。
五、核心运行原理对比:两者的深层技术差异
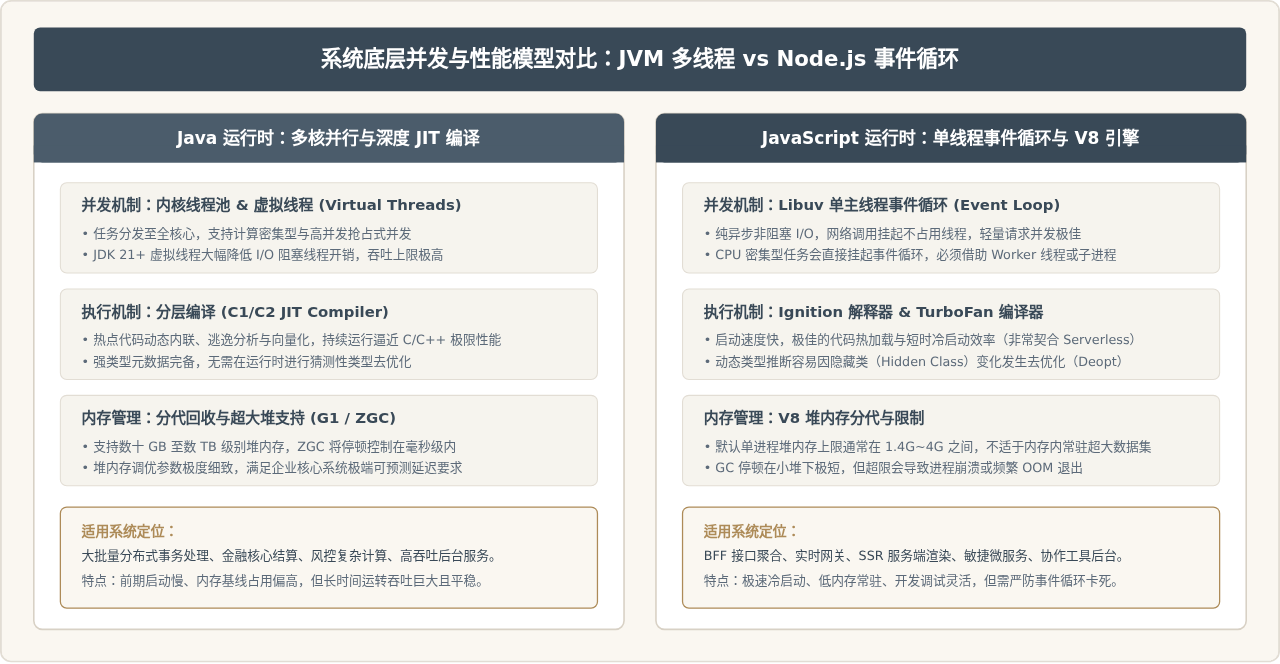
通过对比两者的工作流水线,可以看出两者的根本差异并不在“是否编译”,而在于以下四个维度的设计权衡:
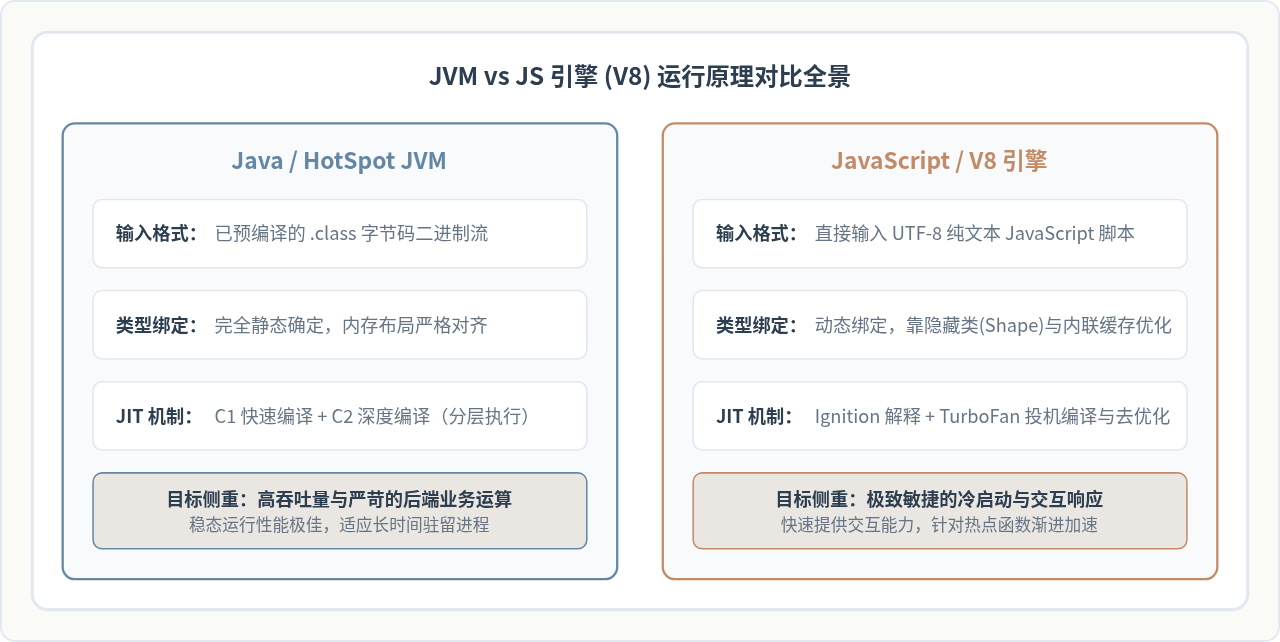
| 对比维度 | JVM (Java 体系) | 现代 JS 引擎 (如 V8) |
|---|---|---|
| 源码处理阶段 | 预先完成静态编译,部署的是二进制 .class 字节码。 |
分发并直接接收纯文本源码,运行时即时完成词法解析与 AST 构建。 |
| 类型约束性质 | 强类型、静态类型。变量类型在运行前完全锁定,内存偏移固定。 | 弱类型、动态类型。变量在运行时可绑定任意类型,对象属性可动态增删。 |
| 中间字节码设计 | 基于操作数栈(Stack-based)的标准字节码,指令精简且统一规范。 | 基于累加器寄存器(Accumulator Register)的私有字节码,针对特定引擎优化。 |
| JIT 优化假设稳定性 | 极高。类型信息恒定,去优化主要发生于类加载扩展接口或反射多态破坏时。 | 相对脆弱。依赖动态推测(Speculation),类型震荡会导致频繁发生 Deopt 性能骤降。 |
| 启动耗时与吞吐偏向 | 冷启动较重(需加载 JVM、校验字节码、类链接),但长期稳定吞吐上限极高。 | 冷启动极其敏捷(轻量解析立即执行),优先兼顾网页即时交互响应。 |
1. 为什么 JS 引擎的 JIT 优化难度远高于 JVM?
在 Java 中,当执行到以下代码时:
public class Calculator {
    public int add(int a, int b) {
        return a + b;
    }
}
JVM 在静态阶段就百分之百确认 a 和 b 是 32 位带符号整数,+ 操作对应的就是 CPU 的单条加法指令 ADD。JIT 编译器只需要考虑指令级重排、内联等硬件优化。
而在 JavaScript 中:
function add(a, b) {
    return a + b;
}
这里的 + 操作符在规范中极其复杂:可能是两个小整数(Smi)相加,可能是双精度浮点数(Double)运算,可能是字符串拼接,甚至可能触发对象的 valueOf() 或 toString() 隐式转换。V8 的 TurboFan 必须赌它下一次依然是同类型(例如全是整数),生成单条加法机器指令;并在其前面安插一条类型守卫(Type Guard)。如果守卫未通过,就会付出高昂的 Deopt 惩罚。
六、全景对比与技术选型总结
下方的全景总结图直观呈现了 JVM 与现代 JS 引擎在整个运行生命周期各环节的对应关系与差异:
七、工程实践中的注意事项
1. JavaScript 中的“单态(Monomorphic)”编写原则
由于 V8 的 TurboFan 高度依赖内联缓存对隐藏类的假设,编写热点函数时应尽可能保持对象形状一致。不要在函数内部随机为对象添加或删除字段,也不要向同一个高频计算函数混合传入不同类型参数(例如一会儿传整数,一会儿传带小数点的对象),否则会导致内联缓存退化为超态(Megamorphic),丧失 JIT 机器码优化能力。
2. Java 中的预热(Warm-up)与 AOT(提前编译)
JVM 在刚启动时主要由解释器执行,随着方法调用次数增多才逐步晋升为 C1/C2 机器码。因此在执行微基准测试或承接核心高峰业务前,必须对系统进行“预热”。在对冷启动延迟极度敏感的场景(如 Serverless / FaaS),现代 Java 生态衍生出了 GraalVM Native Image 等 AOT 技术,将全部字节码在打包阶段直接固化为平台原生可执行文件,彻底消除了 JIT 的预热开销。
配置 Matter.js 睡眠机制以优化静止物体性能
2026-11-05 15:43:12
JavaScript console.log高级用法:用table、group和time优化调试输出
2026-11-05 08:04:56
JS变量中存储HTML代码时的特殊字符转义方法
2026-11-04 19:04:09
JS怎么安全转换带千分位或货币符号的字符串为数字
2026-11-04 11:54:14
推荐几款稳定的在线JS反混淆工具,支持Obfuscator.io解密
2026-11-04 08:16:21