JS变量中存储HTML代码时的特殊字符转义方法
深入讲解在JavaScript变量中存储与动态拼接HTML代码时的特殊字符转义方法,涵盖JS语法字面量转义与HTML字符实体转义的双层机制、转义顺序、具体代码实现及多场景避坑方案。
&、<、>、"、' 等敏感字符转换为对应的 HTML 字符实体,阻断 DOM 结构破坏与跨站脚本攻击(XSS)。
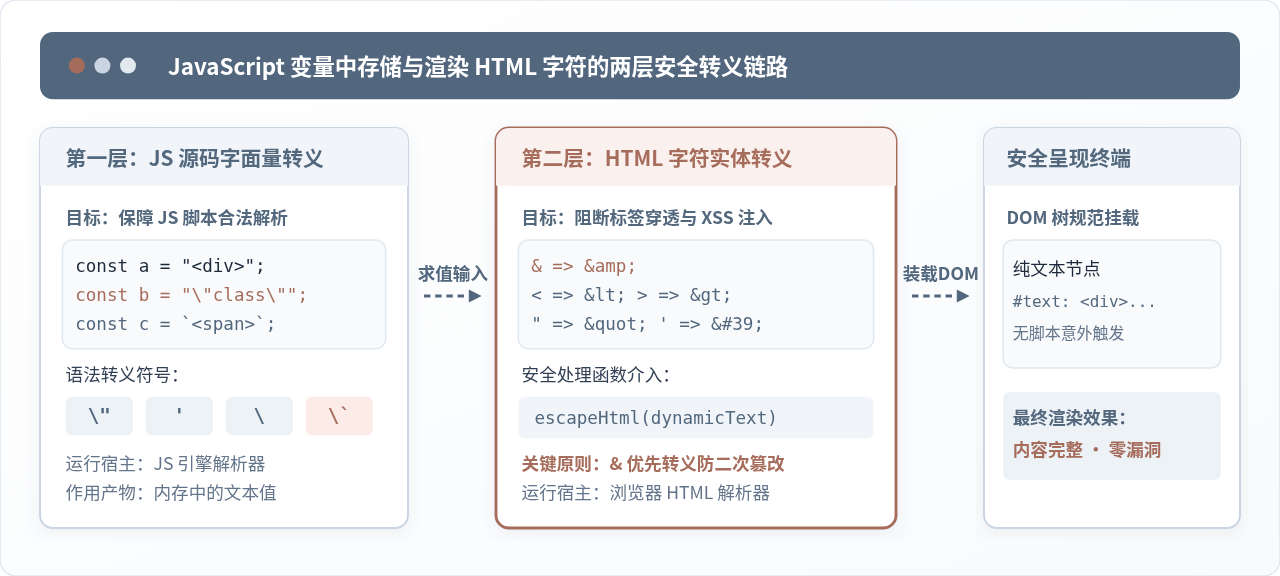
许多前端开发者在初始阶段都会遇到类似现象:在定义包含 HTML 的变量时,小心翼翼地给内部属性加上反斜杠转义(例如 let html = "<div class="box">";),程序顺利运行;但当这段变量与用户提交的动态内容拼接后插入 innerHTML 时,一旦数据中混入一个未经转义的单引号或大于号,页面排版立刻错乱,甚至直接抛出脚本注入漏洞。这种混淆的根本原因,在于把“写在 JS 代码里的字面量语法反斜杠”当成了“HTML 渲染引擎所需的字符转义”。
一、理清两个层面的转义本质
要彻底掌握转义,必须明确区分 JavaScript 引擎和 HTML 解析器分别在什么阶段工作、对哪些字符敏感。
第一层是 JavaScript 字符串自身的字面量语法转义。这是代码编写阶段的诉求,目标是告诉 JavaScript 词法分析器(Lexer)当前的引号是普通字符还是字符串的闭合边界。如果使用双引号定义字符串,内部的双引号就必须写成 ";如果使用单引号定义字符串,内部的单引号必须写成 ';如果字符串需要跨行或者包含反引号,则需在模板字符串中处理 \` 或 \${}。需要注意的是,当这一段代码被 JavaScript 引擎解析执行完毕后,反斜杠已经被引擎消费掉了,存放在内存变量中的值仍然是未经任何 HTML 处理的原始字符。
第二层是 HTML 字符实体转义(Entity Encoding)。这是运行阶段浏览器将字符串解析为 DOM 树时的诉求。浏览器解析 HTML 标记时,依仗 < 识别标签开始,依仗 > 识别标签闭合,依仗 & 识别实体引用,依仗 " 和 ' 圈定属性值边界。如果一段未经处理的纯文本直接以 HTML 形式注入,浏览器就会将文本中的 <script> 当成真正的 DOM 节点执行。因此,必须将这些符号转换为浏览器不会将其误识为语法的安全实体编码。
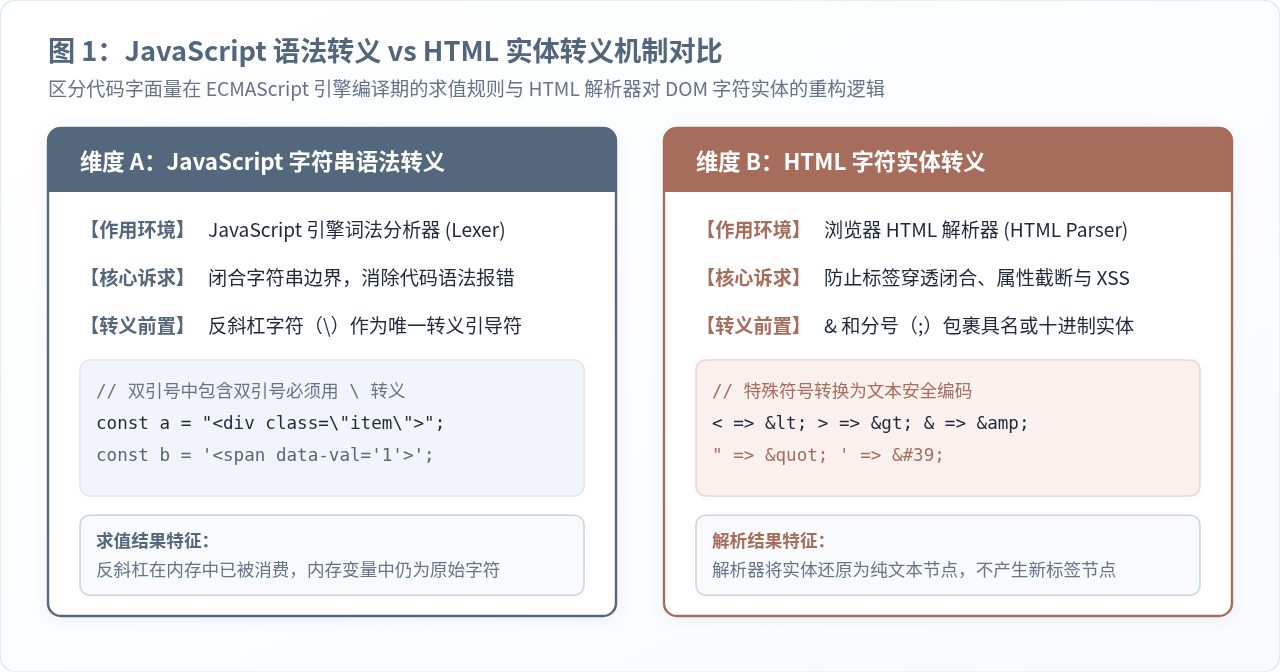
| 对比维度 | JavaScript 语法字面量转义 | HTML 字符实体转义 |
|---|---|---|
| 生效阶段 | ECMAScript 编译与词法解析阶段 | 浏览器 HTML 解析器构建 DOM 阶段 |
| 核心目的 | 闭合变量字符串边界,保证脚本正常运行 | 防止标签逃逸破坏结构,阻断 XSS 漏洞 |
| 关键前置符 | 反斜杠 \ |
和符号 & 与分号 ; |
| 典型写法 | "、'、\、\` |
&、<、>、"、' |
| 内存存储状态 | 反斜杠消失,内存中保留原始字符 | 内存中存储完整的实体文本字符串 |
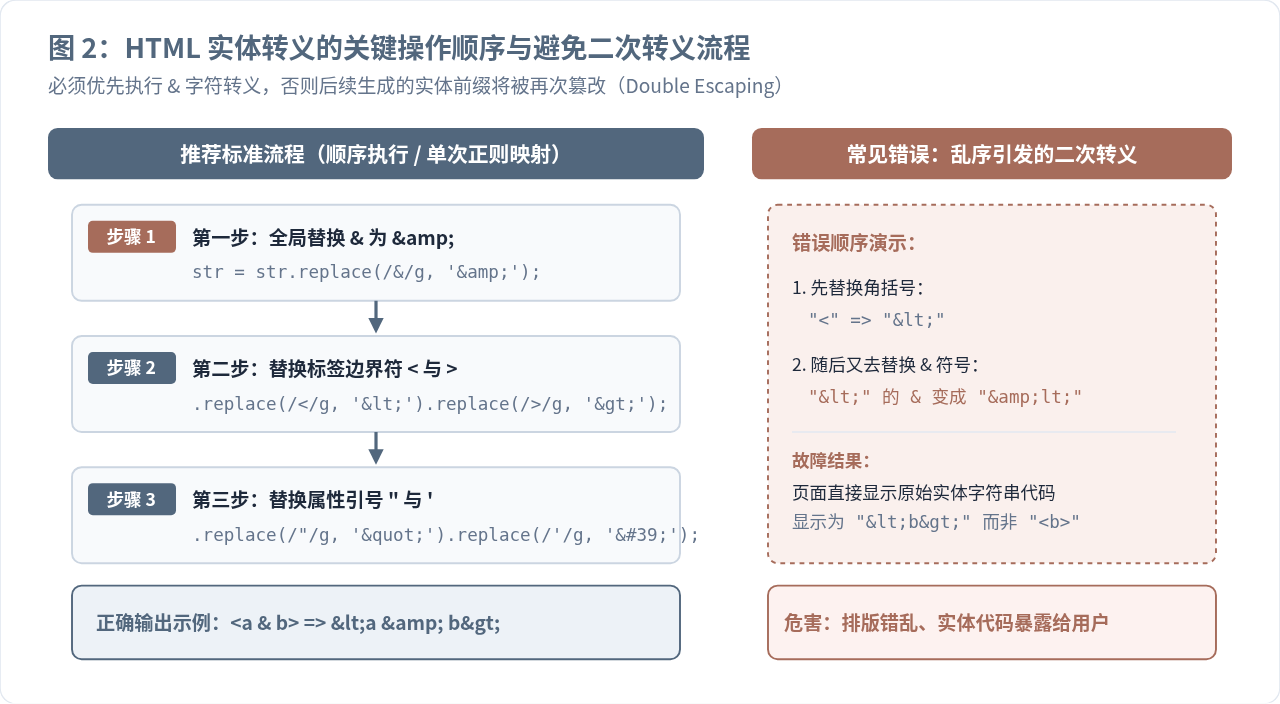
二、HTML 核心敏感字符与严格转义顺序
在构建 HTML 内容时,以下 5 个字符属于核心保留符号,也是安全转义的基石:
&必须转义为&(和符号是所有实体的起始引导符,权重最高)<必须转义为<(防止被解析为 HTML 标签开始)>必须转义为>(防止闭合前面的标签属性或标签体)"必须转义为"(防止双引号包裹的 HTML 属性被提前闭合)'必须转义为'(防止单引号包裹的 HTML 属性被提前闭合)
如果使用链式 str.replace() 方法进行字符置换,必须且只能把 & 放在最第一步执行。如果颠倒顺序,先将 < 替换成了 <,随后再去全局替换 &,那么刚刚生成的 < 中的 & 就会被再次替换成 &,导致最终输出为 &lt;。这种现象被称为“二次转义(Double Escaping)”,会导致页面不仅没有正确渲染,反而直接向用户显示丑陋的源代码实体字符。
三、在 JS 中转义与存储 HTML 的四大实用实现方案
根据项目运行环境(浏览器端、Node.js 运行时或同构 SSR)以及代码复杂度,有四种成熟且经过生产验证的转义实现方式。
方案 1:基于正则与字典映射的高效轻量转义函数
这是最经典、执行速度最快且无外部依赖的通用做法。通过一个匹配 5 个敏感字符的正则表达式,结合映射对象,在单次扫描中完成置换。这种方法从原理上彻底规避了顺序替换可能引发的二次转义问题。
/**
* 通用 HTML 字符实体安全转义函数
* 适用于浏览器环境及 Node.js / SSR 运行时
*/
const HTML_ESCAPE_MAP = {
'&': '&',
'<': '<',
'>': '>',
'"': '"',
"'": '''
};
function escapeHtml(str) {
if (typeof str !== 'string') {
return String(str ?? '');
}
return str.replace(/[&<>"']/g, (match) => HTML_ESCAPE_MAP[match]);
}
// 使用示例
const rawInput = '<script>alert("xss & hack")</script>';
const safeHtml = `<div class="content">${escapeHtml(rawInput)}</div>`;
// 输出:<div class="content"><script>alert("xss & hack")</script></div>
方案 2:利用 ES6 标签模板字符串(Tagged Template Literals)
在手动拼接大量 HTML 片段时,逐个调用 escapeHtml() 既繁琐又极易遗漏。利用 ES6 标签模板功能,可以编写一个 html 标签函数,自动对所有 ${...} 插值变量进行转义,而模板中的固定 HTML 结构保持不变。
/**
 * 标签模板自动转义函数
 */
function html(strings, ...values) {
  return strings.reduce((result, str, i) => {
    const value = values[i - 1];
    // 对动态插值变量执行实体转义
    const escapedValue = escapeHtml(value);
    return result + escapedValue + str;
  });
}

// 使用示例:固定结构标签保留,动态输入自动过滤
const username = 'Alice <script>';
const bio = 'Coder & "Designer"';

const card = html`
  <section class="user-card">
    <h3>${username}</h3>
    <p>${bio}</p>
  </section>
`;
方案 3:浏览器端 DOM 容器代理转义(离线元素法)
在纯浏览器宿主环境下,若不想手写替换规则,可以借助浏览器的内置机制:将文本赋值给离线 DOM 元素的 textContent 属性,浏览器会自动在内部将其转义为合法的文本节点,再通过读取 innerHTML 即可拿到已完成实体转义的字符串。
/**
* 利用浏览器原生 DOM 特性进行实体转义
* 注意:仅可在具备 window / document 的浏览器环境下调用
*/
function escapeHtmlByDom(text) {
const div = document.createElement('div');
div.textContent = text;
return div.innerHTML;
}
// 验证执行
const inputStr = '<a href="test">Tom & Jerry</a>';
console.log(escapeHtmlByDom(inputStr));
// 输出:<a href="test">Tom & Jerry</a>
该方案的优势在于完全依仗浏览器底层标准实现,转义准确率极高;不足之处是依赖 DOM 环境,无法在 Node.js 服务端运行,且高频大量调用时存在微小的 DOM 节点创建开销。
方案 4:服务端向页面注入内联 JS 变量时的防御转义
在现代同构应用或服务端直出页面中,常常需要把包含 HTML 数据的后端对象序列化后注入到前端页面的 <script> 标签内,例如 window.__INITIAL_DATA__ = ...。此时最危险的字符并非双引号,而是 </script> 序列。
因为 HTML 解析器遇到 </script> 字符串时,无论它是否包裹在 JavaScript 的字符串字面量中,都会立即判定当前的 <script> 标签结束,导致后续代码溢出到外部 HTML 中执行。针对这种场景,不能使用常规的 HTML 字符实体(因为 JS 引擎无法把 " 解析为有效 JSON),而必须采用 Unicode 字符转义:
// 服务端(Node.js)安全序列化注入数据
function safeSerializeForInlineScript(data) {
  return JSON.stringify(data)
    .replace(/</g, '\u003c')
    .replace(/>/g, '\u003e')
    .replace(/&/g, '\u0026')
    .replace(/
/g, '\u2028') // 防止行分隔符导致旧语法解析崩溃
    .replace(/
/g, '\u2029');
}

// 即使数据中包含恶意闭合标签 "</script><script>evil()</script>"
// 也会被编码为 "...",HTML 解析器无法探测到闭合标签,
// 而 JS 引擎在解析 JSON/变量时又能无损还原本意。
四、三大渲染上下文转义矩阵与常见陷阱
字符转义必须依据具体的渲染上下文决定。脱离具体位置的盲目转义,往往会导致功能异常或留下防御漏洞。
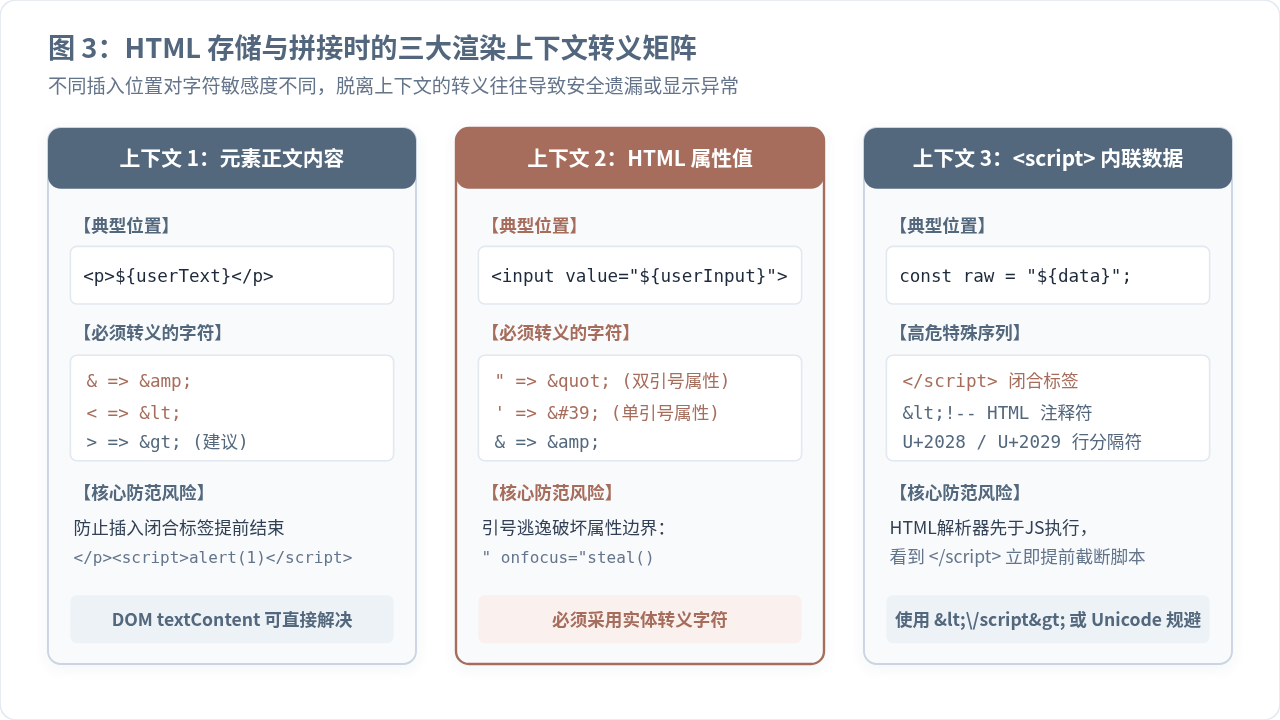
1. 普通标签内容上下文(Element Content):例如 <p>${text}</p>。此时核心敏感字符为 < 和 &。只要确保这两个字符被转义为 < 和 &,文本就无法跳出成为新的 HTML 节点。在原生开发中,如果整个节点全部为文本,强烈推荐直接使用 element.textContent = text 赋值,从根源上免去手动字符串拼接。
2. 属性值上下文(Attribute Values):例如 <input name="desc" value="${val}">。当属性值由双引号包裹时,输入中的 " 是最高危字符,如果不做实体转义,攻击者只需输入 " onfocus="alert(1) 即可轻松逃逸出属性范围;如果属性值由单引号包裹,则 ' 是最高危字符。因此,在属性上下文中,属性包裹引号与内部转义必须严格协同,始终建议对双引号和单引号都进行完整转义。
3. 警惕双重反斜杠与转义遗漏:在 JavaScript 代码编写中,如果在字符串字面量里书写正则或直接构建字符串,例如 let str = "\"";,每个 \ 在引擎求值后都会降级为一个普通反斜杠。在编写多重嵌套模板(例如在字符串内生成包含另一段 JS 的 HTML)时,需要逐层推演反斜杠的消费次数,必要时使用 String.raw 保持原始字符形态。
五、技术选型决策与落地规范
面对不同的业务开发环境,如何选择最高效、最不易出错的技术路线?可以参考以下决策路径:
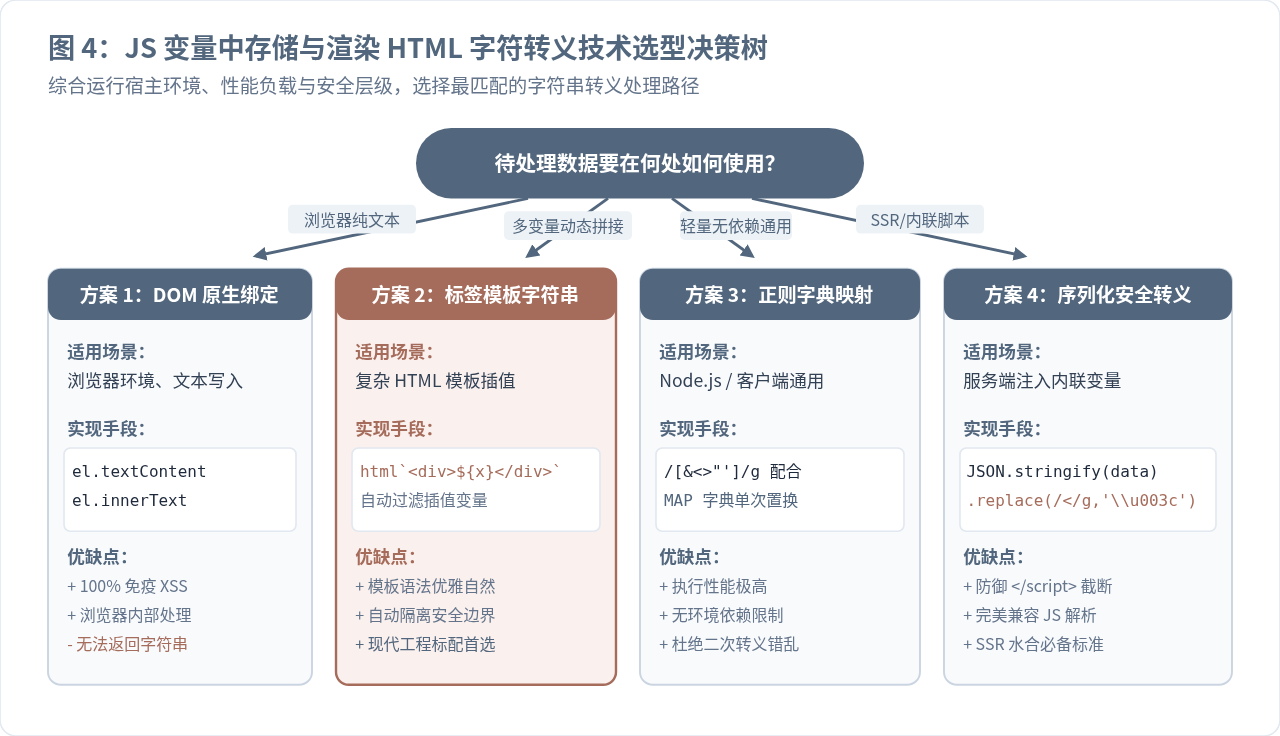
- 优先采用数据绑定而非字符串拼接:在前端交互中,修改纯文本优先使用
textContent或innerText;修改属性使用setAttribute(),浏览器底层会自动完成安全过滤。 - 必须拼接 HTML 时使用标签模板:在现代前端项目中,通过封装好的
html`...`标签函数进行多变量模板插值,杜绝手动拼接时的人工疏漏。 - 跨端与通用库统一采用正则映射:在 Node.js 中间件、离线渲染或无依赖工具类中,使用预编译正则加字典映射模式,兼具毫秒级高性能与高可靠性。
- 服务端内联输出务必使用 Unicode 编码:禁止直接使用未过滤的
JSON.stringify输出到内联<script>中,必须替换<为<以切断脚本截断隐患。
配置 Matter.js 睡眠机制以优化静止物体性能
2026-11-05 15:43:12
JavaScript console.log高级用法:用table、group和time优化调试输出
2026-11-05 08:04:56
JS怎么安全转换带千分位或货币符号的字符串为数字
2026-11-04 11:54:14
推荐几款稳定的在线JS反混淆工具,支持Obfuscator.io解密
2026-11-04 08:16:21
JS加密密钥硬编码在代码中有什么风险
2026-11-03 23:04:42