不同语言间JS与Java/Python加密结果不一致怎么办
深入解析JavaScript与Java、Python跨语言加密结果不一致的根本原因,提供涵盖字符编码、工作模式、填充方式、密钥派生及输出格式的排查步骤与完整对齐代码示例。
一、四步排查法:快速定位不一致节点
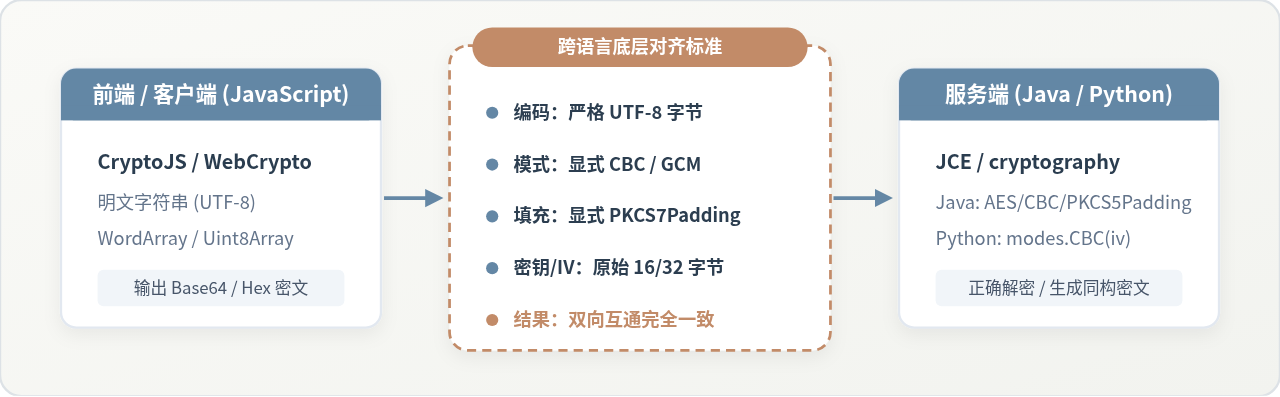
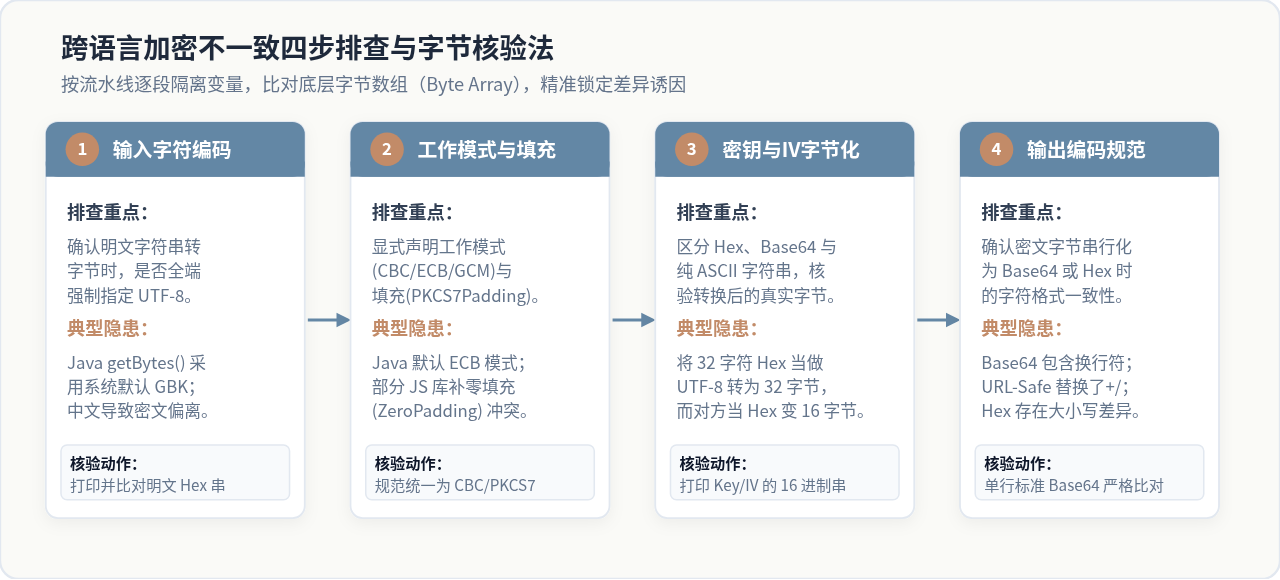
排查跨语言加密问题切忌盲目更换加解密库。最稳妥、高效的定位策略是将加解密流程拆分为四个检验关卡,逐级比对各语言底层的真实字节流:
- 步骤一:核验明文输入字节(统一字符编码)。无论是使用 CryptoJS、Node.js crypto、Java 的
getBytes()还是 Python 的encode(),首先核对明文字符串转成字节后的十六进制表示(Hex)。尤其当明文包含中文或特殊字符时,若字节数组不同,说明字符编码未统一为 UTF-8。 - 步骤二:显式声明工作模式与填充方式。严禁依赖语言运行时的默认值。必须在代码中明确写出算法、模式和填充(例如
AES/CBC/PKCS7Padding)。如果 Java 代码中只写Cipher.getInstance("AES"),Java 运行时会默认启用 ECB 模式与 PKCS5Padding,而前端很多库默认使用 CBC 模式,导致密文机制直接脱轨。 - 步骤三:核对密钥与初始向量(IV)的原始字节。这是跨语言联调中最频繁踩坑的区域。必须明确协商:密钥字符串是 16 个 ASCII 字符,还是 32 个字符的十六进制字符串(Hex),亦或是 Base64 编码字符串?必须确保各端载入内存后的
byte[]/Uint8Array长度(如 AES-128 严格为 16 字节)和字节内容完全一致。 - 步骤四:标准化最终密文的输出编码。加解密核心算子输出的是二进制字节数组。将字节数组输出为文本时,必须统一采用标准无换行的 Base64 字符串或全小写的 Hex 字符串。避免因部分语言的 Base64 工具带自动回车换行或 URL-Safe 字符替换(如把
+换成-,把/换成_)造成格式解析失败。
二、四大核心差异成因深入解析
1. 字符编码隐患:系统默认编码的暗坑
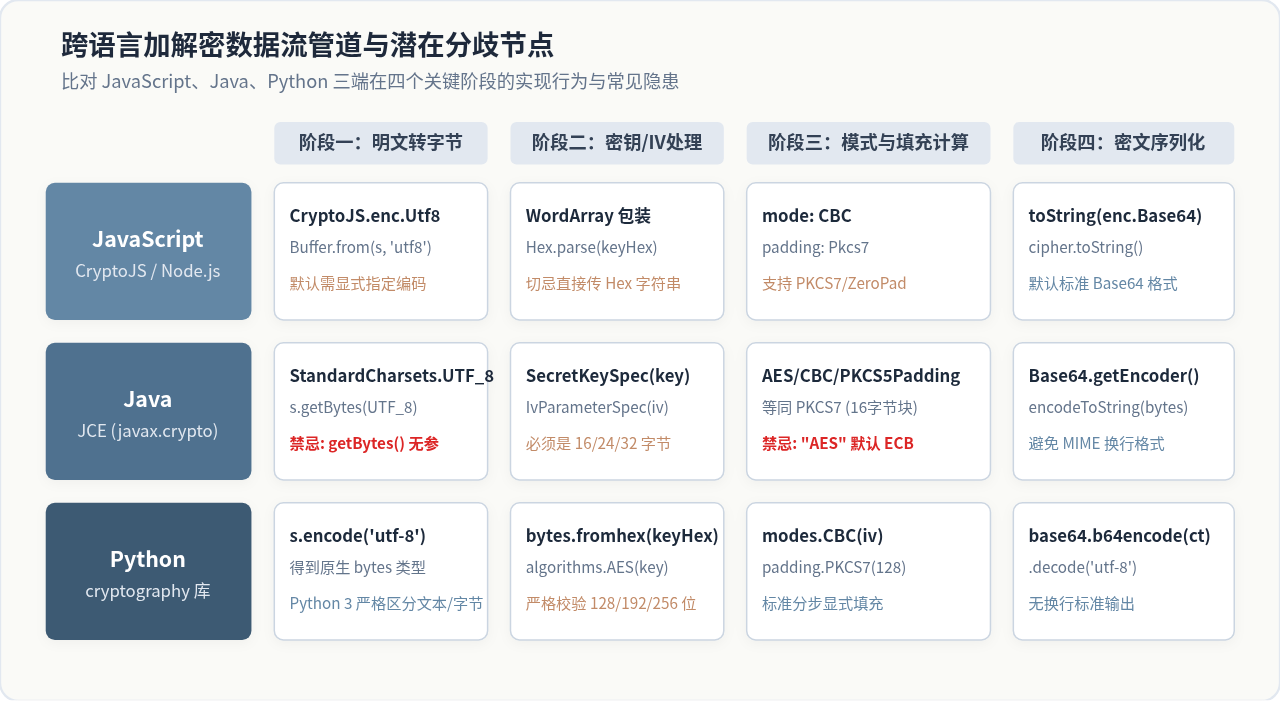
在 JavaScript 中,处理字符串时通常通过 CryptoJS.enc.Utf8.parse(text) 或 Node.js 的 Buffer.from(text, 'utf8') 完成。而在 Java 中,若调用 text.getBytes() 且未传入参数,JVM 将读取宿主操作系统的默认编码(在 Windows 下常常是 GBK,在 Linux 容器中可能是 UTF-8)。对于英文字符,ASCII 与 UTF-8、GBK 编码完全兼容,因此纯英文测试往往能通过;一旦测试包含中文字符,GBK 编码下一个汉字占 2 字节,而 UTF-8 编码下占 3 字节,输入加密引擎的字节数组从源头上就彻底不同,最终密文自然风马牛不相及。
getBytes(),必须显式传递 text.getBytes(StandardCharsets.UTF_8);Python 端必须明确使用 text.encode('utf-8')。
2. 填充与工作模式的语言级默认陷阱
AES 等分组对称密码以固定块大小(128 位,即 16 字节)进行运算。当数据长度不是 16 字节的倍数时,必须进行数据填充:
- PKCS#5 与 PKCS#7:在 16 字节块大小的 AES 算法中,PKCS#5 与 PKCS#7 的填充规则完全一致(缺 N 字节就补充 N 个值为 N 的字节)。Java JCE 标准规范中注册的名称为
PKCS5Padding,但在 AES 下它就是标准的 PKCS7 行为;而 JavaScript(CryptoJS)与 Python(cryptography)中通常显式命名为PKCS7。两者在数学和字节层面完全通用。 - ZeroPadding 的混淆:部分前端实现或早期的轻量级库为了简便,采用了在末尾补 0 的
ZeroPadding。若后端采用标准 PKCS5/PKCS7 进行解密,解密器会读取最后一个字节作为填充长度校验,发现末尾是0x00时就会直接抛出BadPaddingException: Given final block not properly padded。 - 工作模式不一致:ECB 模式不需要初始向量(IV),每个分组独立加密;CBC 模式需要一个 16 字节的 IV 进行链式异或。如果前端配了 IV 但后端隐式走了 ECB,或者前端未传 IV 默认使用全 0 向量,都会导致两端结果不合。
3. 密钥与 IV 的格式解析误区(字符串 vs 真实字节)
这是跨语言对接中最隐蔽的问题。假设两端约定的密钥是 32 位字符串 "0123456789abcdef0123456789abcdef":
- 如果这代表的是 32 个十六进制字符(Hex String),解码后对应的是 16 字节(128 位)的二进制数据。在 JS 中应当使用
CryptoJS.enc.Hex.parse(keyStr),Python 中使用bytes.fromhex(keyStr)。 - 如果某一端错误地将这 32 个字符直接当成普通的 UTF-8 字符串 调用
keyStr.getBytes("UTF-8"),则会生成 32 字节(256 位)的密钥,触发了 AES-256 算法。
两端各自运行正常且都不报错,但一端在执行 AES-128,另一端在执行 AES-256,密钥内容与算法位宽完全错位。因此,联调时务必打印两端实际使用的密钥与 IV 的十六进制表示,逐字节确认相同。
4. 密文输出与序列化格式差异
加密运算完成后,底层得到的是二进制密文(如 32 或 48 字节)。为了进行网络传输,必须进行文本编码:
- Base64 换行与截断:传统 Java 或 OpenSSL 工具在生成 Base64 时,默认每 76 个字符会插入换行符
- URL-Safe Base64 变体:部分框架会自动将 Base64 中的
+替换为-,将/替换为_,甚至去掉末尾的补位符=。若接收方使用普通 Base64 解码器,会直接抛出非法字符异常。 - Hex 大小写与前缀:采用十六进制序列化时,不同语言实现的十六进制字母大小写可能不同,或带
0x前缀。比对时应统一转小写再校验。
三、实战对齐:AES-128-CBC 跨语言标准示例
为了给读者提供一个可以直接运行、完全互通的基准参照,下面给出在 JavaScript、Java 与 Python 三种语言下,使用相同测试向量实现 AES-128-CBC / PKCS7Padding 的完整工程代码。
统一测试向量约定
- 测试明文:
Hello, Antigravity 跨语言加密! - 密钥(16 字节 UTF-8):
1234567890123456 - 初始向量 IV(16 字节 UTF-8):
abcdef0123456789 - 算法模式与填充:
AES-128-CBC,PKCS7Padding - 预期输出标准单行 Base64 密文:
EFTSBk4RCBBmo6/CF7qp2iY39X+PmdEvBLF3tFplnQKUNRCQKF5yxDuKrCQcFT7Z
1. JavaScript 实现(Node.js 原生 crypto 与 CryptoJS)
// 方式 A:Node.js 原生 crypto 模块
const crypto = require('crypto');

const key = Buffer.from('1234567890123456', 'utf8'); // 16 字节密钥
const iv  = Buffer.from('abcdef0123456789', 'utf8'); // 16 字节 IV
const plaintext = 'Hello, Antigravity 跨语言加密!';

// 加密
const cipher = crypto.createCipheriv('aes-128-cbc', key, iv);
cipher.setAutoPadding(true); // 默认即为 PKCS7Padding
let encrypted = cipher.update(plaintext, 'utf8', 'base64');
encrypted += cipher.final('base64');
console.log('JS (Node.js) 密文:', encrypted);

// 解密验证
const decipher = crypto.createDecipheriv('aes-128-cbc', key, iv);
decipher.setAutoPadding(true);
let decrypted = decipher.update(encrypted, 'base64', 'utf8');
decrypted += decipher.final('utf8');
console.log('JS (Node.js) 解密:', decrypted);
// 方式 B:浏览器端常见 CryptoJS 库实现
// 依赖:crypto-js
const CryptoJS = require('crypto-js');
const key = CryptoJS.enc.Utf8.parse('1234567890123456');
const iv = CryptoJS.enc.Utf8.parse('abcdef0123456789');
const message = 'Hello, Antigravity 跨语言加密!';
// 加密
const encryptedObj = CryptoJS.AES.encrypt(message, key, {
iv: iv,
mode: CryptoJS.mode.CBC,
padding: CryptoJS.pad.Pkcs7
});
const ciphertextBase64 = encryptedObj.toString(); // 默认输出即为标准 Base64
console.log('JS (CryptoJS) 密文:', ciphertextBase64);
// 解密验证
const decryptedBytes = CryptoJS.AES.decrypt(ciphertextBase64, key, {
iv: iv,
mode: CryptoJS.mode.CBC,
padding: CryptoJS.pad.Pkcs7
});
const decryptedText = decryptedBytes.toString(CryptoJS.enc.Utf8);
console.log('JS (CryptoJS) 解密:', decryptedText);2. Java 实现(标准 JCE:javax.crypto)
import javax.crypto.Cipher;
import javax.crypto.spec.IvParameterSpec;
import javax.crypto.spec.SecretKeySpec;
import java.nio.charset.StandardCharsets;
import java.util.Base64;

public class AesCrossLanguage {
    private static final String ALGORITHM = "AES/CBC/PKCS5Padding"; // 在 AES 下等同于 PKCS7
    private static final byte[] KEY_BYTES = "1234567890123456".getBytes(StandardCharsets.UTF_8);
    private static final byte[] IV_BYTES  = "abcdef0123456789".getBytes(StandardCharsets.UTF_8);

    public static String encrypt(String plaintext) throws Exception {
        Cipher cipher = Cipher.getInstance(ALGORITHM);
        SecretKeySpec keySpec = new SecretKeySpec(KEY_BYTES, "AES");
        IvParameterSpec ivSpec = new IvParameterSpec(IV_BYTES);

        cipher.init(Cipher.ENCRYPT_MODE, keySpec, ivSpec);
        byte[] encryptedBytes = cipher.doFinal(plaintext.getBytes(StandardCharsets.UTF_8));

        // 使用标准无换行 Base64 编码
        return Base64.getEncoder().encodeToString(encryptedBytes);
    }

    public static String decrypt(String ciphertextBase64) throws Exception {
        Cipher cipher = Cipher.getInstance(ALGORITHM);
        SecretKeySpec keySpec = new SecretKeySpec(KEY_BYTES, "AES");
        IvParameterSpec ivSpec = new IvParameterSpec(IV_BYTES);

        cipher.init(Cipher.DECRYPT_MODE, keySpec, ivSpec);
        byte[] decodedBytes = Base64.getDecoder().decode(ciphertextBase64);
        byte[] decryptedBytes = cipher.doFinal(decodedBytes);

        return new String(decryptedBytes, StandardCharsets.UTF_8);
    }

    public static void main(String[] args) throws Exception {
        String text = "Hello, Antigravity 跨语言加密!";
        String ciphertext = encrypt(text);
        System.out.println("Java 密文: " + ciphertext);
        System.out.println("Java 解密: " + decrypt(ciphertext));
    }
}
3. Python 实现(官方推荐 cryptography 库)
import base64
from cryptography.hazmat.primitives.ciphers import Cipher, algorithms, modes
from cryptography.hazmat.primitives import padding

KEY_BYTES = b"1234567890123456"
IV_BYTES  = b"abcdef0123456789"

def aes_encrypt(plaintext: str) -> str:
    # 1. 显式转 UTF-8 字节
    data = plaintext.encode('utf-8')

    # 2. 显式执行 PKCS7 填充 (128位块大小)
    padder = padding.PKCS7(128).padder()
    padded_data = padder.update(data) + padder.finalize()

    # 3. 执行 AES-128-CBC 加密
    cipher = Cipher(algorithms.AES(KEY_BYTES), modes.CBC(IV_BYTES))
    encryptor = cipher.encryptor()
    ciphertext = encryptor.update(padded_data) + encryptor.finalize()

    # 4. 输出标准 Base64 字符串
    return base64.b64encode(ciphertext).decode('utf-8')

def aes_decrypt(ciphertext_b64: str) -> str:
    ciphertext = base64.b64decode(ciphertext_b64)
    cipher = Cipher(algorithms.AES(KEY_BYTES), modes.CBC(IV_BYTES))
    decryptor = cipher.decryptor()
    padded_data = decryptor.update(ciphertext) + decryptor.finalize()

    # 去除 PKCS7 填充
    unpadder = padding.PKCS7(128).unpadder()
    data = unpadder.update(padded_data) + unpadder.finalize()
    return data.decode('utf-8')

if __name__ == "__main__":
    text = "Hello, Antigravity 跨语言加密!"
    encrypted = aes_encrypt(text)
    print("Python 密文:", encrypted)
    print("Python 解密:", aes_decrypt(encrypted))
运行结果核验
上述三个程序在各自语言环境下独立运行,对于同一输入明文,生成的标准 Base64 密文均为:
EFTSBk4RCBBmo6/CF7qp2iY39X+PmdEvBLF3tFplnQKUNRCQKF5yxDuKrCQcFT7Z并且在任一语言中生成的该密文字符串,均可直接复制到另外两种语言的解密函数中成功还原明文。这证明只要关键参数完全对齐,不同语言间的加密逻辑是 100% 互通的。
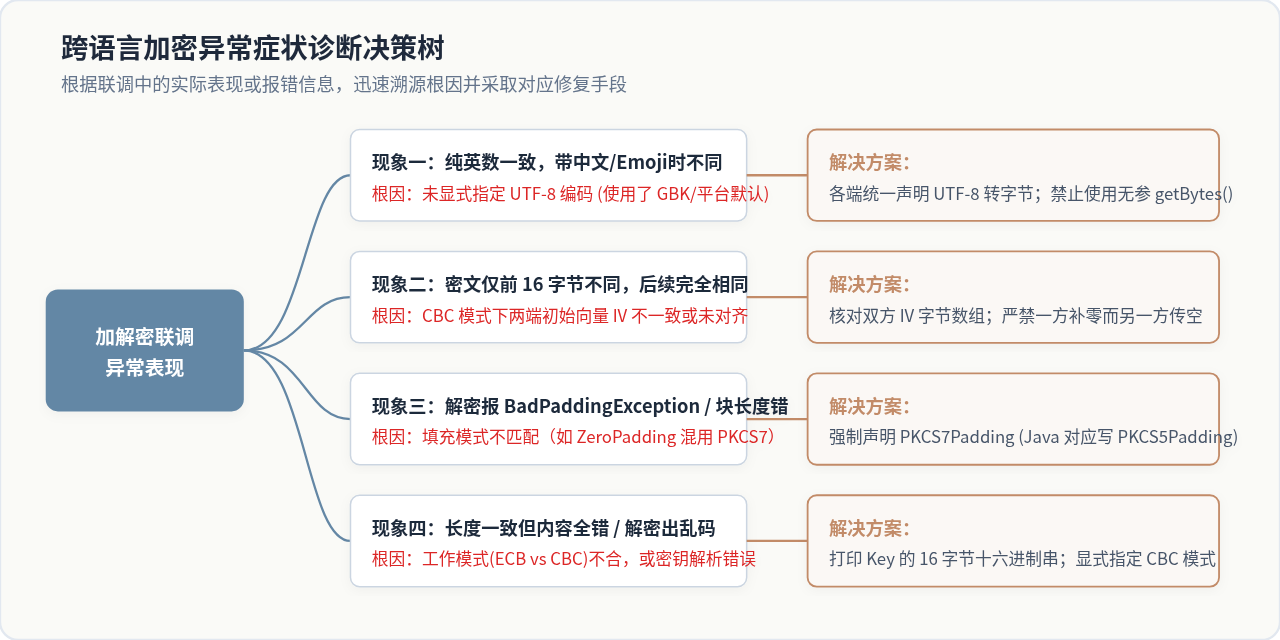
四、常见故障现象排查决策
在日常跨语言联调中,如果已经遇到错误,可通过以下特征进行定向排除:
| 联调具体表现 / 报错信息 | 核心根因分析 | 具体纠正动作 |
|---|---|---|
| 英文测试一致,含汉字或 Emoji 时密文不同 | 输入明文转换为字节时使用了平台默认编码(如 Windows 下 JVM 使用 GBK),导致非 ASCII 字符的字节序分歧。 | 所有语言代码中强制指定 UTF-8 字符集,杜绝无参 getBytes()。 |
| 密文前 16 字节不同,后续内容完全一致 | 在 CBC 模式下,第一块密文直接与 IV 进行异或,后续块依赖前一块密文。若仅首块不同,说明两端 IV 不一致。 | 检查 IV 是否一端写死而另一端为空/补零,两端统一显式传入相同的 16 字节 IV。 |
解密抛出 BadPaddingException: Given final block not properly padded |
1. 填充算法未统一(一端用 ZeroPadding,另一端用 PKCS7); 2. 密钥错误导致解密出的明文末尾呈现伪随机字节。 |
1. 确认两端均声明 PKCS7Padding(Java 填 PKCS5Padding); 2. 打印密钥字节核验是否一致。 |
| 密文长度相等但内容完全不同,解密全部乱码 | 1. 一端误用了 ECB 模式而另一端用了 CBC 模式; 2. 密钥格式解析错误(将 Hex 字符串误当成普通字符串直接编码)。 |
1. 显式声明 AES/CBC/PKCS7Padding;2. 打印两端加载进内存的密钥十六进制串,确保逐字节相同。 |
解密报错 Illegal base64 character 或末尾截断 |
密文传输过程中混入了换行符(
),或一方启用了 URL-Safe Base64(将 + 变 -,/ 变 _)。 |
标准化使用单行 RFC 4648 标准 Base64;解密前统一做 replace("
", "").replace("
", "") 过滤。 |
五、跨语言加密工程规范与长效防护
为了避免团队在跨端联调中反复排查类似问题,建议在项目初期制定《跨语言加解密协议字典》,并建立常态化的验证闭环:
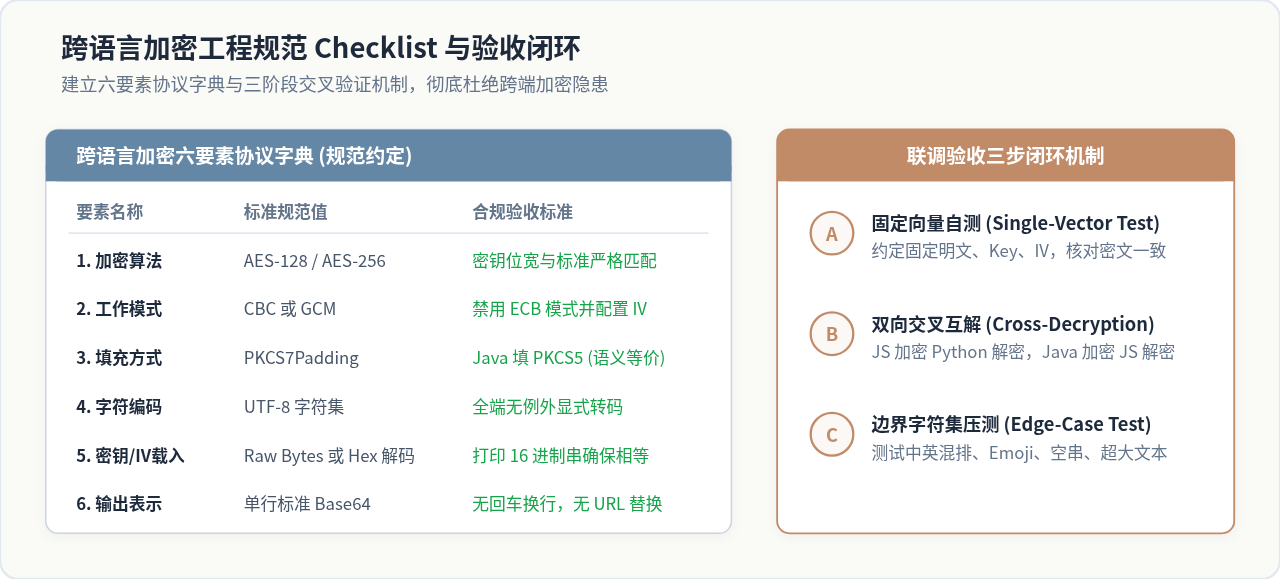
- 协议文档明确六要素:接口契约中不可仅写“AES加密”,必须明确约定:算法名称(AES-128 / AES-256)、工作模式(CBC)、填充方案(PKCS7)、明文字符集(UTF-8)、密钥与IV编码形式(Hex 还是 Base64 还是 Raw ASCII)、密文序列化格式(单行标准 Base64)。
- 提供官方固定测试向量:在对接文档中直接附带一组固定的明文、密钥、IV 及对应的标准密文。开发人员在写完本端代码后,优先跑通该测试向量,确认本端与标准一致后,再进行跨端双向联调。
- 编写跨语言 CI 自动化测试:在持续集成流程中,使用脚本模拟前端加密并在后端服务中解密,覆盖纯英数、多语言字符、超长文本及边界空串,确保依赖库升级后依然保持二进制层面的兼容性。
为什么叫JavaScript:语言命名由来及与Java的历史渊源
2026-11-05 11:37:48
JS获取当前时间年月日时分秒并格式化为YYYY-MM-DD HH:mm:ss
2026-11-04 21:25:21
Mock.js 拦截 Axios 和 Fetch 请求的原理与配置方法
2026-11-04 08:13:59
JS怎么获取当前日期并格式化为YYYY-MM-DD
2026-11-03 18:47:03
怎么用JS在网页上实时动态显示当前时间
2026-11-03 17:20:33