

JS相对路径转绝对URL的三种可靠方法
深入讲解在JavaScript中将相对路径可靠转换为绝对URL的三种方法:原生URL构造函数、DOM元素属性反射机制以及服务端与无DOM环境解析,包含具体代码、解析原理与避坑指南。
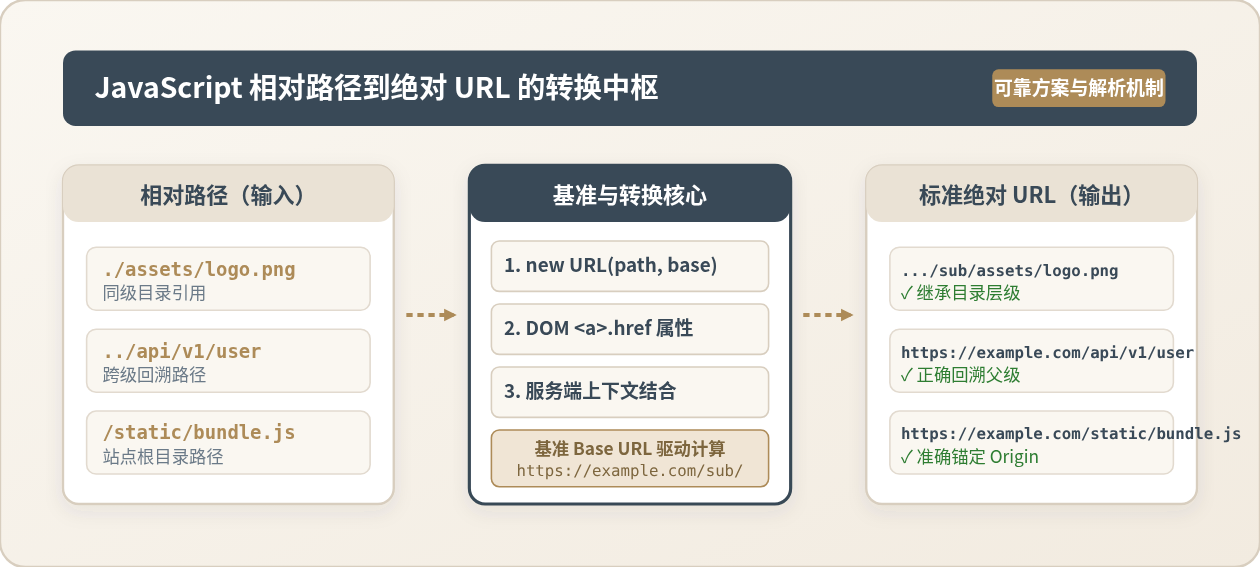
在 JavaScript 开发中,将相对路径转换为规范的绝对 URL 是网络请求重定向、资源预加载、图片懒加载以及服务端渲染(SSR)中的高频基础操作。实现这一转换的核心逻辑是在确定的基准路径(Base URL)约束下,按照 RFC 3986 规范对路径节点进行合并与层级推导。目前生产环境中最可靠的三种解决方案分别是:跨端通用的原生 URL 构造函数、利用浏览器 DOM 元素特性的属性反射机制,以及服务端与无 DOM 环境下的基准拼装解析。本文将分别介绍这三种方法的实现步骤、运行机制、代码示例以及技术选型边界。
一、相对路径与基准 URL 的解析工作机制
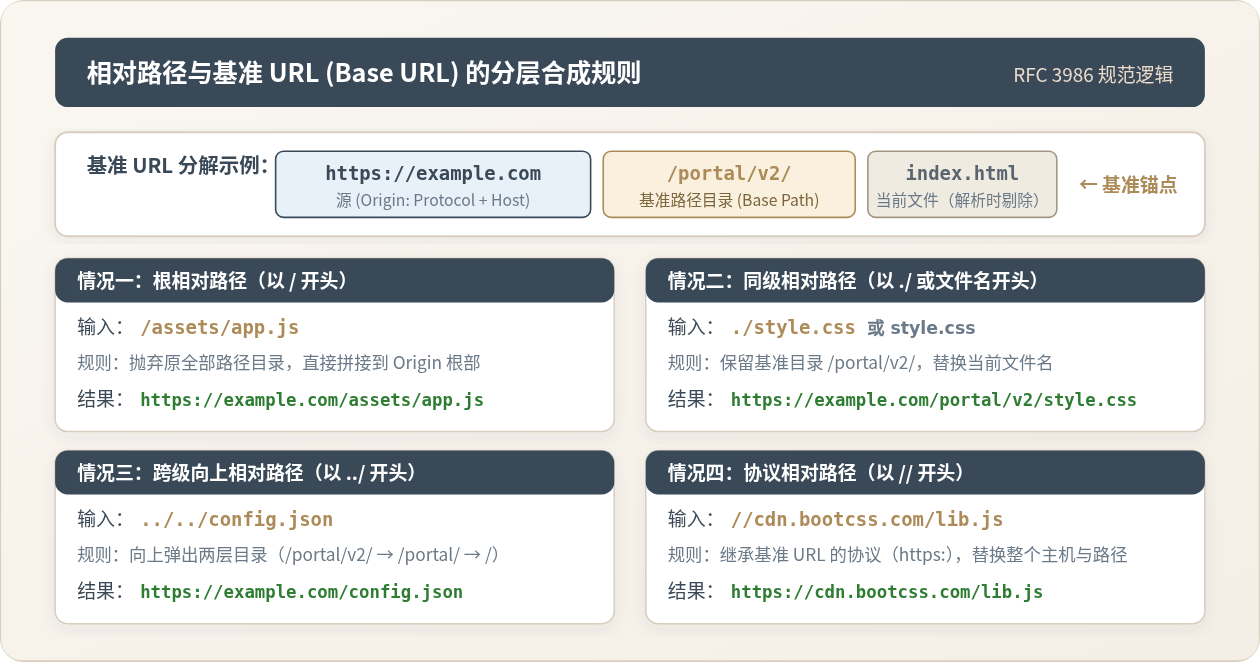
为了让转换逻辑保持可预测,必须先厘清基准 URL(Base URL)与相对路径结合时的计算规则。一个合法的绝对基准由协议(Protocol)、主机名(Host)、端口(Port)以及路径目录(Pathname)构成。当传入不同的相对路径时,解析引擎会依据起始符号执行不同的合并策略:
- 以斜杠
/开头的根相对路径:直接清空基准 URL 中的所有原有目录,将新路径挂载到基准 URL 的 Origin 根节点下。 - 以
./或普通文件名开头的同级路径:保留基准 URL 的目录路径,仅替换最后一个文件名,若基准最后以斜杠结尾则直接追加到该目录下。 - 以
../开头的父级回溯路径:按照../出现的次数,从基准目录自右向左依次剥离对应的父级目录,再将剩余路径拼接。 - 以
//开头的协议相对路径:完整继承基准 URL 的当前协议(如https:),但替换后续的主机名与全部路径。
二、方法一:原生 URL 构造函数解析法(现代通用标准)
使用现代 JavaScript 运行时内置的 URL 全局构造函数是目前最推荐的标准方式。该方法在 ECMAScript 标准中确立,全面支持现代浏览器、Node.js(10.0+)、Deno 以及各类边缘计算 Worker 环境,完全不依赖 DOM 树。
1. 具体做法与代码示例
new URL(input, base) 构造函数接收两个参数:第一个参数为待解析的相对路径,第二个参数为绝对基准 URL。创建实例后,直接读取其 href 属性即可获得转换后的完整字符串:
// 定义基准 URL(通常为当前页面地址或 API 网关前缀)
const baseURL = 'https://example.com/portal/v2/index.html';

// 示例 1:解析同级资源
const url1 = new URL('./assets/style.css', baseURL).href;

// 示例 2:跨级回溯父级目录
const url2 = new URL('../../config/settings.json', baseURL).href;

// 示例 3:站点根目录资源
const url3 = new URL('/images/favicon.ico', baseURL).href;

console.log(url1);
console.log(url2);
console.log(url3);
url1 -> "https://example.com/portal/v2/assets/style.css"url2 -> "https://example.com/config/settings.json"url3 -> "https://example.com/images/favicon.ico"
2. 关键注意事项与异常防御
如果第二个参数 base 缺失或不是合法的绝对 URL,当第一个参数为相对路径时,构造函数会立即抛出 TypeError: Invalid URL。在实际业务封装中,建议通过 try...catch 块对异常进行兜底包装,避免因非法字符串导致应用崩溃:
function resolveToAbsolute(relativePath, base = typeof window !== 'undefined' ? window.location.href : '') {
  if (!relativePath || typeof relativePath !== 'string') {
    return '';
  }
  try {
    return new URL(relativePath.trim(), base).href;
  } catch (err) {
    console.warn('URL 解析失败:', err.message);
    return '';
  }
}
三、方法二:DOM 元素属性反射解析法(浏览器原生机制)
在浏览器环境中,所有包含超链接特性的 DOM 节点(如 HTMLAnchorElement 即 <a> 标签,或 <area> 标签)都会在设置属性时由浏览器渲染内核自动执行 URL 规范化运算。通过 JavaScript 动态创建节点并为 href 属性赋值,浏览器会自动结合文档的当前上下文将其转换为完整绝对路径。
1. 具体做法与代码示例
动态创建 <a> 节点无需将其插入到 DOM 树中即可完成解析计算。读取其 href 属性会返回由浏览器引擎解析好的绝对 URL:
function resolveByAnchor(relativePath) {
  if (typeof document === 'undefined') {
    throw new Error('当前运行环境不支持 DOM 对象,无法使用 Anchor 解析');
  }
  const a = document.createElement('a');
  a.href = relativePath;
  return a.href;
}

// 假设当前页面位于 https://example.com/products/view.html
const absResult = resolveByAnchor('../cart/checkout');
console.log(absResult);
absResult -> "https://example.com/cart/checkout"
2. 运行特性与性能优化
该方法的最大特点是能够无感响应 HTML 文档 <head> 中声明的 <base href="..."> 标签。如果页面指定了全局基准,<a> 标签会自动遵循该基准,而无需开发者手动读取并传参。在频繁执行解析的高频场景中,可以通过单例对象复用单个 <a> 元素,减少内存分配与垃圾回收压力:
// 单例复用模式
const sharedResolver = typeof document !== 'undefined' ? document.createElement('a') : null;

function resolveFast(relativePath) {
  if (!sharedResolver) return '';
  sharedResolver.href = relativePath;
  return sharedResolver.href;
}
四、方法三:服务端与无 DOM 环境下的基准拼装解析
在 Node.js 服务端、Next.js / Nuxt 同构服务端渲染(SSR)或无头数据爬虫中,既不存在全局 window.location,也无法访问浏览器 document 对象。此时相对路径转换必须结合服务端请求上下文(如 HTTP 请求头中的反向代理标头)以及环境配置来提取或推导基准。
1. 具体做法与代码示例
在服务端架构中,前端经过 Nginx 或 API 网关转发后,原始域名通常存放在 X-Forwarded-Host 与 X-Forwarded-Proto 标头中。服务端需要将请求头动态合成为绝对基准,再由 Node.js 内置的 URL 模块完成解析:
// Node.js / SSR 场景下的通用解析封装
function resolveServerPath(relativePath, reqContext) {
  let baseOrigin = '';

  if (typeof reqContext === 'string') {
    baseOrigin = reqContext;
  } else if (reqContext && reqContext.headers) {
    // 从代理转发头中提取实际协议与主机名
    const proto = reqContext.headers['x-forwarded-proto'] || 'http';
    const host = reqContext.headers['x-forwarded-host'] || reqContext.headers.host || 'localhost';
    baseOrigin = `${proto}://${host}`;
  } else {
    baseOrigin = process.env.APP_BASE_URL || 'http://127.0.0.1:3000';
  }

  try {
    // 确保基准末尾具有规范斜杠
    const normalizedBase = baseOrigin.endsWith('/') ? baseOrigin : baseOrigin + '/';
    return new URL(relativePath, normalizedBase).href;
  } catch (err) {
    console.error('服务端 URL 解析异常:', err.message);
    return relativePath;
  }
}
// 模拟 Express / Koa 请求上下文resolveServerPath("/api/v2/items", mockReq) -> "https://api.myapp.com/api/v2/items"
五、路径转换的操作实施与异常防御流程
在实际工程代码中,相对路径转换不仅仅是单行 API 的调用,更是涉及环境检测、输入清洗、引擎调度和异常捕获的完整逻辑闭环。以下步骤展示了生产级转换模块的标准防御式流程:
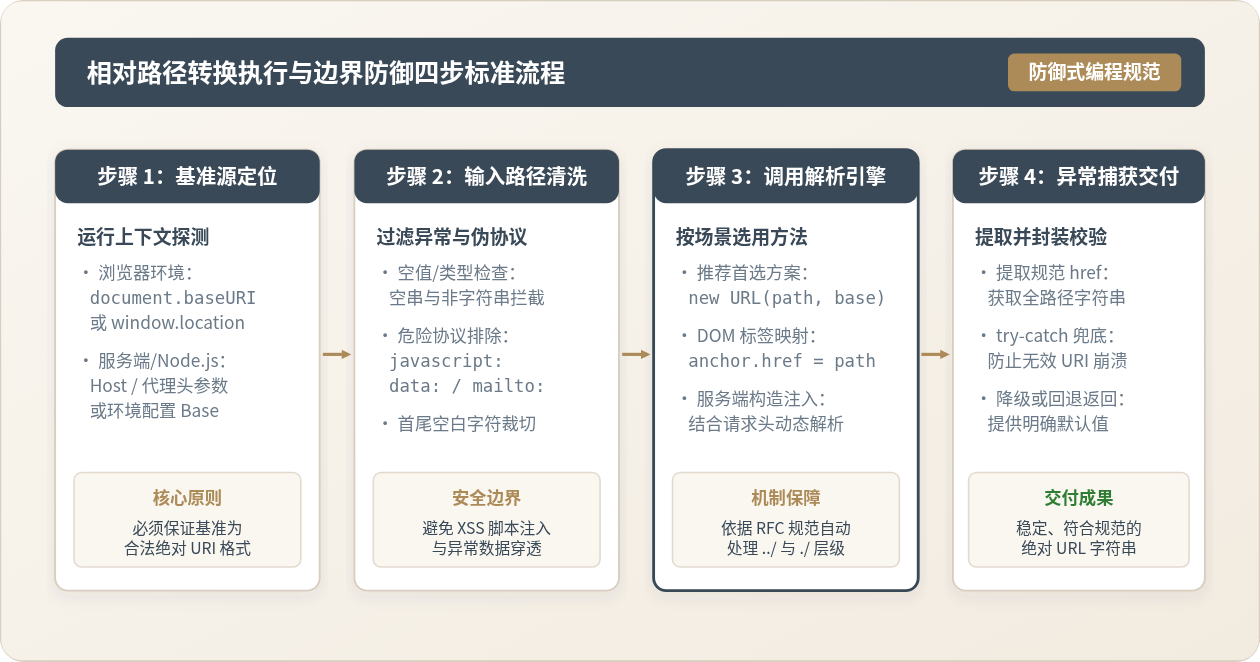
- 步骤一:基准源探测与规范化。检查当前运行时宿主环境,优先提取明确配置或请求上下文;如果处于浏览器环境且未传基准,则优先读取
document.baseURI(能够自动感知<base>标签),否则回退到window.location.href。 - 步骤二:输入路径清洗与过滤。去除路径首尾的空格与制表符,拦截空字符串。同时针对
javascript:、data:、mailto:等伪协议进行前置检查,避免潜在的安全注入。 - 步骤三:调用解析引擎。现代项目优先选用
new URL(path, base)执行运算;若需兼容无该 API 的遗留老旧浏览器内核且存在 DOM,则平滑降级至HTMLAnchorElement反射机制。 - 步骤四:异常捕获与格式标准化。将解析调用包裹在
try...catch中,处理因特殊非法字符或空主机名引发的TypeError,确保模块对外始终返回可预测的字符串格式或安全空值。
六、三种方法的选型对比与决策考量
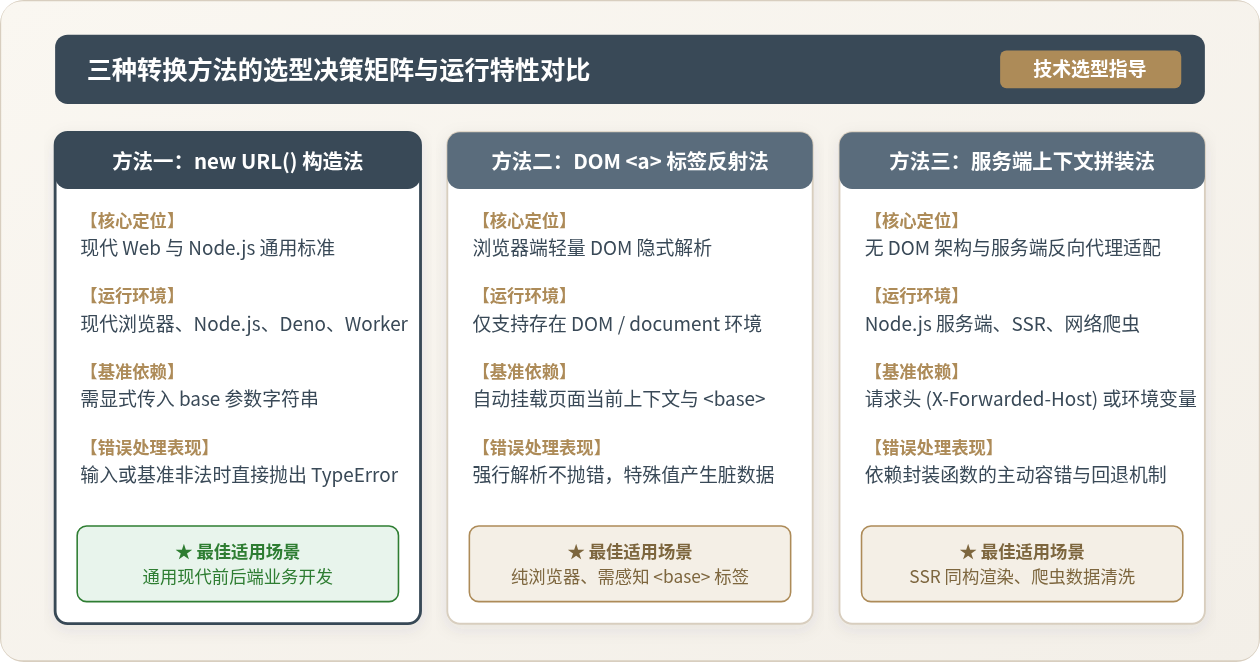
为了在不同架构与技术栈中作出合理的选择,下表对这三种可靠方法在支持环境、基准依赖、错误机制和应用场景上进行了系统对比:
| 对比维度 | 方法一:原生 new URL() | 方法二:DOM <a> 标签反射 | 方法三:服务端上下文拼装 |
|---|---|---|---|
| 支持环境 | 现代浏览器、Node.js、Worker | 仅浏览器环境(依赖 DOM) | Node.js、SSR 框架、服务端爬虫 |
| 基准来源 | 显式传参(字符串或 URL 实例) | 隐式继承当前页面与 <base> | 请求标头(Host/Proto)或环境变量 |
| 异常行为 | 格式不合法时抛出 TypeError | 静默失败,强行生成可能异常的属性 | 依赖业务封装函数的降级逻辑 |
| 性能开销 | 极低(纯原生 C++ 核心规范实现) | 低(需分配 DOM 节点,可单例复用) | 极低(标准 URL 对象复用) |
| 推荐场景 | 现代 Web 项目通用标准方案 | 页面含 <base> 标签的纯客户端项目 | Next.js/Nuxt SSR 服务端及爬虫接口 |
七、关键注意事项与避坑清单
在路径转换的实际编码过程中,有一些常见的隐蔽细节容易引发生产缺陷,需要格外留意:
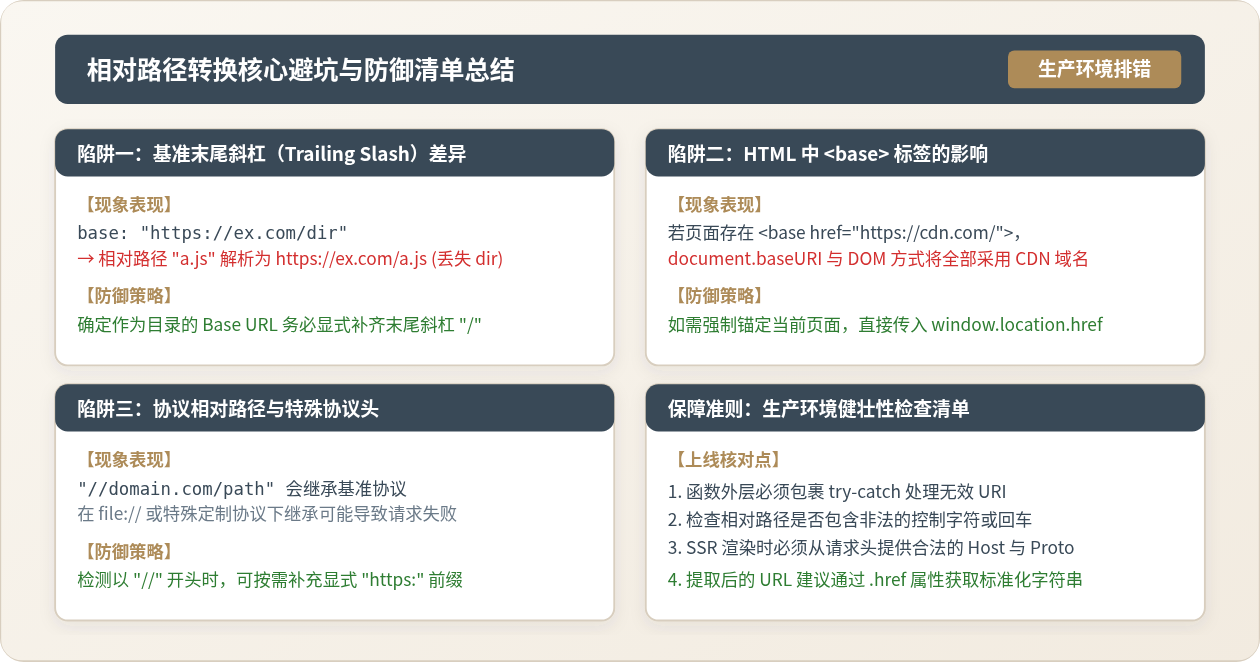
在 URL 解析规范中,https://example.com/app 中的 app 会被视为一个文件而不是目录。若在其后解析相对路径 page.html,结果会变成 https://example.com/page.html,导致 app 目录被覆盖丢失。如果 app 本身代表一个文件夹,基准必须写为 https://example.com/app/,解析结果才会正确保持为 https://example.com/app/page.html。
总结来说,对于绝大多数现代项目,使用原生 new URL(relativePath, base) 并辅以完善的 try...catch 校验是最清晰、严谨且跨端的首选方案;在依赖全局 <base> 标签的页面内,DOM 元素反射能省去手动同步基准的成本;而在 SSR 和后端数据清洗链路中,结合代理头的上下文拼装则是保证多租户与跨域名环境正确映射的基石。
Java和JavaScript的应用场景分工:后端企业级开发与Web前端交互
2026-11-05 15:57:34
除了浏览器和Node.js,还有哪些轻量级Js脚本运行工具?
2026-11-04 17:38:24
无需后端:用JavaScript实现简单网站的本地数据存储
2026-11-03 23:03:30
Node.js 下载慢或官网打不开怎么办
2026-11-03 18:19:37
JS解析大体积Excel文件内存溢出怎么办
2026-11-03 18:19:37







