

JavaScript递归基础:从阶乘到斐波那契数列的实现
深入浅出讲解JavaScript递归编程基础,剖析基线条件与调用栈执行过程,从单分支阶乘实现过渡到多分支斐波那契数列,并详解重叠子问题与记忆化优化。
递归本质上是函数直接或间接调用自身,将规模庞大的复杂问题逐层降解为结构相同的最小子问题。在 JavaScript 中,编写递归的核心并非复杂的数学技巧,而是确立“何时停下”与“如何向前推进”这两个确定性规则。本文从最经典的单分支阶乘运算切入,剖析执行上下文调用栈在内存中的压栈与回溯过程;随后延伸至双分支树形斐波那契数列,揭示重叠子问题带来的性能断崖,并提供记忆化剪枝与迭代转换的具体工程解法。

一、递归的核心机制:基线条件与递推关系
初学者在初次接触递归时,往往容易陷入“不断调用自身无从收尾”的思维死循环中。要准确掌握递归,首先需要将其拆解为两个不可或缺的核心支柱:基线条件(Base Case)与递归推进(Recursive Step)。
- 基线条件(终止阀门):函数中首先执行的条件分支。当传入的参数满足特定边界时,直接计算或返回已知常量,不再发起任何后续递归调用。没有基线条件,程序便无法自行终止。
- 递归推进(规模递减):将当前问题拆解为参数更小的一项或多项子调用。递推的核心法则在于:每一次递归调用的传参,都必须在逻辑上更贴近基线条件。
在底层机制上,JavaScript 引擎使用调用栈(Call Stack)来跟踪每个函数的执行上下文。当一个函数调用自身时,引擎会为该次调用分配一个新的栈帧(Stack Frame),压入调用栈顶部,保存当前的局部变量和执行指针;只有当深层子函数返回结果后,当前栈帧才会出栈并恢复执行。
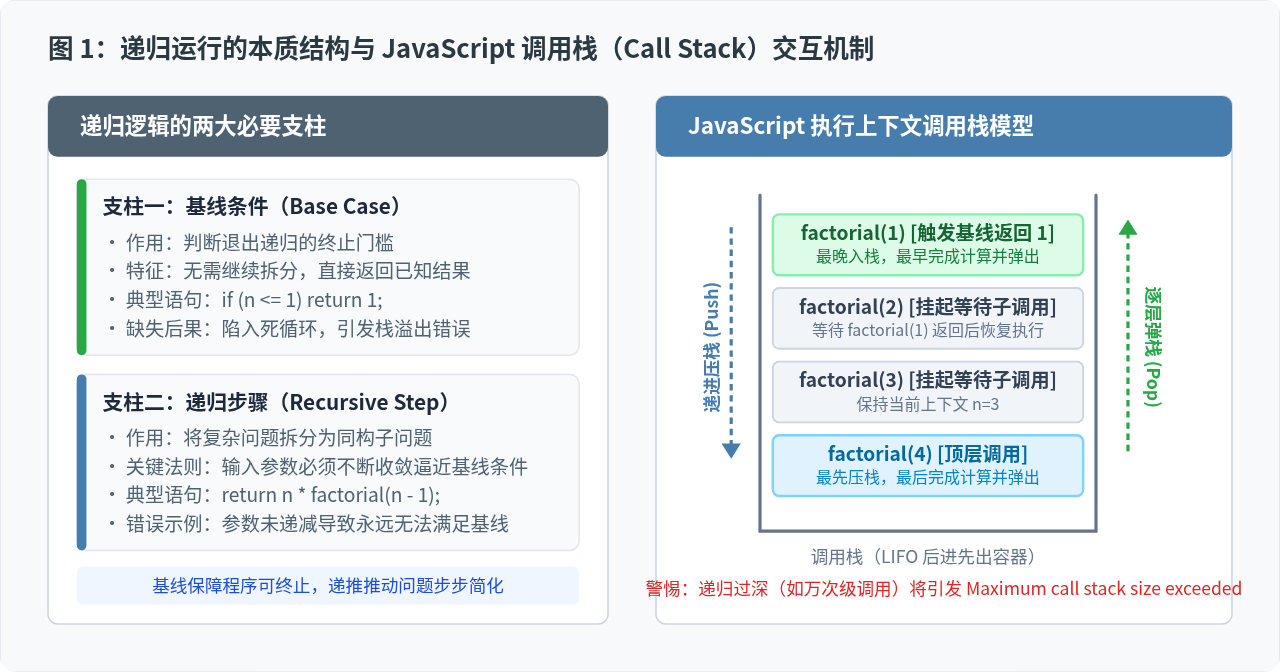
调用栈的存储空间是有限的。以 V8 引擎(Node.js 或 Chrome 环境)为例,默认调用栈深度大约在 10,000 次左右。如果递归条件设计失误导致参数发散,或者递归层数过深,引擎会立即抛出 RangeError: Maximum call stack size exceeded 并中断运行。
二、线性递归实践:阶乘函数的逐步实现与执行追踪
阶乘(Factorial,记作 n!)是理解单分支线性递归的绝佳案例。数学上,一个正整数 n 的阶乘被定义为所有小于等于 n 的正整数的乘积,即 n! = n × (n - 1) × ... × 1,且约定 0! = 1。
用递归思路拆解阶乘,可以得到极其纯粹的递推公式:
- 基线条件:当
n === 0或n === 1时,结果确定为1。 - 递归推进:当
n > 1时,factorial(n) = n × factorial(n - 1)。
1. 完整代码实现
/**
 * 计算非负整数 n 的阶乘
 * @param {number} n
 * @returns {number}
 */
function factorial(n) {
  // 参数前置防错校验
  if (!Number.isInteger(n) || n < 0) {
    throw new Error("输入参数必须为非负整数");
  }

  // 1. 基线条件 (Base Case)
  if (n === 0 || n === 1) {
    return 1;
  }

  // 2. 递归推进 (Recursive Step)
  return n * factorial(n - 1);
}

// 验证输出
console.log(factorial(4)); // 示例输出: 24
console.log(factorial(0)); // 示例输出: 1
2. 执行追踪:factorial(4) 的双阶段生命周期
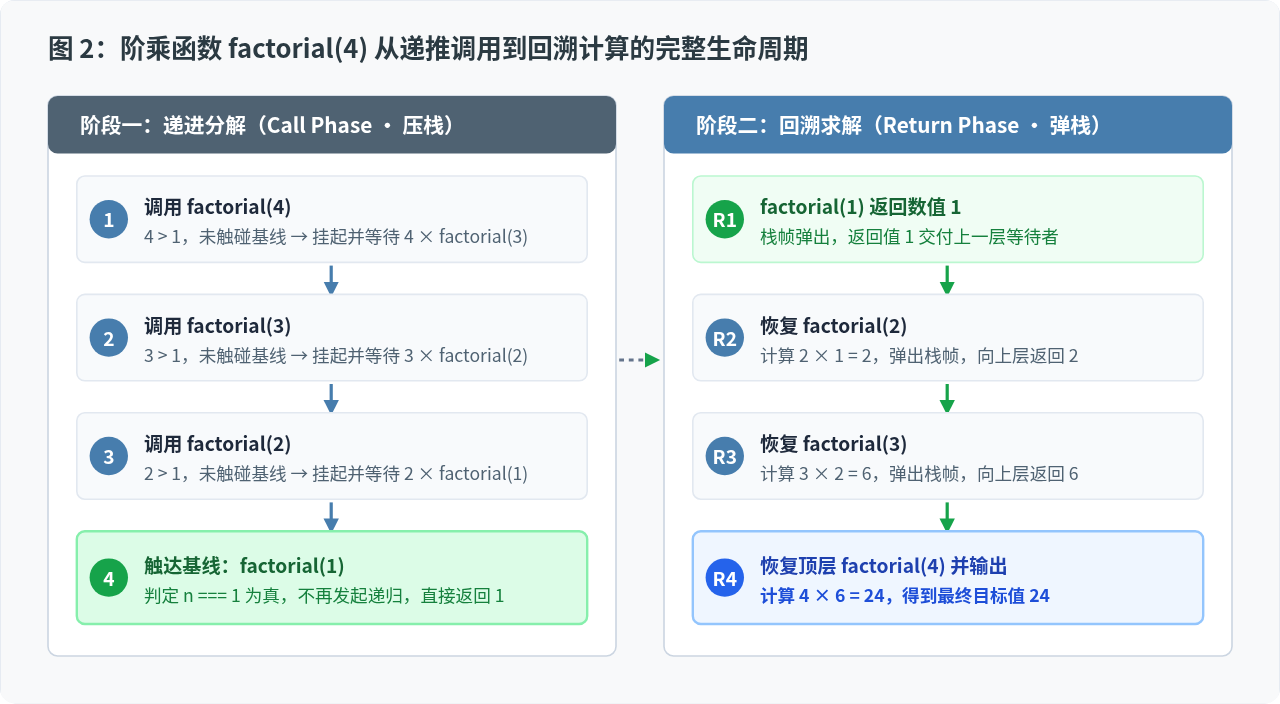
理解递归不能只看代码表面,必须观察函数在调用栈中的展开与收敛。以 factorial(4) 为例,其执行完整经历两个独立阶段:
-
递进展开阶段(压栈):
factorial(4)挂起等待4 × factorial(3);接着factorial(3)挂起等待3 × factorial(2);factorial(2)挂起等待2 × factorial(1)。此时栈深达到最大。 -
回溯归约阶段(弹栈计算):
factorial(1)触碰基线直接返回1;factorial(2)恢复计算2 × 1 = 2并弹出;factorial(3)恢复计算3 × 2 = 6并弹出;最后factorial(4)计算4 × 6 = 24完成并输出。
三、树形分支递归:斐波那契数列与指数级重叠子问题
阶乘是典型的“单线推进”,每一次函数执行只会触发一次内部递归。而当问题演进为“多路分支”时,递归的结构复杂度将发生质的改变。最典型的模型就是斐波那契数列(Fibonacci Sequence)。
斐波那契数列定义如下:
F(0) = 0,F(1) = 1(两个基线条件)F(n) = F(n - 1) + F(n - 2),其中n ≥ 2
1. 朴素递归实现
/**
 * 朴素递归实现斐波那契数列
 * @param {number} n
 * @returns {number}
 */
function fibonacci(n) {
  if (!Number.isInteger(n) || n < 0) {
    throw new Error("输入参数必须为非负整数");
  }

  // 基线条件
  if (n === 0) return 0;
  if (n === 1) return 1;

  // 双路分支递归
  return fibonacci(n - 1) + fibonacci(n - 2);
}

console.log(fibonacci(6)); // 示例输出: 8
2. 为什么朴素递归在规模增大时会卡死?
上述代码在逻辑上极其清晰,但在计算机运行时却隐藏着极具破坏性的性能陷阱。尝试在浏览器控制台中运行 fibonacci(45),页面通常会明显卡顿数秒甚至失去响应。
其症结在于:双路递归生成了一棵巨大的二叉调用树。在树的每一层,节点数量以指数级翻倍展开。更为致命的是,左右子树之间存在大量完全相同的重叠子问题(Overlapping Subproblems)。
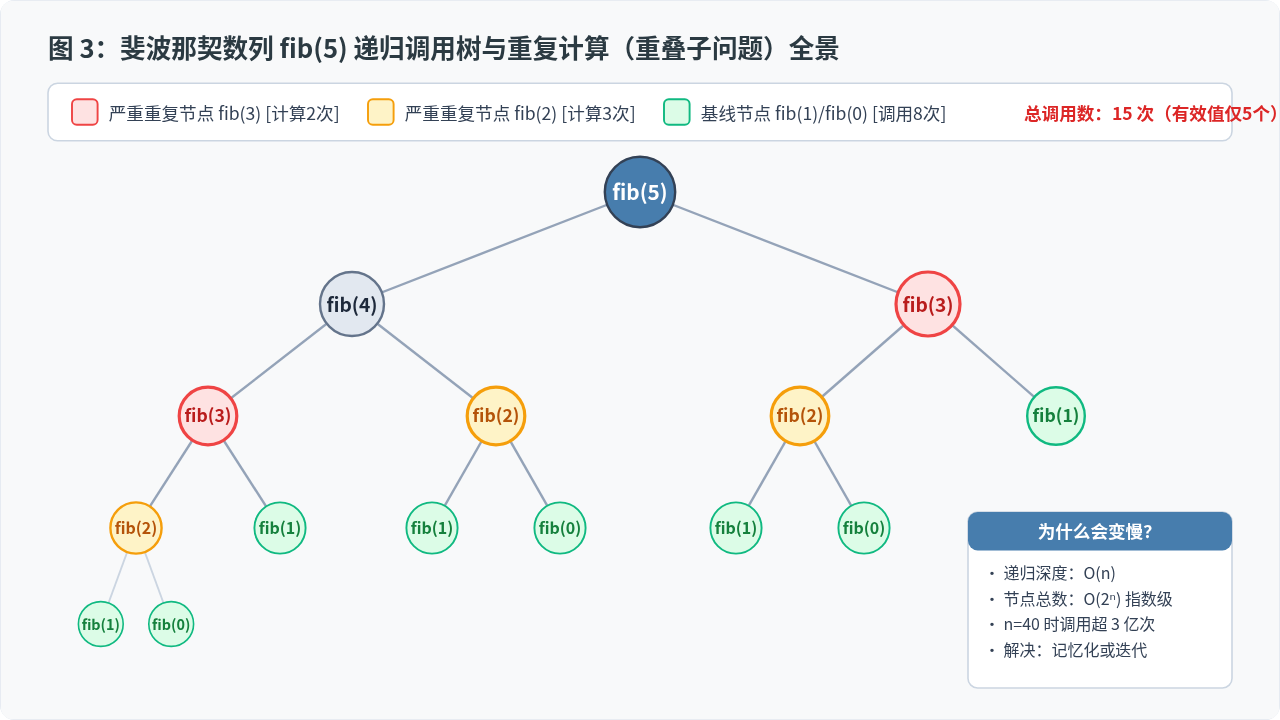
从图 3 可以清楚地看到,计算 fib(5) 时:
fib(3)被完全独立地计算了 2 次;fib(2)被计算了 3 次;- 基线节点
fib(1)和fib(0)被反复触发了 8 次。
随着 n 的增大,整个调用树的节点总数逼近 O(2ⁿ)。当 n = 40 时,函数调用次数已突破 3 亿次,且绝大部分计算都是在重复进行相同的运算。
四、突破性能瓶颈:记忆化剪枝与迭代状态转移
面对多分支递归带来的指数级算力浪费,常规的工程优化手段有两种:记忆化自顶向下剪枝和迭代自底向上推进。
方法一:记忆化递归(Memoization)
既然子问题会被频繁重复调用,最直接的方法就是引入缓存容器(例如对象或 Map)。当某个 fib(k) 首次被计算出来后,先将其缓存到容器中;下次再次需要该值时直接查表返回,不再向下分支。
/**
 * 记忆化递归斐波那契数列 (时间复杂度 O(n), 空间复杂度 O(n))
 * @param {number} n
 * @param {Record<number, number>} memo
 * @returns {number}
 */
function fibonacciMemo(n, memo = {}) {
  if (!Number.isInteger(n) || n < 0) {
    throw new Error("输入参数必须为非负整数");
  }

  // 基线条件
  if (n === 0) return 0;
  if (n === 1) return 1;

  // 优先查缓存,若已计算直接返回结果
  if (memo[n] !== undefined) {
    return memo[n];
  }

  // 未缓存时进行单次计算,并存入 memo
  memo[n] = fibonacciMemo(n - 1, memo) + fibonacciMemo(n - 2, memo);
  return memo[n];
}

console.log(fibonacciMemo(50)); // 示例输出: 12586269025 (瞬间完成)
方法二:迭代状态转移(自底向上消除递归)
记忆化虽然将时间复杂度从 O(2ⁿ) 缩减到 O(n),但仍然需要占用 O(n) 的调用栈深度与哈希表存储。实际上,计算 F(n) 时只需要前两个连续状态 F(n-1) 和 F(n-2),完全可以通过一个极简的 for 循环实现自底向上的迭代计算,将空间复杂度进一步降至 O(1)。
/**
 * 迭代法斐波那契数列 (时间复杂度 O(n), 空间复杂度 O(1))
 * @param {number} n
 * @returns {number}
 */
function fibonacciIterative(n) {
  if (!Number.isInteger(n) || n < 0) {
    throw new Error("输入参数必须为非负整数");
  }
  if (n === 0) return 0;
  if (n === 1) return 1;

  let prev = 0; // 代表 F(n-2)
  let curr = 1; // 代表 F(n-1)

  for (let i = 2; i <= n; i++) {
    const next = prev + curr;
    prev = curr;
    curr = next;
  }

  return curr;
}

console.log(fibonacciIterative(50)); // 示例输出: 12586269025| 实现方案 | 时间复杂度 | 空间复杂度 | 优缺点评定 |
|---|---|---|---|
| 朴素双分支递归 | O(2ⁿ) 指数爆炸 |
O(n) 栈深度 |
结构直观,但规模超过 40 时几乎不可用。 |
| 记忆化递归 (Memo) | O(n) 线性增长 |
O(n) 栈深度 + 表缓存 |
保留自顶向下的递归思维,剪除重复子树,效率极高。 |
| 自底向上循环迭代 | O(n) 线性增长 |
O(1) 常数级变量 |
无栈溢出风险,执行速度最快,生产环境首选。 |
五、调用栈安全守则:防范栈溢出与工程选型依据
在编写生产级别的 JavaScript 递归代码时,建议按照以下四个标准化步骤进行工程验证:
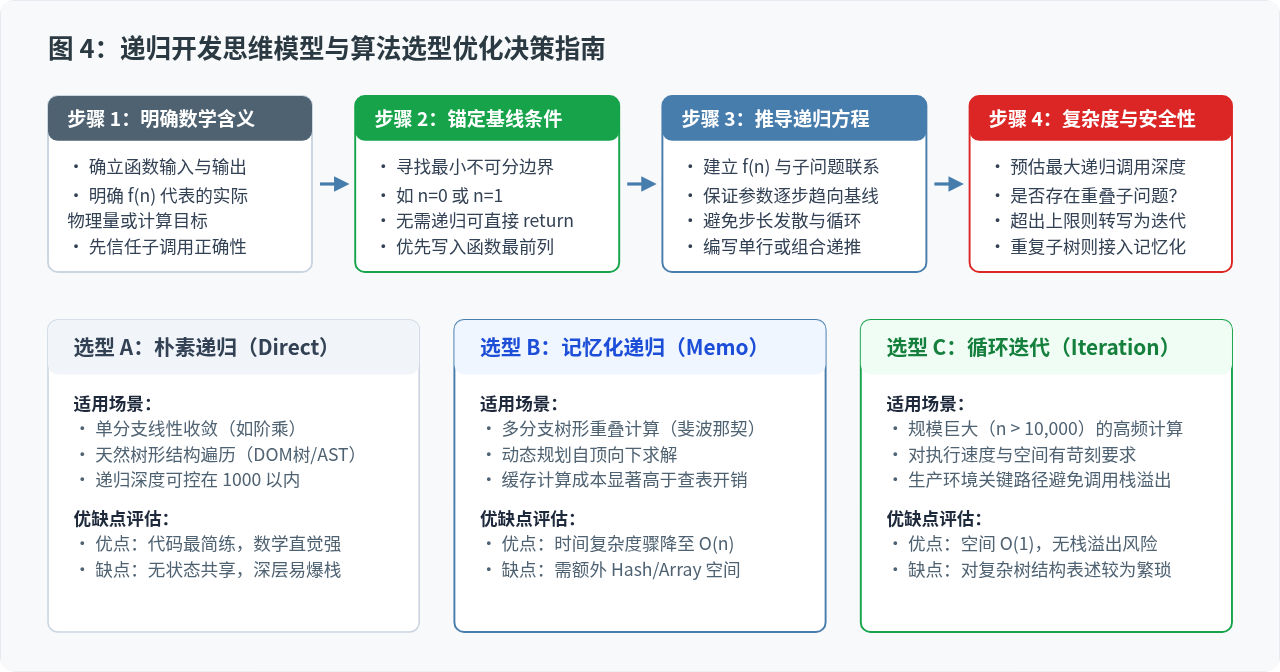
1. 递归编写的防御性检查清单
- 首行放置基线判断:严禁在递归调用之后才处理基线边界,基线逻辑必须位于函数体最前沿。
- 确保步长单向收敛:检查传入递归调用的参数,确保每次调用都在向基线数值移动(例如
n - 1),切勿出现步长为 0 或方向颠倒的情况。 - 评估最大调用栈深度:若业务场景可能涉及成千上万层嵌套(如深度未知的超大树状结构数据),优先选择循环迭代,或手动借助数组模拟执行栈(显式栈),避免触发引擎硬性栈深度上限。
ES6 规范曾定义了“尾调用优化”(Tail Call Optimization,TCO),允许在特定严格模式下,如果函数的最后一步仅仅是返回子调用结果,引擎可复用当前栈帧而不增加栈深度。然而在实际工程环境中,主流 JavaScript 引擎(如 Google V8、Node.js、SpiderMonkey)因调试栈追踪(Stack Trace)保留及安全考量,并未默认支持该特性。因此,不可将生产代码的栈安全寄托于引擎的尾递归优化,深层计算请坚决改写为显式循环。
什么时候该用JS构造器:与工厂模式、字面量的选择对比
2026-11-05 16:18:22
推荐几款轻量级JS照片墙开源库及对比
2026-11-05 15:56:19
JavaScript递归写法有哪些常见陷阱及避免方法
2026-11-05 14:53:38
JS数组浅拷贝与深拷贝怎么选?场景与方法总结
2026-11-05 14:41:02
p5.js 中 setup() 和 draw() 函数的执行机制详解
2026-11-05 12:32:38
相关标签:







