怎么解决 Turf.js 处理大规模 GeoJSON 数据的性能瓶颈
深入剖析 Turf.js 在处理大规模 GeoJSON 数据时的单线程阻塞与高阶复杂度瓶颈,系统阐述空间索引剪枝、Web Worker 异步分块、几何轻量化预处理与流式调度的完整工程解决方案。
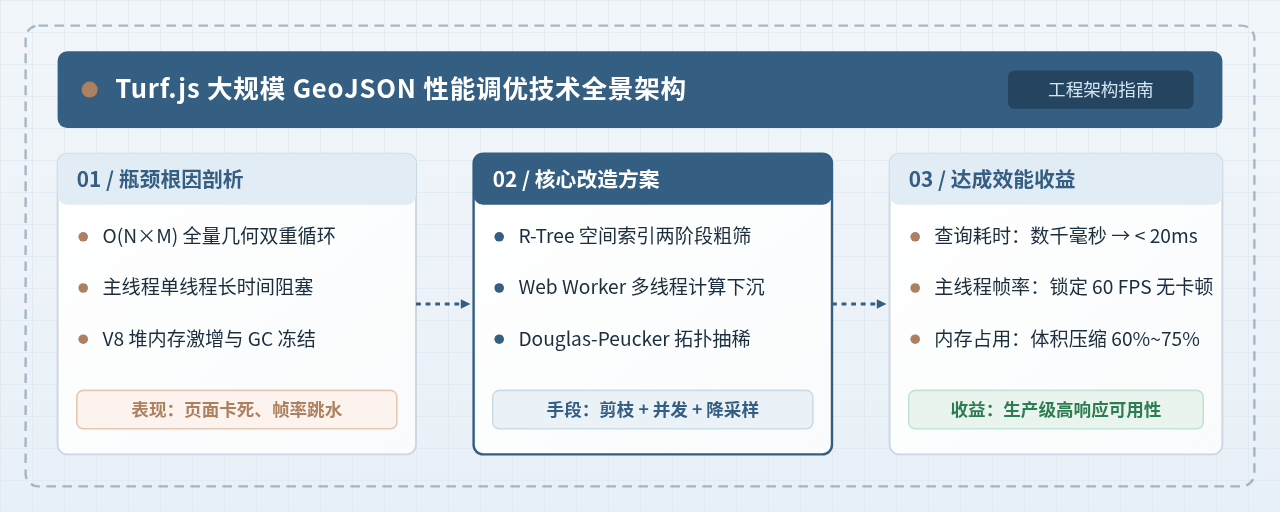
一、Turf.js 处理大规模数据的瓶颈成因
Turf.js 是 Web GIS 与前端空间几何计算的事实标准库。它完全基于纯 JavaScript 编写,原生操作遵循 GeoJSON 规范的 JavaScript 对象。在处理数十或数百个要素(Features)的小型数据集时,Turf.js 凭借轻量、无外部依赖和直观的 API 能带来极高的研发效率。
然而,一旦数据规模上升至数万个要素或数百万个几何顶点,应用系统便会迅速陷入严重的性能瓶颈,主要表现在以下四个层面:
-
全量几何扫描的双重循环(O(N×M) 复杂度):
在最常见的点落区匹配(Point in Polygon)或要素间相交检测场景下,若未经预先索引,开发者通常使用双重
for循环或Array.filter进行全量比对。若有 10,000 个待查点与 5,000 个多边形,便会产生 5,000 万次射线相交判定,导致计算耗时线性爆炸。 -
浏览器主线程单线程阻塞:
Web 端的 JavaScript 运行在单线程事件循环中。如果一次复杂的
turf.buffer(缓冲区生成)或turf.intersect(面面相交)占用调用栈超过 50ms,就会被浏览器判定为长任务(Long Task)。计算期间,用户的所有缩放、平移手势以及 WebGL/Canvas 地图重绘全部停滞,界面直接假死。 -
GeoJSON 对象深层嵌套引发的 V8 堆内存激增:
GeoJSON 是一种文本友好的松散数据结构。一个包含了 10 万个点要素的
FeatureCollection,在 V8 引擎解析后会派生出数百万个细小的对象实例(包括 Feature、Geometry、Coordinates 数组及 Properties 键值对)。原本仅 30MB 的文本文件,在内存中常膨胀至 200MB 以上,频繁触发 JavaScript 引擎的垃圾回收(GC Stop-The-World),造成周期性掉帧。 - 多边形顶点冗余与几何退化: 许多业务数据直接来源于高精度的测绘 Shapefile,单个复杂面包含数万个经纬度坐标点。直接对这类高密度多边形进行布尔运算时,算法底层复杂度往往与顶点数平方相关,运算耗时呈几何级数增加。
二、核心方案一:引入 R-Tree 空间索引实现两阶段剪枝
解决 Turf.js 计算瓶颈最立竿见影的手段,是将无序的全量遍历升级为“外包围盒两阶段剪枝(Two-Phase Spatial Filtering)”。通过 R-Tree 树形空间数据结构,首先在毫秒级时间内剔除 98% 以上在空间上绝不可能重叠的要素,最后仅对极少数疑似候选集调用真实的 Turf 几何函数。
在 JavaScript 生态中,目前成熟度最高、性能最优的空间索引库主要有两个:
- RBush:基于 R-Tree 的动态二维空间索引库,支持高频增量插入与动态删除,适合要素会随时变动(如移动车辆、动态标绘)的业务场景。
- Flatbush:针对静态只读数据的超紧凑空间索引库。它采用扁平内存布局(Flat ArrayBuffer),内存占用仅为普通对象的十分之一,且索引构建速度是 RBush 的 2~3 倍,是只读底图或离线分析的首选。
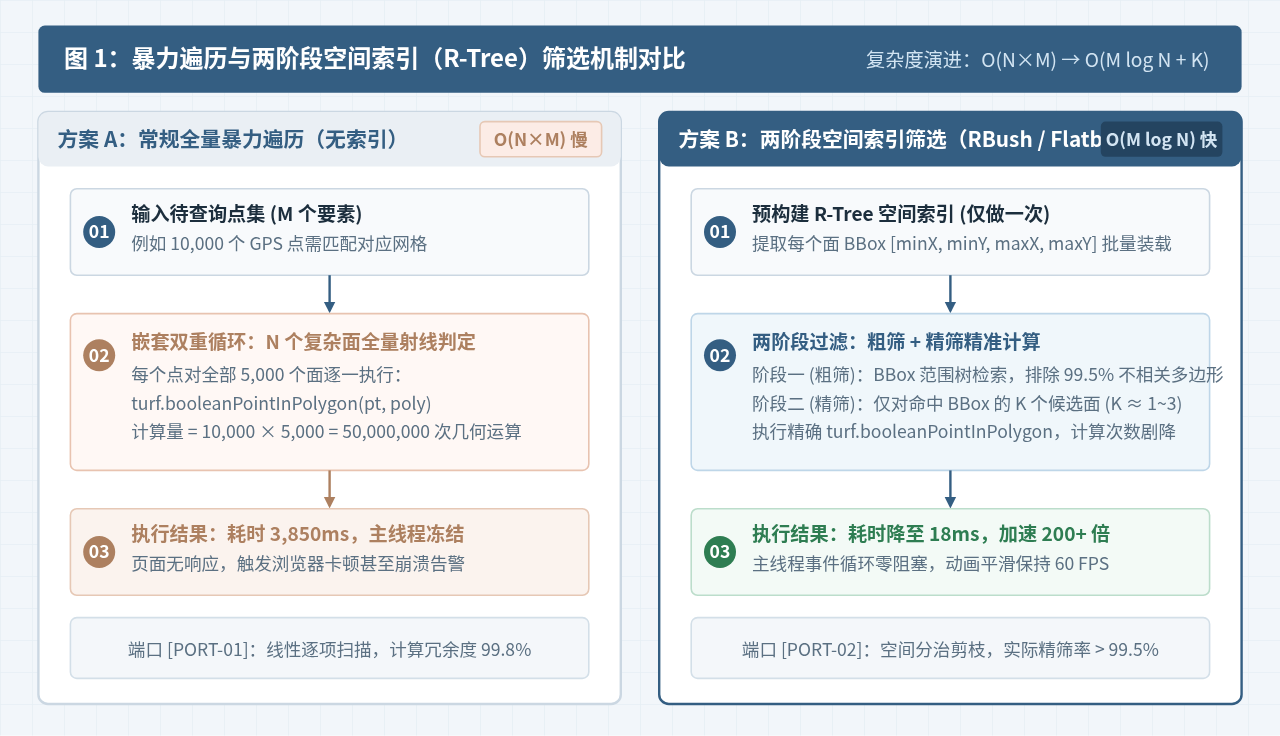
代码实战:基于 RBush 构建两阶段空间包含查询服务
以下是在生产项目中封装的通用空间索引服务示例。我们在数据初始化阶段批量提取每个 Polygon 的外包围盒(Bounding Box),将其灌入 RBush 树中;在执行点选匹配时,先通过点的坐标范围进行 BBox 粗筛,随后对命中的几个候选要素执行 turf.booleanPointInPolygon:
// 引入 RBush 索引库与 Turf 核心模块
import RBush from 'rbush';
import bbox from '@turf/bbox';
import booleanPointInPolygon from '@turf/boolean-point-in-polygon';

export class SpatialIndexService {
  constructor() {
    this.tree = new RBush();
    this.indexedCount = 0;
  }

  /**
   * 为大规模多边形集合构建 R-Tree 空间索引
   * @param {FeatureCollection} featureCollection 目标多边形集合
   */
  loadPolygons(featureCollection) {
    const items = featureCollection.features.map((feature, idx) => {
      // 计算每个要素的外包围盒 [minX, minY, maxX, maxY]
      const [minX, minY, maxX, maxY] = bbox(feature);
      return {
        minX,
        minY,
        maxX,
        maxY,
        id: feature.id || idx,
        feature: feature
      };
    });

    // 批量装载索引(Bulk Load 性能显著优于循环 insert)
    this.tree.load(items);
    this.indexedCount = items.length;
  }

  /**
   * 两阶段点落区查询
   * @param {Feature<Point>} point 待匹配的查询点
   * @returns {Array<Feature>} 包含该点的多边形数组
   */
  findContainingPolygons(point) {
    const [px, py] = point.geometry.coordinates;

    // 阶段一(粗筛):通过 R-Tree 搜索相交的外包围盒(耗时通常 < 0.5ms)
    const candidateBoxes = this.tree.search({
      minX: px,
      minY: py,
      maxX: px,
      maxY: py
    });

    // 阶段二(精筛):仅针对粗筛命中的少量要素执行射线法精确判定
    const matchedFeatures = [];
    for (let i = 0; i < candidateBoxes.length; i++) {
      const candidate = candidateBoxes[i].feature;
      if (booleanPointInPolygon(point, candidate)) {
        matchedFeatures.push(candidate);
      }
    }

    return matchedFeatures;
  }
}tree.load(items) 进行一次性批量装载,切忌在循环中反复调用 tree.insert(item)。load() 采用 OMT(Overlap Minimizing Top-down)打包算法,不仅构建速度快数十倍,还能生成平衡度极高的高效树形。
三、核心方案二:通过 Web Worker 将密集空间计算移出主线程
对于一些原生复杂度极高的计算操作(如大范围多边形缓冲 turf.buffer、拓扑融合 turf.dissolve 或凸包计算 turf.convex),即便是精简之后,计算本身仍需耗费数百毫秒。将这类重计算留在主线程,必然会导致页面掉帧、卡死。
现代浏览器的标准解法是启用 Web Worker,将几何数据分发至后台独立线程执行,计算完成后再通过消息通道回传结果。在 Worker 线程中,V8 拥有独立的堆内存空间,其计算消耗与垃圾回收完全不会干扰主线程的 60 FPS 渲染。
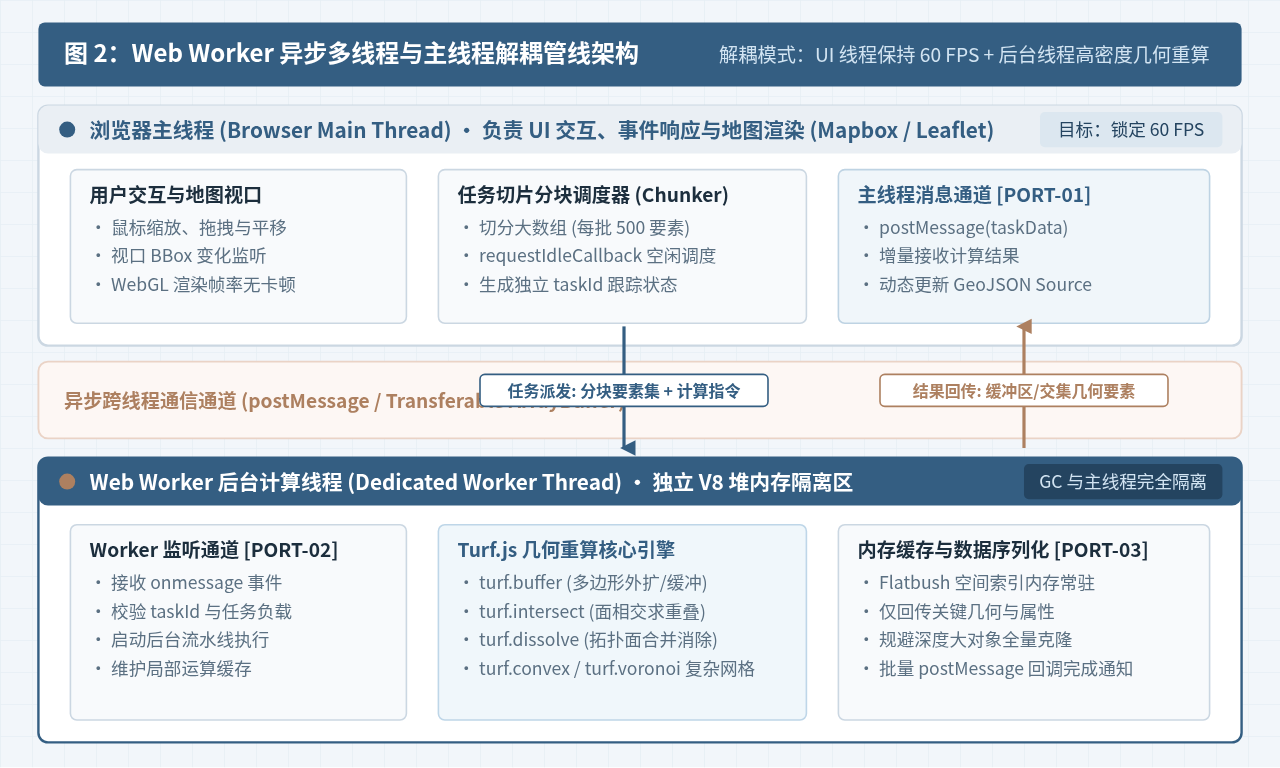
代码实战:主线程与 Worker 线程的任务解耦设计
在实施 Web Worker 改造时,核心注意事项是控制跨线程通信的序列化开销。不要把包含大量复杂业务属性的全部对象传给 Worker,而应只传递精简后的 Geometry 数组;回传结果时,如果不需要在主线程频繁操作对象,可以使用结构化克隆(Structured Clone)或 Transferable 对象。
// ==========================================
// 1. 后台工作线程:turf-worker.js
// ==========================================
import buffer from '@turf/buffer';

self.addEventListener('message', (event) => {
  const { taskId, type, payload } = event.data;

  if (type === 'COMPUTE_BUFFER_BATCH') {
    const { features, distance, units } = payload;

    try {
      // 在后台线程密集执行 Turf 缓冲区运算
      const bufferedResults = features.map(feat => {
        return buffer(feat, distance, { units });
      });

      // 将结果打包回传给主线程
      self.postMessage({
        taskId,
        success: true,
        data: bufferedResults
      });
    } catch (err) {
      self.postMessage({
        taskId,
        success: false,
        error: err.message
      });
    }
  }
});

// ==========================================
// 2. 浏览器主线程:worker-dispatcher.js
// ==========================================
export class TurfWorkerPool {
  constructor(workerScriptUrl) {
    this.worker = new Worker(workerScriptUrl, { type: 'module' });
    this.pendingTasks = new Map();

    this.worker.addEventListener('message', (e) => {
      const { taskId, success, data, error } = e.data;
      const promiseHandlers = this.pendingTasks.get(taskId);

      if (promiseHandlers) {
        this.pendingTasks.delete(taskId);
        if (success) {
          promiseHandlers.resolve(data);
        } else {
          promiseHandlers.reject(new Error(error));
        }
      }
    });
  }

  /**
   * 异步派发批量缓冲区计算任务
   */
  executeBufferBatch(features, distance, units = 'kilometers') {
    return new Promise((resolve, reject) => {
      const taskId = 'task_' + Math.random().toString(36).substr(2, 9);
      this.pendingTasks.set(taskId, { resolve, reject });

      this.worker.postMessage({
        taskId,
        type: 'COMPUTE_BUFFER_BATCH',
        payload: { features, distance, units }
      });
    });
  }
}
四、核心方案三:几何拓扑轻量化与数据源预处理
在空间计算领域,算法耗时往往与几何实体的顶点数量呈非线性关系。许多从遥感或 CAD 系统直接导出的矢量多边形存在大量过度密集的点位,或者包含了远在当前视口之外的无效要素。在执行 Turf.js 运算前,必须进行前置的几何轻量化预处理。
1. 视口相交裁剪(BBox Clipping)
用户在交互地图时,屏幕往往只能展示全局数据中的一个局部区域。如果针对整个城市的 10 万个要素运行计算,有 90% 以上的结果都在屏幕可视范围外。通过预先计算当前视口外包围盒,并使用 turf.booleanDisjoint 剔除完全不相交的多边形,可以瞬间减少大部分计算量。
2. 拓扑抽稀(Douglas-Peucker 算法)
使用 turf.simplify 可以在保留几何体宏观拓扑形状的前提下,剔除直线或平缓曲线上的共线冗余点。合理设置 tolerance(容差)参数,通常可以将顶点总数缩减 60%~80%,而肉眼几乎无法分辨形状差异。
3. 坐标浮点精度截断
GeoJSON 默认的经纬度浮点数往往精确到小数点后第 10 位甚至 14 位(相当于微米级精度,对于地理空间无实际意义)。将经纬度截断至 6 位小数(地面分辨率约 0.1 米),不仅可以极大地加速数值计算,还可以使序列化后的 JSON 字符串体积直接缩减 40% 以上。
import simplify from '@turf/simplify';
import bbox from '@turf/bbox';
import coordEach from '@turf/coord-each';

/**
 * 几何轻量化管道:视口过滤 + 抽稀 + 精度截断
 * @param {FeatureCollection} fc 原始要素集
 * @param {Array<number>} viewportBbox 当前屏幕视口外包围盒 [minX, minY, maxX, maxY]
 * @param {number} tolerance 抽稀容差 (单位通常为度,如 0.0005)
 */
export function preprocessGeoJson(fc, viewportBbox, tolerance = 0.0005) {
  const [vMinX, vMinY, vMaxX, vMaxY] = viewportBbox;
  const validFeatures = [];

  for (let i = 0; i < fc.features.length; i++) {
    const feat = fc.features[i];
    const [fMinX, fMinY, fMaxX, fMaxY] = bbox(feat);

    // 1. 视口快速碰撞检测(AABB 相交检测)
    const isOutside = fMaxX < vMinX || fMinX > vMaxX || fMaxY < vMinY || fMinY > vMaxY;
    if (isOutside) {
      continue; // 彻底跳过视口外要素
    }

    // 2. 使用 Douglas-Peucker 算法降低顶点密度
    const simplifiedFeat = simplify(feat, {
      tolerance: tolerance,
      highQuality: false, // 追求速度时关闭 highQuality
      mutate: false
    });

    // 3. 截断经纬度保留 6 位小数
    coordEach(simplifiedFeat, (coords) => {
      coords[0] = Math.round(coords[0] * 1e6) / 1e6;
      coords[1] = Math.round(coords[1] * 1e6) / 1e6;
    });

    validFeatures.push(simplifiedFeat);
  }

  return {
    type: 'FeatureCollection',
    features: validFeatures
  };
}
五、核心方案四:分块批处理与空闲调度机制
在某些无法轻易使用 Web Worker 的受限环境(如受同源策略限制的沙箱 iframe 或轻量微前端容器),空间计算只能在主线程内完成。此时切忌使用 features.forEach() 一次性把成千上万个要素全量塞进同步循环。
正确的做法是引入时间切片(Time Slicing)与流式分块(Chunking)机制。将大数组拆分为每批 200~500 个要素的小分片,借助浏览器的 requestIdleCallback 或异步宏任务在帧空闲时执行一段,将执行权适时交还给浏览器的渲染管线,从而彻底避免界面被长时间霸占。
/**
   * 基于 requestIdleCallback 的大批量数据无阻塞调度执行器
   */
export async function processInChunks(items, chunkSize, processItemFn, onProgress) {
  let cursor = 0;
  const total = items.length;
  const results = [];

  while (cursor < total) {
    const chunk = items.slice(cursor, cursor + chunkSize);

    // 处理当前分块内的要素
    for (let i = 0; i < chunk.length; i++) {
      results.push(processItemFn(chunk[i]));
    }

    cursor += chunk.length;
    if (onProgress) {
      onProgress(cursor, total);
    }

    // 出让执行权,等待浏览器空闲帧
    await new Promise((resolve) => {
      if ('requestIdleCallback' in window) {
        window.requestIdleCallback(() => resolve(), { timeout: 20 });
      } else {
        setTimeout(resolve, 0);
      }
    });
  }

  return results;
}
六、落地步骤:大规模 GeoJSON 性能调优实施全流程
在真实生产工程中,解决 Turf.js 性能问题绝非盲目堆砌优化手段,而应遵循严密的诊断、重构与验证步骤,确保在维持拓扑几何正确性的同时,获得确定性的运行效能提升。
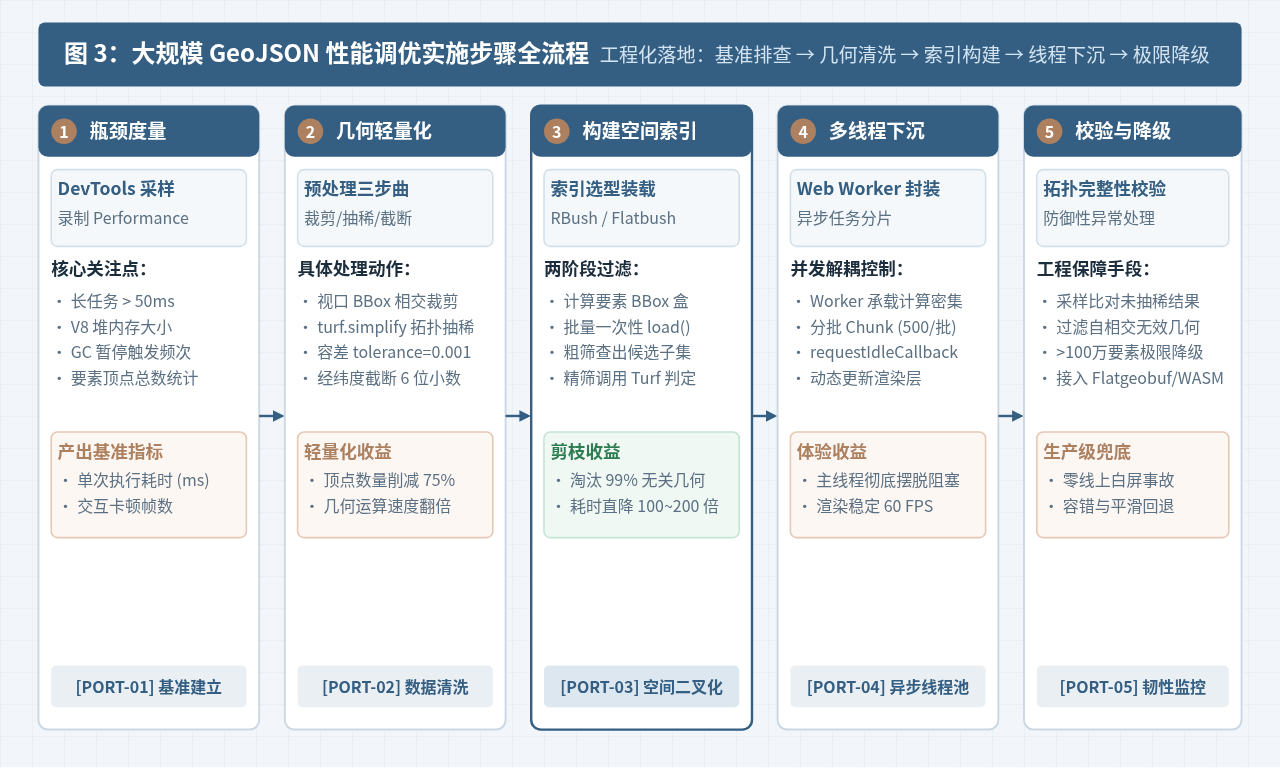
完整的实施路线包含以下五个关键步骤:
-
步骤一:瓶颈度量与基准采样
在修改任何代码前,在 Chrome DevTools 的 Performance 面板中录制计算过程。明确瓶颈是出在JSON.parse反序列化、Turf 函数调用栈,还是垃圾回收(GC)。记录未优化前的单次执行耗时(如 4,200ms)和丢帧数量,以此建立优化基线。 -
步骤二:数据源几何轻量化
对输入数据执行视口 BBox 相交裁剪,剔除无效要素;配置turf.simplify抽稀多余顶点,并将坐标统一截断至 6 位浮点数,从源头上遏制计算量。 -
步骤三:空间索引构建与两阶段检索
若是只读底图或检索场景,装载 Flatbush 或 RBush 索引。在业务查询入口将暴力扫描重构为“BBox 粗筛 + Turf 精筛”的二阶段范式。 -
步骤四:异步多线程管线与切片集成
将 CPU 密集型操作剥离至独立 Web Worker 脚本中,配置分块调度器,配合requestIdleCallback,使主线程完全回归 UI 渲染。 -
步骤五:拓扑完整性校验与极端降级
对比抽稀前后计算结果的准确性,防止因抽稀过度导致多边形自相交(Self-intersection)。针对超过 50 万要素的极端超量数据,建立向二进制数据流(如 Flatgeobuf)或 WebAssembly 计算模块的降级通道。
七、架构演进:技术选型决策与全景矩阵
不同的业务数据量级与几何计算类型,对应的最佳优化手段截然不同。并非所有场景都需要复杂的 Web Worker 或索引重构。根据实际工程经验,可参考以下全景决策矩阵进行技术方案的选型与演进:
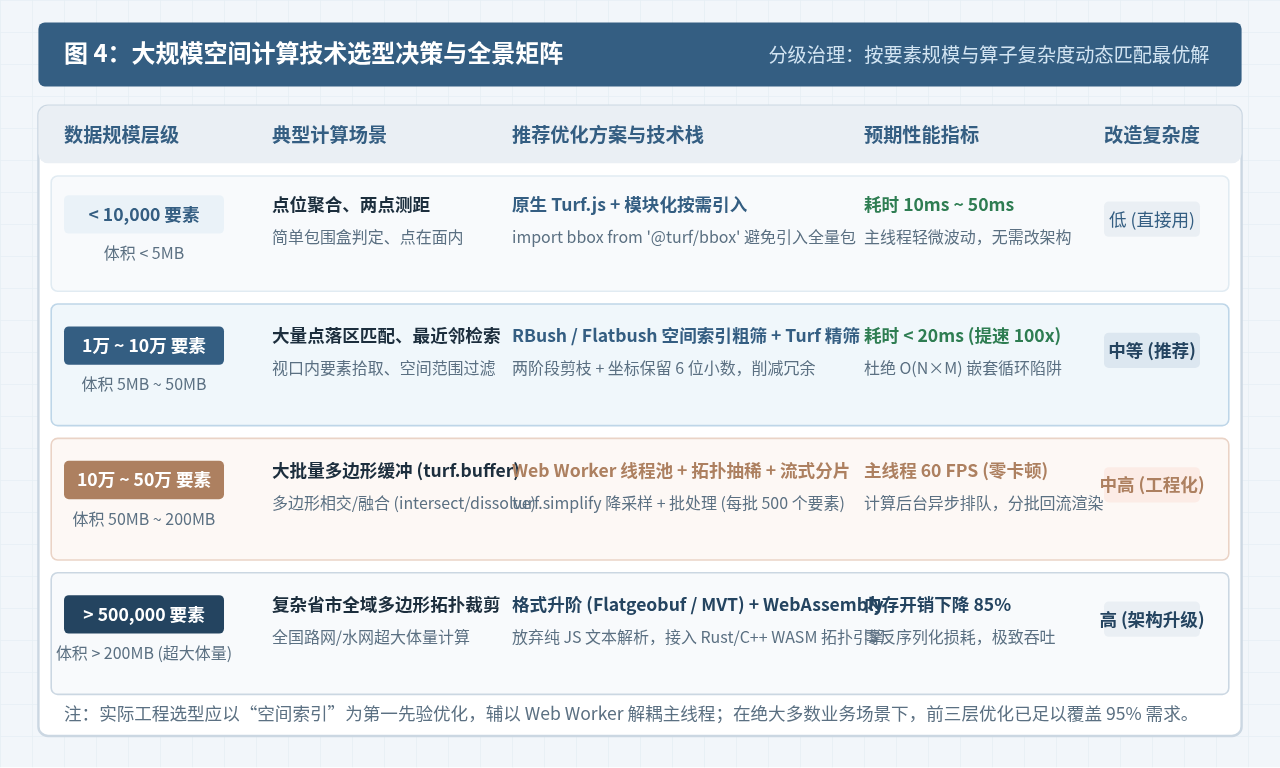
| 要素规模与体积 | 典型业务场景 | 推荐架构方案 | 预期性能表现 | 改造成本 |
|---|---|---|---|---|
| < 10,000 要素 (< 5MB) |
点位聚合、单点落区、测距 | 原生 Turf.js + 模块化按需引用 | 耗时 10ms ~ 50ms 无需改造已有架构 |
极低 |
| 10,000 ~ 100,000 要素 (5MB ~ 50MB) |
海量点多边形匹配、空间相交过滤 | RBush / Flatbush 空间索引 + 视口裁剪 | 耗时降至 < 20ms 性能提升 100~200 倍 |
中等(推荐首选) |
| 100,000 ~ 500,000 要素 (50MB ~ 200MB) |
复杂多边形缓冲区、相交面求解、融合 | Web Worker 线程池 + 拓扑抽稀 + 分块切片 | 主线程锁定 60 FPS 后台异步平滑出图 |
中高(需多线程封装) |
| > 500,000 要素 (> 200MB 超大规模) |
全省市级土地规划、全国级管网水系分析 | Flatgeobuf 二进制格式 + 矢量瓦片 + WebAssembly (GeoRust) | 内存下降 85% 突破浏览器 JS 堆栈瓶颈 |
高(需基础设施演进) |
八、工程实施避坑指南
在落地以上优化方案的过程中,有几个隐蔽且极易踩中的工程陷阱需要特别关注:
-
避免跨线程传输全量业务属性:
Web Worker 的
postMessage在传递深层 JavaScript 对象时,底层需要执行结构化克隆(Structured Clone)算法。如果一个 GeoJSON 要素携带了数十个业务属性字段,向 Worker 传递该对象所花费的序列化时间甚至可能超过计算本身。最佳实践是在主线程将属性(Properties)与几何(Geometry)分离,仅将必要的坐标数组发送给 Worker。 -
防范抽稀导致的几何自相交与无效面:
Douglas-Peucker 算法虽然高效,但在处理带有极近内环(Holes)或复杂边界的多边形时,若
tolerance设置过大,可能会导致多边形边界相互穿透,破坏 OGC 拓扑有效性(产生 Invalid Polygon)。调用turf.simplify后,对于关键的多边形分析,建议结合turf.kinks检查是否存在自相交点。 -
警惕经纬度与投影坐标系混淆:
Turf.js 默认基于 WGS84 经纬度椭球面进行大圆航线(Geodesic)度量。但在执行平面几何算法(如平面切片、二维 R-Tree 盒构建)时,高纬度地区的经纬度跨度并不等同于米制跨度。如果计算涉及精确距离阈值,必须统一使用
units: 'meters'或在投影坐标系(如 Web Mercator EPSG:3857)下完成空间运算。
怎么使用 JavaScript import() 实现模块的条件加载
2026-11-05 14:44:45
前端防御XSS攻击:怎么防止恶意JS注入与CSP策略配置
2026-11-04 08:51:38
为什么不建议在JS中手动拼接JSON字符串?
2026-11-03 22:48:27
代码混淆对JS执行性能的影响测试与分析
2026-11-03 22:25:37
怎么在JavaScript中使用js-coroutines库实现完整协程功能
2026-11-03 19:48:34