为什么不建议在JS中手动拼接JSON字符串?
深入剖析为什么在 JavaScript 中不建议手动拼接 JSON 字符串,从特殊字符转义失真、类型边界坍塌、JSON 注入安全风险以及底层引擎性能等维度进行系统解析,并给出生产环境下的安全序列化最佳实践。
JSON.stringify(),在 C++ 层面具备极致的转义与遍历优化。手动拼接无法带来实质的性能收益,却直接破坏了数据结构化的可靠性。
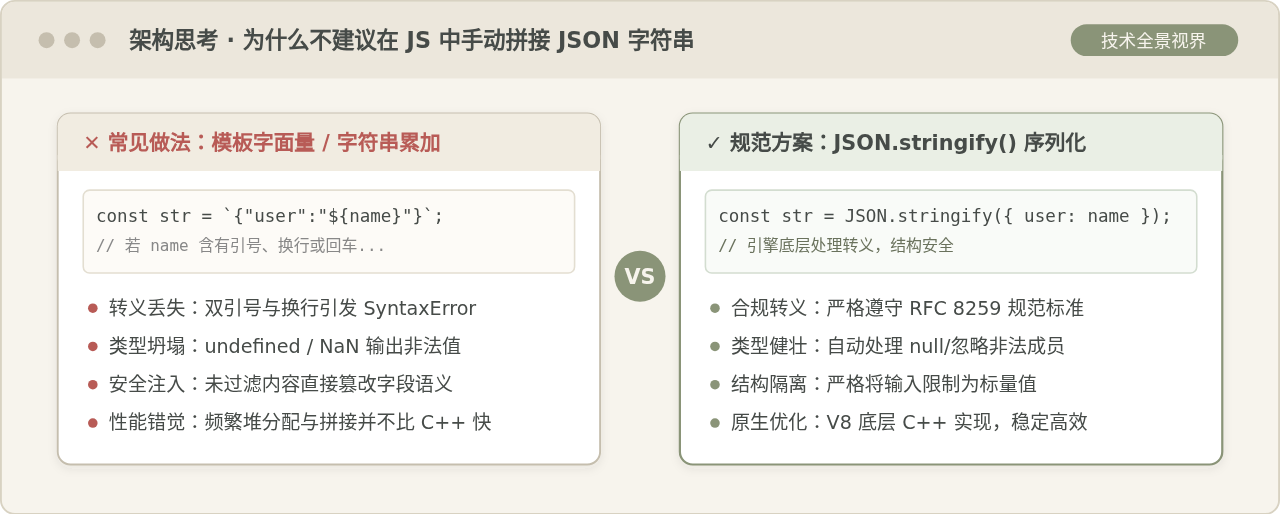
一、为什么开发者会产生手动拼接的念头?
在编写网络请求、构建跨进程 IPC 消息或生成埋点日志时,经常能看到类似下面的拼接写法:
// 常见的手动拼接示例
const name = getUserInput();
const id = getUserId();
const payload = `{"id": ${id}, "name": "${name}"}`;
fetch('/api/submit', { method: 'POST', body: payload });
这种写法之所以屡见不鲜,主要源于两种直觉认知:
- 直觉一:结构简单,写个模板字面量更省事。当数据结构只有一两个扁平字段时,开发者认为声明一个对象再调用
JSON.stringify()多写了两行代码,不如直拼直观。 - 直觉二:认为避免创建中间对象可以“提升性能”。有人误以为声明 JavaScript 对象会带来内存分配和垃圾回收开销,而原生
JSON.stringify()属于深层函数调用,直拼可以“省下函数调用的开销”。
这些想法在极其严苛的纯受控静态常量场景(例如纯数字坐标、已知无转义字符的预设枚举)中看似能够正常运行,但它把本该由运行时引擎承担的语法规范性保障完全转嫁给了脆弱的外部假设。一旦数据源接入了用户输入、远端接口返回或动态计算值,隐藏的隐患就会立刻爆发。
二、隐患一:特殊字符与转义遗漏(最常见的解析崩溃)
JSON 规范(RFC 8259)对字符串内部的字符有着严格的要求:包含在双引号内的文本如果出现双引号 "、反斜杠 \ 或 ASCII 控制字符(如换行符
、回车符 、制表符 等),必须进行反斜杠转义。
当使用模板字面量或加号拼接时,变量的内容是原样嵌入到模板中的。以用户的昵称或留言为例:
const userInput = 'Tom "Neo"'; // 名字中带有英文双引号
const jsonStr = `{"username": "${userInput}"}`;

console.log(jsonStr);
// 输出结果:{"username": "Tom "Neo""}  <-- 非法 JSON!

JSON.parse(jsonStr);
// 抛出异常:Uncaught SyntaxError: Unexpected token N in JSON at position 18
同样的故障发生在多行输入时。如果用户在文本框里敲了回车,变量中包含字面量换行符
(U+000A),在直拼得到的字符串中会变成真实的换行,而 JSON 语法规定字符串内部不允许直接包含未转义的控制字符,解析端会直接抛出 SyntaxError: Unexpected token ILLEGAL 或 Bad control character in string literal。
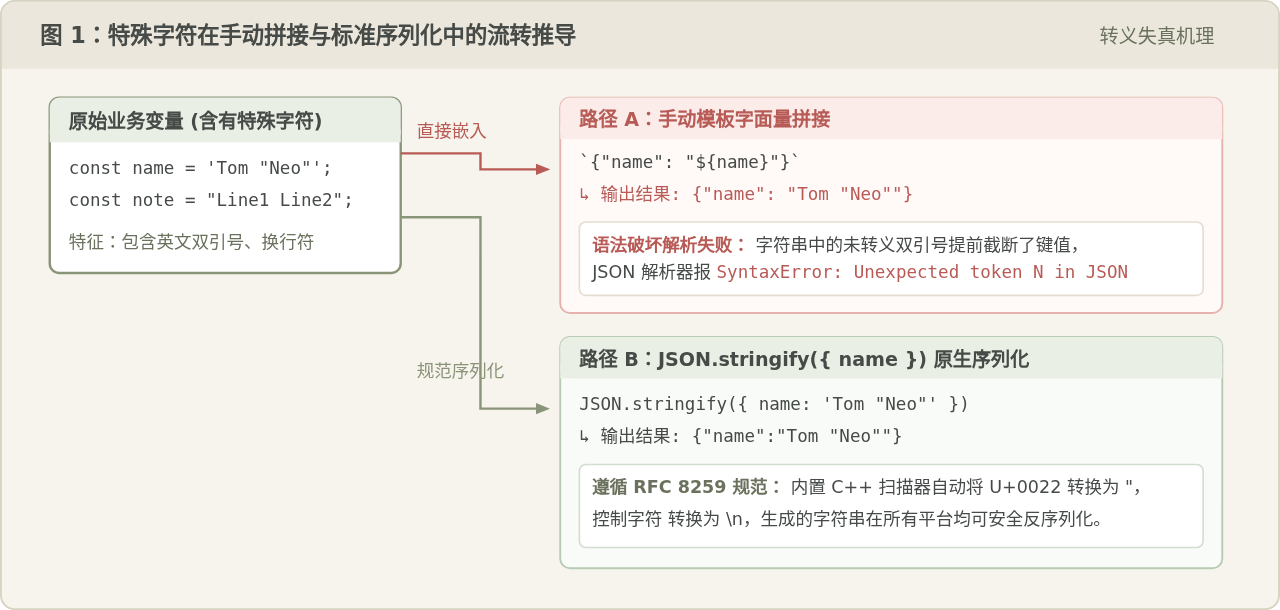
相比之下,JSON.stringify() 在底层执行了完善的字符扫描与映射表置换。它会将 " 自动处理为 ",将换行符替换为转义序列
,确保输出结果在任意遵循规范的解析器中均能被无损还原。
三、隐患二:JavaScript 数据类型的失真与坍塌
JSON 虽然源自 JavaScript 对象字面量语法,但两者的类型系统存在本质差异。JavaScript 拥有 undefined、NaN、Infinity、Date、BigInt、Symbol 以及函数等丰富类型,而 JSON 只支持字符串、数字、布尔值、数组、对象和 null 六种数据类型。
手动拼接往往依赖变量的默认 toString() 方法,这会导致大量非法值的产生:
| JavaScript 数据值 | 模板字面量直拼结果 | JSON 规范表现与合法性 | JSON.stringify() 标准处理 |
|---|---|---|---|
undefined |
{"val": undefined} |
非法(JSON 中不存在 undefined) | 对象中该属性直接被忽略;数组中转化为 null |
NaN / Infinity |
{"count": NaN} |
非法(JSON 数值必须是有穷实数) | 统一规范转换为 null |
new Date() |
{"time": "Sat Oct 31 2026..."} |
混淆(本地化字符串难以统一解析) | 自动调用 toISOString() 生成标准 UTC 串 |
null |
{"data": "null"}(带引号时被当成字符串) |
语义偏移(对象 null 变成字符串 "null") | 精确保留为字面量 null |
// 真实业务中极具隐蔽性的浮点计算异常
const score = calculateScore(); // 若逻辑除以 0,返回 NaN
const rawPayload = `{"userId": 1001, "score": ${score}}`;
// 结果为: '{"userId": 1001, "score": NaN}'
// 发送给服务端 Java/Go/Python 的 JSON 反序列化库时立刻报错拒收!
手动拼接无法感知运行时的类型边界。如果要手写兼容 undefined、null、NaN 的逻辑,开发者就需要针对每个字段写一遍三元运算符和类型检查,代码不仅冗长,而且随时可能由于疏漏再次引入崩溃。
四、隐患三:JSON 注入风险与数据越权漏洞
许多人认为 SQL 注入、XSS 是安全问题的重灾区,却忽视了由字符串拼接引发的 JSON 注入(JSON Injection)。
在微服务架构或前后端通信中,如果通过字符串拼接构造发往鉴权服务、下游网关或存储引擎的数据包,攻击者可以通过构造闭合字符逃逸出原本的字段值,从而注入新的键值对甚至修改原有业务字段。
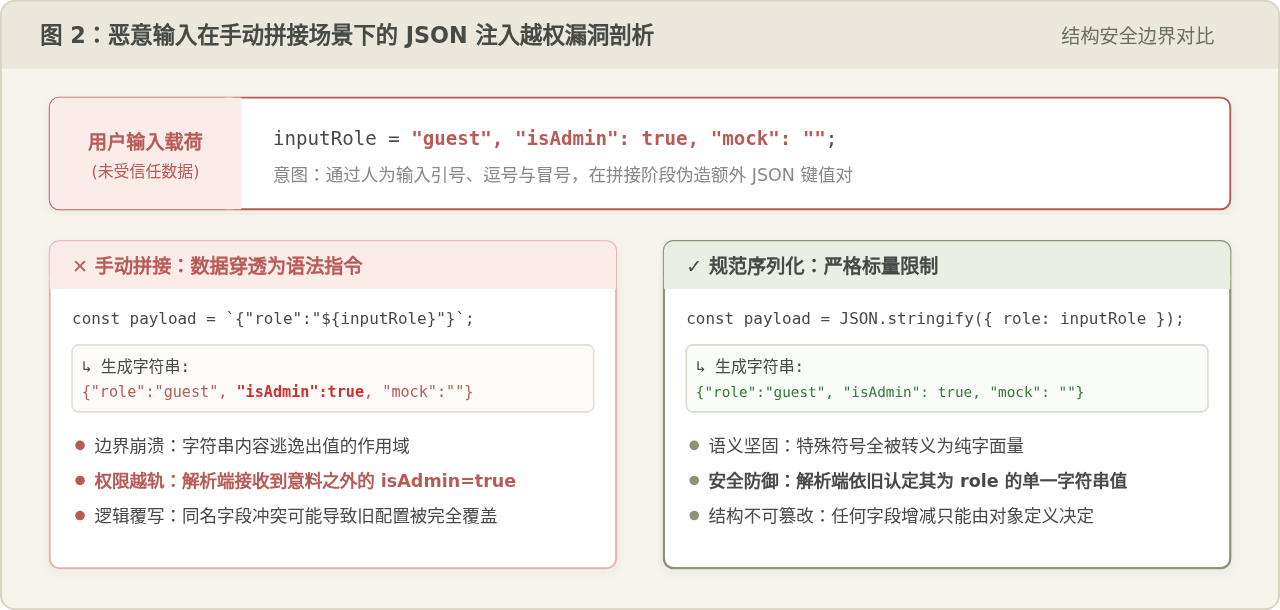
来看一个真实的逻辑越权漏洞复现:
// 服务端某内部转发逻辑使用手动拼接
function buildTokenPayload(username, role) {
  return `{"username": "${username}", "role": "${role}"}`;
}

// 正常调用:buildTokenPayload("alice", "user") 正常
// 攻击者注册名为:bob", "role": "admin", "x": "
const maliciousName = 'bob", "role": "admin", "x": "';
const injectedJSON = buildTokenPayload(maliciousName, 'user');

console.log(injectedJSON);
// 拼接输出结果:
// {"username": "bob", "role": "admin", "x": "", "role": "user"}

// 根据许多后端 JSON 库(如以最后一个 key 为准或以前一个为准的特定实现)
// "role": "admin" 被成功注入并生效,完成了无需鉴权的水平越权!
而在使用 JSON.stringify({ username, role }) 时,无论 username 传入多少引号、冒号或括号,序列化器都会坚决地将它们当作普通文本进行反斜杠转义,字段结构始终受到语言引擎的硬性保护,杜绝了结构注入的可能。
五、性能辨析:手拼真的比 JSON.stringify() 更快吗?
在日常开发中,常有声音认为:“既然只拼两三个属性,调用底层序列化器需要建立 AST、反射属性,手拼肯定开销更小”。这个判断忽视了现代 JavaScript 引擎的底层架构设计。
在主流的 V8 引擎(Chrome、Node.js)中,JSON.stringify() 并不是用 JavaScript 编写的高级递归函数,而是由深度优化的 C++ 代码直接实现的(位于 src/json/json-stringifier.cc)。引擎在内存中做的是预估缓冲区大小、线性单次遍历、直接内存拷贝。
相反,在 JavaScript 层面使用模板字面量或加号拼接多个变量时,运行时需要经历:
- 多次调用各变量的
ToString抽象操作; - 在 JS 堆内存中频繁分配微小字符串对象(ConsString 拼接);
- 触发垃圾回收器(GC)对拼接过程中的临时字符串碎片进行清理回收。
基准测试表明,对于常见的几十到上百字节业务对象,手拼带来的微秒级差异不仅完全无法抵消后续网络 I/O 的延迟,反而在高吞吐场景下因引发更频繁的新生代(Young Generation)GC 停顿而拖慢整机吞吐。
在 Fastify 等极端追求每秒请求数(RPS)的网关框架中,确实存在类似于“拼接字符串”的实现(如 fast-json-stringify)。但必须强调:它们绝非手动书写模板字面量,而是基于事先给定的 JSON Schema 模式,通过 JIT 编译器在启动期生成带有完整转义算法的预编译函数。在没有 Schema 强约束的常规业务代码中,决不可盲目效仿。
六、规范实践:生产级 JSON 序列化与防御流水线
在规范的工程实践中,推荐建立严格的“面向对象操作,边界原子序列化”原则:在业务逻辑流转过程中,数据必须始终保持为纯净的 JavaScript 对象;只在需要向外界输出(如发送 HTTP 请求、写入本地存储、发送 Redis 消息)的最后边界处,调用 JSON.stringify()。
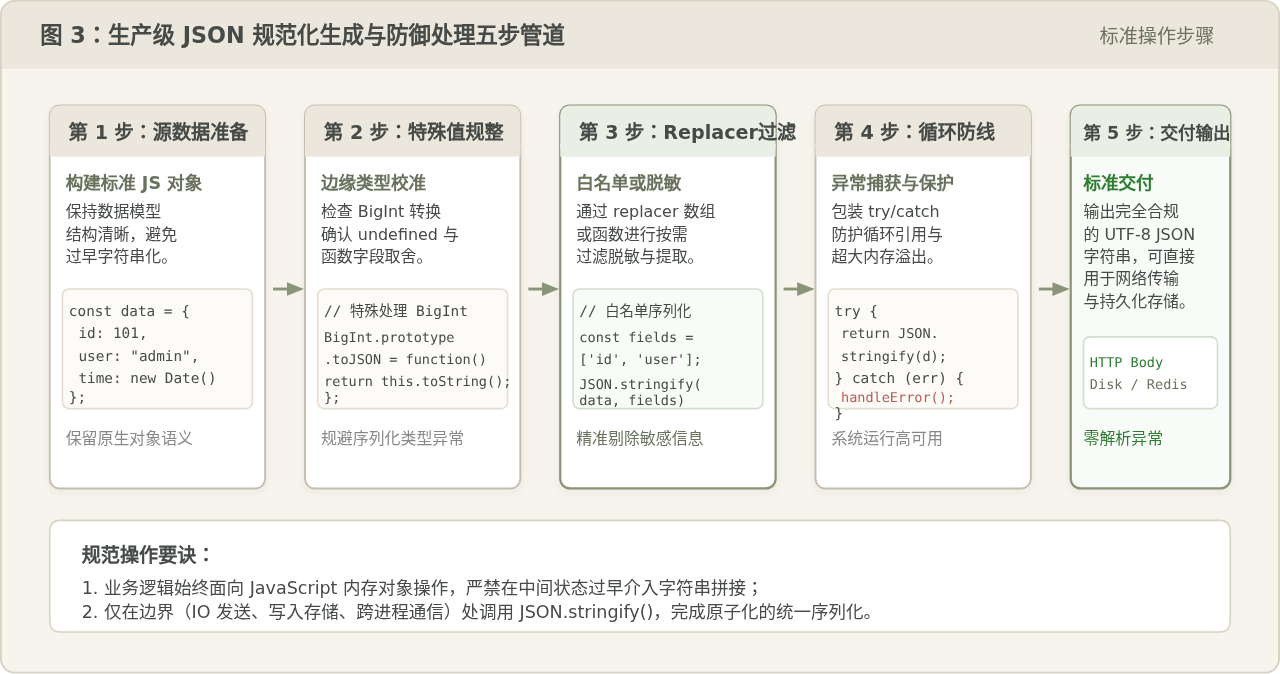
1. 熟练运用 Replacer 过滤器与脱敏
JSON.stringify() 的第二个参数 replacer 支持数组或函数形式,可以优雅地实现属性白名单过滤或敏感数据脱敏,而无需手动拼接修改原始对象:
// 方式 A:属性白名单(只序列化需要的字段)
const userProfile = { id: 101, username: 'alex', secretToken: 'xyz987', role: 'member' };
const safeJSON = JSON.stringify(userProfile, ['id', 'username', 'role']);
// 输出: '{"id":101,"username":"alex","role":"member"}'

// 方式 B:过滤与转换函数
const logPayload = JSON.stringify(userProfile, (key, value) => {
  if (key === 'secretToken') return '***'; // 自动脱敏
  return value;
});
2. 防御循环引用与异常安全封装
当数据对象中存在互相引用时,JSON.stringify() 会抛出 TypeError: Converting circular structure to JSON。在公共工具层中,建议将其安全封装:
// 通用安全序列化工具函数
function safeStringify(data, fallback = '{}') {
  try {
    return JSON.stringify(data);
  } catch (error) {
    console.error('JSON 序列化失败:', error.message);
    return fallback;
  }
}
七、决策总结与选型清单
为了在团队协同和架构评审中建立一致的标准,下表对各类处理方案进行了全景对比:
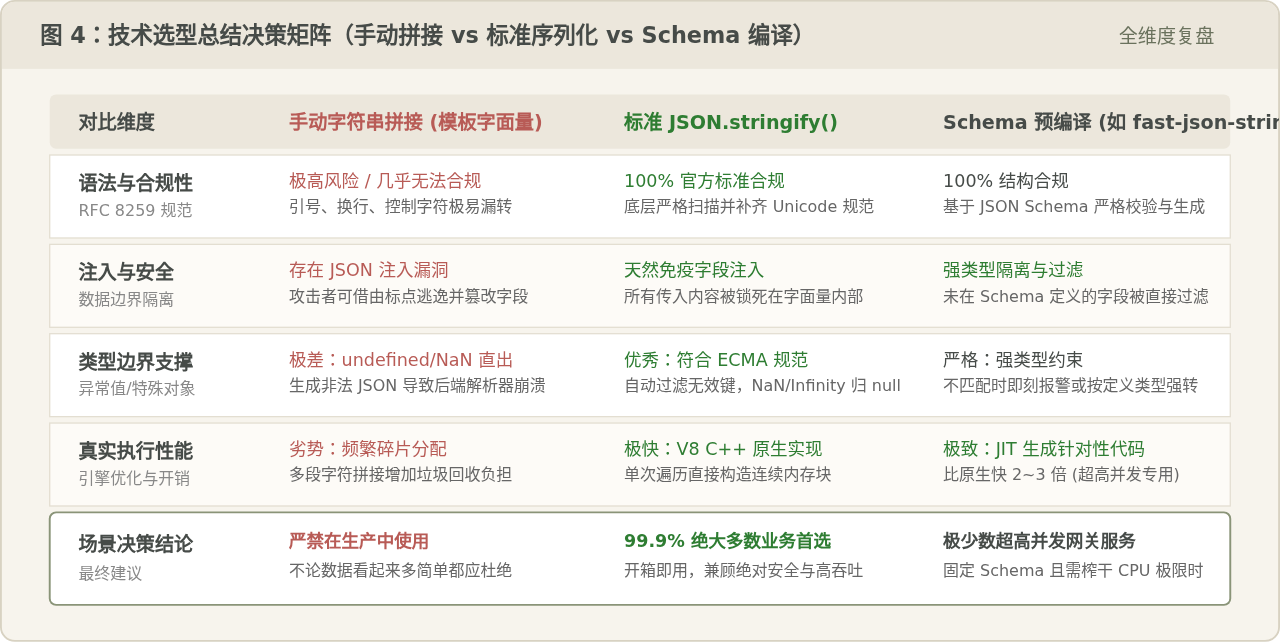
总结而言,在 JavaScript 中手动拼接 JSON 字符串是一种成本极高、隐患极大、收益为零的不良编码习惯。无论是出于语法鲁棒性、系统安全性还是长期维护性的考量,直接使用原生 JSON.stringify() 都是现代 JavaScript 开发中的唯一正确选择。
怎么使用 JavaScript import() 实现模块的条件加载
2026-11-05 14:44:45
前端防御XSS攻击:怎么防止恶意JS注入与CSP策略配置
2026-11-04 08:51:38
怎么解决 Turf.js 处理大规模 GeoJSON 数据的性能瓶颈
2026-11-03 23:22:19
代码混淆对JS执行性能的影响测试与分析
2026-11-03 22:25:37
怎么在JavaScript中使用js-coroutines库实现完整协程功能
2026-11-03 19:48:34
相关标签: