

JS 怎么实现忽略大小写的字符串前缀判断
深入讲解在 JavaScript 中实现忽略大小写字符串前缀判断的几种实用方案,包含基础 startsWith、高效 slice 切片比对、正则表达式转义以及国际化语言比对,并对比内存开销与适用场景。
String.prototype.startsWith() 是严格区分大小写的。实现忽略大小写判断最直接的方式是统一转为小写后再比较;但若考虑大字符串性能与内存占用,最优解是先按前缀长度截取子串再做小写比对。本文将系统讲解基础实现、切片优化、正则匹配与国际化等多种方案的运作机制及适用边界。
一、问题背景与核心解决路径
日常开发中,诸如 URL 协议头校验(http:// 与 HTTP://)、命令行参数解析、文件路径匹配等场景,均要求程序在比对字符串开头时能够容忍英文字母大小写差异。然而,JavaScript 规范中的字符串比对是基于 UTF-16 编码值的严格等值计算,大写字母 'H'(Unicode 72)与小写字母 'h'(Unicode 104)在底层并不相等。
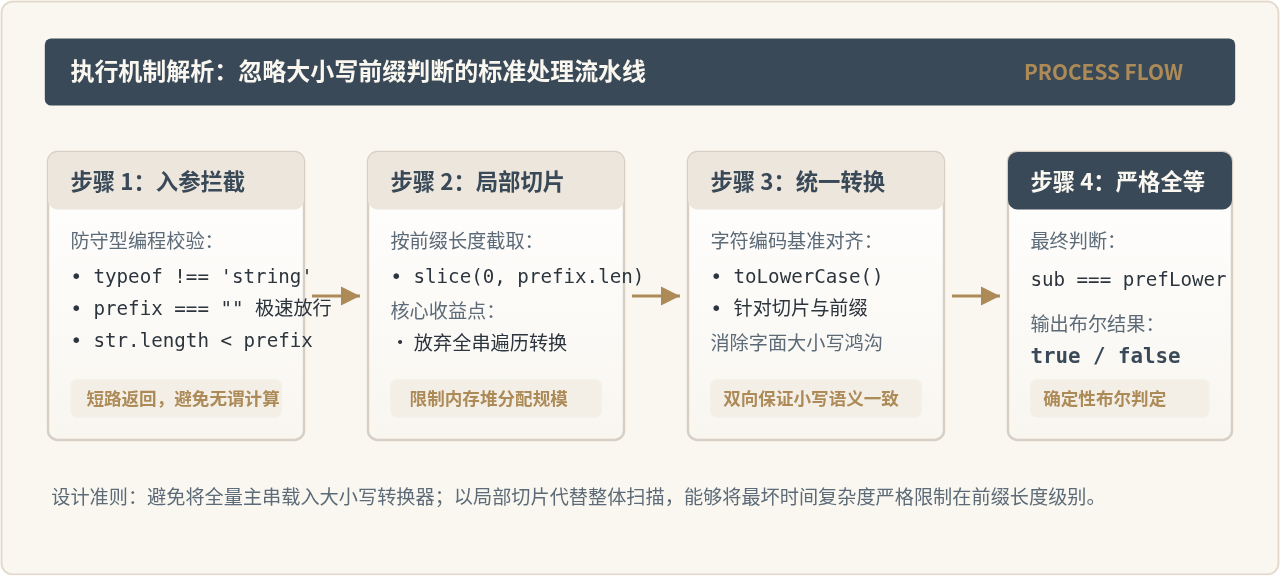
要解决这个问题,整体执行路径可拆解为三个步骤:前置条件拦截、字符大小写归一化(Normalize)以及前缀比对。为了确保函数在工业级应用中的鲁棒性,我们需要严密处理空字符串、类型边界以及长度溢出问题。
二、直觉解法:全量转换配合 startsWith
最符合直觉的代码写法是将待检测的主字符串和前缀均统一转换为小写(或大写),随后直接调用 ES6 的 String.prototype.startsWith():
// 方案 1:直觉型全量转换法
function startsWithIgnoreCaseBasic(str, prefix) {
  if (typeof str !== 'string' || typeof prefix !== 'string') {
    return false;
  }
  return str.toLowerCase().startsWith(prefix.toLowerCase());
}

// 示例调用与输出
console.log(startsWithIgnoreCaseBasic("HTTP://example.com", "http://")); // true
console.log(startsWithIgnoreCaseBasic("Authorization: Bearer token", "auth")); // true
console.log(startsWithIgnoreCaseBasic("Index.HTML", ".html"));            // false
这种写法语法极为简洁,对于短文本(例如百字节以内的表单字段、后缀名或路由参数)完全能够满足需求。
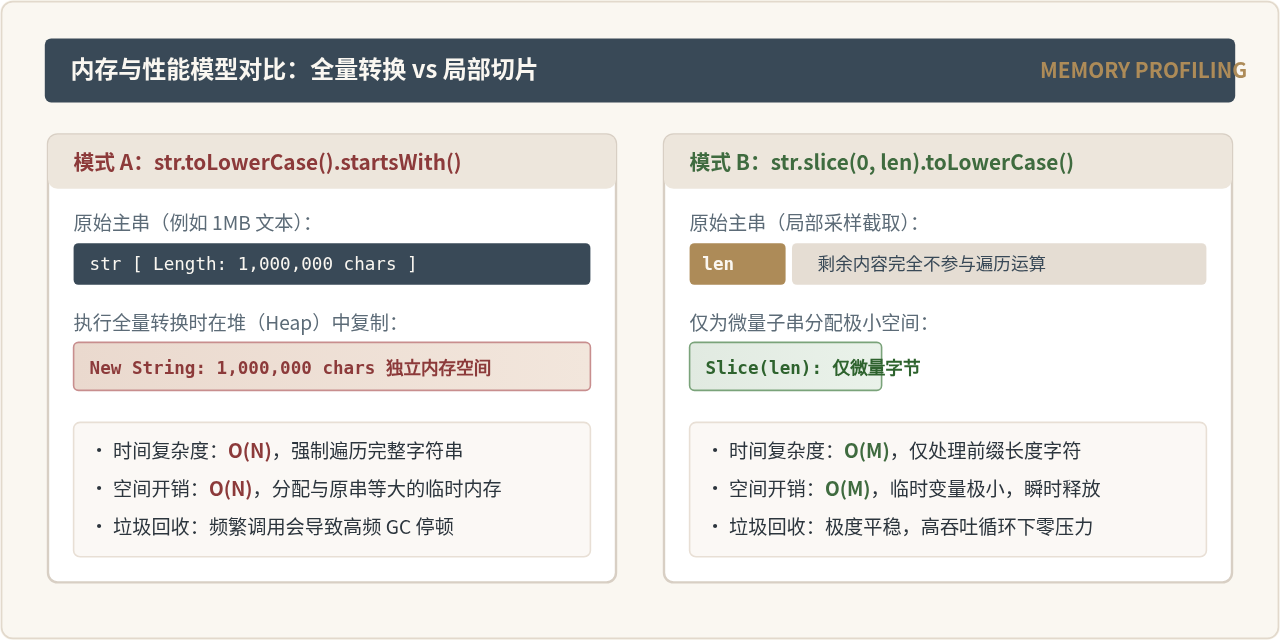
str.toLowerCase() 时,引擎必须分配一块全新的内存空间,并逐一遍历 str 的每个字符将其转成小写副本。如果主字符串 str 是一个多达数兆字节(MB)的长文本或日志文件,而我们仅仅需要比对开头 4 个字符(如 "http"),这种全量拷贝转换就会造成极大的 CPU 周期浪费与垃圾回收(GC)负担。
三、推荐方案:前缀按需截断(Slice + toLowerCase)
为了避免无谓的全量字符串复制,更合理的做法是按需截取(Slice First):仅从主字符串头部截取与前缀长度相同的那部分子串,再对截出的短子串进行大小写转换并比较。
/**
 * 忽略大小写判断主串是否以特定前缀起始(推荐工业方案)
 * @param {string} str 主字符串
 * @param {string} prefix 目标前缀
 * @returns {boolean}
 */
function startsWithIgnoreCase(str, prefix) {
  // 1. 类型安全防御
  if (typeof str !== 'string' || typeof prefix !== 'string') {
    return false;
  }

  // 2. 空前缀按原生 startsWith 行为返回 true
  if (prefix.length === 0) {
    return true;
  }

  // 3. 主串长度不足前缀长度时快速短路
  if (str.length < prefix.length) {
    return false;
  }

  // 4. 仅切取前缀等长字符进行小写等值比对
  const strPrefix = str.slice(0, prefix.length);
  return strPrefix.toLowerCase() === prefix.toLowerCase();
}

// 运行验证示例
console.log(startsWithIgnoreCase("README.md", "read"));      // true
console.log(startsWithIgnoreCase("Api/v1/users", "API/V1")); // true
console.log(startsWithIgnoreCase("short", "longerPrefix"));  // false
console.log(startsWithIgnoreCase("Anything", ""));          // true
在此方案中,若待测前缀长度为 M,主串总长为 N(其中 N >> M),str.slice(0, prefix.length) 仅需处理前 M 个字符,无论主串是 1KB 还是 10MB,转换开销恒定取决于 M 的长度。
四、正则解法:^ 锚点配合 i 修饰符及特殊字符转义
部分开发者偏好通过正则表达式处理字符串起始判断,结合 ^ 锚点与 i 忽略大小写修饰符即可达成目的。但此方式存在一个关键易错点:如果前缀包含正则表达式的保留字符,必须提前转义。
// 正则特殊元字符安全转义工具函数
function escapeRegExp(string) {
  return string.replace(/[.*+?^${}()|[\]\\]/g, '\\$&');
}

/**
 * 基于正则表达式的忽略大小写前缀判断
 */
function startsWithIgnoreCaseRegex(str, prefix) {
  if (typeof str !== 'string' || typeof prefix !== 'string') {
    return false;
  }
  // 空前缀恒为真
  if (prefix === '') return true;

  // 必须对 prefix 中可能存在的特殊字符转义,否则如 prefix="[v1]" 会导致语法错误
  const safePrefix = escapeRegExp(prefix);
  const regex = new RegExp('^' + safePrefix, 'i');
  return regex.test(str);
}

// 示例:包含正则元字符的前缀匹配
console.log(startsWithIgnoreCaseRegex("[INFO] Server started", "[info]")); // true
console.log(startsWithIgnoreCaseRegex("$100.00 dollars", "$100"));        // true
如果没有 escapeRegExp 处理,当传入形如 "$"、"."、"(" 或未闭合的 "[" 时,构造 new RegExp() 将会抛出 SyntaxError 运行时异常,或产生非预期的正则逻辑匹配。此外,在每次调用中动态创建和编译正则表达式对象也会带来不小的开销。
五、特殊边界:多语言与区域文化感知(Intl.Collator)
在标准 ASCII 字母表(A-Z)范围内,toLowerCase() 能够良好运转。但在 Unicode 复杂语系中,忽略大小写往往还伴随着重音符号(Accent)或特定语言的大小写映射规则:
- 土耳其语:小写字母
"i"的大写是带点的"İ",而非标准 ASCII 的"I";不带点的小写"ı"对应大写"I"。 - 德语:尖音
"ß"在转为大写时通常表现为"SS"。 - 变音符号:例如西班牙语或法语中的
"e"与"é"是否需要视为等价。
针对此类跨国语言需求,应采用 ECMAScript 国际化 API Intl.Collator 或 String.prototype.localeCompare,设置 sensitivity: 'accent'(忽略大小写但保留重音)或 sensitivity: 'base'(同时忽略大小写和重音):
/**
 * 语言敏感型的忽略大小写前缀比对
 * @param {string} str 主字符串
 * @param {string} prefix 目标前缀
 * @param {string} [locale='en'] 语言区域标识
 */
function startsWithIgnoreCaseLocale(str, prefix, locale = 'en') {
  if (typeof str !== 'string' || typeof prefix !== 'string') return false;
  if (prefix === '') return true;
  if (str.length < prefix.length) return false;

  // 截取前缀等长字符
  const chunk = str.slice(0, prefix.length);

  // sensitivity: 'accent' 忽略大小写但保留重音
  // sensitivity: 'base' 忽略大小写且忽略重音
  return chunk.localeCompare(prefix, locale, { sensitivity: 'accent' }) === 0;
}

// 示例运行
console.log(startsWithIgnoreCaseLocale("İstanbul", "ist", "tr")); // true (土耳其语特定大小写识别)
六、生产环境边界防护与选型决策
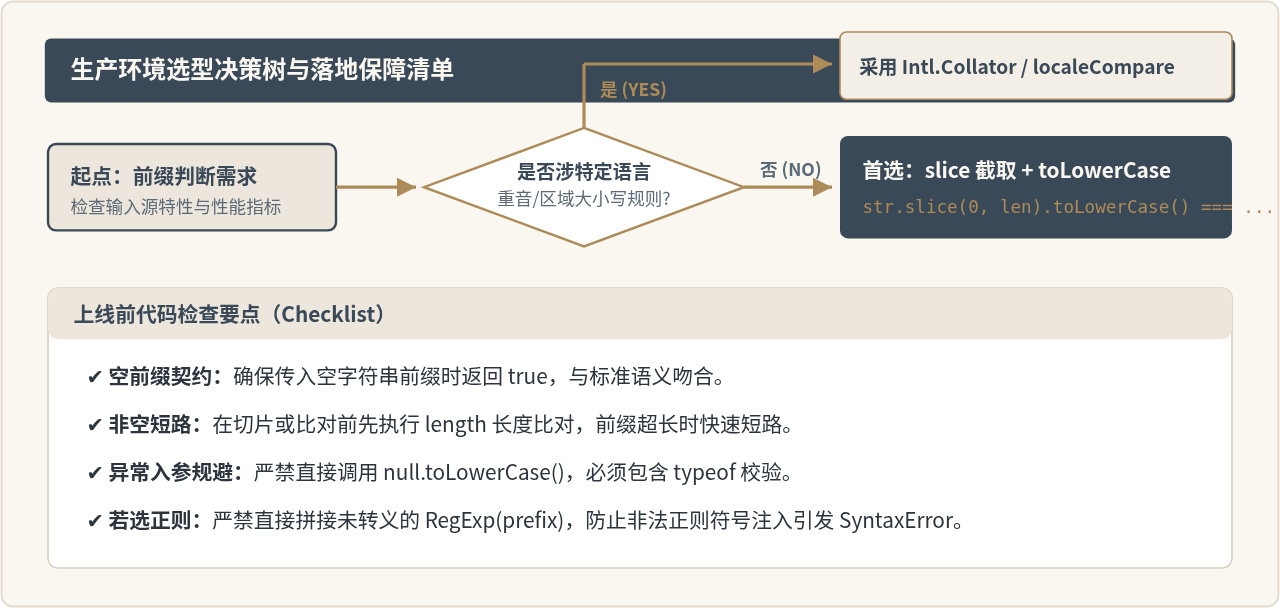
编写健壮的前缀判断函数时,需要特别关注以下常见边界情况,防止线上抛错:
- 非字符串传参处理:对于
null、undefined、数字或对象,原生startsWith会尝试通过ToString隐式转换或直接报错。明确使用typeof === 'string'做类型收窄,能保证函数纯净无副作用。 - 空前缀(Empty String):根据 ECMAScript 规范定义,任何字符串都以空字符串开头(
"abc".startsWith("") === true)。自定义逻辑应与规范保持行为一致。 - 长度溢出早退:在执行任何截取或小写转换之前,加入
str.length < prefix.length判断直接返回false,能省去一切字符运算。
七、综合对比与总结
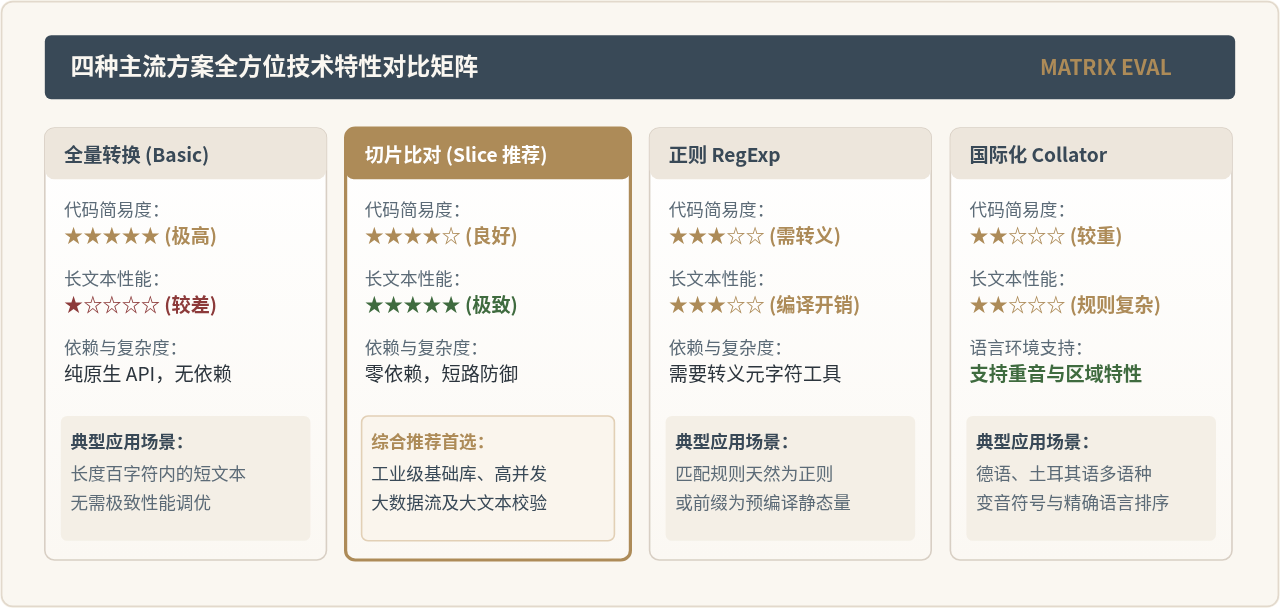
| 实现方式 | 核心 API | 时间复杂度 | 额外内存分配 | 综合适用场景 |
|---|---|---|---|---|
| 切片局部转换(推荐) | slice + toLowerCase |
O(前缀长度) | 仅前缀长度的小字符串 | 通用生产环境、长文本匹配、高频调用函数 |
| 全量直接转换 | toLowerCase + startsWith |
O(主串长度) | 与原主串等大的副本 | 百字符内短文本、简单脚本原型快速编写 |
| 正则表达式 | escapeRegExp + RegExp('^...', 'i') |
O(正则编译 + 匹配) | RegExp 对象创建与捕获开销 | 规则天然为正则、或前缀为预先编译好的静态常量 |
| 国际化排序器 | Intl.Collator / localeCompare |
较高(视区域规则而定) | 排序器配置上下文开销 | 多语言特定大小写、重音符号敏感性特殊业务 |
总体而言,在 JavaScript 中处理忽略大小写的前缀匹配时,“先截断后转换”(str.slice(0, prefix.length).toLowerCase() === prefix.toLowerCase())是兼具执行性能、内存安全与易读性的最佳通用解。理解字符串不可变性带来的内存分配机制,有助于在业务规模扩展时编写出更稳健、更高效的前端与 Node.js 服务端代码。
配置 Matter.js 睡眠机制以优化静止物体性能
2026-11-05 15:43:12
JavaScript console.log高级用法:用table、group和time优化调试输出
2026-11-05 08:04:56
JS变量中存储HTML代码时的特殊字符转义方法
2026-11-04 19:04:09
JS怎么安全转换带千分位或货币符号的字符串为数字
2026-11-04 11:54:14
推荐几款稳定的在线JS反混淆工具,支持Obfuscator.io解密
2026-11-04 08:16:21







