JS对象数组怎么去重?处理引用类型的难点与方案
深入解析JavaScript对象数组去重中的引用类型比较机制,剖析new Set失效原因,并提供基于唯一键(Map/Set)、排序序列化及深度相等比对的完整实战方案与性能决策指南。
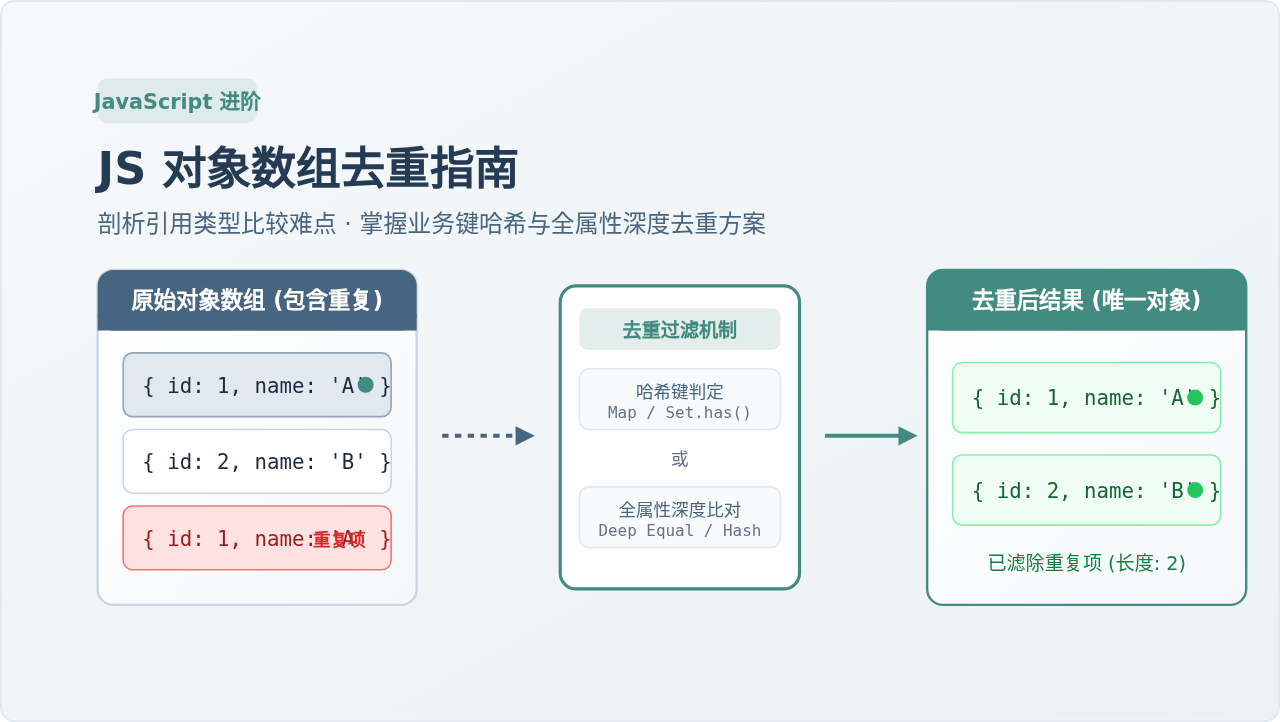
[...new Set(arr)] 即可完成,但当处理对象数组时,Set 却会完全“失灵”。这是由 JavaScript 的引用数据类型内存模型决定的。针对对象数组去重,核心取决于业务场景:是以“指定唯一标识(如 id)”为排重依据,还是需要“所有属性完全深度一致”才视为重复。本文将从底层引用对比机制展开,逐一解析并给出高可用实操方案与选型策略。
一、为什么常规方法对对象数组无效?
初学者在对对象数组进行去重时,往往会直接套用基础类型的处理方法,例如使用 Set 构造函数:
const list = [
  { id: 1, name: 'Alice' },
  { id: 1, name: 'Alice' }
];

const uniqueList = [...new Set(list)];
console.log(uniqueList.length); // 结果仍然是 2!并没有实现去重
这段代码执行后,数组长度依然是 2,两个看似一模一样的对象都被保留了下来。要理解其中的原因,必须剖析 JavaScript 内部的值比较机制以及引用类型的存储结构。
1. 引用类型与堆栈内存模型
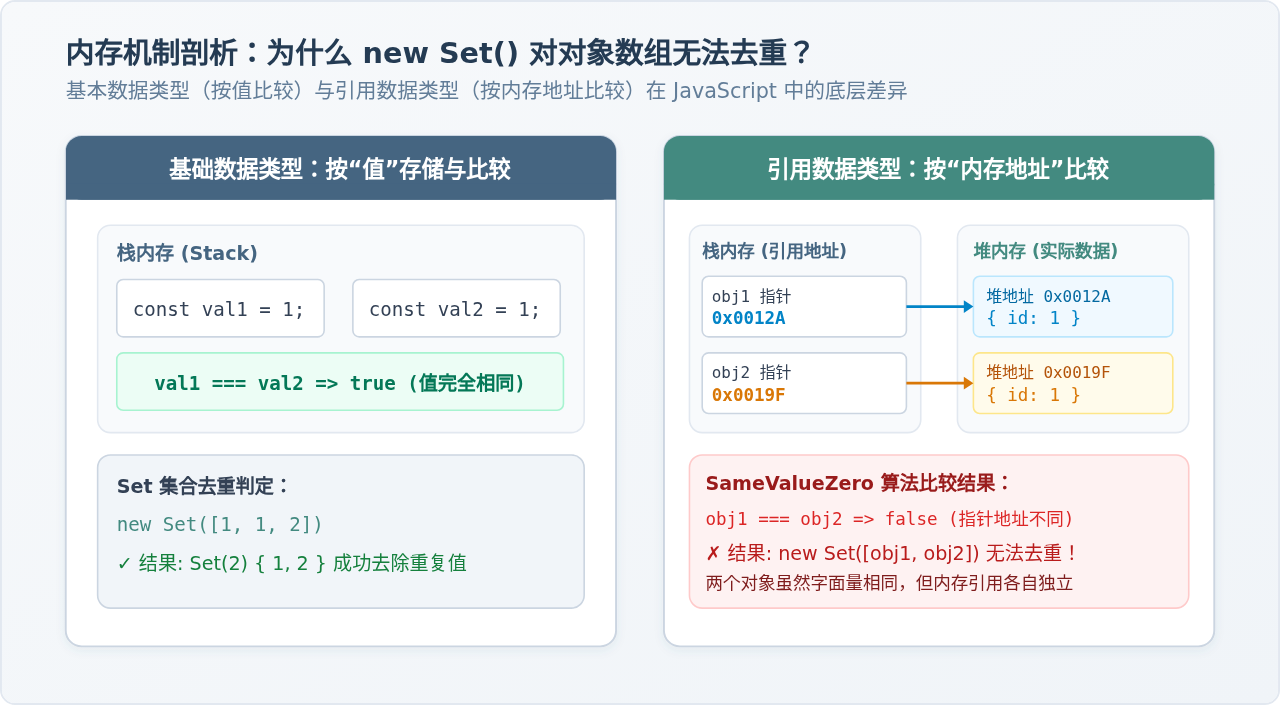
在 JavaScript 中,字符串、数字、布尔值等基本类型直接保存在栈内存(Stack)中,变量保存的就是值本身,因此 1 === 1 为 true。但对象(Object)、数组(Array)属于引用类型:对象的内容保存在堆内存(Heap)中,而在栈内存的变量中仅仅存储着该对象在堆内存中的内存引用地址(指针)。
字面量声明两个结构相同的对象时,JavaScript 引擎会在堆内存中开辟两块独立的存储空间,并分别生成不同的地址指针。即使内部属性完全一致,两个变量持有的地址指针也是不同的。
2. Set 的 SameValueZero 比对算法
Set 数据结构判定元素是否重复时使用的是 SameValueZero 比较算法(行为与全等操作符 === 基本一致,区别仅在于认为 NaN 等于 NaN)。当向 Set 中传入对象时,比较的是它们在栈内存中的引用地址,而不是对象内部的属性键值。因为两个对象的堆内存地址不同,SameValueZero 自然判定它们是互不相同的独立元素,无法过滤。
二、方案一:基于指定唯一键(Key)去重(推荐度最高)
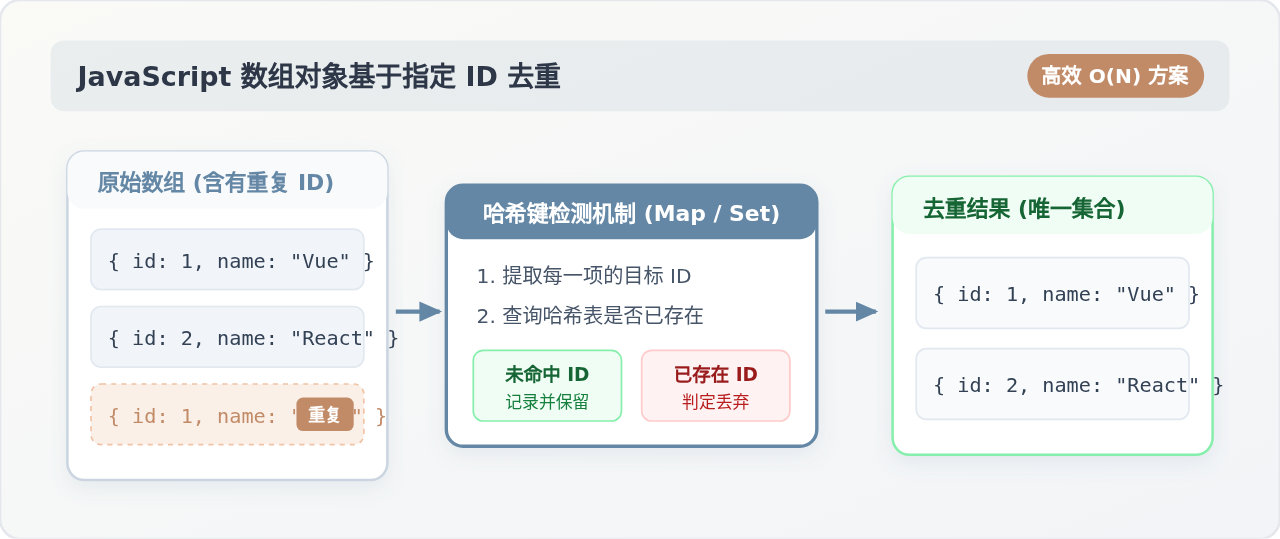
在绝大多数前端业务中(如用户列表、表格数据、分页加载合并),对象通常具备一个明确的业务唯一标识符,例如 id、code、userId 或 uuid。此时对象去重的本质并不是比较每一个属性,而是保证指定键在数组中唯一。
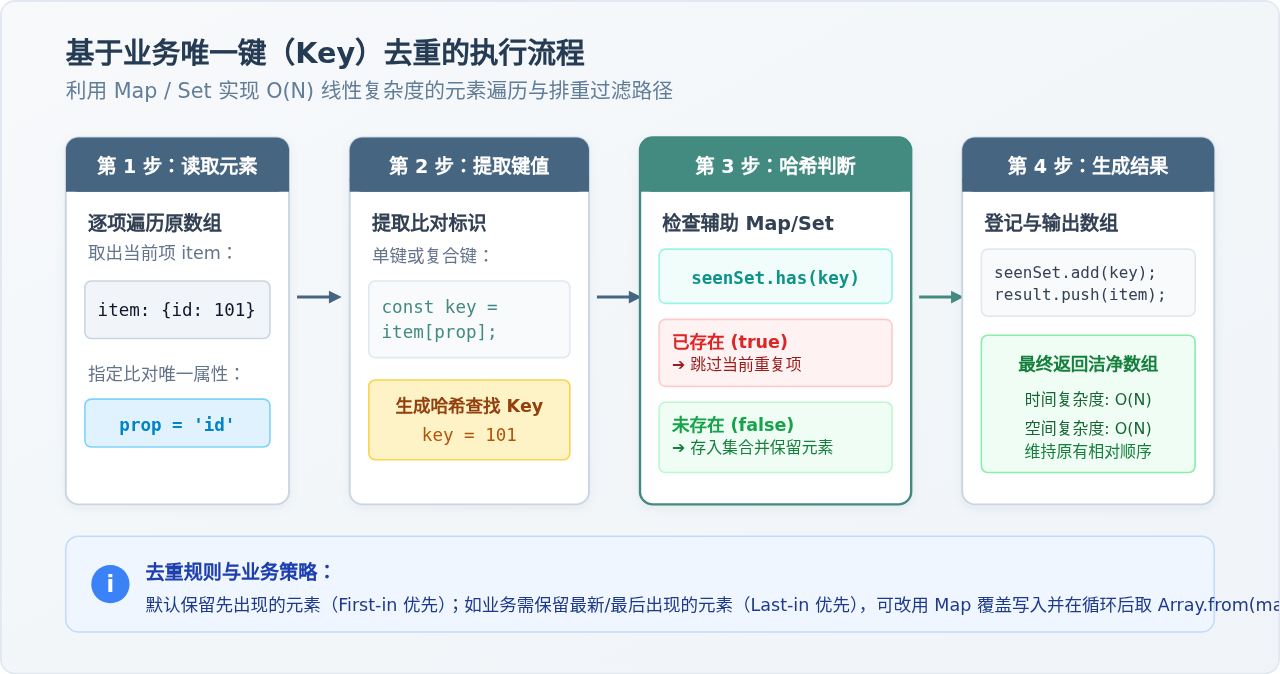
1. 使用 Map / Set 配合 filter 实现(保留首项)
借助 Map 或 Set 的哈希查找特性,可以在遍历数组时以 O(1) 的时间复杂度快速判断某个键是否已经出现过。结合 Array.prototype.filter,可以在保持数组原相对顺序的同时,完成高效去重。
/**
 * 根据指定属性对对象数组进行去重(保留首次出现的项)
 * @param {Array<Object>} arr 待去重的对象数组
 * @param {string} prop 作为唯一判断依据的属性名
 * @returns {Array<Object>} 去重后的新数组
 */
function uniqueByProp(arr, prop) {
  if (!Array.isArray(arr)) return [];
  const seen = new Set();
  return arr.filter(item => {
    if (!item || typeof item !== 'object') return false;
    const key = item[prop];
    if (seen.has(key)) {
      return false; // 已经存在,滤除
    }
    seen.add(key); // 首次出现,记录并保留
    return true;
  });
}

// 运行测试:
const users = [
  { id: 101, name: '张三', role: 'developer' },
  { id: 102, name: '李四', role: 'designer' },
  { id: 101, name: '张三(更新)', role: 'leader' }
];

const result = uniqueByProp(users, 'id');
console.log(result);
// 结果:
// [
//   { id: 101, name: '张三', role: 'developer' },
//   { id: 102, name: '李四', role: 'designer' }
// ]
2. 保留末项策略:使用 Map 覆盖赋值
在某些场景下(例如实时消息流或状态同步),后出现的对象往往代表最新的数据状态,业务需求要求保留最后出现的项。这时可以使用 Map 以后出现的键值覆盖先出现的键值:
/**
 * 根据指定属性去重,保留最后出现的最新项
 */
function uniqueByPropKeepLast(arr, prop) {
  const map = new Map();
  for (const item of arr) {
    if (item && typeof item === 'object') {
      map.set(item[prop], item); // 后续相同 key 会直接覆盖前者
    }
  }
  return Array.from(map.values());
}

const latestUsers = uniqueByPropKeepLast(users, 'id');
console.log(latestUsers);
// 输出中保留的是 id: 101 的 '张三(更新)'
3. 复合唯一键的处理(Composite Keys)
如果业务中单一字段无法唯一确定一条记录,而是由多个字段联合决定(例如 tenantId + userId,或者 skuId + specId),可以通过拼接复合标识字符串来作为去重键:
function uniqueByCompositeKeys(arr, props) {
  const seen = new Set();
  return arr.filter(item => {
    // 拼接所有联合键,并用特殊分隔符避免歧义
    const compositeKey = props.map(p => item[p]).join('::');
    if (seen.has(compositeKey)) return false;
    seen.add(compositeKey);
    return true;
  });
}

// 示例:按部门与员工编号联合去重
const staff = [
  { dept: 'Dev', empId: 1, name: 'A' },
  { dept: 'Ops', empId: 1, name: 'B' },
  { dept: 'Dev', empId: 1, name: 'A_dup' }
];
console.log(uniqueByCompositeKeys(staff, ['dept', 'empId']));
// 成功区分 Dev::1 与 Ops::1,仅过滤 Dev::1 的重复项Map / Set 的键值去重方案,遍历一次数组为 O(N),每次哈希查找与写入均为 O(1)。整体时间复杂度为 O(N),空间复杂度为 O(N)。在面对万级以上的数据集时,执行耗时均在数毫秒级别,是绝大多数业务系统的首选方案。
三、方案二:无唯一键时的全属性去重与序列化陷阱
有时对象数据并没有 id 等主键,只有当两个对象的所有属性和值都完全相等时才视为重复项。很多开发者会想到使用 JSON.stringify 进行字符串序列化后再放入 Set:
// 存在隐患的简易做法:
const rawList = [
  { a: 1, b: 2 },
  { b: 2, a: 1 } // 属性书写顺序颠倒
];

const naiveResult = [...new Set(rawList.map(item => JSON.stringify(item)))]
  .map(str => JSON.parse(str));

console.log(naiveResult.length); // 结果是 2!并未去除重复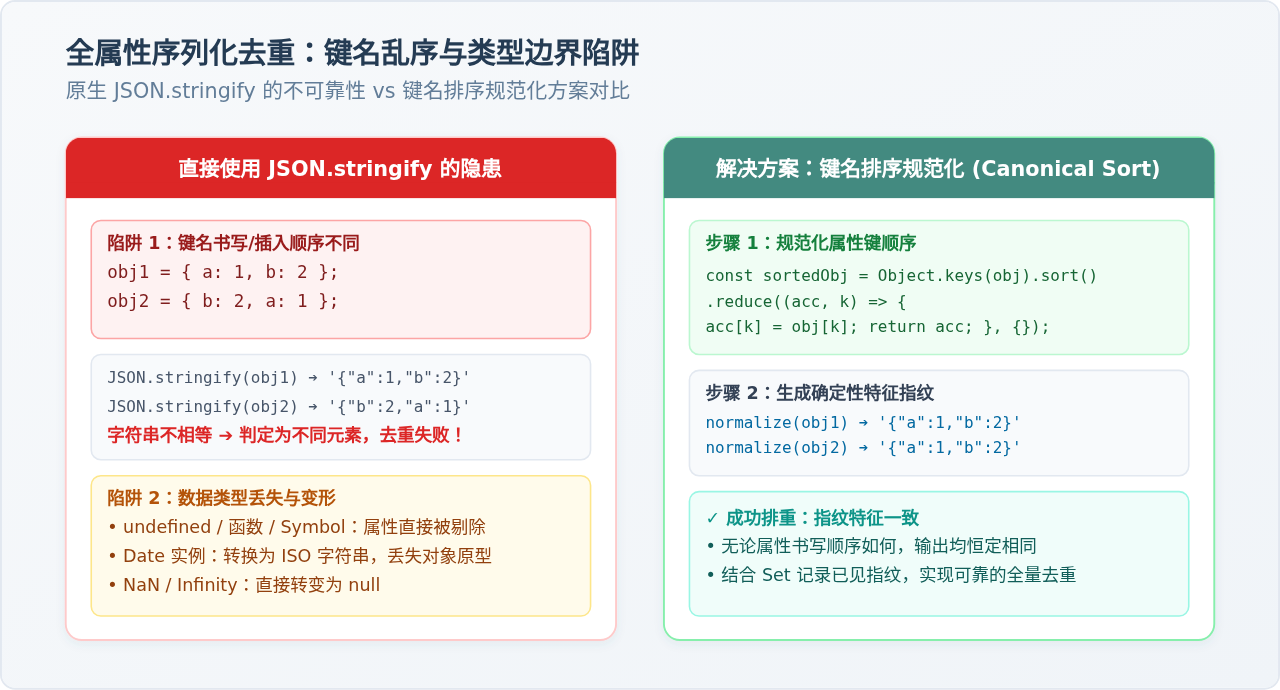
1. JSON.stringify 的天然缺陷
直接使用 JSON.stringify 存在两大致命短板:
- 属性顺序敏感:JavaScript 对象的属性在序列化时依赖键的枚举顺序。
{ a: 1, b: 2 }序列化为'{"a":1,"b":2}',而{ b: 2, a: 1 }序列化为'{"b":2,"a":1}'。内容相同的对象因为字符串不一致而无法被识别为重复。 - 数据类型失真:
JSON.stringify遇到undefined、函数或Symbol时会自动忽略该键;Date实例会被转为 ISO 字符串而丢失日期对象原型;NaN和Infinity会被转为null;存在循环引用时还会直接抛出TypeError。
2. 改进方案:属性排序规范化序列化
如果数据确属纯数据对象(无函数、无特殊引用),但可能存在属性键乱序,可以在序列化前对对象的键名进行稳定排序:
/**
 * 递归规范化对象属性键名,确保相同结构生成完全一致的字符串指纹
 */
function canonicalStringify(value) {
  if (value === null || typeof value !== 'object') {
    return JSON.stringify(value);
  }

  if (Array.isArray(value)) {
    return '[' + value.map(canonicalStringify).join(',') + ']';
  }

  // 提取键并按字母升序排序
  const sortedKeys = Object.keys(value).sort();
  const pairs = sortedKeys.map(k => {
    return JSON.stringify(k) + ':' + canonicalStringify(value[k]);
  });
  return '{' + pairs.join(',') + '}';
}

function uniqueByFullContent(arr) {
  const seen = new Set();
  const result = [];

  for (const item of arr) {
    const hash = canonicalStringify(item);
    if (!seen.has(hash)) {
      seen.add(hash);
      result.push(item);
    }
  }
  return result;
}

// 验证乱序场景:
const disordered = [
  { id: 1, name: 'Alice', extra: { x: 10, y: 20 } },
  { name: 'Alice', id: 1, extra: { y: 20, x: 10 } }
];
console.log(uniqueByFullContent(disordered).length); // 成功去重,输出长度 1
四、方案三:全字段深度比较(Deep Equal 比对法)
当对象结构复杂,包含 Date、RegExp、特殊值或者无法直接进行序列化的属性时,最严谨的做法是编写深度相等判断函数(类似于 Lodash 的 isEqual),结合数组归并实现去重。
/**
 * 深度判断两个实体在内容上是否严格相等
 */
function isDeepEqual(objA, objB) {
  if (objA === objB) return true;

  if (typeof objA !== 'object' || objA === null ||
      typeof objB !== 'object' || objB === null) {
    return false;
  }

  // 处理特殊对象类型
  if (objA instanceof Date && objB instanceof Date) {
    return objA.getTime() === objB.getTime();
  }
  if (objA instanceof RegExp && objB instanceof RegExp) {
    return objA.toString() === objB.toString();
  }

  const keysA = Object.keys(objA);
  const keysB = Object.keys(objB);

  if (keysA.length !== keysB.length) return false;

  for (const key of keysA) {
    if (!Object.prototype.hasOwnProperty.call(objB, key)) return false;
    if (!isDeepEqual(objA[key], objB[key])) return false;
  }

  return true;
}

/**
 * 基于深度比对的对象数组去重
 */
function uniqueByDeepEqual(arr) {
  const result = [];
  for (const item of arr) {
    const isDuplicate = result.some(existing => isDeepEqual(existing, item));
    if (!isDuplicate) {
      result.push(item);
    }
  }
  return result;
}五、方案对比与选型决策指南
不同的去重方案在运行性能、内存开销以及业务普适性上各有侧重。开发者应根据具体数据特征进行合理选型:
| 方案分类 | 去重依据 | 时间复杂度 | 空间复杂度 | 适用场景与局限 |
|---|---|---|---|---|
| Map / Set 键值法 | 指定业务字段(如 id) | O(N) | O(N) | 业务首选。性能极高,支持保留首项或覆盖末项。前提是对象存在主键。 |
| 规范化序列化法 | 排序后的 JSON 字符串 | O(N · K log K) | O(N) | 适用于无唯一键的纯数据对象。无法处理函数、Symbol 和循环引用。 |
| 深度相等比较法 | 全属性递归深比对 | O(N²) | O(1) 辅助 | 结果最精确,支持日期与正则等复杂类型。但在大数据量下性能较差。 |
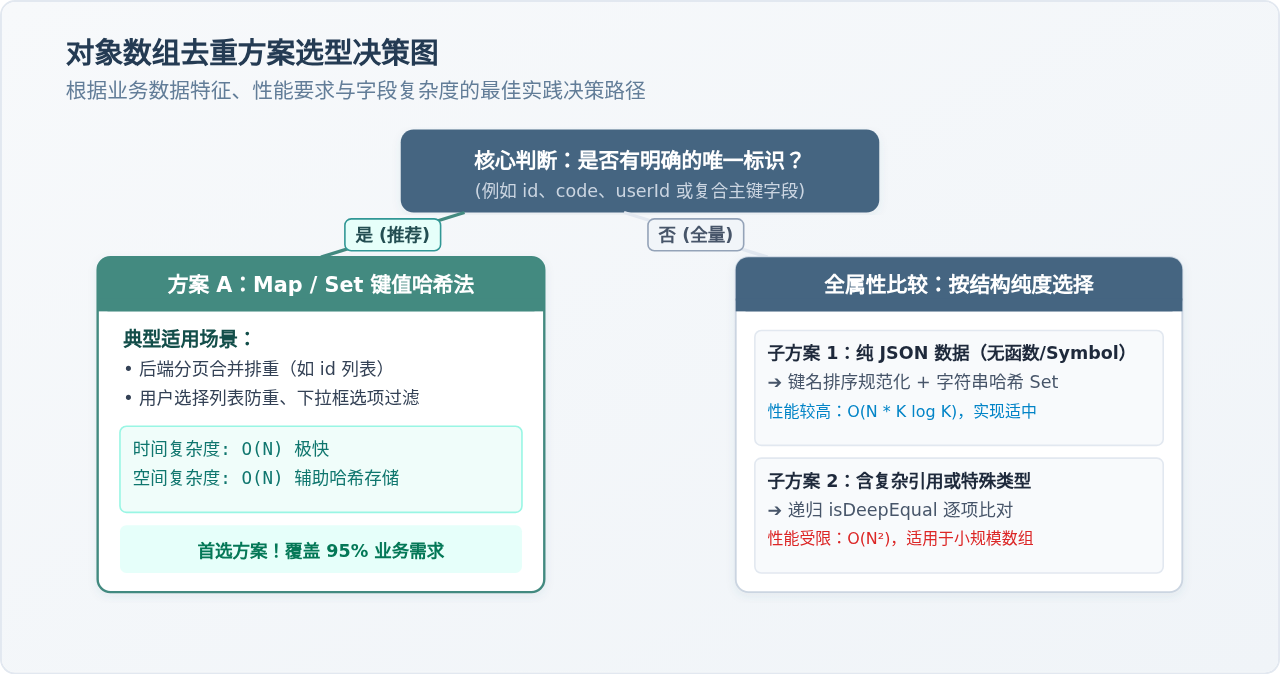
总结操作建议:
- 优先寻找业务主键:无论前端还是后端数据,尽量约定或提取
id、code等唯一字段,直接使用uniqueByProp处理,代码简洁且执行效率最高。 - 慎用未经处理的 JSON.stringify:如果必须进行全量属性比对,务必先通过
Object.keys().sort()规整属性顺序,避免由于键声明顺序不同而产生假阳性重复遗漏。 - 关注数据规模与性能边界:当处理超过数千条数据且无唯一键时,尽量避免直接使用 O(N²) 的深度比对;可考虑向后端寻求数据唯一标识支持,或在数据入库前就做好防重处理。
什么时候该用JS构造器:与工厂模式、字面量的选择对比
2026-11-05 16:18:22
推荐几款轻量级JS照片墙开源库及对比
2026-11-05 15:56:19
JavaScript递归写法有哪些常见陷阱及避免方法
2026-11-05 14:53:38
JS数组浅拷贝与深拷贝怎么选?场景与方法总结
2026-11-05 14:41:02
p5.js 中 setup() 和 draw() 函数的执行机制详解
2026-11-05 12:32:38
相关标签: