JS数组对象怎么根据指定ID字段去重
详细讲解在JavaScript中对包含对象的数组按指定ID字段去重的多种高效方法,涵盖保留首次出现与保留末次出现的不同场景,剖析O(N)哈希算法原理并提供生产环境通用封装函数。
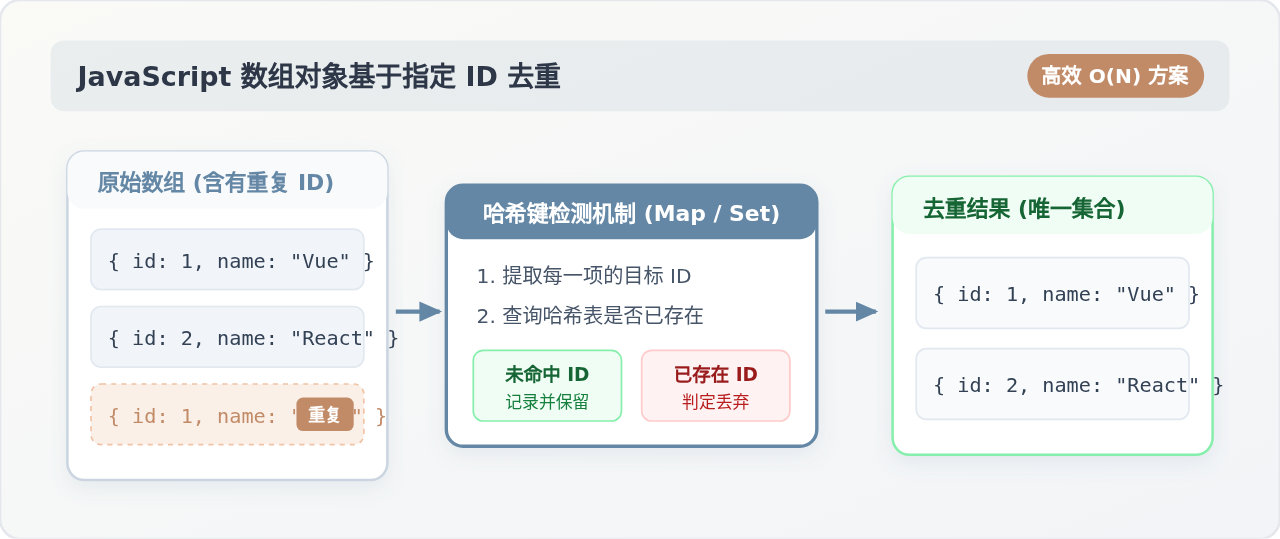
id 字段去重,最高效且推荐的解法是借助 Map 或 Set 哈希结构辅助过滤。通过哈希表可以在 \(O(1)\) 时间内检索唯一键,使得整组去重能在单次遍历中以 \(O(N)\) 时间复杂度 完成。本文将依次剖析“保留首项”、“保留末项”两种业务场景的具体实现与通用封装。
一、为什么基本数据类型的去重方式不能直接套用
在初学 JavaScript 时,许多人习惯使用 [...new Set(arr)] 去除基础类型(如数字、字符串)的重复项。然而,对于数组对象(如 [{ id: 1, name: "A" }, { id: 1, name: "B" }]),由于每个对象在内存中分配了不同的堆内存地址,引用互不相同,Set 会判定它们为不同元素,因而直接使用 new Set(arr) 无法达到按属性判重的目的。
因此,对象数组去重必须明确提取对象的某一个属性作为唯一键(例如 id),并记录该属性值的命中状态。
二、主流方案:Map 与 filter 结合(保留首次出现的数据)
在常规数据展示与分页合并场景中,通常希望保留列表最先出现的项,并过滤掉后续遇到的重复项。使用 Array.prototype.filter() 搭配一个用于记录已遍历 ID 的 Map,是现代前端开发中最标准且易读的写法。
1. 完整实现代码
const list = [
  { id: 101, name: "张三", department: "研发部" },
  { id: 102, name: "李四", department: "运营部" },
  { id: 101, name: "张三旧档案", department: "已离职" },
  { id: 103, name: "王五", department: "测试部" }
];

// 使用 Map 与 filter 进行去重
function deduplicateById(arr) {
  const seen = new Map();
  return arr.filter(item => {
    if (!item || !item.id) return false;
    if (seen.has(item.id)) {
      return false; // 已经存在,过滤丢弃
    }
    seen.set(item.id, true); // 记录首次出现
    return true; // 保留
  });
}

const result = deduplicateById(list);
console.log(result);
// 示例输出:包含 id 为 101(张三)、102(李四)、103(王五) 的 3 个对象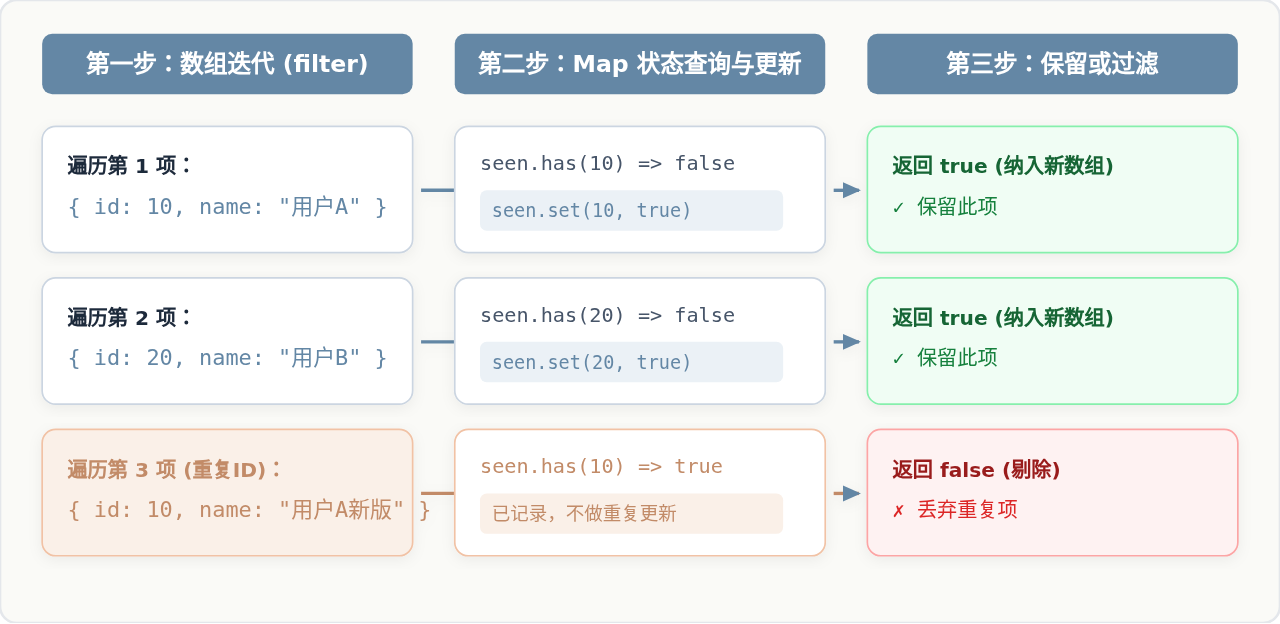
2. 为什么推荐该方案
Array.prototype.filter() 不会改变原始输入数组,符合函数式编程的不可变性原则。同时,seen.has() 与 seen.set() 在 Map 内部均基于哈希散列实现,平均操作耗时为 \(O(1)\),整个数组仅遍历一次,即使处理数万条记录也能在数毫秒内完成。
三、单行极简方案:利用 Map 键覆盖特性(保留最后出现的数据)
在某些业务场景下(如表单实时草稿合并、日志状态覆盖),后一条数据往往代表“最新的修改结果”。此时我们需要保留最后一次出现的对象,直接利用 ES6 Map 的键覆盖机制只需单行代码。
1. 完整实现代码
const rawData = [
  { id: 1, title: "草稿V1", status: "draft" },
  { id: 2, title: "文章2", status: "published" },
  { id: 1, title: "正式发布版", status: "published" }
];

// 单行简洁写法:将每个元素的 [id, item] 作为键值对存入 Map,后出现的直接覆盖前面项
const latestList = Array.from(
  new Map(rawData.map(item => [item.id, item])).values()
);

console.log(latestList);
// 示例输出结果中,id 为 1 的对象是 title: "正式发布版"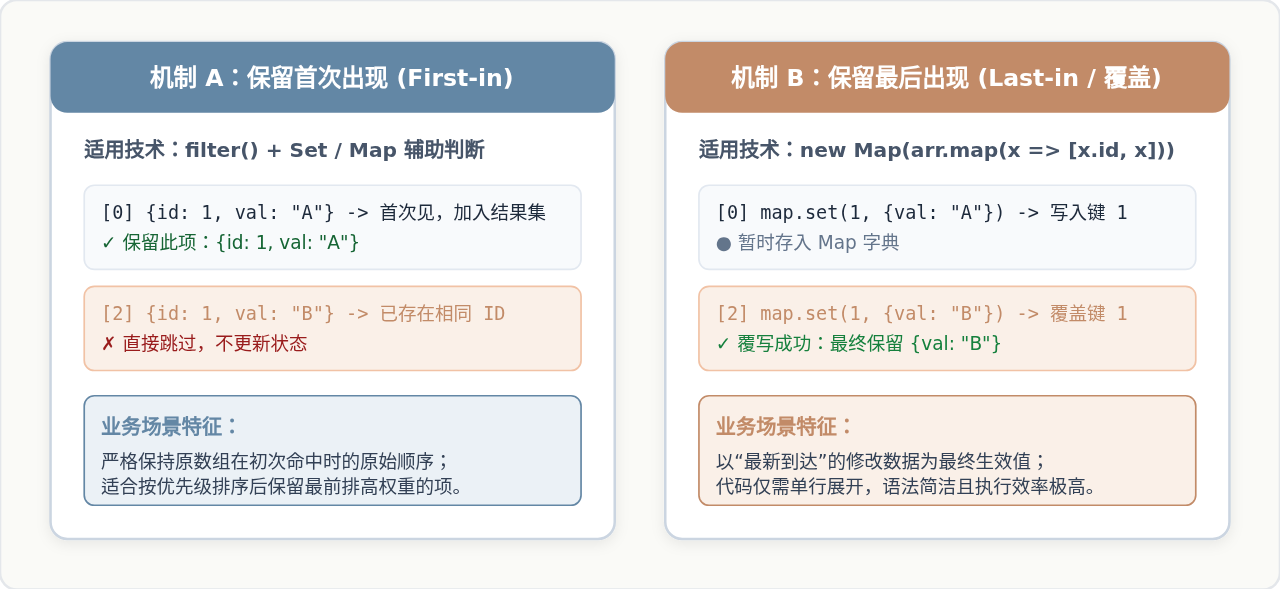
2. 运作原理剖析
rawData.map(item => [item.id, item]) 将对象数组映射为由二元数组组成的键值对集合。随后传入 new Map() 构造函数时,Map 内部会严格保证键的唯一性;若遇到相同的 item.id,后存入的对象会悄然覆盖先前的对象。最后通过 Map.prototype.values() 取出所有去重后的值并转为普通数组。
四、工程级通用封装函数
在实际项目开发中,不能把判重逻辑写死在单一的 id 字段上,有时可能是 userId、code 或 uuid。我们可以封装一个支持任意指定字段、且支持指定保留首项还是末项的通用工具函数。
/**
 * 对象数组根据指定字段去重
 * @param {Array} arr - 待处理的原数组
 * @param {string} key - 用于去重的唯一键字段名(如 'id'、'code')
 * @param {'first'|'last'} [strategy='first'] - 保留首项还是保留末项
 * @returns {Array} 去重后的全新数组
 */
function uniqueByField(arr, key, strategy = 'first') {
  if (!Array.isArray(arr) || !key) {
    return [];
  }

  if (strategy === 'last') {
    const map = new Map();
    for (const item of arr) {
      if (item && Object.prototype.hasOwnProperty.call(item, key)) {
        map.set(item[key], item);
      }
    }
    return Array.from(map.values());
  }

  // 默认策略:保留首次出现
  const seen = new Set();
  return arr.filter(item => {
    if (!item || !Object.prototype.hasOwnProperty.call(item, key)) {
      return false;
    }
    const val = item[key];
    if (seen.has(val)) {
      return false;
    }
    seen.add(val);
    return true;
  });
}

// 使用示例:
const testList = [
  { code: "A", score: 90 },
  { code: "B", score: 85 },
  { code: "A", score: 95 }
];

console.log(uniqueByField(testList, "code", "first")); // 保留 score: 90
console.log(uniqueByField(testList, "code", "last"));  // 保留 score: 95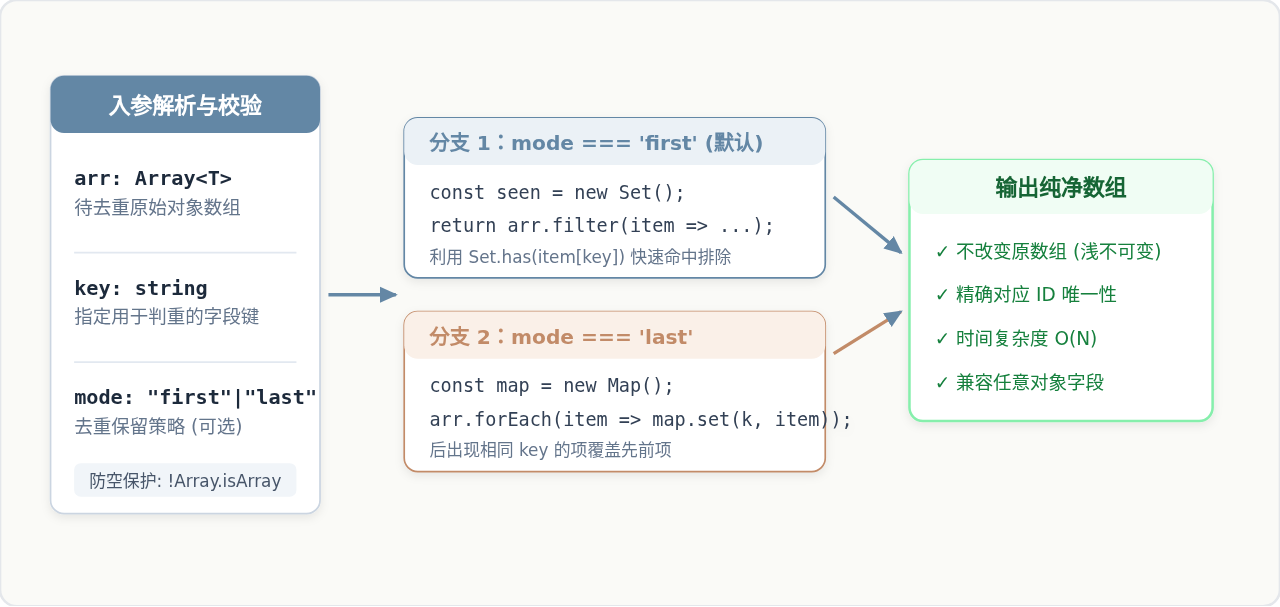
五、必须规避的性能陷阱:避免使用 findIndex
在网络上搜索去重教程时,经常能见到类似如下的代码片段:
// 慎用!数据量稍大时极度缓慢
const badList = arr.filter((item, index) =>
  arr.findIndex(other => other.id === item.id) === index
);
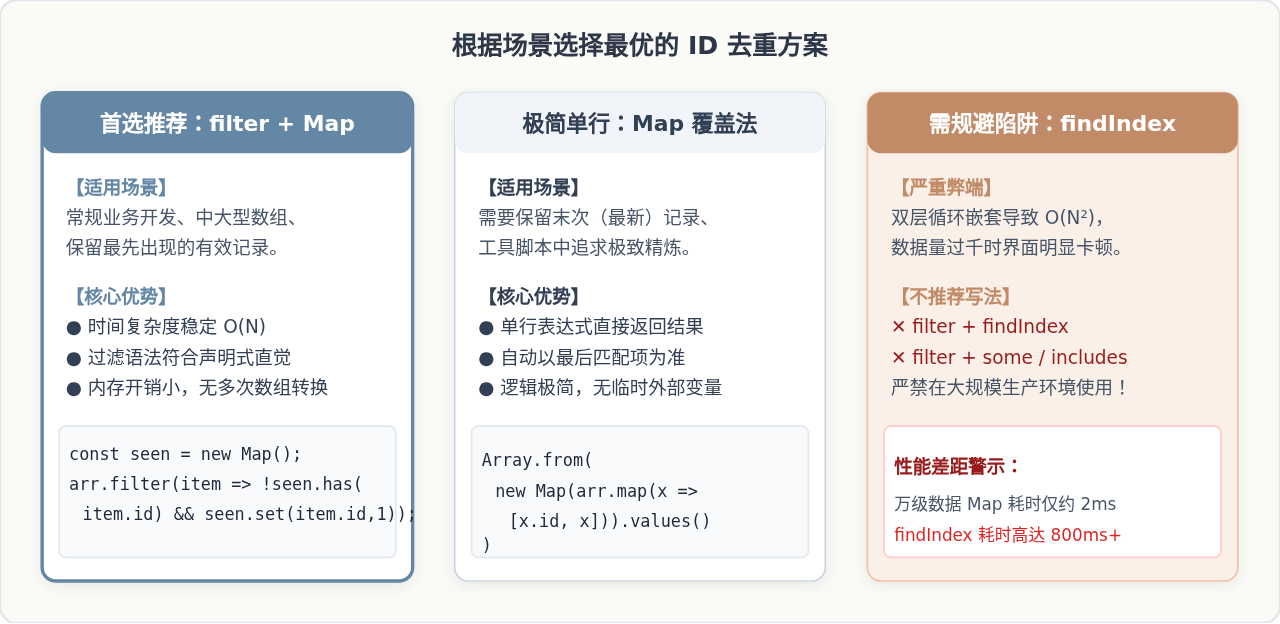
这段代码在语法上确实能跑通,但存在严重的性能陷阱。filter 本身是一层循环(\(O(N)\)),而在过滤回调内调用的 findIndex 又会从数组开头重新扫一遍数组(\(O(N)\))。
这导致整体时间复杂度急剧恶化为 \(O(N^2)\)。如果数组有 10,000 条数据,内部将产生约 50,000,000 次元素比对,不仅可能使浏览器主线程直接掉帧卡死,在 Node.js 服务端更会阻塞事件循环。而使用 Map 或 Set 的哈希查找始终为 \(O(1)\),处理 10,000 条数据只需要遍历 10,000 次。
id 时要注意数据类型。例如数字 1 与字符串 "1" 在 Map 和 Set 中会被判定为两个完全不同的键。如果前后端交互中 ID 存在字符串和数值混用的情况,建议在作为键存入前统一转为字符串处理:String(item.id)。
六、方案对比与选型总结
| 方案 | 时间复杂度 | 空间复杂度 | 去重保留规则 | 适用场景与建议 |
|---|---|---|---|---|
| Map + filter | \(O(N)\) | \(O(N)\) | 保留首次出现的项 | 【强烈推荐】 业务常规场景,语法标准,保持初次顺序 |
| Map 覆盖法 | \(O(N)\) | \(O(N)\) | 保留最后出现的项 | 【极力推荐】 需要以最新数据为准、追求代码极简单行 |
| reduce + Map/Set | \(O(N)\) | \(O(N)\) | 可灵活自定义 | 适合在去重的同时顺便对对象字段进行汇总或二次加工 |
| filter + findIndex | \(O(N^2)\) | \(O(1)\) | 保留首次出现的项 | 【严禁使用】 大数据量下严重卡死,仅适用于十几个元素的极小玩具数组 |
七、总结
在 JavaScript 中解决数组对象按 ID 去重问题,关键在于将无哈希特性的对象引用比对转换为唯一标示(ID)的哈希快速检索。需要保留初次出现时,选择 Map/Set + filter;需要保留最后出现时,选择 new Map() 键覆盖;避免使用 \(O(N^2)\) 的 findIndex 嵌套循环。根据具体业务规则选用对应的 \(O(N)\) 解法,即可兼顾代码的健壮性与极致的运行时性能。
tween.js 内存泄漏预防:怎么正确停止动画与清理对象
2026-11-05 15:52:56
Vue或React项目中为何不建议直接使用JS刷新页面
2026-11-05 13:57:30
哪里可以找到高质量的免费JS脚本资源?
2026-11-05 13:15:03
JS数组去重方法性能对比:Set、Map与Filter谁更快
2026-11-04 16:14:15
JS随机字符串生成:Math.random与Crypto API对比
2026-11-04 15:58:42