

Node.js环境中发送HTTP请求与浏览器的区别及实现
深入对比Node.js与浏览器在发送HTTP请求时的运行机制、跨域安全沙箱、标头控制、Cookie管理及底层Socket连接池差异,并提供原生http/https、内置fetch与第三方库的完整实现与避坑指南。
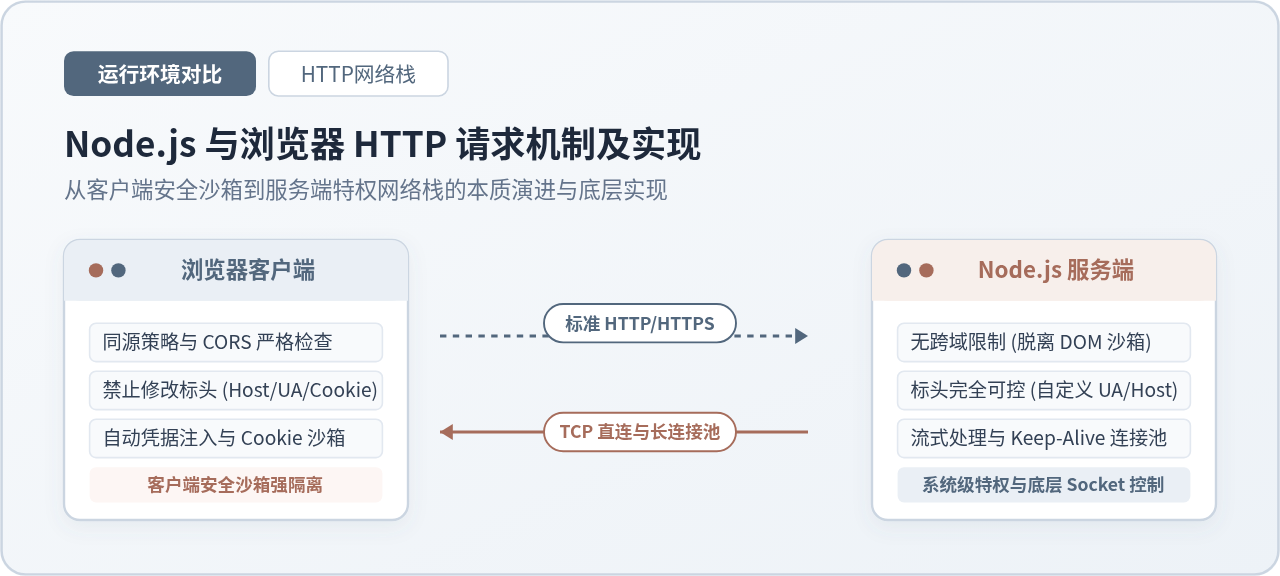
在前端与服务端的日常开发中,发送 HTTP 请求几乎是最频繁的操作。虽然浏览器中的 fetch 或 XMLHttpRequest 与 Node.js 环境中的 http 模块遵循相同的应用层网络协议,但两者的运行机制、安全边界以及数据控制方式有着根本差异。在浏览器中,JavaScript 运行在严格的安全沙箱内,跨域资源共享(CORS)、Cookie 的读写与网络标头的篡改均受到浏览器内核的强制管控;而在 Node.js 服务端环境中,代码拥有直接操作操作系统 TCP Socket 的特权,既不受同源策略约束,也可以自由伪造标头并精确管理底层连接池。
本文将从运行环境与安全沙箱机制的本质区别切入,逐层解析两者的网络栈与底层连接管理逻辑,随后提供 Node.js 原生模块、内置 fetch 与工业级第三方库的具体实现,并梳理在生产高并发场景下的连接池复用与流式内存避坑指南。
一、运行环境与安全沙箱机制的本质区别
理解 Node.js 与浏览器发送请求差异的第一步,是认清两者执行主体的安全假设。浏览器是一个面向未受信任 Web 脚本的多租户沙箱,其首要目标是保护终身用户的隐私安全;Node.js 则是一个受信任的服务端执行环境,其网络能力直接映射到底层操作系统的系统调用。
1. 同源策略与跨域(CORS)的存废
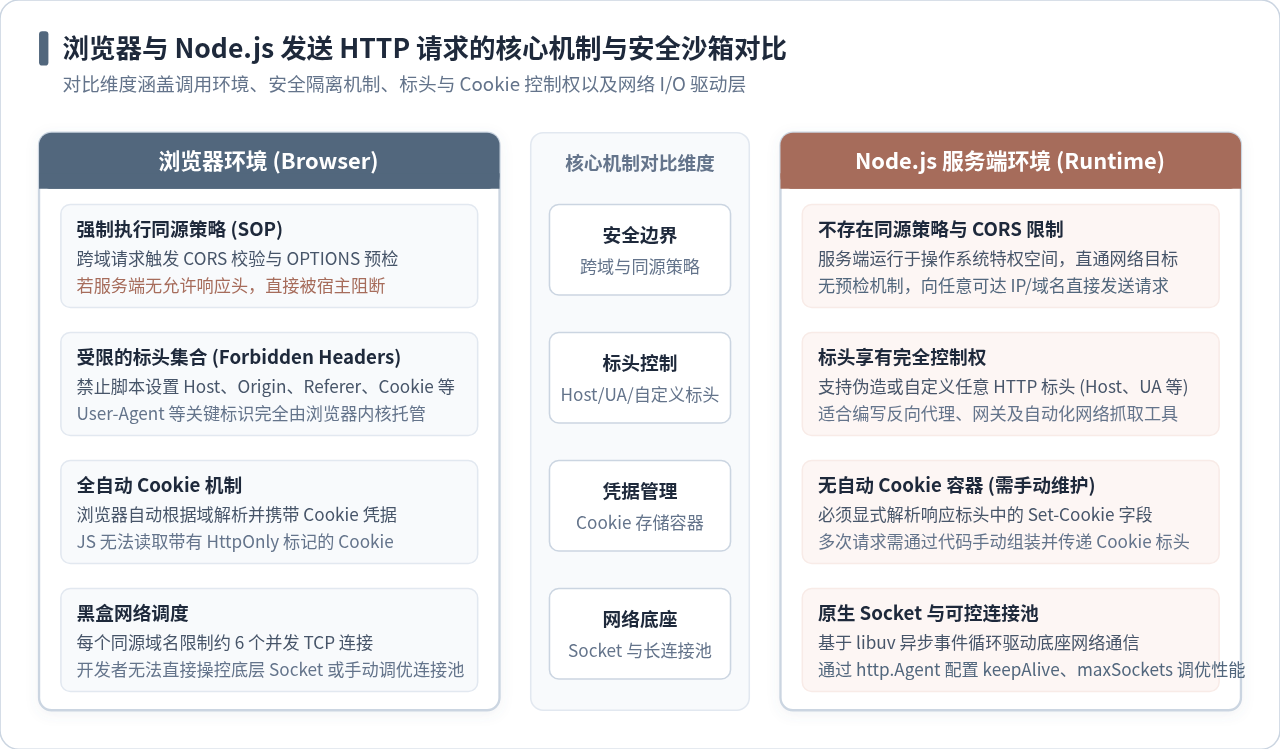
在浏览器中,当 JavaScript 发起一个跨域(协议、域名或端口不同)请求时,同源策略(Same-Origin Policy)会立即介入。对于非简单请求,浏览器会自动向目标服务器发送一个 OPTIONS 预检请求。只有当目标服务显式返回包含 Access-Control-Allow-Origin 等跨域响应头时,浏览器才允许前端脚本读取响应数据;否则,网络请求虽然在传输层完成了往返,响应数据仍然会被浏览器内核直接丢弃,并在控制台抛出熟悉的 CORS 错误。
而在 Node.js 环境中,根本不存在同源策略或 CORS 跨域问题。Node.js 并不存在“当前页面域名”的概念,它是作为一个独立的网络客户端直接发起 TCP 连接。无论是向内部微服务发送请求,还是向第三方公网接口抓取数据,Node.js 都能直接接收并完整解析服务端的响应报文,绝不会发生因缺少 CORS 标头而遭本地拦截的情况。
2. 请求标头(Headers)的控制特权
为了防止恶意脚本伪造关键身份或干扰网络传输,浏览器标准制定了严格的“禁止修改标头名称”(Forbidden Header Names)规范。在前端脚本中使用 fetch 或 XMLHttpRequest 时,以下标头无法被手动设定或修改:
Host:防止伪造目标虚拟主机;User-Agent:由浏览器固定输出,反映设备与内核标识;Referer与Origin:由浏览器内核依据当前页面真实上下文自动注入,防范 CSRF 与篡改;Cookie与Cookie2:由浏览器内部 Cookie Jar 全权管理,避免脚本越权注入会话凭据;Connection、Keep-Alive等连接管理标头:由网络底座统一调度。
相反,在 Node.js 中,开发者享有对 HTTP 报文标头的绝对控制权。你可以将 User-Agent 伪装成任意浏览器或移动端设备,可以手动在 Host 头中指定内网转发目标,也可以任意增删改 Cookie、Referer 或自定义私有标头。这种特权使得 Node.js 成为编写 API 网关、反向代理、爬虫工具及服务间通信的理想环境。
3. 凭据与 Cookie 状态管理的模式差异
浏览器的 Cookie 管理机制是全自动且隐式的。当浏览器收到带有 Set-Cookie 的响应时,会根据 Domain、Path、SameSite 等规则将 Cookie 存入本地数据库;后续向同源目标发起请求时,浏览器会自动从 Cookie 存储中读取有效凭据并附加在请求中。即便前端脚本无法通过 document.cookie 读取带有 HttpOnly 标记的敏感 Token,浏览器在网络层仍会自动携带它。
Node.js 则完全没有内置的“全局 Cookie 存储容器”。服务端发送请求时,如果服务端接口返回了 Set-Cookie 响应头,Node.js 只会将其作为普通的字符串或数组暴露给开发者。如果后续请求需要维持会话状态,开发者必须通过代码手动提取、存储并在后续请求的标头中拼接 Cookie: key=value,或者借助第三方 Cookie Jar 库进行维护。
二、底层网络栈与连接管理机制的差异
除了应用层的安全规则差异,浏览器与 Node.js 在操作系统底层网络套接字(Socket)的抽象与调度方式上也截然不同。
1. 网络 I/O 驱动与线程架构
浏览器具有极其庞大且复杂的网络栈(例如 Chromium 的 Network Service)。它在独立的网络进程中管理多路复用连接池、DNS 缓存、系统代理侦测以及 TLS 会话恢复。前端 JavaScript 仅能在顶层通过高度封装的高级 API(如 Fetch 的 Response 对象)消费数据,无法触碰底层的 Socket 实例。
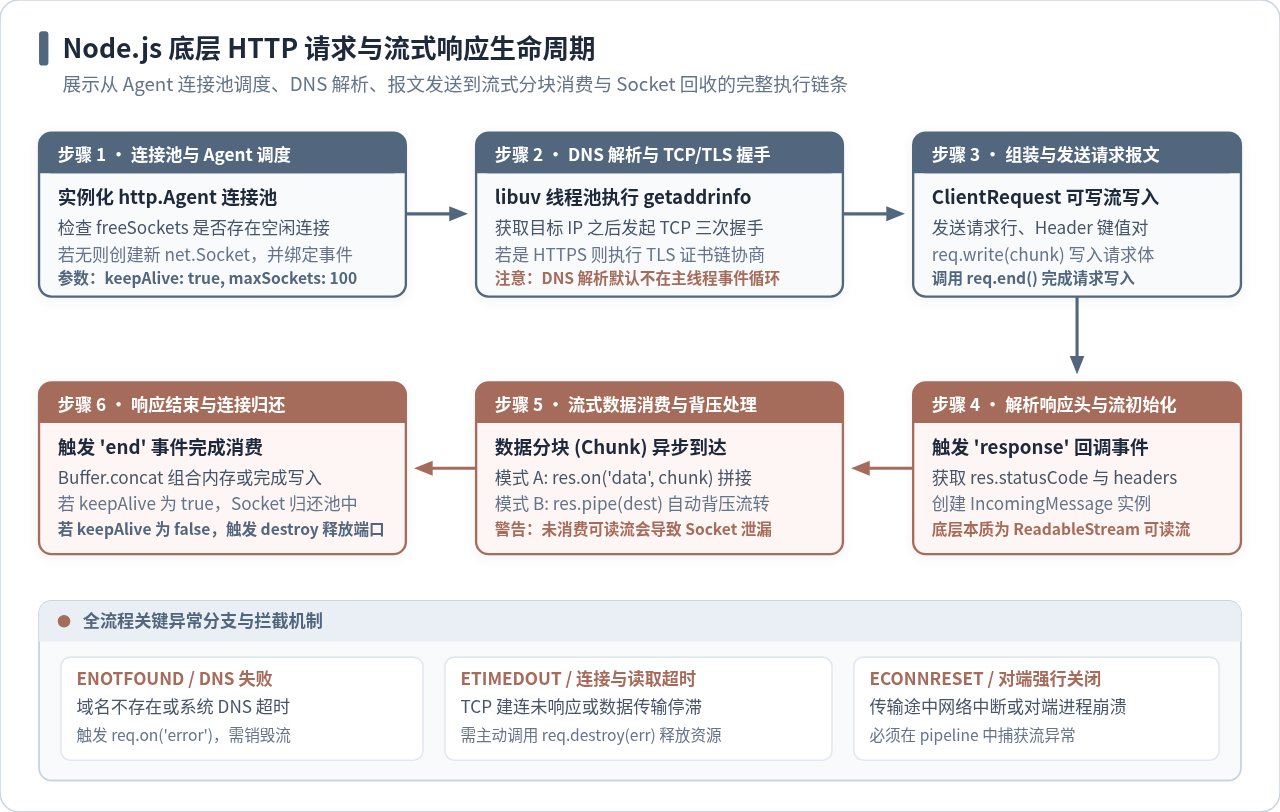
Node.js 则是构建在 libuv 异步事件循环与 V8 引擎之上。它的原生 HTTP 模块底层直接依托 net.Socket(针对普通 HTTP)和 tls.TLSSocket(针对 HTTPS)。这意味着在 Node.js 中,每一次 HTTP 请求都是建立在一个可读写的原生流(Stream)之上,开发者可以直接监听底层 Socket 的建立、超时、断开以及 TLS 握手事件。
浏览器的 DNS 解析由操作系统或内嵌的异步解析器处理,并带有完备的 DNS 缓存机制。而 Node.js 默认的 dns.lookup() 在底层使用的是 POSIX 系统的 getaddrinfo(3) 同步系统调用,必须借由 libuv 的线程池(默认仅 4 个工作线程)来执行异步封装。在高并发且大量请求不同域名的场景下,如果未启用连接复用或 DNS 缓存,可能会导致 libuv 线程池瞬间耗尽,严重阻塞文件 I/O 与加密操作。
2. 长连接与连接池复用(Keep-Alive)
在浏览器中,同一个域名通常被限制在 6 个并发 TCP 连接左右。浏览器内核会自动管理 HTTP Keep-Alive,在页面生命周期内复用空闲套接字以降低握手开销,开发者无需也不能干预具体的连接池配置。
在 Node.js 中,连接池由 http.Agent(或 https.Agent)显式控制。默认情况下,早期 Node.js 版本的 http.globalAgent 默认没有开启 keepAlive,导致每次发送请求都会经历完整的 TCP 三次握手与 TLS 协商,并在请求结束后立刻断开连接。在高 QPS 的生产环境中,短时间内大量建立与销毁连接不仅会显著增加网络延迟,更会导致操作系统堆积海量的 TIME_WAIT 状态端口,最终引发 connect EADDRNOTAVAIL 或系统端口耗尽故障。因此,显式配置并复用带有 keepAlive: true 的 Agent 是 Node.js 高性能网络编程的关键基础。
3. 数据流式消费与背压(Backpressure)机制
在浏览器中处理 HTTP 响应,通常是通过 response.json() 或 response.text() 一次性将全部数据读入内存,即使使用现代 Streams API,受到浏览器环境限制,大多也是为了渲染局部界面。
在 Node.js 服务端,HTTP 响应对象 res 本身就是一个继承自 EventEmitter 的可读流(stream.Readable)。当接收大体积文件或数据流时,Node.js 并不需要一次性将数 GB 的数据加载进内存,而是可以利用 pipe() 管道直接将数据流转推给磁盘文件系统、下游网络套接字或哈希计算器。流的底层内置了背压处理机制,当写入端速度慢于网络接收端时,会自动暂停底层 Socket 读取,从而保证极低的内存占用和极佳的系统稳定性。
三、Node.js 中发送 HTTP 请求的主流实现方式
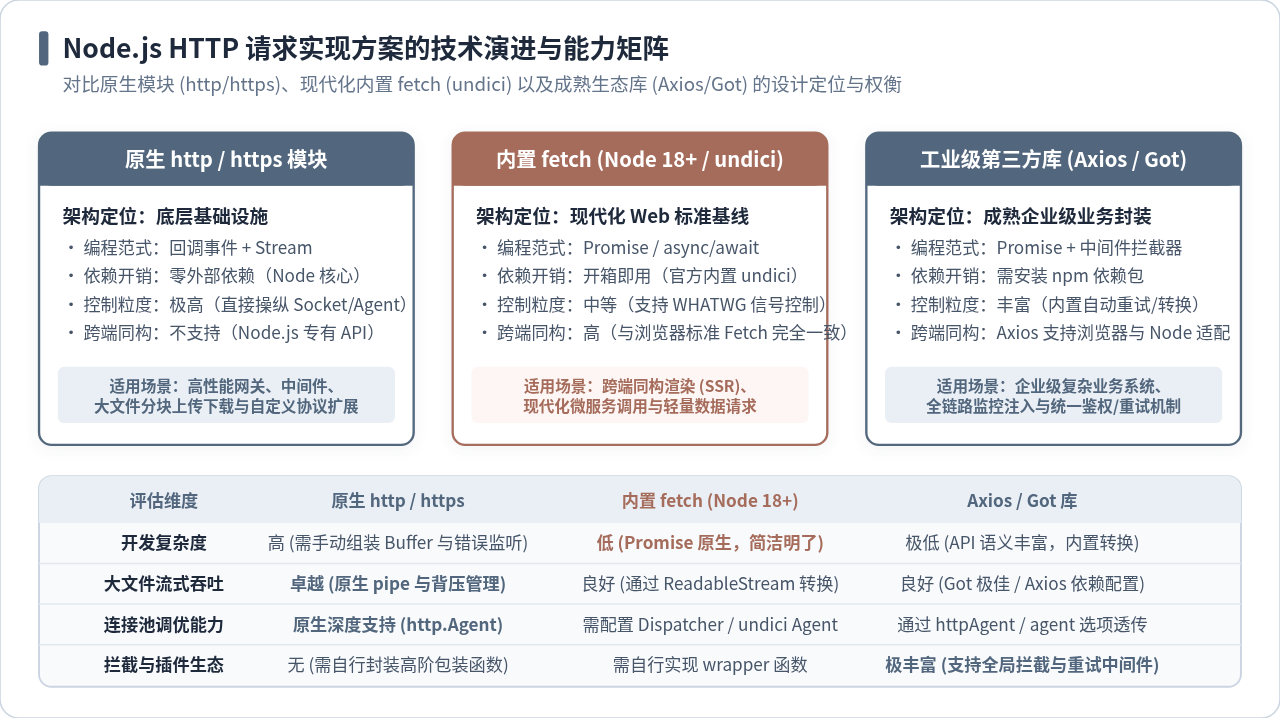
在实际项目开发中,根据依赖策略、同构需求及业务复杂度,Node.js 生态中主要有三种主流的 HTTP 请求实现方案:原生 node:https 模块、Node.js 18+ 内置全局 fetch,以及工业级第三方库(如 Axios 与 Got)。
1. 方案一:Node.js 原生 node:https / node:http 模块
原生模块是 Node.js 核心库的一部分,无需安装任何 npm 包。它提供了最底层的控制能力,适合编写对冷启动时间、依赖体积极其敏感的基础库,或需要精确操纵 Socket 的网络代理。
以下是使用 node:https 发送带有连接池复用、自定义标头及完整错误捕获的 GET 请求示例:
import https from 'node:https';

// 实例化支持长连接复用的 Agent
const keepAliveAgent = new https.Agent({
  keepAlive: true,
  maxSockets: 50,
  maxFreeSockets: 10,
  timeout: 30000, // Socket 空闲超时 30 秒
});

function requestGet(url) {
  return new Promise((resolve, reject) => {
    const options = {
      agent: keepAliveAgent,
      headers: {
        'User-Agent': 'CustomNodeService/1.0.0',
        'Accept': 'application/json',
      },
      timeout: 5000, // 传输超时 5 秒
    };

    const req = https.get(url, options, (res) => {
      const { statusCode } = res;
      const contentType = res.headers['content-type'] || '';

      // 状态码非 2xx 处理
      if (statusCode < 200 || statusCode >= 300) {
        // 重要:即便不关心数据,也必须显式消费响应流以释放套接字
        res.resume();
        return reject(new Error(`请求失败,状态码: ${statusCode}`));
      }

      const chunks = [];
      res.on('data', (chunk) => {
        chunks.push(chunk);
      });

      res.on('end', () => {
        try {
          const rawBuffer = Buffer.concat(chunks);
          const bodyString = rawBuffer.toString('utf-8');
          const data = contentType.includes('application/json')
            ? JSON.parse(bodyString)
            : bodyString;
          resolve(data);
        } catch (parseError) {
          reject(parseError);
        }
      });
    });

    // 捕获网络层错误(如 DNS 解析失败 ENOTFOUND)
    req.on('error', (err) => {
      reject(err);
    });

    // 捕获超时错误并手动销毁连接
    req.on('timeout', () => {
      req.destroy(new Error('请求超时 (ETIMEDOUT)'));
    });
  });
}

// 执行示例
requestGet('https://api.github.com/zen')
  .then((data) => console.log('请求成功,返回数据:', data))
  .catch((err) => console.error('请求异常:', err.message));
当需要发送带有 Payload 的 POST 请求时,可以通过 https.request 构造可写流,使用 req.write() 写入请求体并调用 req.end():
function requestPost(url, payload) {
  return new Promise((resolve, reject) => {
    const postData = JSON.stringify(payload);
    const parsedUrl = new URL(url);

    const options = {
      hostname: parsedUrl.hostname,
      port: parsedUrl.port || 443,
      path: parsedUrl.pathname + parsedUrl.search,
      method: 'POST',
      agent: keepAliveAgent,
      headers: {
        'Content-Type': 'application/json; charset=utf-8',
        'Content-Length': Buffer.byteLength(postData),
        'User-Agent': 'NodeBackend/2.0',
      },
      timeout: 5000,
    };

    const req = https.request(options, (res) => {
      const chunks = [];
      res.on('data', (chunk) => chunks.push(chunk));
      res.on('end', () => {
        const result = Buffer.concat(chunks).toString('utf-8');
        resolve({ statusCode: res.statusCode, body: result });
      });
    });

    req.on('error', reject);
    req.on('timeout', () => req.destroy(new Error('POST 请求连接超时')));

    // 写入请求体并结束写入流
    req.write(postData);
    req.end();
  });
}
2. 方案二:内置全局 fetch API(Node.js 18+ 现代化标准)
从 Node.js 18.0.0 开始,官方将基于高性能 undici 网络库构建的 fetch 提升为全局 API,无需引入任何依赖。它完全遵循 WHATWG Fetch 规范,使前端与服务端的网络请求代码得以保持高度同构。
在 Node.js 中使用 fetch 时,应注意合理配置 AbortController 以设置严格的超时中断机制:
async function modernFetch(url, options = {}) {
  const { timeout = 5000, ...fetchOptions } = options;
  const controller = new AbortController();
  const timeoutId = setTimeout(() => controller.abort(), timeout);

  try {
    const response = await fetch(url, {
      ...fetchOptions,
      signal: controller.signal,
      headers: {
        'Content-Type': 'application/json',
        'User-Agent': 'NodeModernFetch/18.0',
        ...(fetchOptions.headers || {}),
      },
    });

    if (!response.ok) {
      throw new Error(`HTTP 异常: ${response.status} ${response.statusText}`);
    }

    // 自动解析 JSON
    return await response.json();
  } catch (error) {
    if (error.name === 'AbortError') {
      throw new Error(`请求超时,已在 ${timeout}ms 处主动中断`);
    }
    throw error;
  } finally {
    clearTimeout(timeoutId);
  }
}

// 执行现代异步调用示例
(async () => {
  try {
    const postData = { title: '测试', content: 'Node.js 内置 Fetch' };
    const res = await modernFetch('https://jsonplaceholder.typicode.com/posts', {
      method: 'POST',
      body: JSON.stringify(postData),
      timeout: 3000,
    });
    console.log('创建成功,响应结果:', res);
  } catch (err) {
    console.error('调用失败:', err.message);
  }
})();
3. 方案三:工业级成熟第三方库(Axios 与 Got)
在复杂的企业级后端服务中,纯粹的原生请求往往不足以应对统一的业务治理需求。成熟的社区开源库提供了更为完备的抽象:
- Axios:跨端同构的首选。在浏览器环境下底层调用
XMLHttpRequest,在 Node.js 环境下自动适配为原生http/https模块。提供全局拦截器(Interceptors)、自动转换 JSON、统一的错误模型以及对取消令牌(CancelToken / AbortSignal)的支持。 - Got:专为 Node.js 环境打造的人性化 HTTP 客户端(不支持浏览器端)。原生拥抱现代 Promise 与 Stream 管道,内置强大的自适应指数退避重试算法、RFC 规范缓存机制以及详尽的分阶段耗时监控(Timings)。
四、生产环境下的关键避坑点与工程实践
在本地简单测试时,绝大部分网络请求代码都能正常工作;但当系统部署到生产集群并面临每秒数千次请求的高并发冲击时,微小的细节疏漏往往会引发服务雪崩。以下总结了四个在 Node.js 中发送 HTTP 请求最常遭遇的生产陷阱。
1. 响应流未消费导致的 Socket 悬挂与内存泄漏
这是使用原生 http.request 或旧版第三方客户端时最隐蔽的致命陷阱。在 Node.js 中,响应对象 res 是一个处于暂停模式的可读流。如果接口返回了 404 Not Found 或 500 Internal Error,或者在业务逻辑判断后决定丢弃该响应,开发者必须显式调用 res.resume()。
原因在于:只有当可读流中的所有数据被彻底消费或清空后,底层的 net.Socket 才会触发 'end' 事件并将自身归还给 http.Agent 连接池。如果直接 return 忽视数据流,Socket 会一直处于挂起锁定状态,导致连接池中的连接被持续占满,后续请求陷入无限排队,最终引发系统全面假死与内存爆满。
2. 忽略 Keep-Alive 连接池配置引发的端口耗尽
当客户端与服务端频繁通信时,建立 TCP 连接的成本极高。默认情况下,如果每次请求都重新握手并在响应完成后主动 close,操作系统会为主动关闭方保留 2MSL(约 1 至 2 分钟)的 TIME_WAIT 状态。在短时间内突发数万次请求时,主机的临时端口范围(通常为 32768 至 60999)会迅速被 TIME_WAIT 占尽,导致新的请求抛出 connect EADDRNOTAVAIL 错误。因此,生产环境中所有内部调用均应共享同一个配置合理的 http.Agent 实例。
3. 超时机制的层级混淆
很多开发者误以为设置了一个 timeout: 5000 就万事大吉。但在原生的网络模型中,超时至少分为三个不同层面:
- 连接建立超时(Socket Connect Timeout):从发起 TCP 握手到连接成功的时间。如果对端机器宕机或防火墙丢包,将卡死在此阶段。
- 空闲超时(Socket Inactive Timeout):建立连接后,套接字在多长时间内未接收到新数据。
- 整体请求超时(Total Request Timeout):从发起请求到整个响应报文接收完毕的全局绝对时限。
在原生模块中,req.setTimeout() 仅代表 Socket 空闲超时,并不会自动销毁请求,必须手动在超时回调中调用 req.destroy()。在现代开发中,推荐统一使用 AbortController 来控制全局整体时限。
五、总结与技术选型建议
在 Node.js 与浏览器中发送 HTTP 请求,表面上都是向指定 URL 获取或提交数据,但底层的系统特权与架构逻辑有着天壤之别:
- 安全边界:浏览器以同源策略为铁律,强制介入 CORS 预检与禁止标头阻断;Node.js 运行在独立进程空间,无跨域限制,享有标头完全掌控权。
- 凭据管理:浏览器通过系统 Cookie Jar 自动读写与附加凭据;Node.js 需要在代码中显式解析
Set-Cookie并手动管理会话容器。 - 网络性能:浏览器由内核黑盒调度有限连接;Node.js 依托 libuv 与事件驱动流,允许开发者深度调优
http.Agent连接池与背压传输管道。
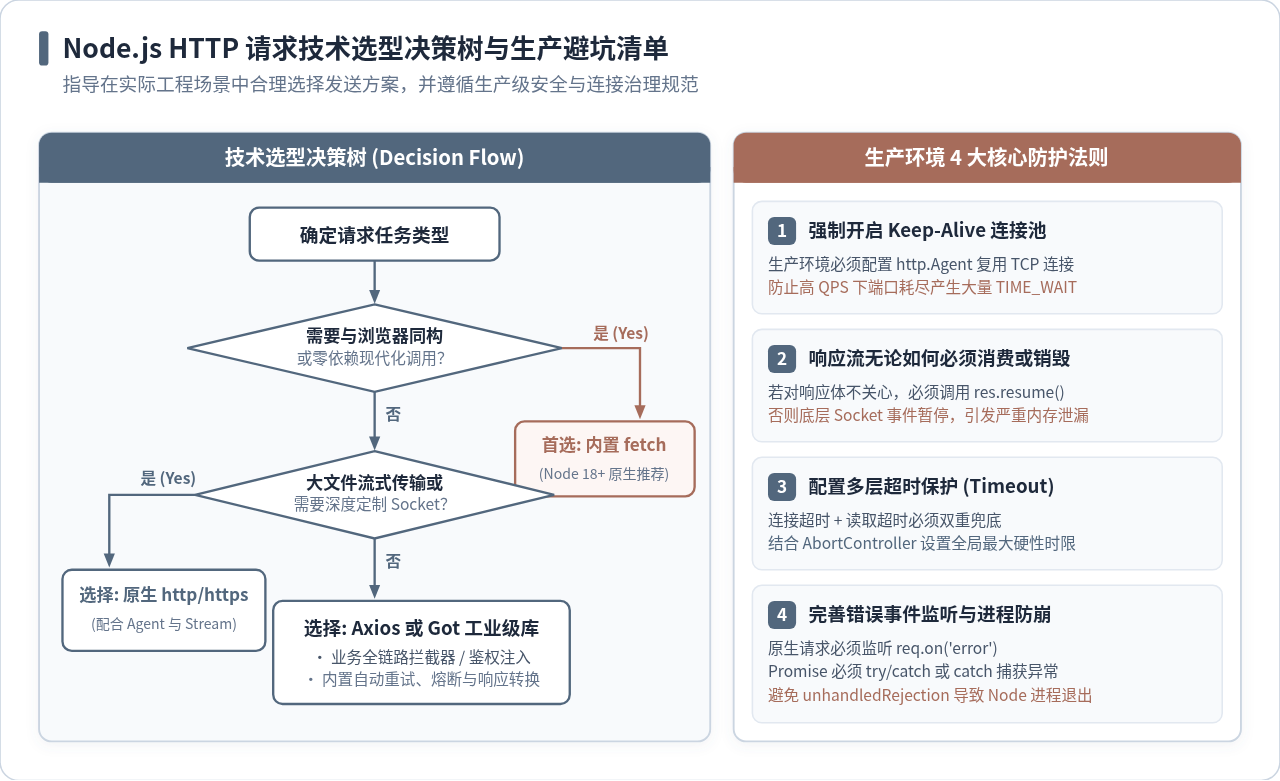
在技术方案选型上:
- 对于运行在 Node.js 18+ 环境中的现代化微服务调用、Serverless 函数或前端同构(SSR)逻辑,推荐直接使用原生的内置
fetch,代码轻量、标准统一且零外部依赖; - 对于大文件断点续传、音视频分块流式代理或需要精确控制底层 TCP 连接属性的高性能网关,推荐基于原生
node:http/node:https结合 Stream 管道进行定制; - 对于大型企业级中后台项目,如果需要统一的鉴权 Token 刷新拦截器、自动重试熔断与全链路链路追踪标头注入,成熟的 Axios 或专为 Node.js 打造的 Got 依然是保障系统健壮性最省心的选择。
macOS卸载Node.js指南:区分Homebrew与pkg安装包的处理方式
2026-11-05 11:28:12
JS逆向入门:浏览器Console调试与Node.js环境搭建指南
2026-11-05 10:57:15
Node.js 大版本升级需要注意哪些破坏性变更
2026-11-03 20:35:44
Node.js官网LTS版与Current版有什么区别
2026-11-03 19:33:49
Windows彻底卸载Node.js:清理AppData残留与PATH环境变量
2026-11-03 19:15:35







