JS中怎么将HTML字符串安全转换为DOM对象
深入讲解在JavaScript中将HTML字符串安全转换为真实DOM对象的完整方案,分析DOMParser、template元素与innerHTML的安全边界与执行时机,提供抵御XSS注入的实战代码与架构决策指南。
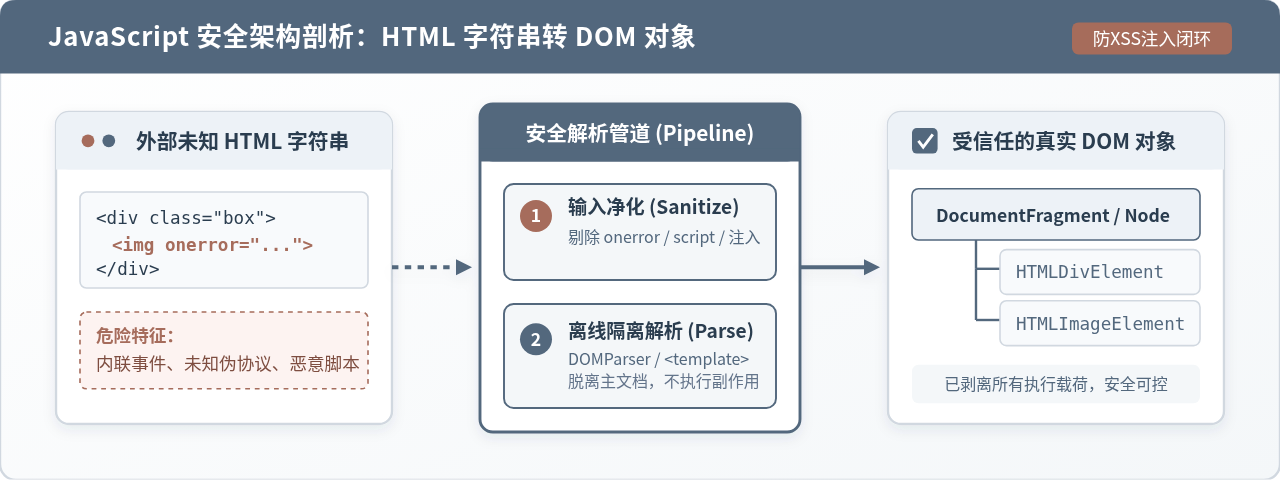
DOMParser 或 <template> 元素的 innerHTML 在离线上下文中生成节点;但“安全”转换的核心不仅仅在于调用哪个解析 API,而在于解析流程中对 XSS 载荷的净化过滤。只有通过“输入消毒(Sanitization)+ 离线隔离解析”的双层闭环,才能彻底杜绝内联事件属性(如 onerror)与恶意脚本注入所带来的代码执行风险。
为什么“看似简单的转换”隐藏着严重安全漏洞
在日常开发中,许多人初次遇到将 HTML 字符串转为 DOM 节点的需求时,第一反应是直接创建一个虚拟的 <div> 容器,然后为其赋值 innerHTML 并读取其 firstElementChild。这种写法在处理纯受信任文本时虽然能够得到 DOM 节点,但在面对用户输入或外部接口数据时却极具破坏性。
现代浏览器虽然在 HTML5 规范中明确规定通过 innerHTML 动态插入的 <script> 标签默认不自动执行,但这并不能阻挡变种注入。最典型的场景就是基于属性和媒体资源的内联注入载荷,例如:
// 极其危险的载荷示例:不需要直接执行 script 标签
const maliciousString = '<img src="invalid-image.jpg" onerror="alert(document.cookie)">';

// 若直接借助常规已挂载或半活动节点解析:
const tempDiv = document.createElement('div');
tempDiv.innerHTML = maliciousString; // 浏览器立即尝试加载图片,失败后立刻触发 onerror 中的 JS!
一旦图片加载失败(对于构造的恶意地址而言几乎是必然的),onerror 挂载的恶意脚本会瞬间在当前页面作用域下执行,盗取会话凭证或篡改界面。因此,“安全转换”不仅意味着“把字符串变成对象”,更意味着在转换全生命周期内掐断所有不受控的脚本执行与跨站攻击(XSS)路径。
主流原生解析方案与机制对比
浏览器原生提供了多种将字符串解析为 DOM 树的途径。了解它们各自的沙箱边界、执行时机以及内存特性,是选对工具的前提。
1. DOMParser:独立脱水沙箱文档(推荐方案)
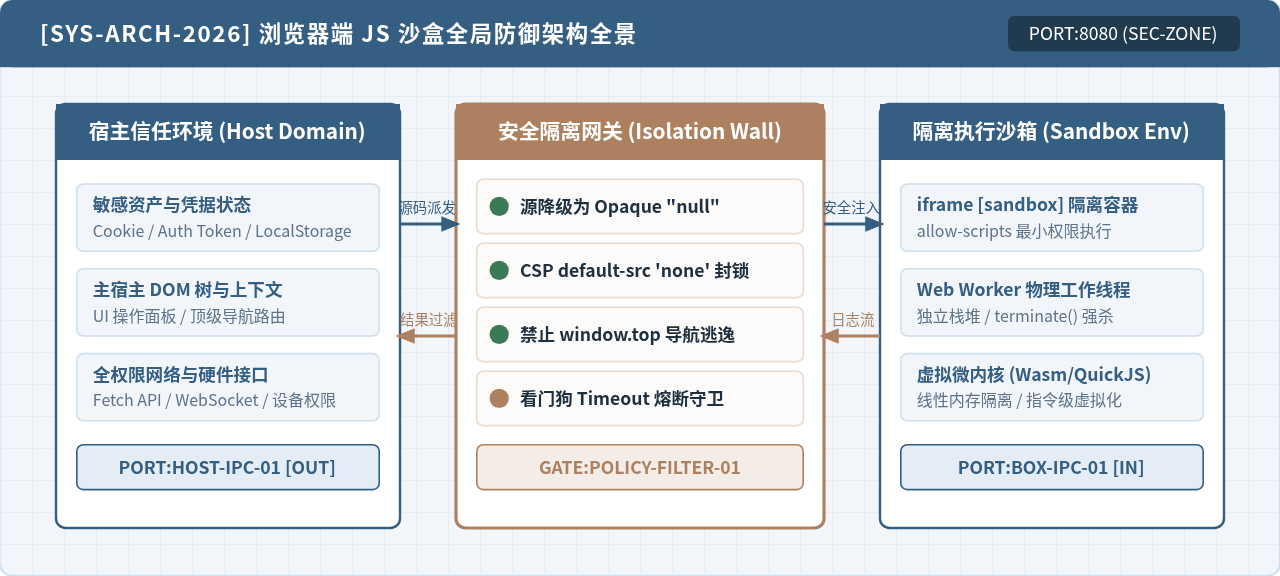
DOMParser 专门用于将 XML 或 HTML 源代码解析为 DOM Document 对象。它是在一个完全独立的沙箱上下文(脱水文档,detached document)中完成解析的。在此过程中,脚本被显式标记为不可执行,外部资源(如图片、媒体)也不会在此阶段发起真正的网络请求。
/**
 * 使用 DOMParser 进行离线解析
 * @param {string} htmlString 待解析的 HTML 字符串
 * @returns {Element | null} 解析后的首个 Element 节点
 */
function parseWithDOMParser(htmlString) {
  const parser = new DOMParser();
  // 解析为完整的独立 HTMLDocument
  const doc = parser.parseFromString(htmlString, 'text/html');

  // 提取 body 下的首个子元素
  return doc.body.firstElementChild;
}
2. HTML5 <template> 元素:惰性 DocumentFragment 容器
<template> 是 HTML5 引入的原生内容模板元素。它的核心设计目的就是存储客户端惰性内容。当向 template.innerHTML 写入字符串时,解析出的节点会存放在 template.content 这一特殊的 DocumentFragment 中。
在这个片段中,所有的脚本保持休眠状态,样式不渲染,图像等外链资源完全不进行预加载。这使得它在需要批量转换多个同级兄弟元素时成为极佳的性能容器。
/**
 * 使用 template 元素解析多个同级元素片段
 * @param {string} htmlString 待解析的 HTML 片段
 * @returns {DocumentFragment} 包含所有解析节点的惰性文档片段
 */
function parseWithTemplate(htmlString) {
  const template = document.createElement('template');
  template.innerHTML = htmlString.trim();
  // template.content 是一个只读的 DocumentFragment
  return template.content;
}
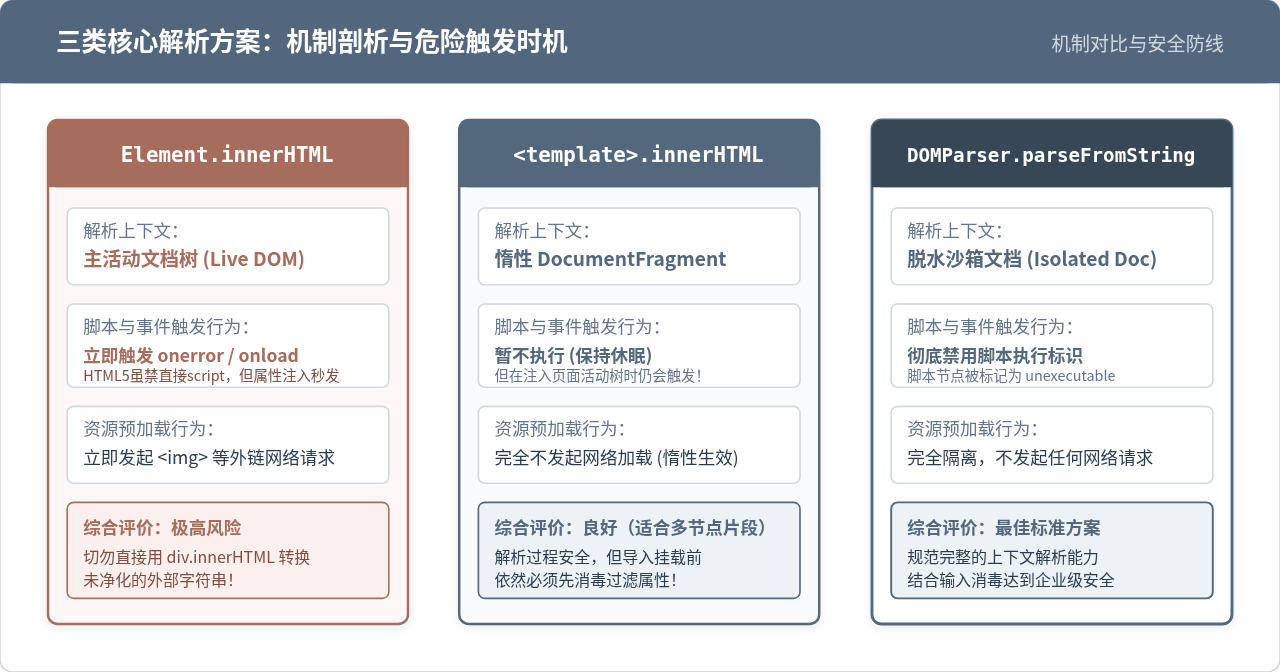
DOMParser 还是 <template>,虽然它们在“解析瞬间”不会执行 <script> 或 onerror,但一旦你将得到的 DOM 节点通过 appendChild 或 replaceChildren 挂载到主活动文档中,浏览器仍会触发那些残留的内联事件!因此,解析器沙箱只能保证“解析时安全”,不能代替“净化过滤”。
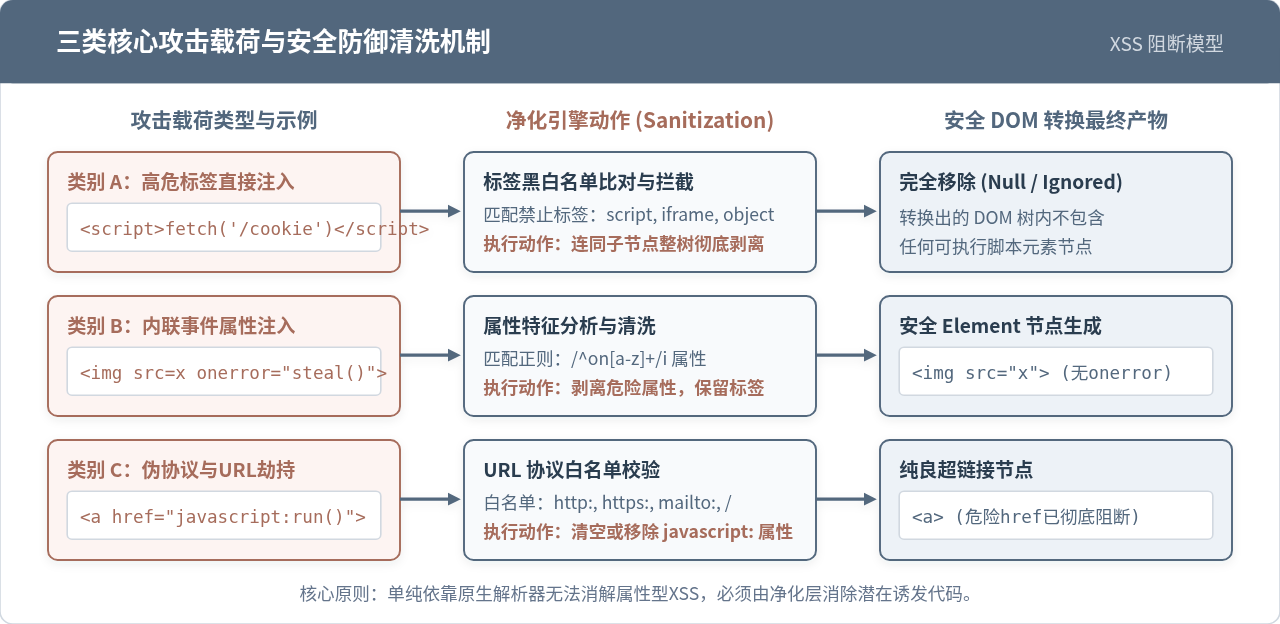
落地实践:构建真正安全的生产级转换管道
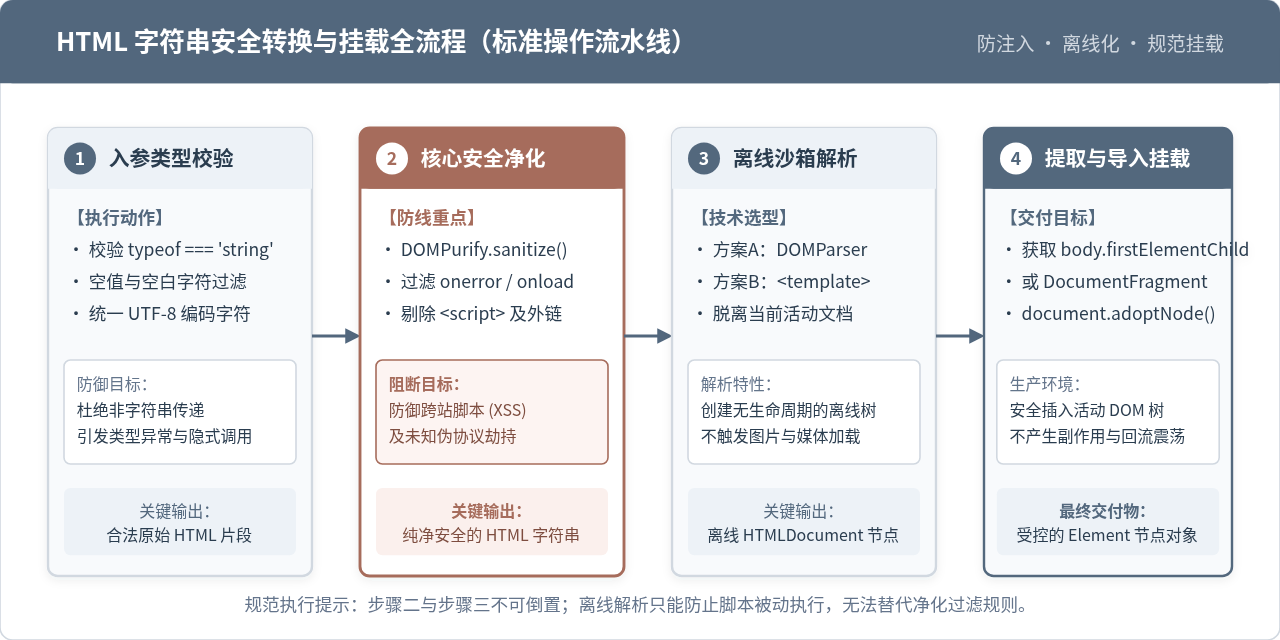
为了保证无论传入多么刁钻的恶意代码,转换出的 DOM 节点都能安心插入活动文档中,必须建立严格的“净化前置”流水线。在生产环境中,最可靠的方式是结合工业级净化库(如 DOMPurify),或者在现代浏览器中结合渐进式支持的原生 Sanitizer API。
完整且可复用的生产级封装示例
下面的代码演示了一个生产级安全转换函数 safeHTMLToDOM。它首先对入参做严格的类型断言,然后利用净化器剔除所有危险标签和事件监听器,再通过 DOMParser 离线实例化并提取纯净的 DOM 节点。
/**
 * 完整安全的 HTML 字符串转 DOM 对象方案
 * 依赖说明:若处理未知来源内容,需引入 DOMPurify 进行净化;
 * 若在纯内部信任模板环境下,可将 sanitize 设为 false。
 */
function safeHTMLToDOM(htmlString, options = {}) {
  // 1. 入参严苛断言
  if (typeof htmlString !== 'string') {
    throw new TypeError('safeHTMLToDOM: 入参必须为有效的字符串');
  }

  const trimmed = htmlString.trim();
  if (!trimmed) {
    return null;
  }

  const {
    asFragment = false,  // 是否以 DocumentFragment 返回所有子节点
    sanitize = true       // 是否执行安全净化过滤
  } = options;

  // 2. 前置消毒:优先调用全局或模块引入的 DOMPurify
  let cleanHTML = trimmed;
  if (sanitize) {
    if (typeof DOMPurify !== 'undefined' && DOMPurify.sanitize) {
      cleanHTML = DOMPurify.sanitize(trimmed, {
        RETURN_DOM: false, // 保持字符串,由统一解析器实例化
        FORBID_TAGS: ['style', 'script', 'iframe', 'object', 'embed'],
        FORBID_ATTR: ['onerror', 'onload', 'onclick', 'onmouseover']
      });
    } else {
      // 备用极简防御:在缺少净化库时拦截最典型的恶意特征
      cleanHTML = cleanHTML
        .replace(/<script[^<]*(?:(?!<\/script>)<[^<]*)*<\/script>/gi, '')
        .replace(/\s*on\w+\s*=\s*(['"]).*?/gi, '')
        .replace(/href\s*=\s*(['"])javascript:.*?/gi, 'href="#"');
    }
  }

  // 3. 离线沙箱解析
  const parser = new DOMParser();
  const doc = parser.parseFromString(cleanHTML, 'text/html');

  // 4. 节点提取
  if (asFragment) {
    const fragment = document.createDocumentFragment();
    // 循环转移节点至当前上下文的 DocumentFragment
    while (doc.body.firstChild) {
      // adoptNode 保证从外部沙箱文档平滑迁移节点宿主关系
      fragment.appendChild(document.adoptNode(doc.body.firstChild));
    }
    return fragment;
  }

  // 返回首个根 Element 对象
  const rootEl = doc.body.firstElementChild;
  return rootEl ? document.adoptNode(rootEl) : null;
}
测试与验证结果
我们可以用一组包含潜在攻击代码的样例来验证上述函数的表现:
// 测试用例:混合恶意属性与合法 HTML 结构的字符串
const input = `
  <div class="user-card">
    <h3>用户资料</h3>
    <img src="avatar.png" onerror="alert('xss')" alt="头像">
    <a href="javascript:alert(1)">访问链接</a>
    <script>console.log('恶意代码执行');</script>
  </div>
`;

const domNode = safeHTMLToDOM(input);

console.log(domNode instanceof HTMLElement); // 输出: true
console.log(domNode.querySelector('img').hasAttribute('onerror')); // 输出: false
console.log(domNode.querySelector('script')); // 输出: null
从验证结果可以看出,原本附带在 <img> 上的 onerror 属性被完全剥离,危险的 <script> 标签未被保留,生成的节点是一个标准且纯净的 HTMLDivElement,即便立即插入主文档 document.body.appendChild(domNode),也不会产生任何非预期的副作用。
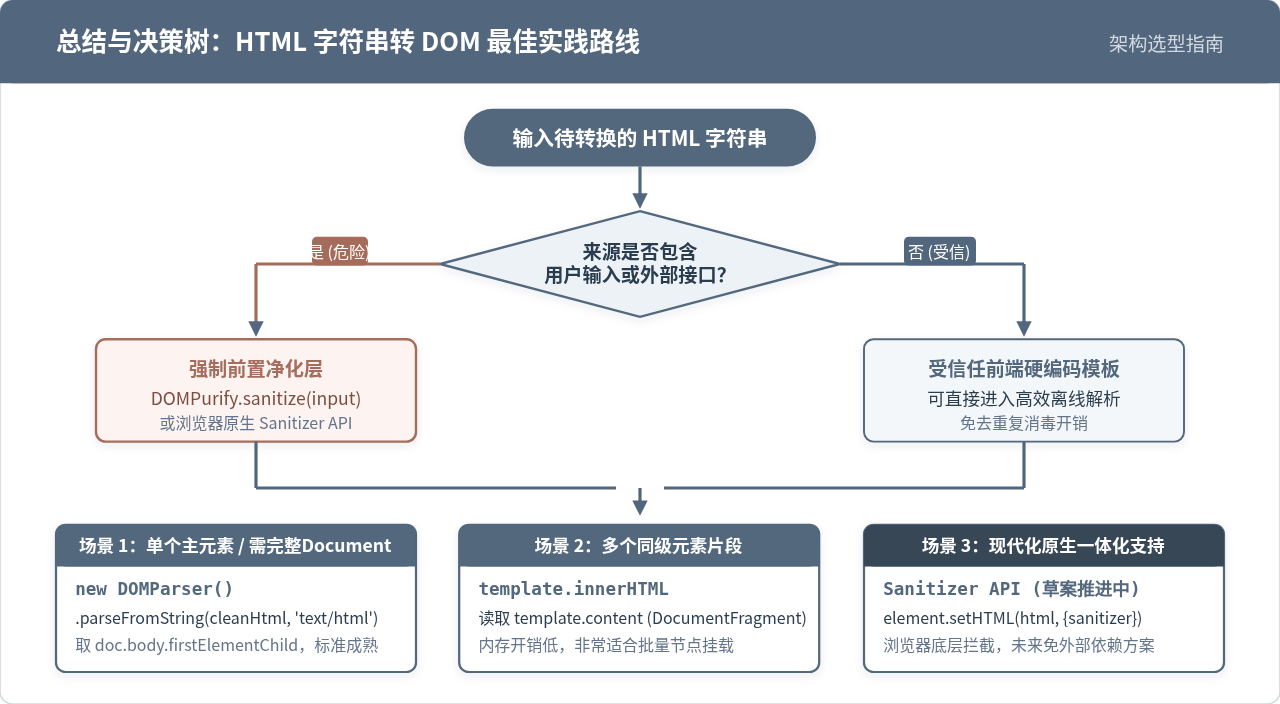
选型对照与场景总结
为了便于在工程落地中快速抉择,下表对各类方案的关键特性进行了汇总:
| 技术方案 | 原生支持度 | 解析阶段安全性 | 挂载阶段安全性 | 推荐使用场景 |
|---|---|---|---|---|
| DOMParser + DOMPurify | 全浏览器通用 (需引库) | 极高 (独立沙箱) | 极高 (无遗留属性) | 企业级通用推荐,处理任何不可信外部输入 |
| <template>.innerHTML | 全浏览器原生 | 高 (惰性片段,不加载资源) | 需前置净化,否则挂载即爆 | 组件库内部同级多节点的高性能拼接 |
| Sanitizer API (原生) | 现代浏览器实验推进中 | 极高 (底层C++级过滤) | 极高 (平台规范标准) | 未来标准方向,适用于免第三方依赖的现代轻量环境 |
| Range.createContextualFragment | 全浏览器原生 | 低 (可能触发立即执行) | 低 (容易被属性注入) | 仅限富文本编辑器纯受信任选区操作,不推荐解析外部输入 |
总结而言,在 JavaScript 中将 HTML 字符串转换为 DOM 对象并不存在技术阻碍,真正的难点在于建立起纵深防御的工程意识:优先使用 DOMParser 创建离线沙箱环境,并在将结果回填至活动界面前完成白名单式的属性与标签净化。把握好“离线解析”与“输入净化”的分工边界,便能在获得灵活 DOM 操作能力的同时,彻底筑牢前端的安全底线。
配置 Matter.js 睡眠机制以优化静止物体性能
2026-11-05 15:43:12
JavaScript console.log高级用法:用table、group和time优化调试输出
2026-11-05 08:04:56
JS变量中存储HTML代码时的特殊字符转义方法
2026-11-04 19:04:09
JS怎么安全转换带千分位或货币符号的字符串为数字
2026-11-04 11:54:14
推荐几款稳定的在线JS反混淆工具,支持Obfuscator.io解密
2026-11-04 08:16:21