Cube.js Data Schema编写指南:Cubes、Dimensions与Measures定义
本指南详解 Cube.js Data Schema 的核心构建方法,涵盖 Cube 实体声明、基础 SQL 表绑定、Dimensions 维度与主键设置,以及各类 Measures 指标聚合定义与验证。
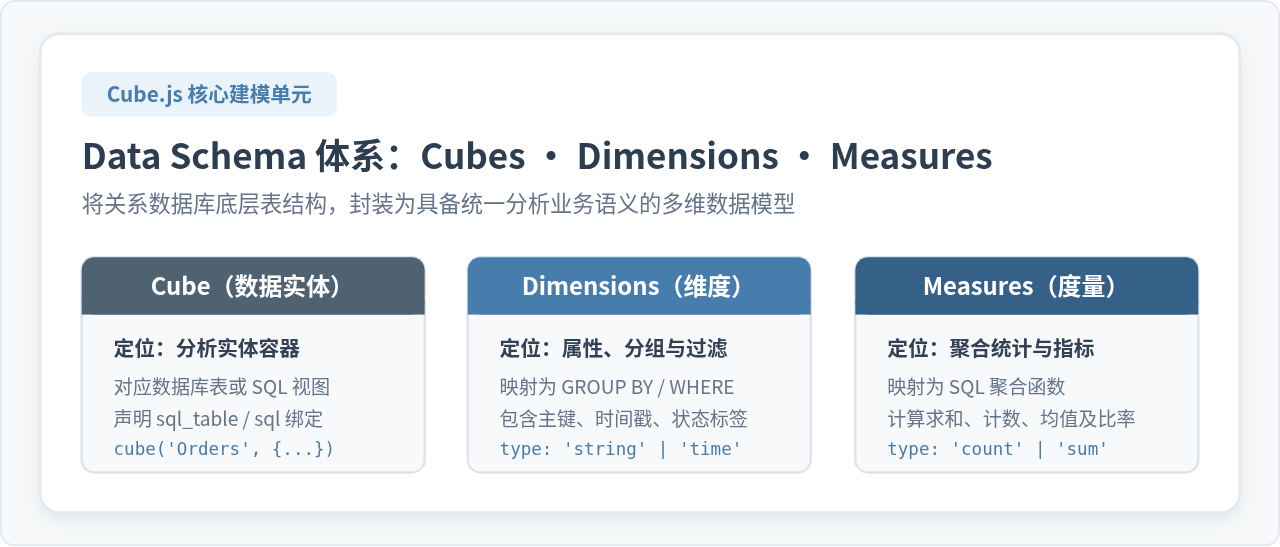
一、Cube.js Data Schema 的定位与核心组成
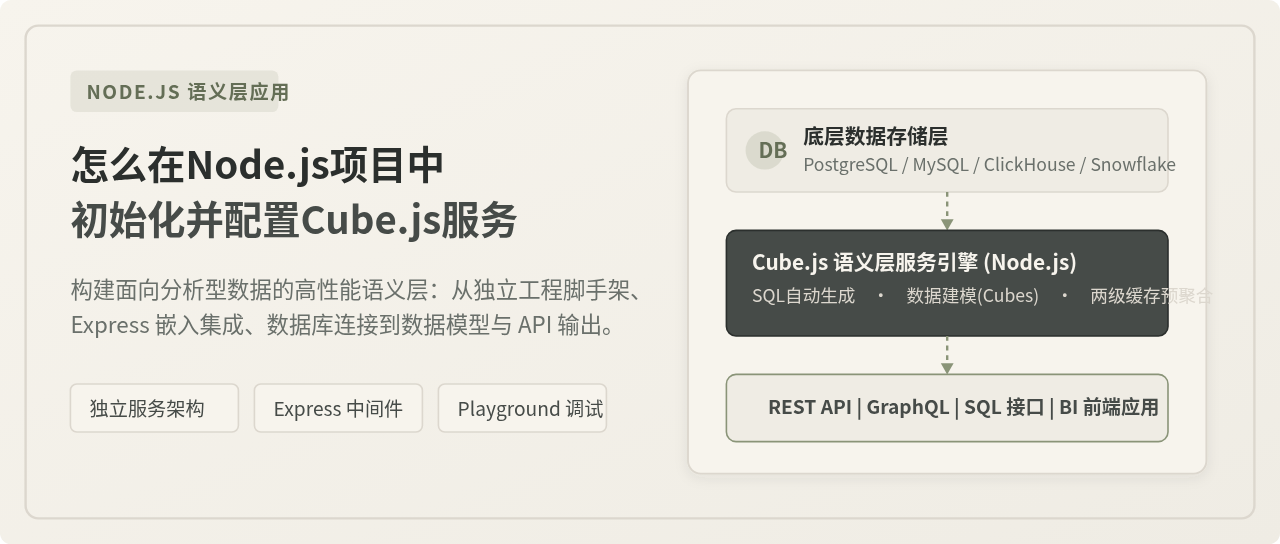
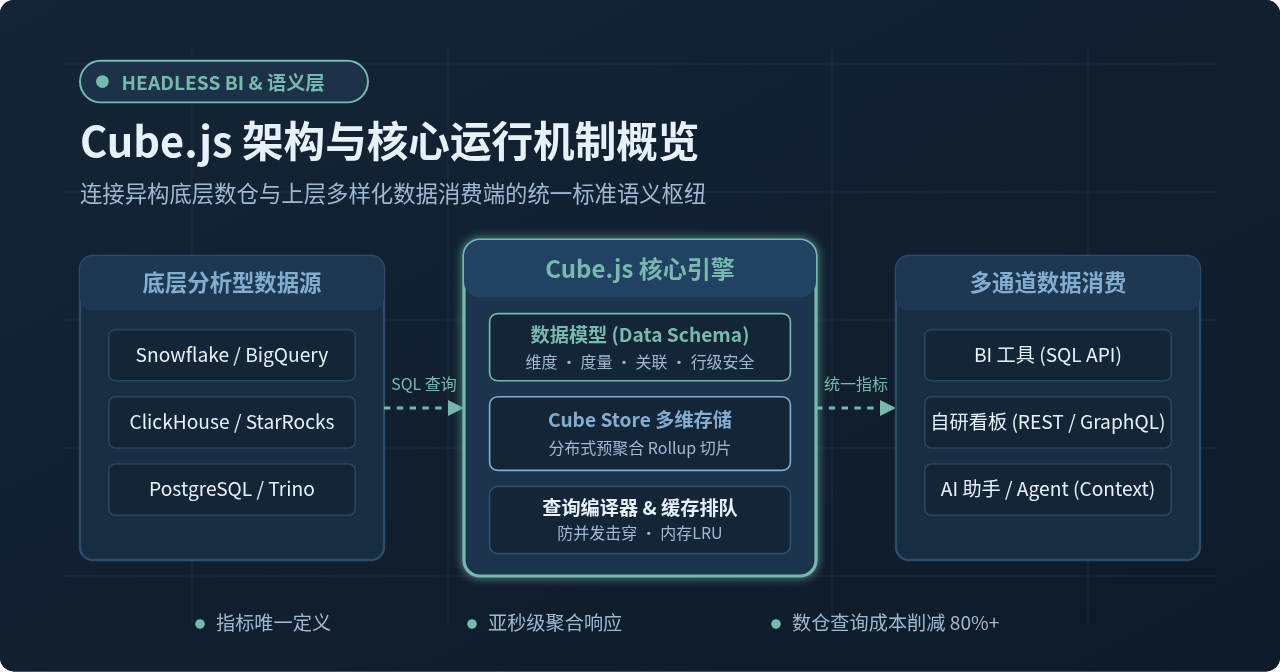
传统直接面向数据库写 SQL 进行多维分析的方式存在诸多痛点:复杂的 JOIN 逻辑随处复制、聚合口径在各个看板与下游报表中标准不一、业务变动时维护成本高昂。Cube.js 作为一个开源的数据语义层(Semantic Layer),位于底层分析型数据库与上层消费端(前端仪表盘、BI 工具、下游 API)之间。
Data Schema 是 Cube.js 运作的大脑。开发者在 Schema 中将分散的物理数据表抽象为逻辑模型。在 Data Schema 中,核心概念划分为三个层次:
- Cubes(立方体/实体):多维分析的基本逻辑单元,通常对应数据库中的一张物理表、一个视图,或者一段经过清理的 SQL 子查询。它作为容器包裹所属的维度与度量。
- Dimensions(维度):描述事物的属性与特征,用于在分析时进行过滤(
WHERE)、切片分组(GROUP BY)与排序(ORDER BY)。例如用户 ID、订单状态、创建时间、所属省份等。 - Measures(度量):基于数值的统计计算结果,对应 SQL 中的聚合函数(如
COUNT、SUM、AVG、MIN、MAX)或在此基础上的比率计算。例如总订单数、GMV、平均客单价等。
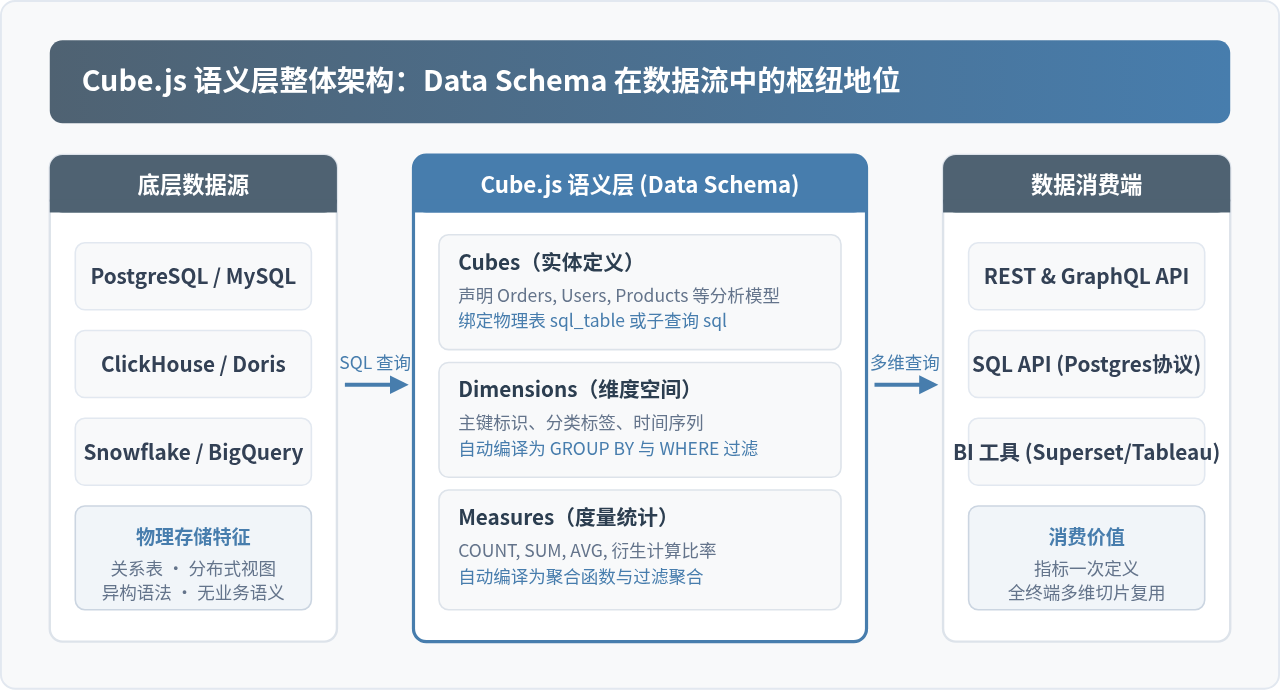
二、声明数据实体:Cube 的基本结构与数据源绑定
Cube.js 支持使用 JavaScript 或 YAML 编写 Data Schema 文件,官方推荐在项目根目录下的 schema/ 文件夹中以 .js 文件组织。一个典型的文件如 schema/Orders.js,使用全局函数 cube() 进行声明。
1. 绑定方式:sql_table 与 sql
每个 Cube 必须明确其底层的数据来源,主要有两种配置属性:
sql_table:直接映射物理表。当表结构整洁、无需在语义层前置过滤时优先使用。需要指定数据库 schema 前缀(如public.orders)。sql:使用自定义 SQL 查询作为 Cube 的数据源。适用于需要在进入 Cube 之前进行列裁剪、联表打宽或硬过滤历史废弃数据的场景。
// 方式 A:直接绑定物理表(推荐)
cube('Orders', {
  sql_table: 'public.orders',

  // 维度与度量声明...
});

// 方式 B:使用子查询清洗数据
cube('ActiveUsers', {
  sql: `SELECT id, name, created_at, status
        FROM public.users
        WHERE is_deleted = false`,

  // 维度与度量声明...
});${CUBE} 关键字指代当前 Cube 在生成 SQL 时被分配的表别名。例如 ${CUBE}.amount,这样能有效避免表别名冲突。
三、定义 Dimensions(维度):属性、主键与时间切片
Dimensions 对应的是业务中“按什么分类查看”或“按什么条件筛选”。在 SQL 查询生成阶段,所有请求中包含的维度都会被 Cube.js 自动编译进入 GROUP BY 子句。
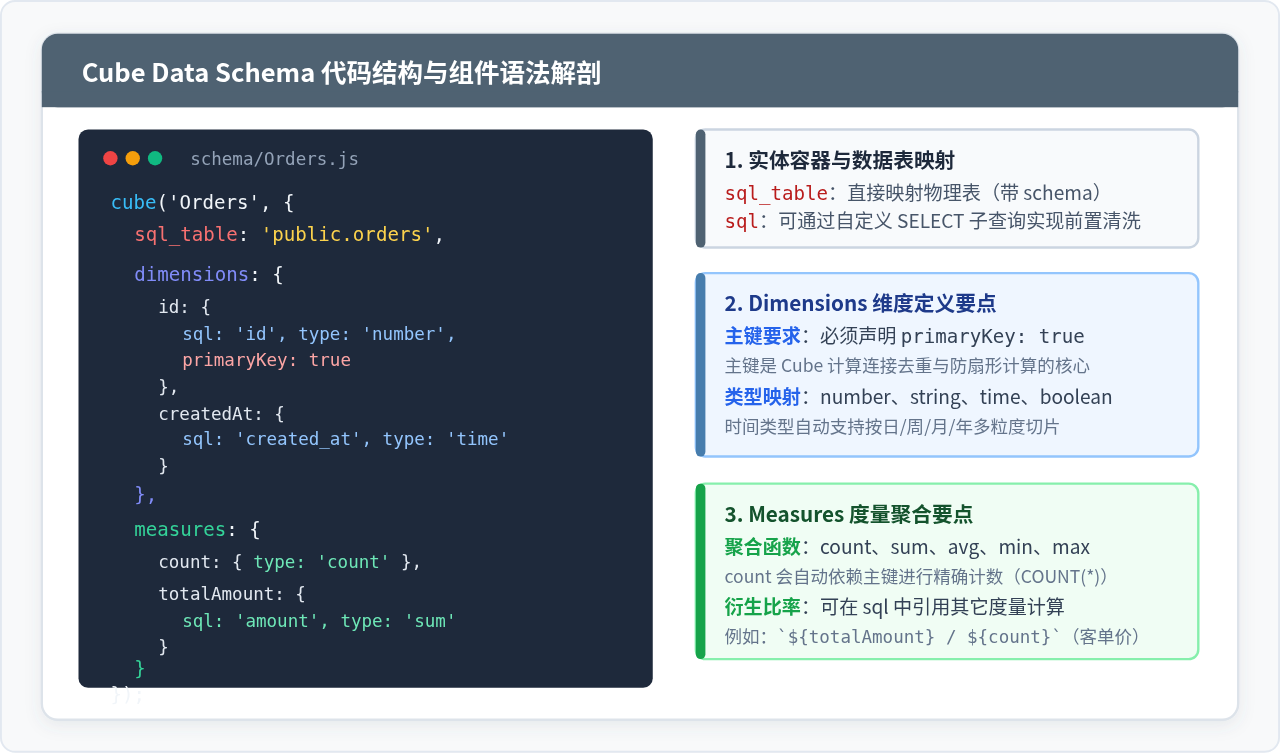
1. 核心属性与主键声明
在声明维度时,最重要的规则之一是必须为每个 Cube 指定主键。在对应维度的配置中设置 primaryKey: true。
Cube.js 依赖主键来精确执行行数统计(COUNT)、防止在多表 JOIN 时产生笛卡尔积或扇形计算(Fan-out),以及为预聚合提供唯一的哈希依据。
dimensions: {
  id: {
    sql: 'id',
    type: 'number',
    primaryKey: true
  },

  status: {
    sql: 'status',
    type: 'string'
  },

  // 计算型布尔维度
  isCompleted: {
    sql: `${CUBE}.status = 'completed'`,
    type: 'boolean'
  }
}
2. 时间维度与自动粒度切片
时间维度是多维分析中最重要的维度类型。当把维度的 type 设置为 time 时,Cube.js 的查询接口会自动支持时间粒度(Granularity)转换,客户端无需在前端写 DATE_TRUNC,只需在查询传参中指定 granularity: 'day' | 'month' | 'year' 即可。
createdAt: {
  sql: 'created_at',
  type: 'time'
}
四、定义 Measures(度量):聚合统计与业务计算
Measures 对应的是“统计出来的数值”。只要在客户端查询请求中包含了 Measure,Cube.js 就会生成对应的 SQL 聚合函数。
1. 基础聚合类型
Cube.js 内置了完备的常用聚合类型:
count:计数。如果没有提供sql,Cube 会默认使用主键计算COUNT(id);若未定义主键则编译为COUNT(*)。countDistinct:去重计数。通过sql指定字段,编译为COUNT(DISTINCT column)。sum:求和。必须指定数值列的sql。avg:平均值。min/max:极值统计。
measures: {
  count: {
    type: 'count'
  },

  totalAmount: {
    sql: 'amount',
    type: 'sum'
  },

  avgAmount: {
    sql: 'amount',
    type: 'avg'
  },

  payingUsersCount: {
    sql: 'user_id',
    type: 'countDistinct'
  }
}
2. 条件过滤度量(Filtered Measures)
在真实业务中,经常需要统计特定状态下的指标,例如“已支付订单总额”或“退款订单量”。Cube.js 提供了 filters 属性,它会在 SQL 中自动生成带 CASE WHEN 的条件聚合,而不需要写子查询。
completedAmount: {
  sql: 'amount',
  type: 'sum',
  filters: [
    { sql: `${CUBE}.status = 'completed'` }
  ]
}
3. 衍生计算度量(Calculated Measures)
像“客单价(总金额 / 订单数)”、“退款率”等复合指标,不能简单对单列求均值,而必须在聚合结果之间相除。Cube.js 允许将度量的类型设置为 number,并在 sql 中直接引用其它已经声明的度量:
averageOrderValue: {
  sql: `${totalAmount} / NULLIF(${count}, 0)`,
  type: 'number'
}NULLIF(..., 0) 包装分母,避免在特定筛选维度下因分母为 0 导致数据库抛出 Division by zero 错误。
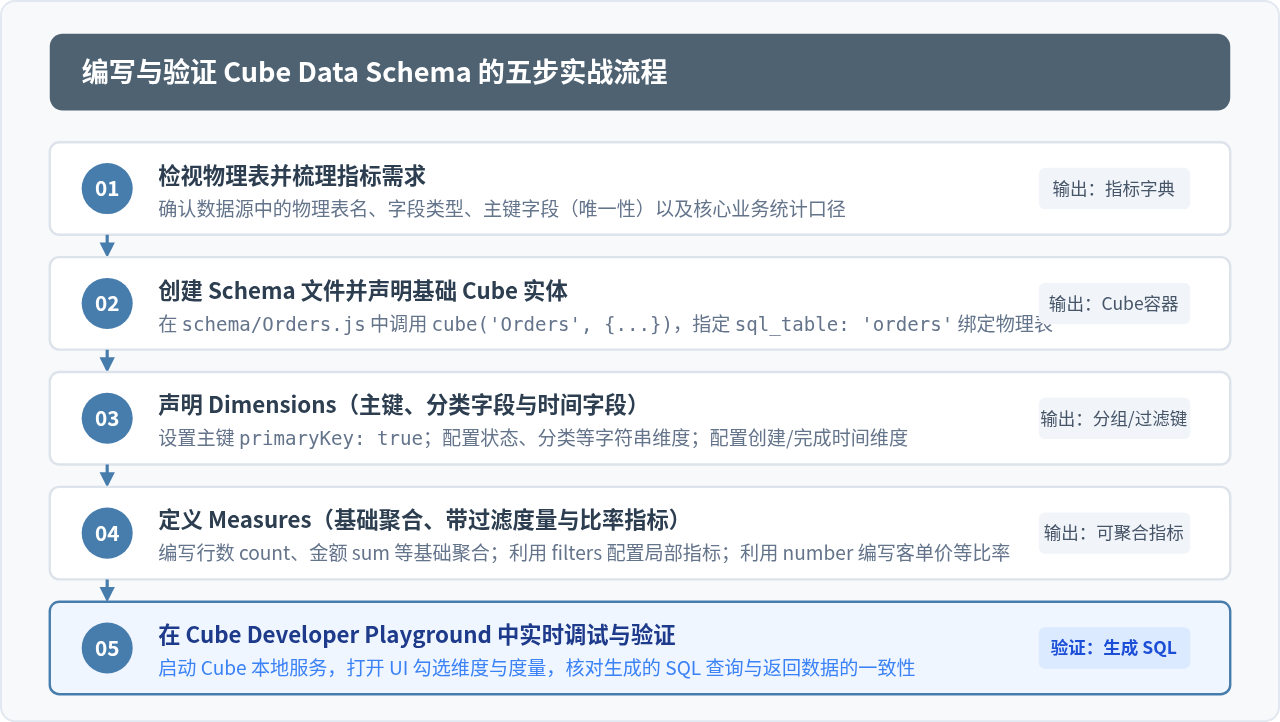
五、实操步骤:从原始表到可查询 Schema 的完整开发流程
编写 Cube.js Data Schema 应当遵循严格的递进顺序,从表结构梳理到本地开发沙箱验证,确保每个指标的口径符合预期。
-
步骤 1:检视物理表与业务目标
连接数据库,检查目标表的字段类型、是否存在空值以及主键约束。与业务方明确指标口径,例如订单金额是否包含优惠券扣减。
-
步骤 2:新建 Schema 文件并绑定数据源
在项目的
schema/目录下新建文件(如Orders.js),使用cube('Orders', { sql_table: 'orders' })构建基础框架。 -
步骤 3:定义 Dimensions 属性与唯一主键
依次添加主键
id并设置primaryKey: true;加入分类维度(如status)和时间戳维度(如createdAt)。 -
步骤 4:定义 Measures 聚合度量
添加基础聚合度量
count和totalAmount;根据业务需要加入filters条件度量与比率衍生度量。 -
步骤 5:在 Cube Developer Playground 中调试验证
运行
npm run dev启动 Cube 本地服务,访问http://localhost:4000进入 Playground 界面。勾选刚定义的维度与度量,观察生成并发送到数据库的真实 SQL,核对返回的数据行与指标数值。
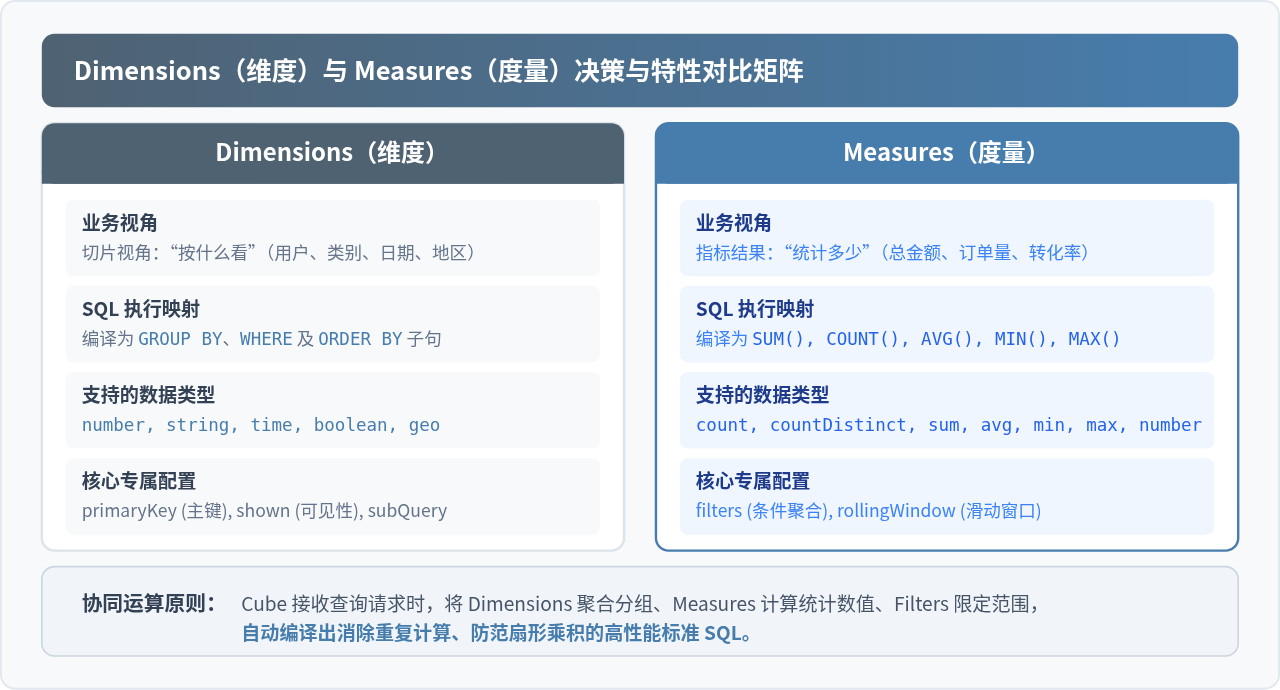
六、Dimensions 与 Measures 决策对比与速查矩阵
初学者在建模时常产生困惑:“金额”到底该作为 Dimension 还是 Measure?“用户年龄”该怎么定义?
判断的核心依据在于业务使用意图:如果需要按其作为行标签分组拆解或作为区间筛选条件,它就是 Dimension;如果需要统计它的总数、平均数或分布总和,它就是 Measure。在某些场景下一个字段可以同时衍生为两者(例如:作为单价维度的 unitPrice 与作为平均单价度量的 avgUnitPrice)。
| 对比要素 | Dimensions(维度) | Measures(度量) |
|---|---|---|
| 业务角色 | 定义切片视角,回答“按什么看” | 输出汇总数值,回答“统计是多少” |
| SQL 编译目标 | 编译为 GROUP BY、WHERE、ORDER BY |
编译为 SELECT 中的聚合函数(SUM、COUNT 等) |
| 支持类型 | string, number, time, boolean, geo |
count, countDistinct, sum, avg, min, max, number |
| 核心配置项 | primaryKey, shown, subQuery |
filters, rollingWindow, drillMembers |
| 典型示例 | 用户城市、下单日期、商品品类、订单状态 | 总销售额、支付订单数、独立访客 UV、平均客单价 |
七、编写避坑指南与最佳实践
在实际生产环境中编写 Schema 时,以下几个关键注意事项能避免常见隐患:
- 主键缺失引发的扇形重复统计(Fan-out):当两个 Cube 发生
joins连接时,如果多对一或者一对多关系中没有正确声明primaryKey: true,多表关联可能会导致度量求和被重复翻倍。Cube.js 依赖主键来在生成 SQL 时执行子查询或两阶段聚合消除重复。 - 避免在维度中写聚合函数:Dimensions 的
sql表达式中绝对不能包含SUM()或COUNT()等聚合函数。所有聚合计算必须且只能在 Measures 中声明。 - 谨慎使用 countDistinct:在超大数据量(千万级以上)的列上执行
countDistinct会对数据库造成较大的性能负担。若底层是 ClickHouse 或 Doris 等引擎,可结合底层引擎的 HyperLogLog 近似算法或在 Cube 中配置预聚合(Pre-aggregations)进行加速。 - 命名一致性:字段名统一采用驼峰式命名(如
createdAt、totalAmount),保持业务字段名称在整个团队的数据字典中规范统一。
掌握了 Cubes、Dimensions 与 Measures 的定义规则后,即可为系统搭建起清晰、坚固的数据语义基石。后续无论是扩展表间 joins 关联、定义细粒度的行级权限(Data Security),还是配置预聚合加速(Pre-aggregations),都能在此模型架构上自然延展。
全栈开发中JavaScript与Java怎么协作?前后端技术栈配合解析
2026-11-04 11:08:24
Node.js官网访问慢?国内镜像加速下载方案
2026-11-03 18:57:24
Node.js 连接 MySQL 数据库实现增删改查操作
2026-11-03 14:31:14
Windows系统安装Node.js:下载、配置与环境验证
2026-11-03 14:15:56
Linux (Ubuntu/CentOS) 环境下安装Node.js的常用方法
2026-11-03 10:18:39