基于Cube.js构建嵌入式分析仪表板的实践方案
本文详细介绍基于Cube.js构建嵌入式分析仪表板的完整实践方案,涵盖语义建模、多租户行级数据隔离、预聚合查询加速以及前端SDK无缝集成的具体实现。
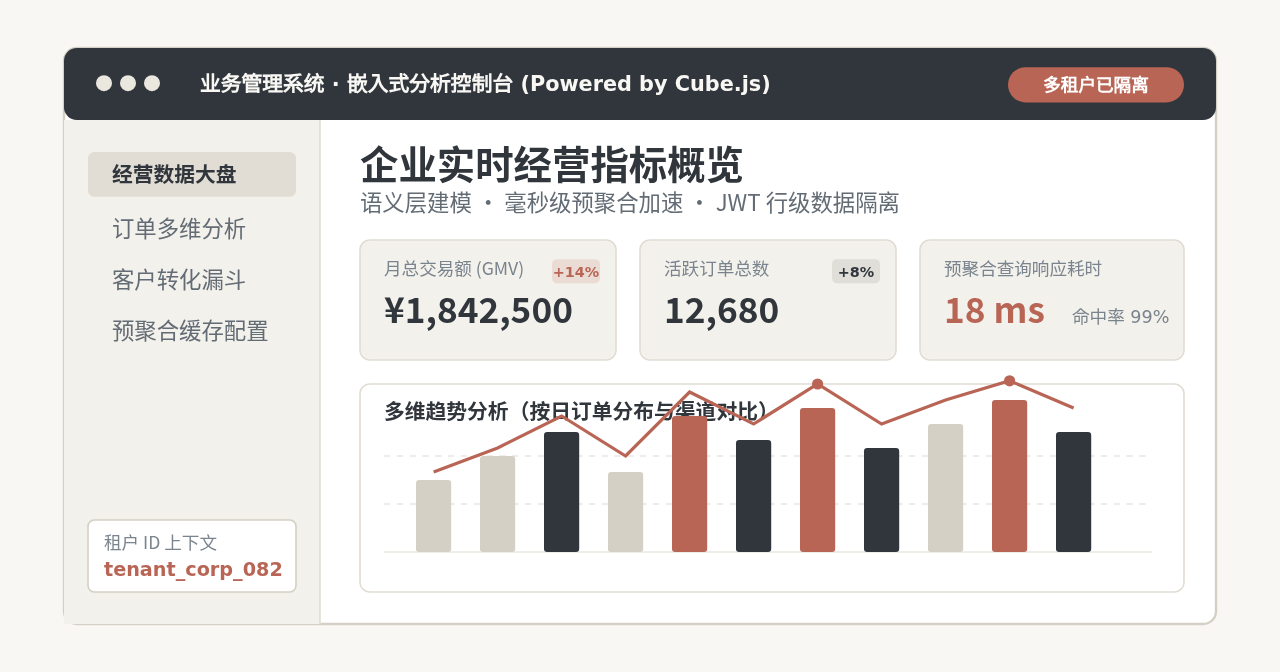
一、嵌入式分析的架构瓶颈与解耦机制
传统的嵌入式分析通常有两种做法:一是在业务后台硬写 SQL API,并在前端用图表库渲染;二是直接通过 <iframe> 嵌入外部商业 BI 系统的仪表板页面。这两种做法在复杂业务场景下各有硬伤。
直接拼接 SQL 的方案初期开发快,但随着业务演进,计算口径往往散落在不同的后端 Controller 中,维护成本急剧膨胀,且缺乏统一的缓存层与多维切片切块能力,极易因为用户查询复杂的宽表而拖垮数据库。而商业 BI 的 <iframe> 方案虽然具备现成的报表设计器,但在多租户账号映射、Token 双向认证、页面样式适配以及前端组件事件联动上限制繁多,用户体验有明显的割裂感。
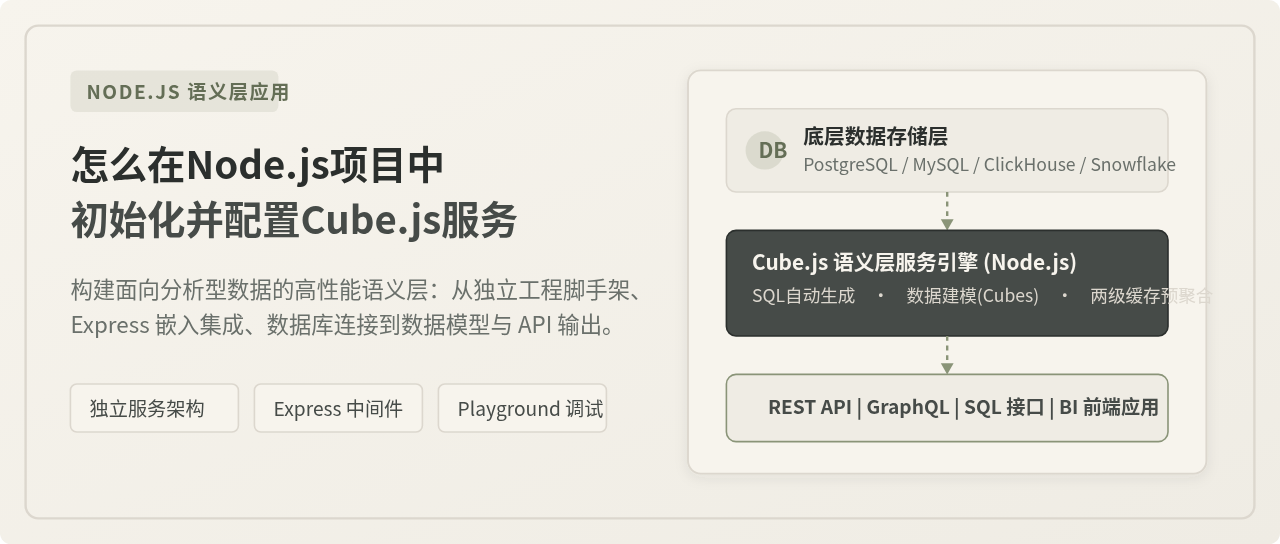
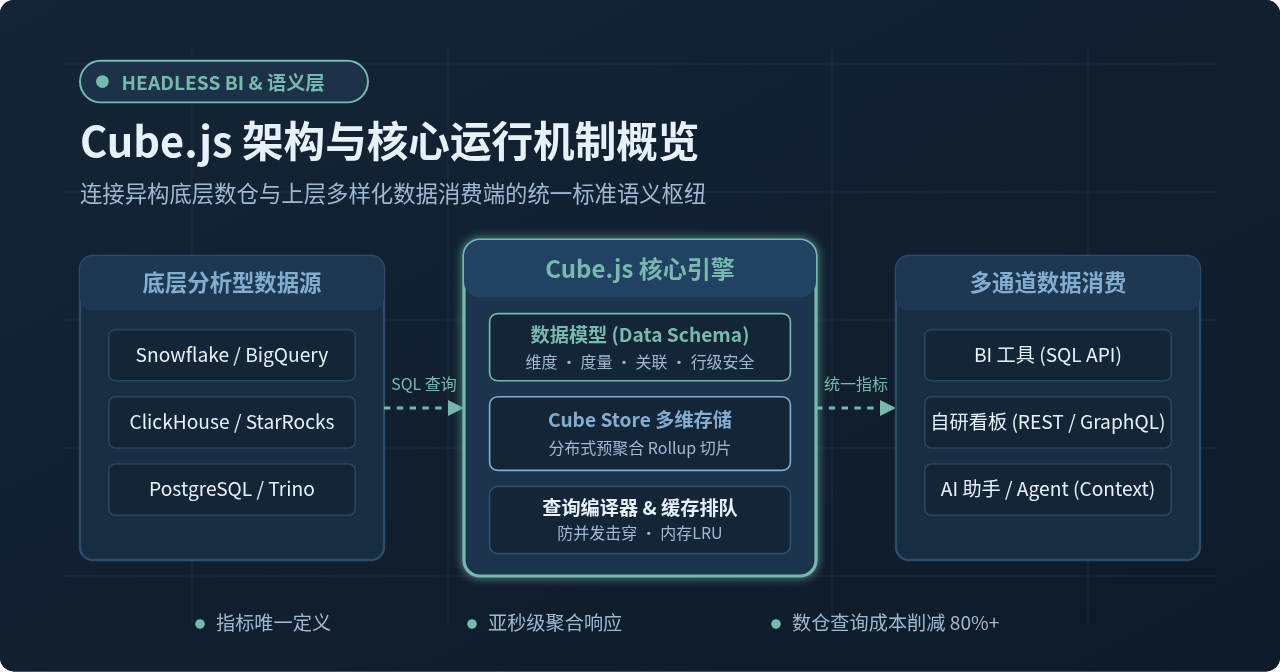
Cube.js 采用无头语义层(Headless Semantic Layer)架构。它本身不包含固定的图表 UI,而是专注于数据连接、指标建模、数据权限注入、预聚合缓存以及通过标准 REST/GraphQL API 输出结构化数据集。业务前端可以使用任意喜欢的图表库(如 ECharts、AntV 或 Chart.js)完全自主定制 UI,同时把指标计算的准确性与查询性能全权托管给 Cube。
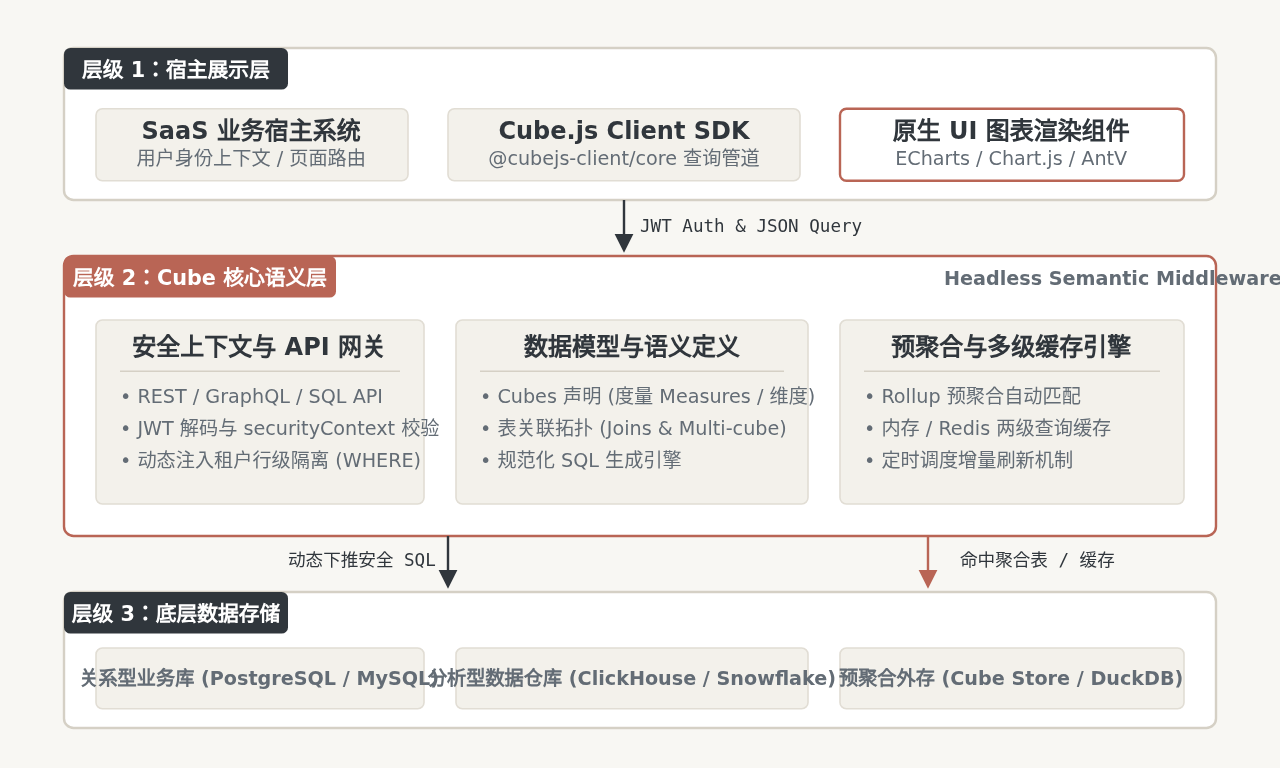
从图 1 可以看出,整个架构被清晰地拆解为三个物理与逻辑层级:
- 宿主展示层:运行在用户的浏览器中,前端应用通过
@cubejs-client/core发送标准查询 JSON,接收规范化的轴数据与序列,与宿主系统的主题、响应式断点无缝集成。 - Cube 语义服务层:部署在内部基础设施中,负责解密客户端 JWT、校验多租户安全上下文(Security Context)、解析数据模型、并自动判断是否命中预聚合表。
- 底层数据源:既可以是 OLTP 业务数据库(如 PostgreSQL、MySQL),也可以是 OLAP 数据仓库(如 ClickHouse、Snowflake)。预聚合引擎可使用 Cube 内置的外部预聚合外存(如 Cube Store、DuckDB)实现海量历史聚合的高速缓存。
二、数据建模:在 Cube 中定义语义与指标
语义层建模是 Cube.js 的核心。Cube 将数据实体抽象为“Cube 对象”,通常存放在项目的 schema/ 目录下。每个 Cube 对象明确划分了业务上的维度(Dimensions)、度量(Measures)以及多表关联(Joins)关系。
以常见的电商或 SaaS 计费系统为例,我们定义一个名为 Orders 的 Cube 模型。该模型不仅定义了交易总额、平均客单价和订单总量,还明确了所属租户 ID 和支付时间维度:
// schema/Orders.js
cube(`Orders`, {
  sql: `SELECT * FROM public.orders`,

  joins: {
    Customers: {
      relationship: `belongsTo`,
      sql: `${CUBE}.customer_id = ${Customers.id}`
    }
  },

  measures: {
    count: {
      type: `count`,
      title: `订单总量`
    },
    totalAmount: {
      sql: `amount`,
      type: `sum`,
      title: `交易总金额`
    },
    averageAmount: {
      sql: `amount`,
      type: `avg`,
      title: `平均客单价`
    }
  },

  dimensions: {
    id: {
      sql: `id`,
      type: `number`,
      primaryKey: true
    },
    tenantId: {
      sql: `tenant_id`,
      type: `string`
    },
    status: {
      sql: `status`,
      type: `string`,
      title: `订单状态`
    },
    createdAt: {
      sql: `created_at`,
      type: `time`,
      title: `下单时间`
    }
  }
});
在上述代码中,指标计算逻辑被严格封装在服务端。前端仪表板在请求“2026年按月统计交易总金额”时,只需要发出包含度量 Orders.totalAmount 和时间维度 Orders.createdAt 的 JSON 查询,而不需要在前端关心底层字段是叫 amount 还是 pay_fee,有效防止了指标口径在不同报表之间的漂移。
三、多租户行级数据隔离与 JWT 安全机制
在嵌入式分析场景中,安全性是第一优先级。如果前端直接将 tenantId = '101' 放在查询参数中发送给分析引擎,攻击者篡改该参数即可横向越权查到其他租户的机密商业数据。Cube.js 提供了基于 securityContext 的行级强制过滤机制,从根本上杜绝越权隐患。
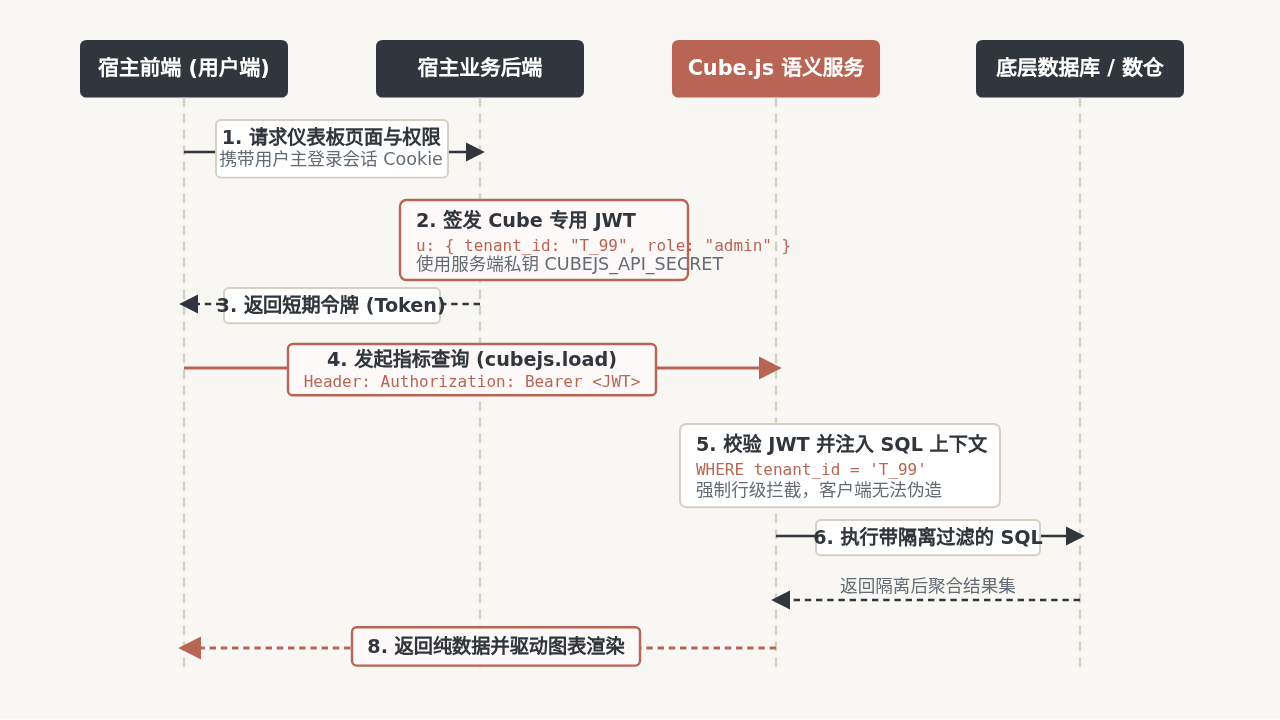
完整的安全认证闭环由宿主后端与 Cube 服务协同完成:
- 当用户登录宿主系统并打开仪表板页面时,宿主后端在验证用户会话后,根据当前用户的租户身份(例如
tenant_id: "T_99"),使用两端约定的CUBEJS_API_SECRET签发一个短期有效的 JWT。 - JWT 的 Payload 中必须包含
securityContext声明,例如:// 宿主后端 Node.js 签发示例 const jwt = require('jsonwebtoken'); const token = jwt.sign( { u: { userId: user.id, tenantId: user.tenantId, // 绑定当前租户 role: user.role }, exp: Math.floor(Date.now() / 1000) + 3600 // 1小时有效 }, process.env.CUBEJS_API_SECRET ); - 在 Cube 服务的配置文件
cube.js中,启用queryRewrite钩子函数。无论前端发送了什么查询参数,Cube 都会拦截该查询并强制追加租户过滤条件:// cube.js (服务端全局配置) module.exports = { queryRewrite: (query, { securityContext }) => { if (!securityContext || !securityContext.u || !securityContext.u.tenantId) { throw new Error('未授权访问:缺少租户安全上下文'); } // 强制向所有查询注入当前租户的过滤限制 query.filters = query.filters || []; query.filters.push({ member: 'Orders.tenantId', operator: 'equals', values: [securityContext.u.tenantId] }); return query; } };
安全实践要点:切勿将 CUBEJS_API_SECRET 暴露给前端代码或推送到公开仓库中。前端只需要接收后端签发的短效 JWT,并通过 HTTP Authorization: Bearer <token> 报头与 Cube 通信。
四、嵌入式落地实施流程与前后端代码集成
将 Cube 落地到现有应用中,应遵循标准化的工程步骤,确保各环节可测试、可回溯。
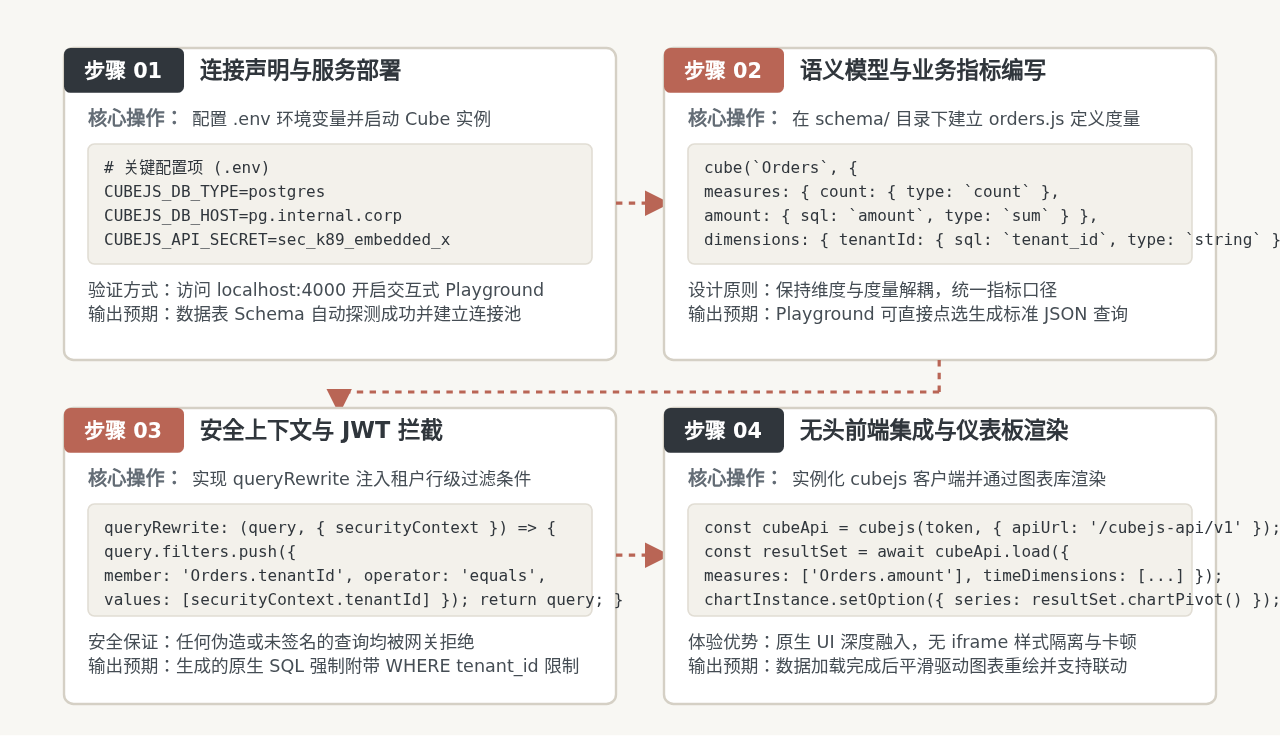
1. 部署与连接声明
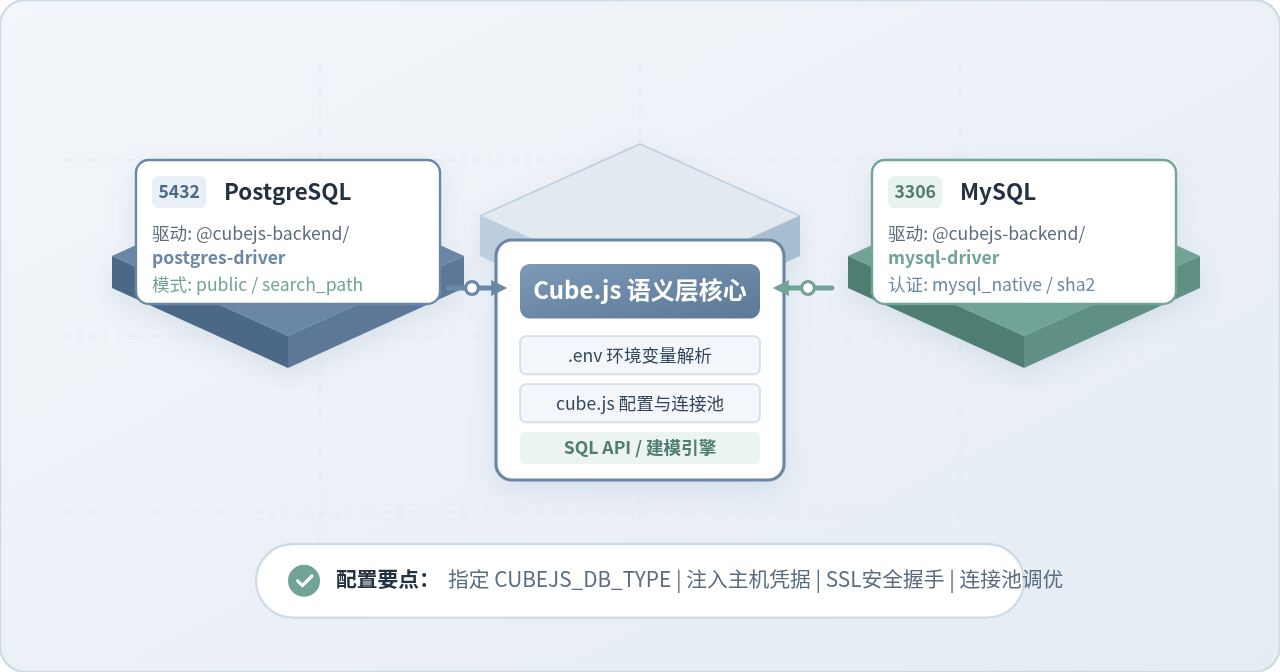
通过官方 Docker 镜像或 Node.js 环境快速启动 Cube 服务。在环境变量中指定数据库类型与连接参数:
# .env
CUBEJS_DB_TYPE=postgres
CUBEJS_DB_HOST=10.0.1.15
CUBEJS_DB_PORT=5432
CUBEJS_DB_NAME=production_biz
CUBEJS_DB_USER=cube_readonly_user
CUBEJS_DB_PASS=StrictSecret981
CUBEJS_API_SECRET=d38f82cb3a9010ecb2984fe72
CUBEJS_DEV_MODE=false
运行 cubejs-server 后,服务默认监听在 4000 端口。在开发阶段,可设置 CUBEJS_DEV_MODE=true 进入可视化管理面板(Playground),直观测试指标 SQL 与预聚合生成。
2. 前端 SDK 集成与图表绑定
在前端应用中安装客户端依赖包:
npm install @cubejs-client/core echarts在业务页面的仪表板组件中,初始化 Cube 客户端,并通过标准异步加载机制获取数据后驱动 ECharts 渲染:
import cubejs from '@cubejs-client/core';
import * as echarts from 'echarts';

// 1. 初始化客户端,传入后端获取的 JWT 令牌
const cubeApi = cubejs(userAuthToken, {
  apiUrl: 'https://analytics.your-saas.com/cubejs-api/v1'
});

async function renderRevenueTrend(containerDom) {
  const myChart = echarts.init(containerDom);
  myChart.showLoading();

  try {
    // 2. 发起语义查询
    const resultSet = await cubeApi.load({
      measures: ['Orders.totalAmount', 'Orders.count'],
      timeDimensions: [{
        dimension: 'Orders.createdAt',
        granularity: 'month',
        dateRange: ['2026-01-01', '2026-12-31']
      }]
    });

    // 3. 使用 resultSet.series() 提取格式化数据
    const seriesData = resultSet.series();
    const categories = resultSet.tablePivot().map(row => row['Orders.createdAt.month']);
    const amounts = resultSet.tablePivot().map(row => Number(row['Orders.totalAmount'] || 0));

    // 4. 配置并渲染原生 ECharts
    myChart.hideLoading();
    myChart.setOption({
      tooltip: { trigger: 'axis' },
      xAxis: { type: 'category', data: categories },
      yAxis: { type: 'value', name: '金额 (元)' },
      series: [{
        name: '月度销售额',
        type: 'bar',
        data: amounts,
        itemStyle: { color: '#B96555' }
      }]
    });
  } catch (err) {
    myChart.hideLoading();
    console.error('仪表板加载失败:', err);
  }
}
五、查询加速:预聚合(Pre-aggregations)策略
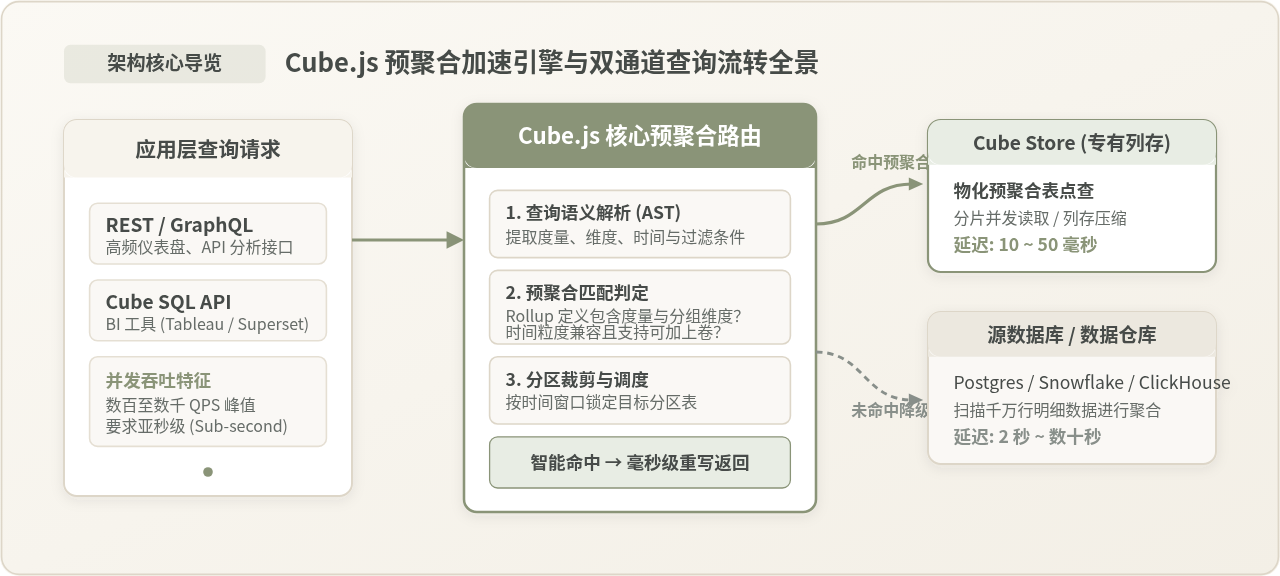
随着业务数据的积累,按年、按月的历史多维聚合查询可能涉及上千万行底层明细记录。如果在用户切换仪表板筛选条件时直接扫描主库,查询延迟可能高达数十秒。Cube 提供了基于 SQL 原理的预聚合(Pre-aggregations)特性,能够在后台自动物化 Rollup 表。
在 Orders 模型中添加预聚合定义:
// 在 Orders Cube 中配置 Rollup 预聚合
cube(`Orders`, {
  // ... 之前的 measures 和 dimensions ...

  preAggregations: {
    monthlyRevenueByTenant: {
      measures: [Orders.totalAmount, Orders.count],
      dimensions: [Orders.tenantId, Orders.status],
      timeDimension: Orders.createdAt,
      granularity: `day`,
      partitionGranularity: `month`,
      refreshKey: {
        every: `1 hour`
      }
    }
  }
});预聚合的核心优势在于智能路由。当用户的查询范围包含在预聚合声明的度量与维度内时,Cube 的 SQL 编译器会自动把查询重写到预聚合物理表上,而不需要开发人员人工修改查询语句。当查询落在预聚合表时,响应时间通常从几秒骤降至 20ms 以内。
通过配置 partitionGranularity: 'month',Cube 会将数据按月进行物理分区。在每日增量数据写入时,调度引擎只需刷新当月对应的分区表,极大节省了系统刷新开销。
六、方案权衡对比与生产部署验证
为了帮助架构与技术团队客观评估落地成本,我们将 Cube.js 方案与主流备选方案进行了系统维度的对比。
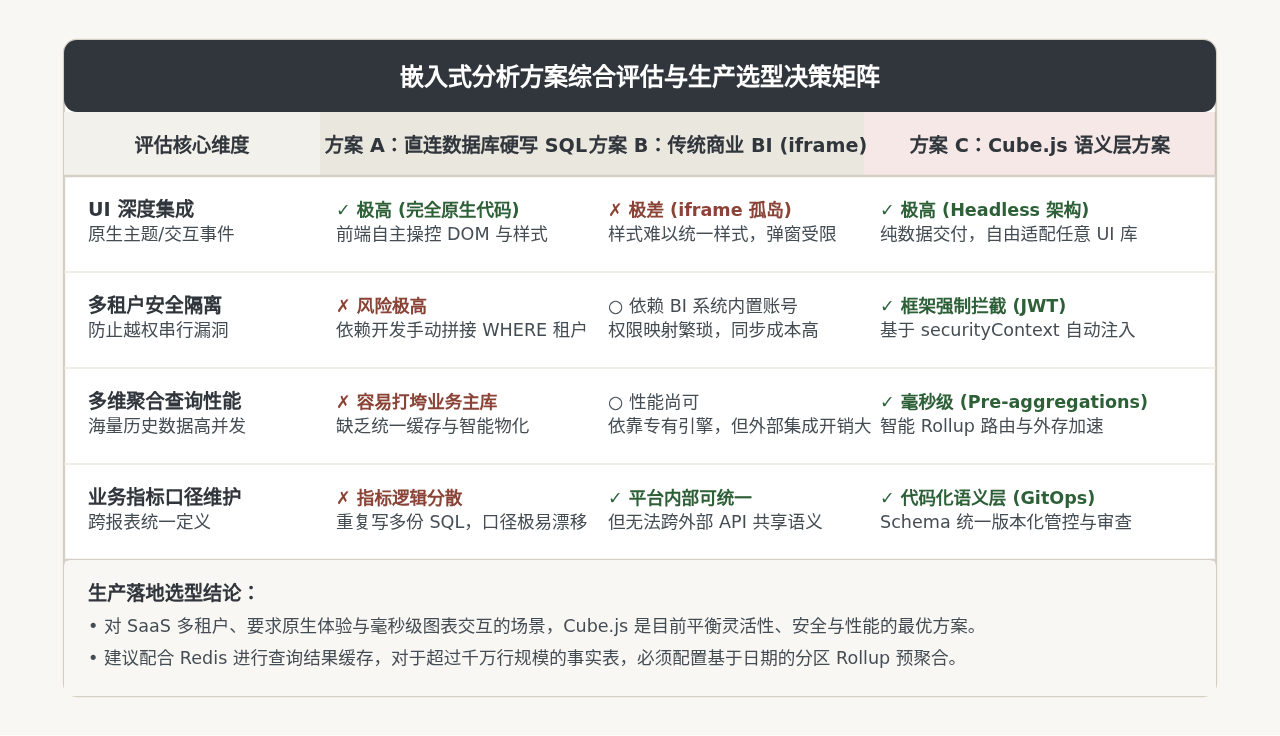
生产环境上线前验证清单
- 只读数据库账号:Cube 连接底层数据库时,必须配置独立的只读账号,严格剥离
INSERT、UPDATE、DELETE权限。 - 连接池与限流:通过
CUBEJS_CONCURRENCY与CUBEJS_DB_MAX_POOL限制并发查询连接数,避免复杂分析峰值将数据库连接池占满。 - 外部分布式缓存:在生产集群中配置 Redis 作为缓存存储(
CUBEJS_CACHE_AND_QUEUE_DRIVER=redis),使多个 Cube 实例能够共享预聚合状态与热点查询结果。 - 安全上下文测试:在上线前编写自动化测试用例,模拟故意篡改 JWT 中
tenantId的越权请求,验证queryRewrite是否能 100% 拦截并返回精准的行级隔离结果。
通过上述方案的系统实施,企业级业务系统不仅能拥有媲美原生功能的可视化分析体验,还能确保业务指标的统一管控与严格的多租户安全防线。
NestJS 是什么?与 Express、Koa 的核心区别及选型建议
2026-11-05 13:46:41
生产环境升级 Node.js 的注意事项与兼容性测试策略
2026-11-05 09:19:24
nvm 常用命令详解:怎么平滑切换和升级 Node.js 版本
2026-11-04 09:02:34
JavaScript和JSP的根本区别:运行环境与执行机制解析
2026-11-03 23:30:18
使用nvm卸载指定版本Node.js并切换默认环境
2026-11-03 23:09:26