怎么在Node.js项目中初始化并配置Cube.js服务
详细讲解如何在Node.js项目中初始化并配置Cube.js服务,涵盖独立微服务与Express嵌入式两种形态、环境变量连接配置、数据模型编写、Playground调试及生产部署安全注意事项。
一、理解 Cube.js 在 Node.js 生态中的定位与数据流
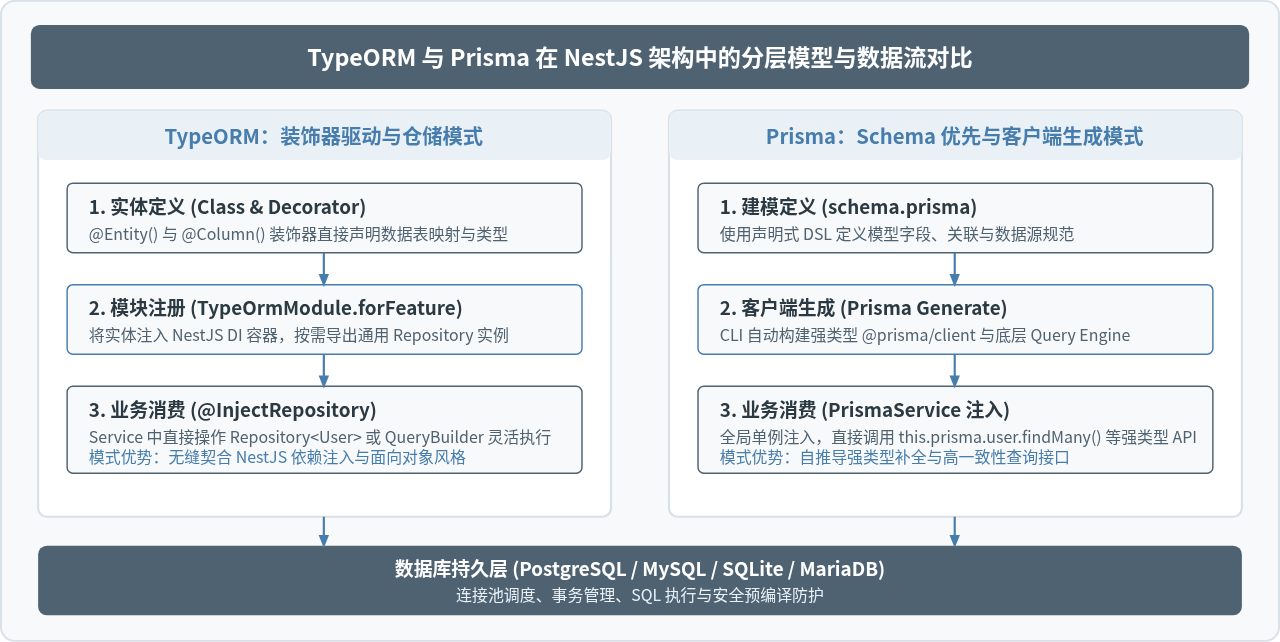
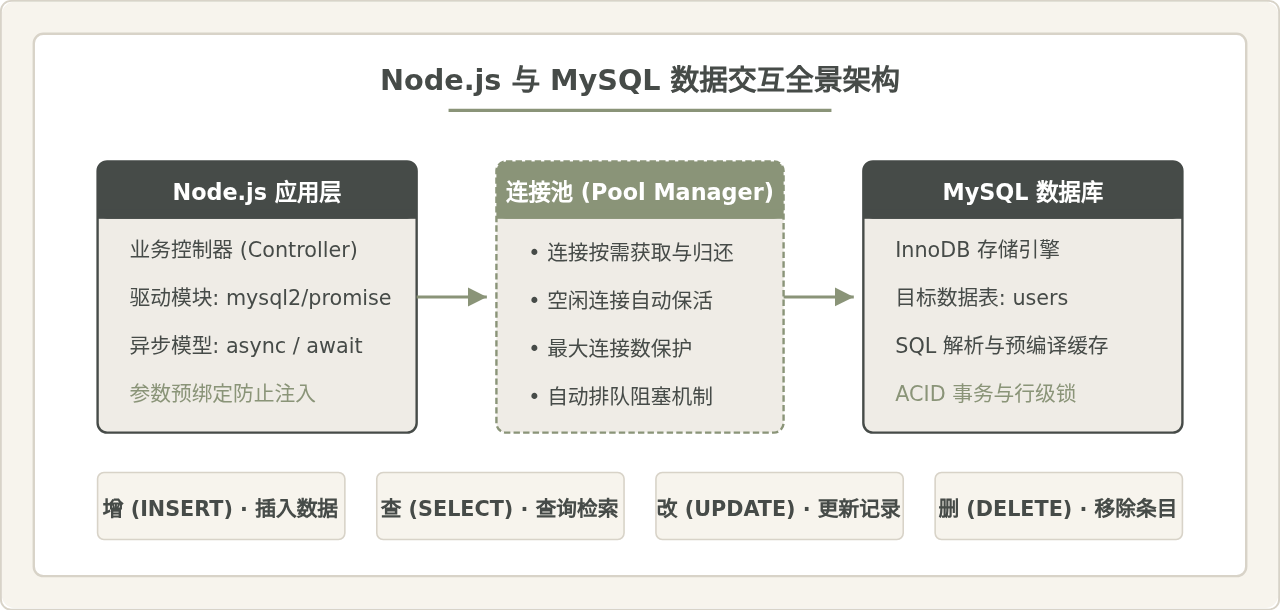
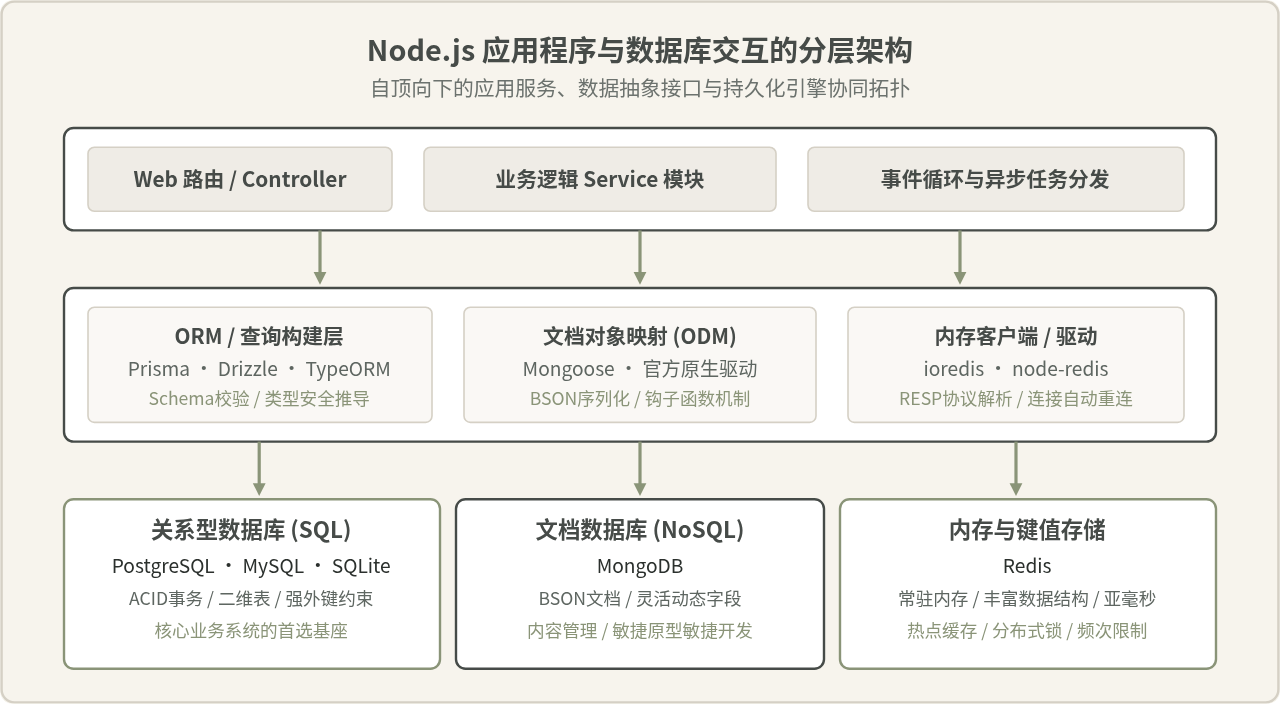
在开展具体编码操作之前,需要准确认识 Cube.js 在整体数据链路中所处的位置。传统 Web 业务系统中,ORM(如 Prisma、TypeORM、Sequelize)主要用于处理行级事务和基本的 CRUD 操作。然而当面对多维度分析、指标聚合、漏斗分析和动态时序统计等复杂分析诉求时,直接在应用代码中拼装繁复的 SQL 极易引发指标口径混乱与数据库过载。
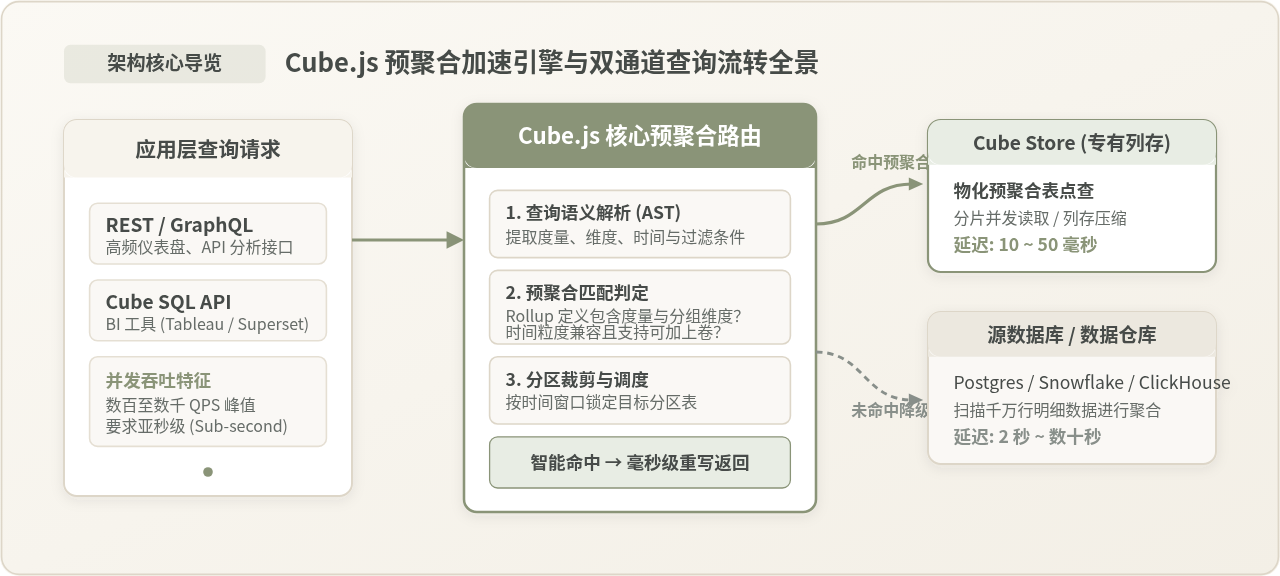
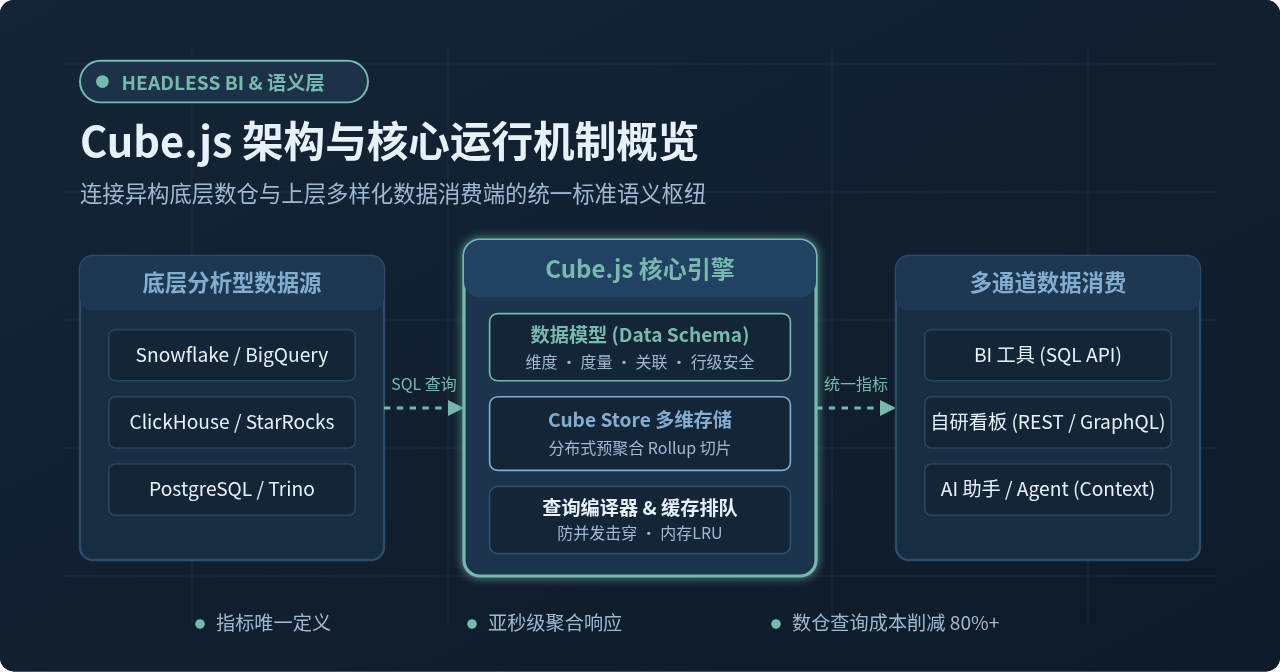
Cube.js(现官方统称为 Cube 或 Cube Core)作为基于 Node.js 运行时构建的开源语义层框架,接收上层客户端通过 REST、GraphQL 或 SQL API 传递的高级分析意图(例如“按月份统计订单状态为已完成的交易总额”),并在内部利用声明式的数据模型将该意图解析编译为针对具体数据库的高效 SQL 查询,同时结合内置的预聚合(Pre-aggregations)和多级缓存机制确保交互式查询的毫秒级响应。
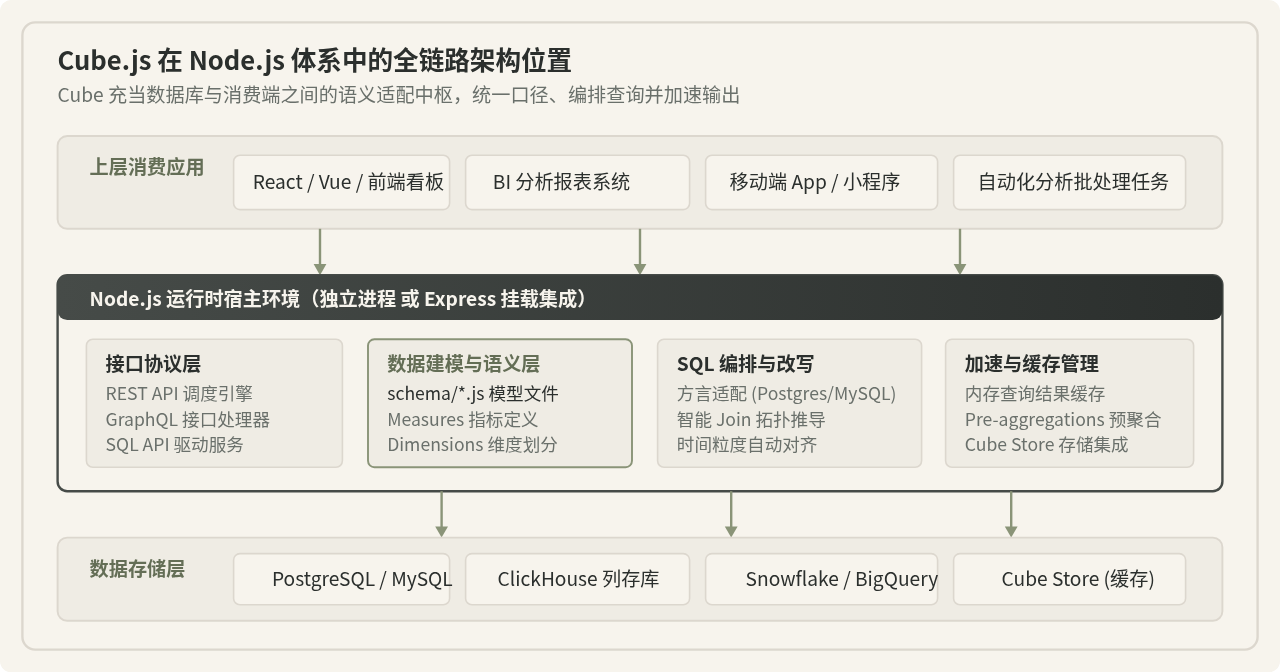
从上图可以看到,Cube.js 服务并不负责生产主数据的原始存储,它依赖底层的真实数据源(如 PostgreSQL、MySQL、ClickHouse 或 Snowflake)。Cube.js 运行在 Node.js 引擎之上,向上提供稳定的分析型接口契约,对外解耦了客户端与底层数据表物理结构的直接关联。
二、初始化方式辨析:独立微服务还是嵌入式集成?
在社区与日常工程实践中,常常能听到一种说法:“在 Node.js 体系里引入 Cube.js,必须另外单独部署一台独立的微服务服务器,不能直接写在现有的后端工程里”。
这种说法看似合理,主要是因为独立微服务形态在官方文档中被作为标准实践推荐,且 Cube.js 官方脚手架默认生成的项目即为一个独立的 Node.js 进程。独立运行确实能做到物理资源隔离——当某个分析看板发起耗费大量 CPU 与内存的复杂聚合运算时,计算压力会被隔离在 Cube 节点内部,不至于拖慢主站用户登录与下单等核心业务接口。
但这并不意味着它无法嵌入。Cube.js 官方提供了高度解耦的底层包 @cubejs-backend/server-core,允许开发者将其作为标准中间件直接挂载至现有的 Express、Koa 等 Node.js 应用实例上。在单体应用阶段或资源受限的中小型内部系统中,采用嵌入式方式不仅能够直接共享主工程的端口与登录鉴权(如 Session 或 JWT 中间件),还能有效避免维护多个服务节点的额外运维成本。
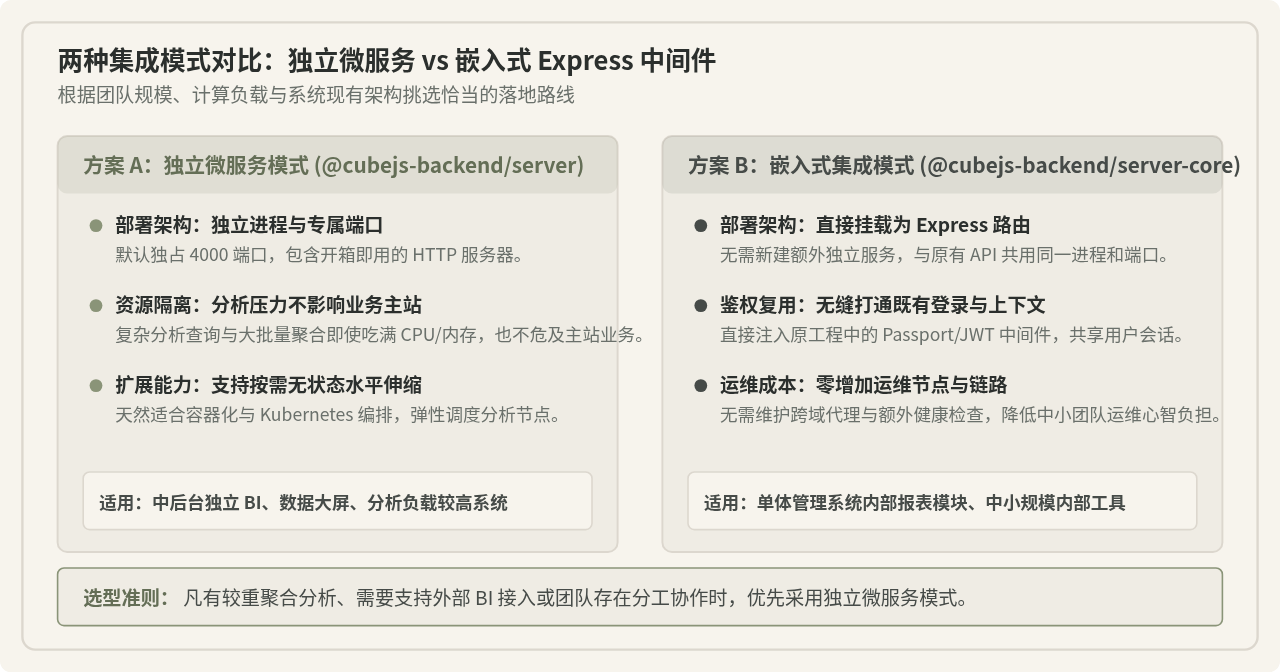
基于上述对比,读者可根据自身项目的实际阶段进行取舍:如果服务分析负载较高、团队有明确的微服务拆分规划,建议采用“模式一:独立微服务”;如果是已有 Express 后端需要快速内嵌数据报表模块,则推荐采用“模式二:嵌入式集成”。
三、初始化与配置全流程步骤概览
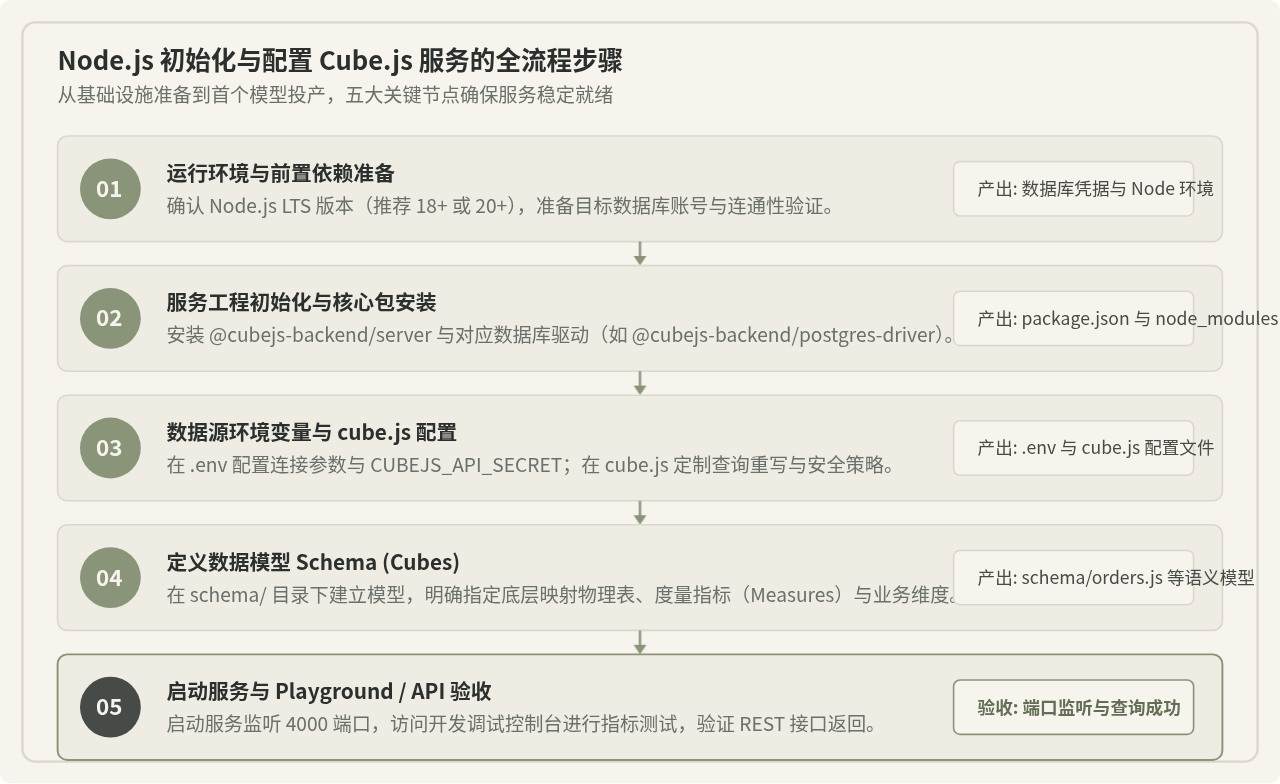
无论选择哪种集成方式,搭建 Cube.js 服务均包含五个核心步骤:前置环境核对、依赖安装、连接配置、数据建模与启动验证。遵循规范的操作步骤有助于排查每个环节的配置有效性,避免把配置错误留到联调阶段。
四、模式一:初始化独立的 Cube.js 服务(标准方案)
本节演示从零搭建一个独立的 Cube.js 分析服务工程。首先请确认本机或服务器上已经安装了 Node.js LTS 版本(推荐 Node.js 18.x 或 20.x,支持 ES6+ 语法)。
1. 初始化工程目录与安装依赖
在终端中新建服务工作目录,并初始化 package.json 文件:
# 创建工作目录并进入
mkdir cube-analytics-service
cd cube-analytics-service

# 初始化 Node.js 工程
npm init -y
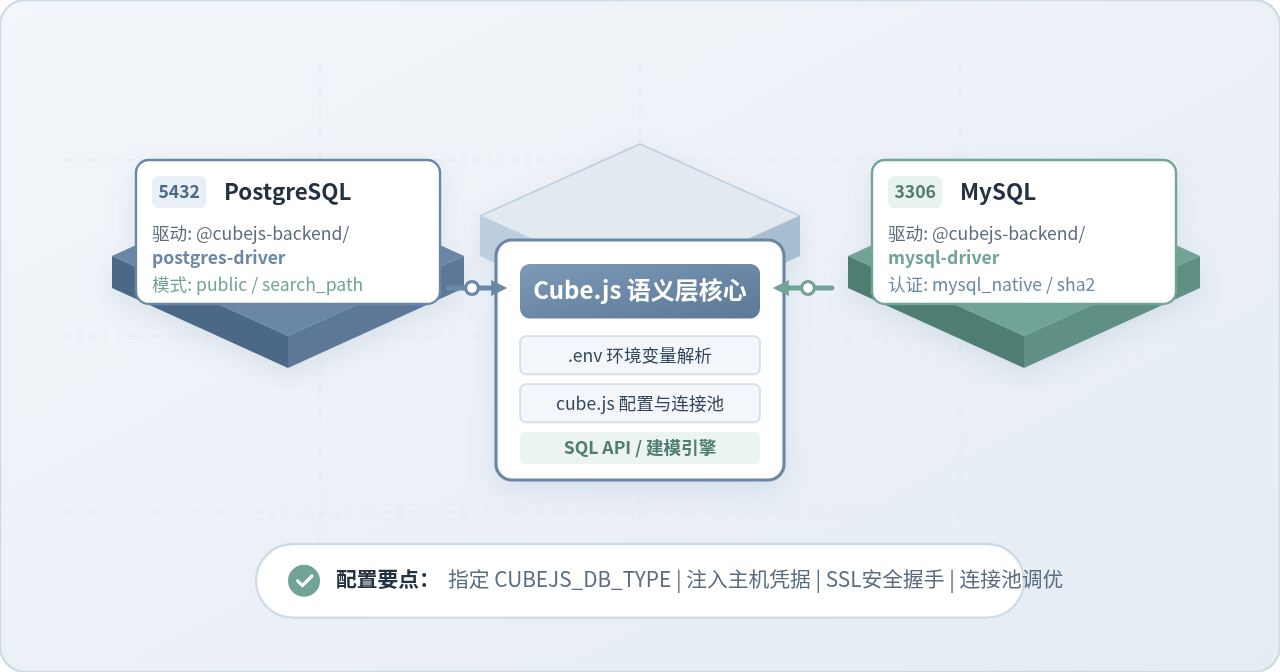
接下来安装 Cube.js 核心服务包 @cubejs-backend/server 以及与底层数据库相匹配的驱动包。以最常见的 PostgreSQL 为例(若使用 MySQL 则安装 @cubejs-backend/mysql-driver,若使用 ClickHouse 则安装 @cubejs-backend/clickhouse-driver):
# 安装 Cube.js 核心服务端与 PostgreSQL 驱动
npm install --save @cubejs-backend/server @cubejs-backend/postgres-driver dotenv
安装完成后,检查 package.json 的 dependencies 字段,确认各依赖包已成功写入:
{
  "name": "cube-analytics-service",
  "version": "1.0.0",
  "main": "index.js",
  "scripts": {
    "dev": "cubejs-server",
    "start": "cubejs-server"
  },
  "dependencies": {
    "@cubejs-backend/postgres-driver": "^0.35.0",
    "@cubejs-backend/server": "^0.35.0",
    "dotenv": "^16.4.5"
  }
}
2. 配置数据源环境变量(.env)
Cube.js 严格遵循十二要素应用规范,推荐使用环境变量管理敏感凭据与网络端点。在项目根目录下创建 .env 文件:
# 数据库类型与连接配置
CUBEJS_DB_TYPE=postgres
CUBEJS_DB_HOST=127.0.0.1
CUBEJS_DB_PORT=5432
CUBEJS_DB_NAME=analytics_demo
CUBEJS_DB_USER=cube_reader
CUBEJS_DB_PASS=SecurePassword123

# Cube 内部通讯与 API 安全密钥(生产环境必须设置强随机字符串)
CUBEJS_API_SECRET=4f8b9e2c6d1a7350f089e81b672a91d2

# 服务端口配置(默认为 4000)
PORT=4000

# 开发模式开关(在本地开发时启用以开启内置 Playground 控制台)
CUBEJS_DEV_MODE=true为 Cube.js 配置数据库账号时,强烈建议分配只读权限(SELECT),禁止赋予 DROP、UPDATE、DELETE 或 ALTER 等数据写入与修改权限。分析引擎只需要读取原始事实表和维度表,只读账号能从根源上杜绝任何非预期的误操作风险。
3. 编写核心配置文件(cube.js)
Cube.js 服务启动时会自动读取根目录下的 cube.js 配置文件。该文件用于定义安全策略、SQL 重写钩子、多租户上下文逻辑以及系统配置项。在项目根目录创建 cube.js:
// cube.js - Cube.js 服务主配置文件
module.exports = {
  // 禁用向官方发送匿名遥测数据
  telemetry: false,

  // 配置上下文提取逻辑(用于多租户行级数据隔离或用户权限判定)
  contextToAppId: ({ securityContext }) => {
    return securityContext && securityContext.tenantId
      ? `APP_${securityContext.tenantId}`
      : 'APP_DEFAULT';
  },

  // 针对特定租户或环境重写查询安全规则
  queryRewrite: (query, { securityContext }) => {
    if (securityContext && securityContext.tenantId) {
      query.filters = query.filters || [];
      query.filters.push({
        member: `${query.measures[0] ? query.measures[0].split('.')[0] : 'Orders'}.tenantId`,
        operator: 'equals',
        values: [securityContext.tenantId]
      });
    }
    return query;
  }
};
五、模式二:在现有 Express 项目中嵌入 Cube.js
如果当前工程已经是一个成型的 Express 后端,不希望为了分析功能单独开辟新进程,可以使用 @cubejs-backend/server-core 进行内嵌集成。
1. 安装核心适配器依赖
在现有 Express 项目根目录下执行安装:
npm install --save @cubejs-backend/server-core @cubejs-backend/postgres-driver2. 挂载中间件到 Express 实例
在 Express 的入口脚本(例如 app.js 或 server.js)中,引入 CubejsServerCore 并调用 initApp() 挂载 API 处理路由:
// server.js - 在现有的 Express 应用中集成 Cube.js
const express = require('express');
const CubejsServerCore = require('@cubejs-backend/server-core');
require('dotenv').config();

const app = express();
const PORT = process.env.PORT || 3000;

// 初始化 Cube 核心实例
const cubejsCore = CubejsServerCore.create({
  dbType: process.env.CUBEJS_DB_TYPE || 'postgres',
  apiSecret: process.env.CUBEJS_API_SECRET,
  devMode: process.env.NODE_ENV !== 'production',
  telemetry: false
});

// 将 Cube.js 的 REST 与 WebSocket 路由自动注入到 Express app 中
// 默认提供 /cubejs-api/v1/* 访问路径
cubejsCore.initApp(app);

// 现有的业务接口仍然正常工作
app.get('/api/health', (req, res) => {
  res.json({ status: 'ok', service: 'main-api' });
});

app.listen(PORT, () => {
  console.log(`主服务及内嵌 Cube.js 运行于端口 http://localhost:${PORT}`);
});
六、编写第一个数据模型 Schema
Cube.js 服务本身并不自动感知业务逻辑,它依赖数据模型(Schema)来知晓“什么是度量”、“什么是维度”以及“如何关联表”。在工程根目录下创建名为 schema 的文件夹,并在其中创建首个模型文件 schema/Orders.js。
假设底层数据库中存在一张名为 orders 的订单明细表,结构包含 id、amount、status、created_at、user_id 等字段:
// schema/Orders.js
cube(`Orders`, {
  // 映射到底层物理数据表,支持具体模式名前缀如 public.orders
  sql_table: `public.orders`,

  // 主键声明:保障去重统计与关联计算时的行唯一性
  joins: {
    // 如需多表关联,可在此声明关联关系
  },

  // 度量(Measures):数值型计算指标,如求和、计数、平均值
  measures: {
    count: {
      type: `count`,
      title: `订单总笔数`
    },

    totalAmount: {
      sql: `amount`,
      type: `sum`,
      title: `订单销售总额`
    },

    averageAmount: {
      sql: `amount`,
      type: `avg`,
      title: `平均客单价`
    }
  },

  // 维度(Dimensions):用于过滤、切片与分组的属性,如时间、状态、类别
  dimensions: {
    id: {
      sql: `id`,
      type: `number`,
      primary_key: true
    },

    status: {
      sql: `status`,
      type: `string`,
      title: `订单状态`
    },

    createdAt: {
      sql: `created_at`,
      type: `time`,
      title: `下单时间`
    }
  }
});
七、启动服务与结果验证
完成环境变量配置与模型定义后,即可启动服务并验证结果。
1. 本地启动与控制台输出
在 cube-analytics-service 目录下执行启动命令:
npm run dev启动成功后,终端将输出如下关键日志(示例输出):
-- 示例控制台输出 --
[Cube.js Server] 🚀 Cube.js server is listening on 4000
[Cube.js Server] 🔓 Authentication is enabled (CUBEJS_API_SECRET is set)
[Cube.js Server] 📊 Dev mode is enabled. Open http://localhost:4000 to access Developer Playground
2. 访问 Developer Playground 交互式调试
在浏览器中打开 http://localhost:4000,将看到 Cube.js 内置的 Developer Playground 控制台:
- 查看 Schema:确认刚刚定义的
Orders及其度量(Measures)与维度(Dimensions)已正确解析。 - 构建查询:勾选“订单销售总额(totalAmount)”,按“下单时间(createdAt)”的“Month”粒度拆分,并按“订单状态(status)”进行过滤。
- 查看生成 SQL:点击界面中的“SQL”选项卡,观察 Cube.js 为目标数据库自动生成的原生 SQL,核对分组聚合与时间截断函数(如
date_trunc)是否合理。
3. 通过 REST API 验证数据输出
上层前端或其它服务可以通过标准的 HTTP POST 请求向 Cube 发起聚合查询。使用 curl 工具执行查询测试:
curl -X POST http://localhost:4000/cubejs-api/v1/load \
  -H "Content-Type: application/json" \
  -H "Authorization: 4f8b9e2c6d1a7350f089e81b672a91d2" \
  -d '{
    "query": {
      "measures": ["Orders.totalAmount", "Orders.count"],
      "dimensions": ["Orders.status"]
    }
  }'
服务端将返回标准的 JSON 结构响应,字段清晰包含聚合结果与元数据(示例输出):
{
  "query": {
    "measures": ["Orders.totalAmount", "Orders.count"],
    "dimensions": ["Orders.status"]
  },
  "data": [
    {
      "Orders.status": "completed",
      "Orders.totalAmount": 128500.50,
      "Orders.count": 342
    },
    {
      "Orders.status": "processing",
      "Orders.totalAmount": 15420.00,
      "Orders.count": 48
    }
  ],
  "lastRefreshTime": "2026-10-31T14:50:00.000Z",
  "annotation": {
    "measures": {
      "Orders.totalAmount": { "title": "订单销售总额", "type": "number" },
      "Orders.count": { "title": "订单总笔数", "type": "number" }
    },
    "dimensions": {
      "Orders.status": { "title": "订单状态", "type": "string" }
    }
  }
}
八、常见困惑与认知误区辨析
1. 误区一:“Cube.js 会把数据库的所有数据全部缓存到内存里,导致内存溢出”
辨析:这种担忧在接触大数据量场景时十分普遍,但该理解存在偏差。Cube.js 并不是全量内存数据库。对于未配置预聚合(Pre-aggregations)的常规查询,Cube.js 仅在收到请求时动态将聚合计算逻辑编译为 SQL 并下推到底层数据库执行,数据库返回聚合后的少量结果集(如数十条或数百条分组汇总数据),Cube.js 仅在内存中暂存该最终聚合结果一段短暂时间(由内存缓存 TTL 控制,默认几分钟)。
即便开启了预聚合,Cube.js 也是在底层数据库或独立的 Cube Store 中构建物化汇总表,而非把千万行原始数据塞进 Node.js 进程内存。因此只要不刻意下发一次性返回数百万行明细记录的非聚合大查询,Node.js 进程本身的内存占用是相对平稳可控的。
2. 误区二:“既然已经用了 Prisma / TypeORM,就完全不需要 Cube.js”
辨析:两者属于不同维度的工具,并不互斥。ORM 擅长行级事务、模型实体关系映射、数据写入验证与数据迁移;而 Cube.js 专注于读密集型的多维统计分析、时间窗口滑动、跨表复杂指标计算与缓存预热。在实际架构中,常见的优秀搭配是:主业务 CRUD 依赖 ORM 保证数据事务一致性,数据看板与报表分析模块则请求由 Cube.js 暴露的统一语义接口,各司其职。
九、生产环境配置审查清单
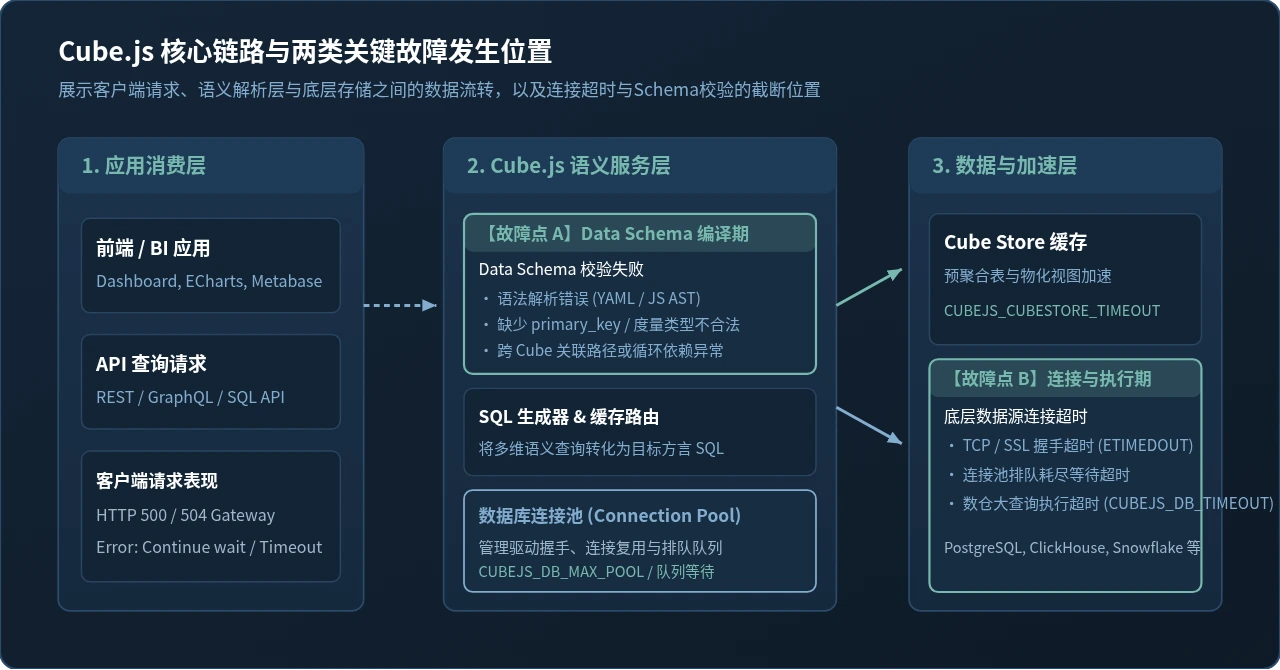
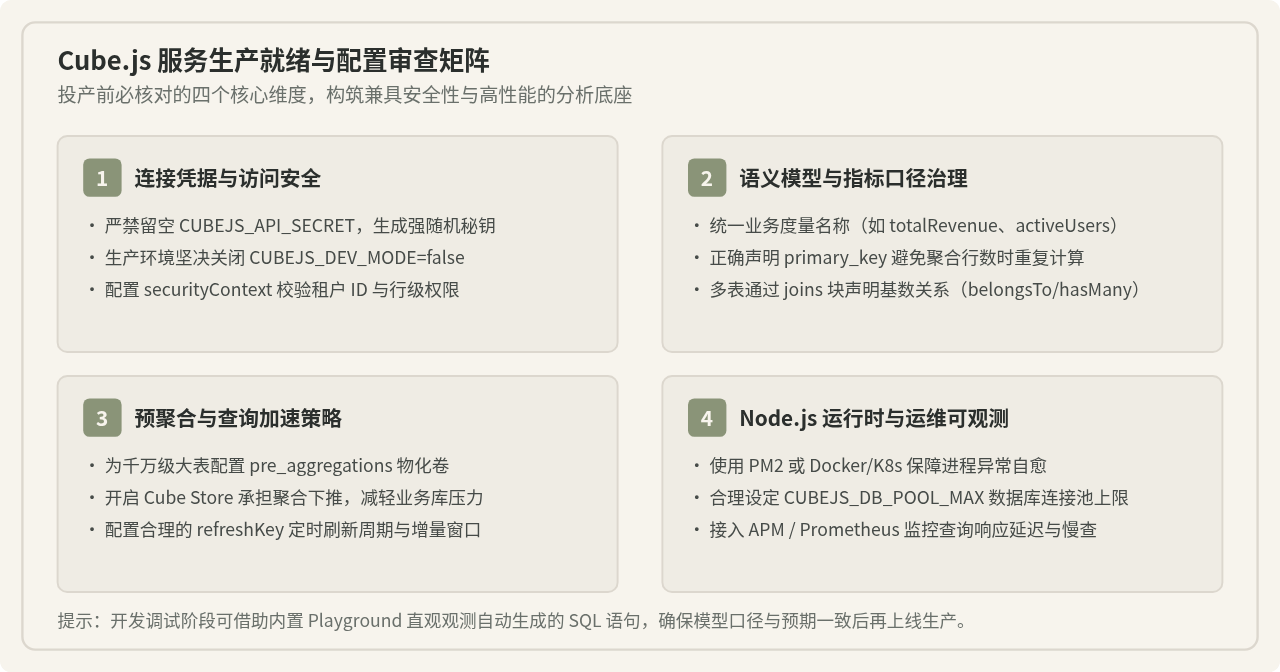
将服务推向生产环境前,建议对照下表与图示完成全要素配置复核,避免因遗漏基础安全与性能参数引发线上故障。
| 配置维度 | 关键配置项 | 生产推荐设置 | 主要作用与防护目标 |
|---|---|---|---|
| 安全防护 | CUBEJS_API_SECRET | 强随机 32 位以上字符串 | 防止未经授权的公网匿名访问与数据泄露 |
| 调试开关 | CUBEJS_DEV_MODE | false | 关闭内置的 Playground 界面与敏感元数据暴露 |
| 连接池 | CUBEJS_DB_POOL_MAX | 根据业务并发设定(如 10 ~ 20) | 防止高并发分析查询瞬间耗尽数据库连接数 |
| 性能加速 | pre_aggregations | 在大数据量 Cube 中按需配置 | 自动构建物化视图,将大表多维查询耗时缩短至毫秒级 |
| 进程自愈 | PM2 / Docker Restart | restart_delay: 3000, max_restarts: 10 | 保障 Node.js 进程发生未捕获异常退出时能迅速恢复 |
十、总结
在 Node.js 生态中初始化并配置 Cube.js 服务,关键在于清晰界定架构形态与配置要素:
- 工程形态选择:根据系统规模选择使用
@cubejs-backend/server构建独立微服务,或者使用@cubejs-backend/server-core无侵入地嵌入既有 Express 业务服务。 - 环境变量与安全底线:务必在
.env中明确数据库连接参数、赋予只读数据库账号,并在生产环境中严格启用CUBEJS_API_SECRET鉴权与关闭DEV_MODE。 - 语义模型规范化:在
schema/目录下以声明式语法精确定义物理表关联、度量(Measures)以及统计维度(Dimensions),实现“业务定义一次,上层多端复用”。 - 演进式性能调优:在数据规模逐步增大时,适时在模型中追加预聚合(Pre-aggregations)规则,以最小的硬件开销支撑高性能数据分析交互。
Node.js 安装配置与第一个 HTTP 服务器编写
2026-11-05 11:41:40
怎么使用 nvm 管理并平滑升级 Node.js 版本
2026-11-04 23:15:07
Node.js 怎么使用 zlib 模块解压 gzip 和 deflate
2026-11-03 23:40:50
直接覆盖安装还是用版本管理器?Node.js 升级方式对比
2026-11-03 22:59:07
Express.js 是什么:Node.js Web 框架核心概念与适用场景
2026-11-03 20:00:12