JS压缩原理是什么?从去除空格到变量名混淆
深入解析 JavaScript 压缩的核心技术原理,从最初级的物理字符与注释剔除,到语法等价变换与常量折叠,再到基于作用域树的变量名混淆与死代码消除。结合完整架构图解与规范示例,助你彻底吃透现代前端打包压缩全流程。
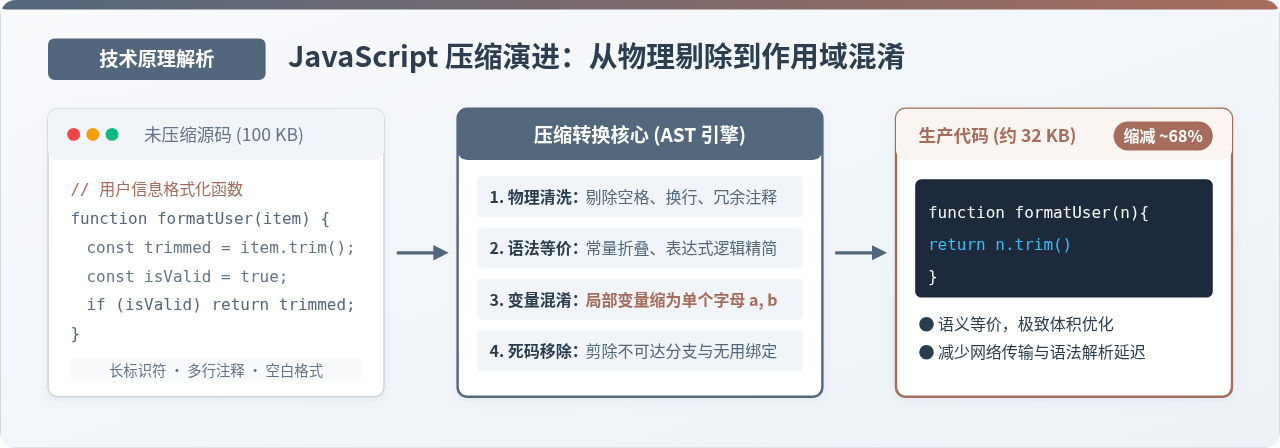
一、为什么不能只用正则表达式替换?
很多开发者初次接触代码压缩时,直觉上会认为这只是个字符串替换任务:写几个正则表达式,把所有的换行符 \n、制表符 \t、连续空格以及 // 和 /* */ 注释删掉,文件体积不就降下来了吗?
但在真正的语法环境中,纯文本替换会瞬间摧毁程序的正确性。考虑下面这段简短却极其典型的代码:
// 示例 1:纯文本替换必然踩坑的场景
const welcomeMessage = "https://example.com/api?debug=true // 此处不是注释";
const pattern = / //.*$/g; // 正则字面量中的斜杠
return value; // 关键关键字与标识符
如果使用简单的正则删除 // 之后的字符,字符串常量内部的 URL 和用于匹配的正则表达式会被直接截断;而如果将所有空格全部抹除,return value 就会变成 returnvalue,导致关键字与变量名直接黏连为未定义的全新标识符,代码在运行时将直接抛出语法错误。
正因如此,现代 JS 压缩器(如 Terser、esbuild、SWC)无一例外遵循编译原理的标准前端管线:必须先通过词法分析器(Lexer)将字符序列分解为一个个具有语法属性的“标记”(Token),再由语法分析器(Parser)将其装配成一棵层次分明的抽象语法树(AST)。只有在掌握了完整语法上下文的前提下,压缩器才能精确裁定哪里的字符可以删除、哪里的标识符可以缩写。
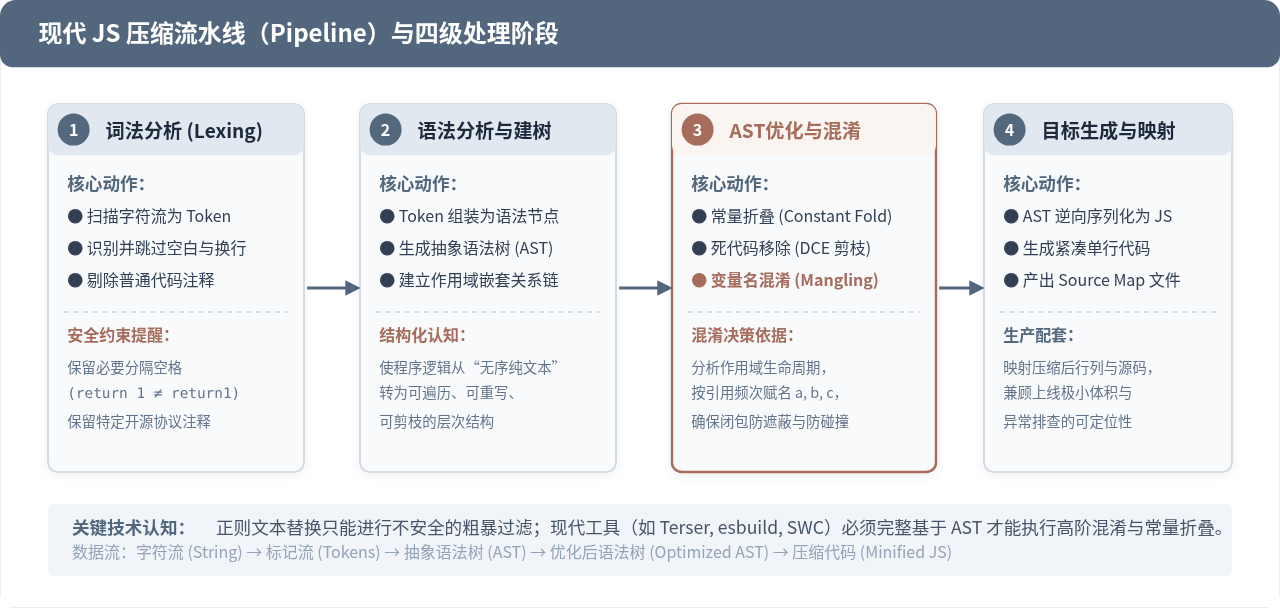
二、物理字符级精简:剥离开发期视觉冗余
压缩流水线的第一道工序是清理仅服务于人类可读性、对机器执行毫无意义的物理字符。在源码解析为 Token 流的过程中,这类精简就已经开始协同运作。
1. 空白符、制表符与换行符的安全剥除
JavaScript 语法规范对空白字符(Whitespace)有着清晰的定义。压缩器通过词法分析可以明确区分两类场景:
- 必需分隔符: 两个相连的关键字、标识符或数值字面量之间,必须保留至少一个分隔符(如
typeof a、let count、12 in arr)。在重组输出时,多余空格均被压制为单个标准空格。 - 非必需空白: 凡是位于操作符、括号、分号、逗号两旁的空白均可安全清除。例如
total = base + tax ;可以直接压缩为total=base+tax;。
2. 注释的彻底清理与版权保护例外
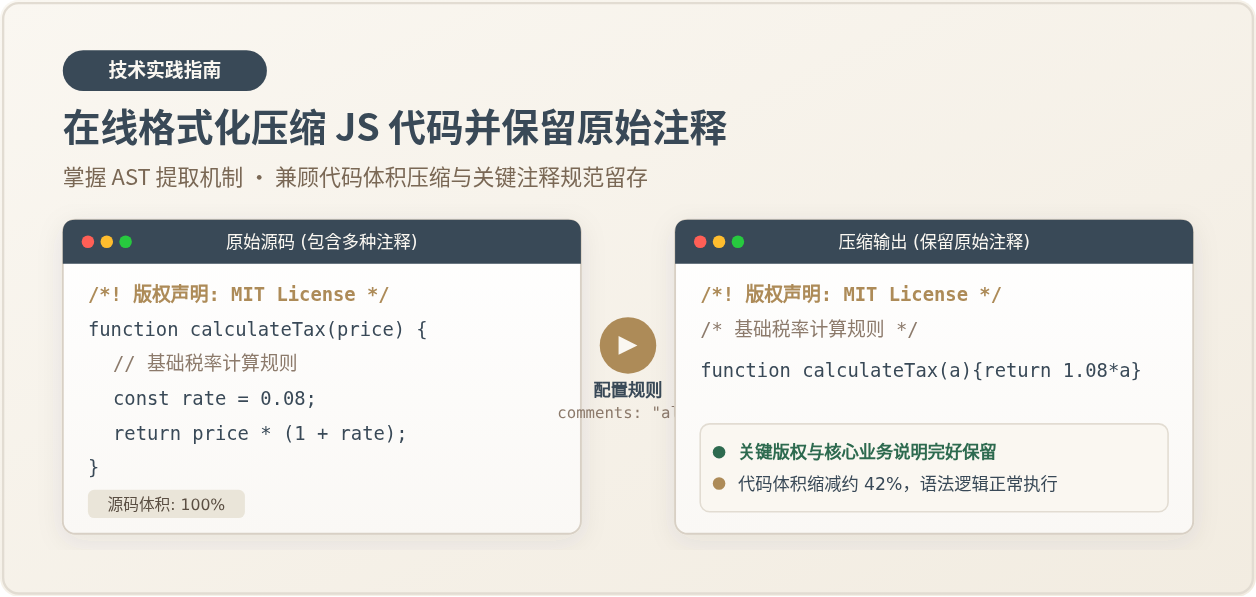
单行注释 // 和多行块级注释 /* ... */ 占据了开发期代码相当一部分体积。在构建生产产物时,压缩器会默认过滤掉所有常规注释。但几乎所有工业级压缩器都留有一个重要例外:法律许可与版权声明保留。
当注释以 /*! 或包含 @license、@preserve 等元信息标记时,打包工具会自动将其提取并保留在打包文件顶部或抽离为单独的 .LICENSE.txt,以满足 MIT、Apache-2.0 等开源协议的合规要求。
三、语法级等价重写:用更少的字节表达相同语义
当代码被解析为抽象语法树(AST)后,压缩工作正式进入“语义等价变换”阶段。此阶段的核心任务是:在保证执行结果与外部可观测行为完全一致的前提下,修改 AST 节点的拓扑结构,选取体积更紧凑的等价表达式。
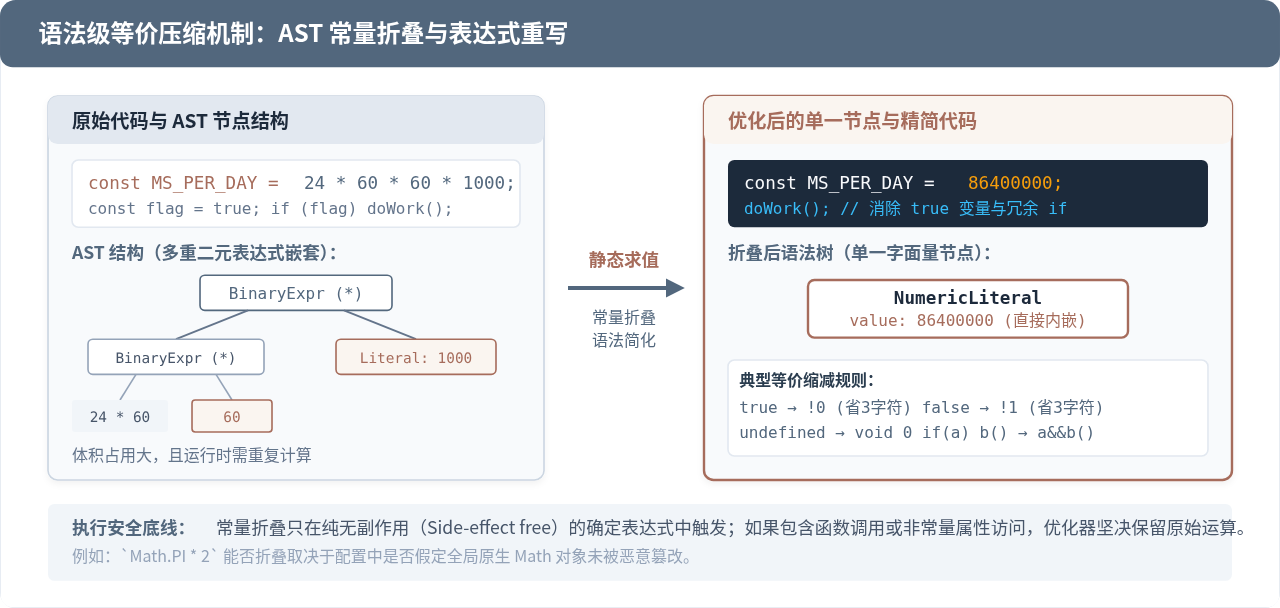
1. 常量折叠(Constant Folding)与静态求值
在日常业务编码中,为了保持代码的可维护性与语义清晰,我们经常写出具有自解释性的算式:
// 开发者源码:保持良好的可读性
const ONE_WEEK_MS = 7 * 24 * 60 * 60 * 1000;
const BUFFER_SIZE = 1024 * 64;
如果直接将这串算式输出到生产包中,不仅浪费了多达数十个字节的体积,还会强迫浏览器的 JS 引擎在运行时进行无意义的乘法运算。压缩器的优化器在遍历 AST 时,一旦识别出二元运算节点(BinaryExpression)的左右子节点皆为静态纯字面量(NumericLiteral),就会在编译期直接完成数学计算,将整棵子树折叠为一个单一的字面量节点:
// 压缩后 AST 逆向序列化结果
const ONE_WEEK_MS = 604800000;
const BUFFER_SIZE = 65536;
2. 布尔值与特殊常量的极简替代
在 JavaScript 中,布尔类型字面量 true 占用 4 个字符,false 占用 5 个字符。利用 JS 宽松的逻辑强制类型转换规则,压缩器通常会采用单字节操作符进行等价缩写:
true等价重写为!0(节约 2 字节)false等价重写为!1(节约 3 字节)undefined(9 字节)经常被改写为void 0(6 字节),这不仅节约了空间,更规避了在老旧非严格模式下全局undefined变量被意外修改的风险。
3. 条件控制流与连续语句合并
压缩器还会积极优化语句块结构。当一个 if 分支内部仅有一句执行表达式时,压缩器会将其改写为逻辑短路运算符或三元运算符,从而省去关键字 if、一对圆括号以及一对大括号:
// 优化前:常规分支判断
if (isReady) {
    initialize();
}
// 压缩后等价变换:
isReady && initialize();
类似地,连续出现的 let a = 1; let b = 2; let c = 3; 会被合并为单声明链 let a=1,b=2,c=3;,剔除重复的关键字定义。
四、变量名混淆(Mangling):减小体积的核心主力
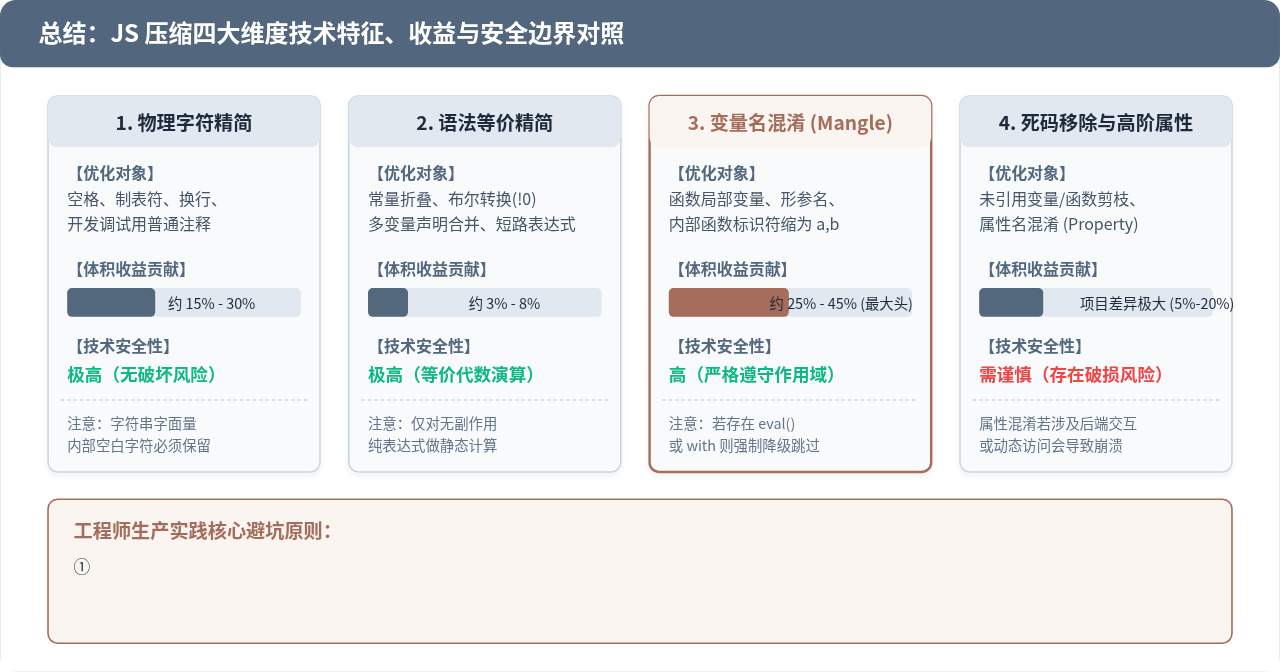
如果说去除空格和语法改写为文件瘦身打下了良好基础,那么变量名混淆(Variable Mangling)则是整个压缩流程中减重贡献最大的环节,通常能承担 30% 到 50% 以上的代码体积降幅。
1. 混淆的核心原理:为什么局部变量可以改,属性名不能改?
很多初学者会问:“既然变量名可以从 userBillingAddress 缩写成 a,为什么对象属性 user.address 不能也缩写成 user.a 呢?”
这里的根本分水岭在于作用域的静态封闭性与运行期动态性:
- 局部变量(Local Variable): 其声明与引用的生命周期完全被封锁在当前函数体或块级作用域内,外界环境无法直接通过动态字符串访问它。编译器能够 100% 掌握该变量的所有读写位置,因此只要在封闭作用域内将其所有引用同步替换,逻辑就不会发生任何偏差。
- 对象属性名(Property): 属于动态对象模型。JS 允许通过方括号
obj["address"]进行动态寻址,且对象经常需要经过JSON.stringify()序列化后发送给后端,或者接收第三方 API 传来的载荷。如果在没有协议绑定的情况下将obj.address改写成obj.a,一旦遭遇动态键查询或网络交互,整个程序就会瞬间崩溃。
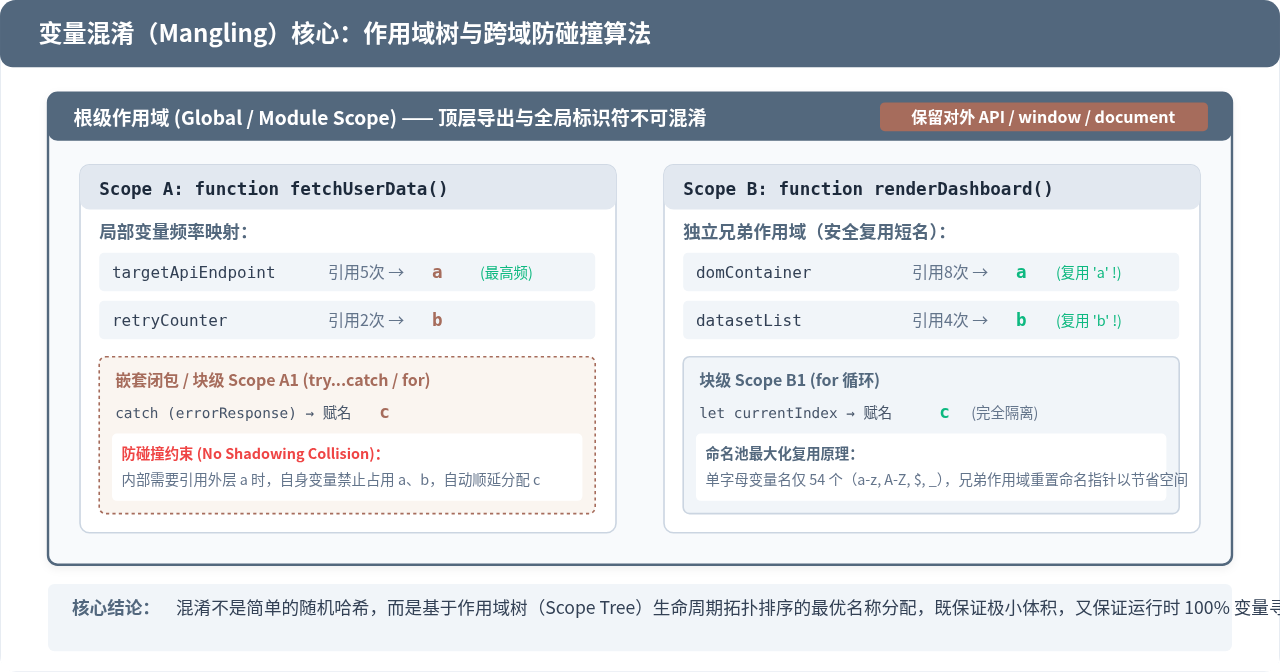
2. 作用域树与名称分配算法
为了做到安全混淆,压缩工具在遍历 AST 时会为整段程序建立一棵作用域树(Scope Tree)。每个作用域节点维护着属于自身的符号表(Symbol Table),记录以下信息:
- 当前作用域声明了哪些局部标识符(声明列表);
- 当前作用域捕获了哪些外层闭包变量(自由变量);
- 每个变量在当前范围内的引用频次与权重。
在分配名称时,混淆器采用基于使用频率的贪心分配策略:从候选字符池(通常由 54 个单字符组成:a-z, A-Z, $, _)中,将最短的单字符(如 a、b、c)优先分配给当前作用域中出现次数最多的局部变量;当单字符耗尽时,再递进使用双字符组合(aa, ab, ...)。
3. 跨作用域的名称复用与防碰撞(No Collision)
混淆器不会为整个工程中的所有变量生成全局唯一的随机串,而是追求最大化复用极短标识符:
- 兄弟作用域复用: 函数
foo()和函数bar()处于平行的作用域层级,彼此互不干扰。因此,foo内部的最高频变量被重命名为a,bar内部的最高频变量同样可以且应当被重命名为a。 - 父子嵌套防遮蔽(Shadowing Prevention): 如果子函数内引用了父级作用域的变量
a,那么子函数在混淆自身内部的局部变量时,必须主动避让a,顺延使用b或c。否则就会产生变量遮蔽(Variable Shadowing),导致子函数原本对外部变量的访问被意外阻断。
eval() 与 with 语句。因为 eval("var x = 1; alert(a)") 可以在运行期随意动态插入新变量或更改变量寻址目标。静态编译器一旦在某个作用域内检测到 eval 的存在,就无法确知哪些变量名可能会被动态字符串用到,为了避免程序崩溃,编译器只能强制放弃当前作用域乃至整条作用域链上的所有变量混淆,导致压缩效果大打折扣。
五、死代码消除(DCE)与静态分支剪枝
除了对活代码进行字符与标识符精简,现代压缩器还充当着“代码清洁工”的角色,负责将永远不可能被执行到的代码剔除出打包产物,即死代码消除(Dead Code Elimination,简称 DCE)。
在工程开发中,我们常常使用环境变量来控制调试功能:
// 开发环境配置与代码
const DEBUG_MODE = false;

function launchApp() {
    setupKernel();
    if (DEBUG_MODE) {
        console.log("详细调试信息:内存指针已分配");
        runInternalDiagnostics();
    }
}
当经过打包工具(如 Webpack/Vite)的环境变量注入后,DEBUG_MODE 被替换为布尔字面量 false。此时 AST 优化器会启动分支裁剪判定:
- 优化器计算出
if (false)的判断条件恒为假; - 优化器判定该
IfStatement的条件体内不存在外部可观测的副作用; - 优化器直接将整个
IfStatement分支子树从 AST 中彻底删除; - 由于
runInternalDiagnostics函数在外部没有其他调用方,它的函数定义节点也将被一并剔除。
最终输出的代码中,调试逻辑与诊断函数完全消失,真正做到生产代码的极致精简。
六、技术边界与生产环境配套:Source Map
理解了从去除空格到变量混淆的全部机制后,我们还需要正视其带来的必然代价:代码人类可读性的彻底丧失与调试难度的增加。
一段数百行的业务模块在经过完整的压缩流水线后,通常会变成一整行高密度、充斥着 a,b,c 的字符串。当生产环境发生未捕获异常时,浏览器上报的调用栈可能仅显示:
// 生产报错调用栈示例
TypeError: Cannot read properties of undefined (reading 't')
    at e.n (bundle.min.js:1:432)
    at t (bundle.min.js:1:89)
这样的堆栈对于排查 Bug 而言无异于天书。为了在极致体积与可调试性之间取得平衡,现代工程体系引入了 Source Map(源码映射) 技术。
压缩器在生成压缩后 JS 文件的同时,会建立一张 VLQ(Variable-length quantity)编码的映射表,精准记录压缩代码中每个字符的行列号与原始未压缩文件中行列号、原始变量名的双向对应关系。在线上部署时,项目团队通常将 .map 文件上传至内部专用的 APM 监控平台(如 Sentry),而不公开发布给普通用户。这样既保证了客户端下载极小的混淆包体,又能让研发团队在后台秒级还原真实源码堆栈。
总结
JavaScript 代码压缩绝非表面上看起来的“删删空格、改改名字”。它是一套严密遵循编译原理的工程体系:
- 物理层(Lexer 级别): 安全剔除无效换行、空格与注释,保留关键分隔符;
- 语法层(AST 级别): 执行常量折叠、运算符简化与不可达死分支剪除;
- 作用域层(Scope Tree 级别): 分析符号生命周期与引用权重,进行基于频率防碰撞的最优单字符重分配。
掌握这一全流程机制,不仅能帮助前端工程师更深入地理解 Terser、Vite、esbuild 等现代构建工具的底层调优参数,更能让我们在日常编写代码时,对 eval、动态属性访问等潜在“负优化”反模式保持警惕,写出对打包工具更加友好、体积更加紧凑的高性能前端应用。
JavaScript入门书籍避坑:这些书不适合初学者
2026-11-05 16:31:15
JS使用Math.round实现保留两位小数的原理与代码
2026-11-05 15:35:55
JavaScript 原生 Date 对象怎么实现日期加减
2026-11-05 14:30:00
JavaScript函数定义的三种方式:声明、表达式与箭头函数
2026-11-05 13:50:55
JavaScript中escape、encodeURI和encodeURIComponent对空格的处理差异
2026-11-05 12:47:23