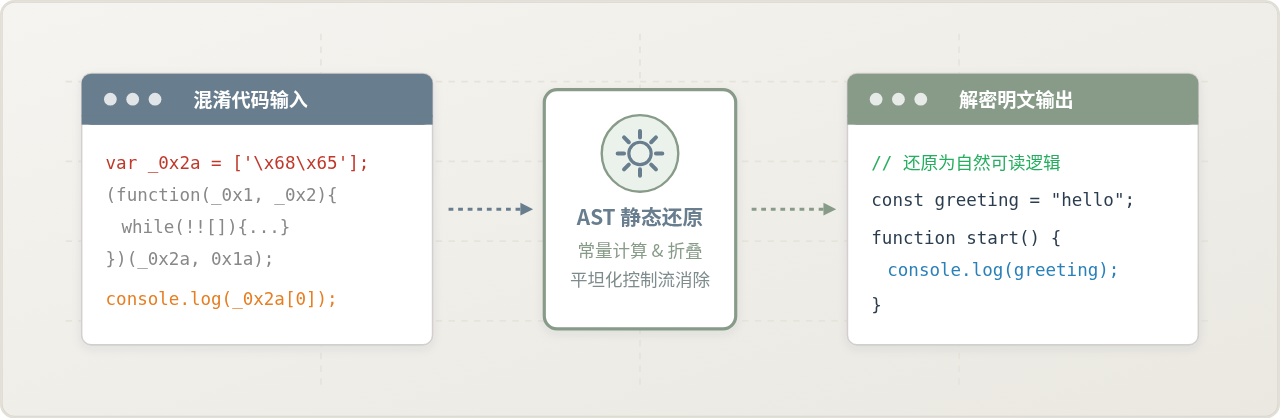
JavaScript代码混淆工具推荐:javascript-obfuscator与terser对比
深入对比主流工具 javascript-obfuscator 与 terser 的核心机制、防护能力、体积与性能损耗,提供详细命令行与工程化配置步骤以及场景选型决策指南。
一、核心定位与设计目标的本质差异
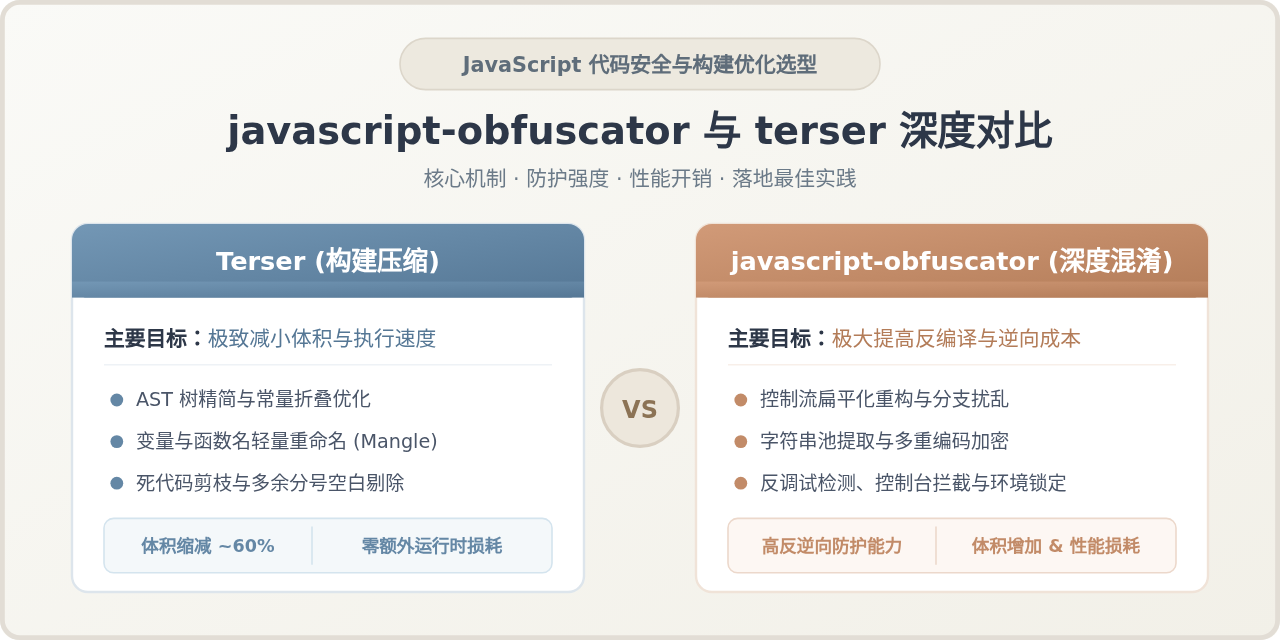
评估一款工具之前,必须首先看清其根本诉求。尽管两者都能让编译后的代码“不易阅读”,但它们在 AST(抽象语法树)上施加的操作逻辑是南辕北辙的:
-
Terser —— 以“性能与体积”为唯一导向:
作为 Webpack、Vite、Rollup 等现代主流打包工具事实上的默认压缩器,Terser 的核心使命是将代码体积压缩至极限,并保留甚至微幅提升执行性能。它执行的操作包括去除注释空白、死代码消除(DCE)、作用域分析、短变量名替换(Mangle)以及常量折叠。在 Terser 看来,变量重命名只是为了用单字符(如
a、b)代替较长的标识符以节省字节,并非为了安全防御。 -
javascript-obfuscator —— 以“阻碍逆向工程”为首要导向:
该工具专为对抗逆向破解、算法窃取和脚本篡改而设计。它不在乎产物体积是否变大,也不以执行性能为代价妥协。它的核心机制是通过控制流扁平化(Control Flow Flattening)将自然连贯的
if-else和循环逻辑拆散为switch-case状态机,并将明文字符串全部提取并进行十六进制或 RC4 加密。其最终目的,是使反编译分析者在静态分析和动态跟踪时付出极高的时间与认知成本。
二、核心转换机制与代码产物直观对比
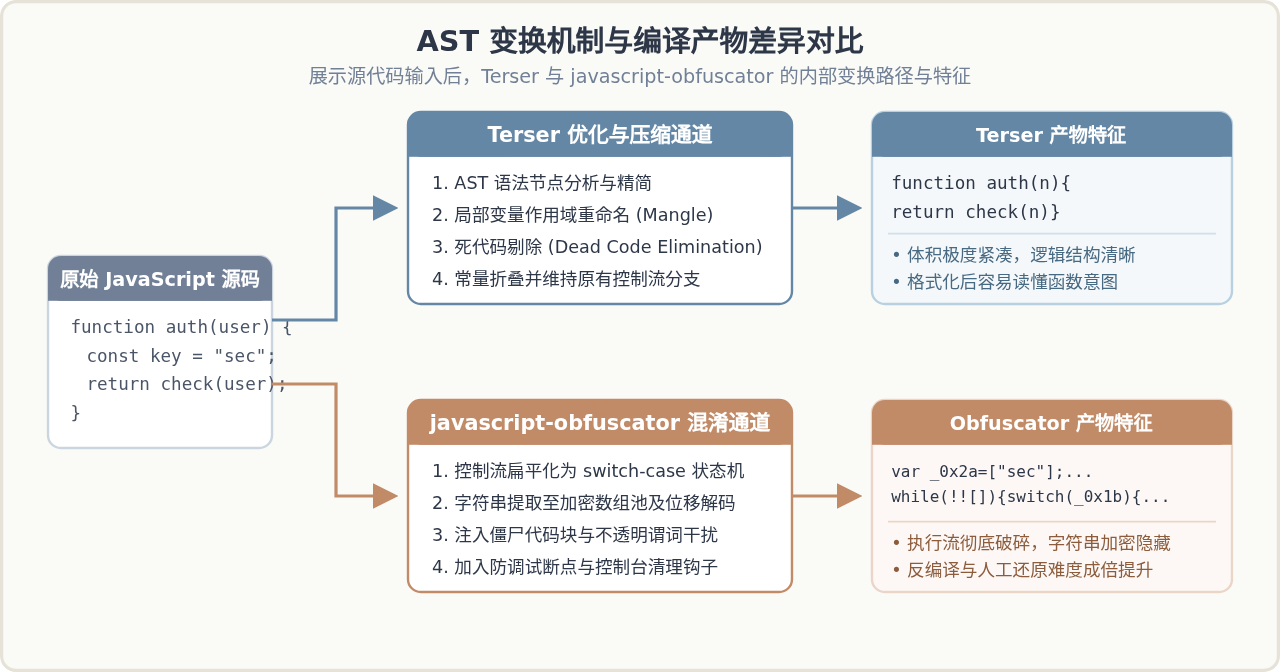
为了清楚展示两者对同一段业务代码的处理效果差异,我们以一段典型的客户端接口加签与鉴权函数为例:
// 原始业务源码 (auth.js)
function verifyToken(userInfo, secretSalt) {
  const signKey = "AUTH_SEC_2026";
  if (!userInfo || !userInfo.uid) {
    console.error("Invalid user payload");
    return false;
  }
  const hash = computeHash(userInfo.uid, signKey, secretSalt);
  return hash === userInfo.signature;
}
1. Terser 的处理方式与产物特征
当执行 terser auth.js -c -m 后,Terser 会进行局部变量作用域缩写,并去除冗余结构:
// Terser 输出产物 (精简且单行化)
function verifyToken(n,e){const r="AUTH_SEC_2026";return!(!n||!n.uid)&&computeHash(n.uid,r,e)===n.signature}
产物特点分析:
可以看到,参数 userInfo 与 secretSalt 被重命名为 n 和 e,局部变量 signKey 被缩短为 r,if 分支被优化合并为更紧凑的逻辑与运算。然而,核心业务逻辑的拓扑结构依然完整,敏感字符串常量 "AUTH_SEC_2026" 依然以明文清晰暴露。逆向者只需在浏览器控制台或本地 IDE 中进行代码格式化(Prettify),就能在数秒内推导还原出原函数的校验逻辑。
2. javascript-obfuscator 的处理方式与产物特征
而在启用控制流扁平化与字符串数组加密后,javascript-obfuscator 生成的代码结构将发生质的改变:
// javascript-obfuscator 输出产物片段 (已隐藏真实控制流)
var _0x5a1b = ["AUTH_SEC_2026", "signature", "uid"];
(function(_0x2d8a, _0x1c4e) {
  var _0x3b = function(_0x4f) { while (--_0x4f) { _0x2d8a['push'](_0x2d8a['shift']()); } };
  _0x3b(++_0x1c4e);
}(_0x5a1b, 0x1a4));
var _0x4c21 = function(_0xa, _0xb) { return _0x5a1b[_0xa = _0xa - 0x0]; };
function verifyToken(_0x3e1a, _0x2f90) {
  var _0x118a = { 'a': function(_0x1, _0x2) { return _0x1 === _0x2; } };
  var _0x24e6 = '1|3|0|2'['split']('|'), _0x4d0a = 0x0;
  while (!![]) {
    switch (_0x24e6[_0x4d0a++]) {
      case '0': var _0x10a2 = computeHash(_0x3e1a[_0x4c21('0x2')], _0x4c21('0x0'), _0x2f90); continue;
      case '1': if (!_0x3e1a || !_0x3e1a[_0x4c21('0x2')]) return ![]; continue;
      case '2': return _0x118a['a'](_0x10a2, _0x3e1a[_0x4c21('0x1')]);
      case '3': continue;
    }
    break;
  }
}
产物特点分析:
函数的原有调用拓扑已被完全瓦解。代码中的每个执行分支被拆分成通过状态机控制的 while-switch 结构;原有的字符串被移入混淆数组并在初始化时通过循环位移进行重排;属性访问(如 userInfo.uid)被转变为下标动态计算 _0x3e1a[_0x4c21('0x2')]。反编译工具和静态 AST 分析脚本难以直接还原其条件流向。
三、快速上手与工程化实操配置
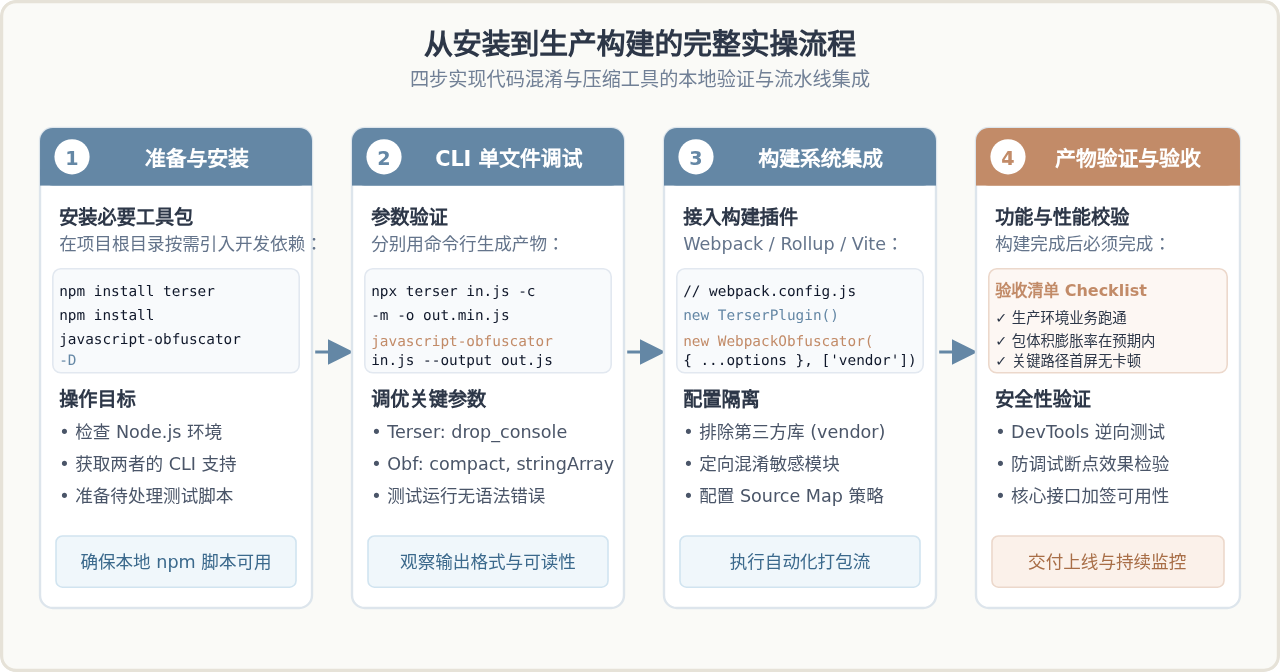
在实际项目工程中,混淆与压缩工具既可以通过命令行进行独立文件快速验证,也可以深度集成到前端构建流水线中。
步骤 1:本地依赖安装
在 Node.js 工程中,通常将这两款工具作为开发依赖(devDependencies)安装:
# 在项目根目录下执行安装
npm install terser javascript-obfuscator --save-dev

# 若使用 Webpack 构建体系,还可安装官方插件
npm install terser-webpack-plugin webpack-obfuscator --save-dev
步骤 2:CLI 单文件调试与核心参数
在将工具集成到自动化构建流之前,推荐先用 CLI 工具处理单个文件,以直观确认混淆深度与运行时正确性。
1. Terser 常用 CLI 调试命令:
# 启用代码压缩 (-c) 与变量简写 (-m),并去除控制台日志
npx terser src/auth.js   --compress drop_console=true,passes=2   --mangle toplevel=true   --output dist/auth.min.js
--compress (或 -c):开启 AST 压缩规则。passes=2表示执行两轮压缩以优化死代码。--mangle (或 -m):重命名局部变量与顶级变量(toplevel=true会缩写最外层未导出的变量)。drop_console=true:移除所有console.*调用,降低泄露信息的风险。
2. javascript-obfuscator 常用 CLI 调试命令:
# 启用中高强度混淆与字符串加密
npx javascript-obfuscator src/auth.js --output dist/auth.obf.js --compact true --control-flow-flattening true --control-flow-flattening-threshold 0.75 --string-array true --string-array-encoding 'base64' --string-array-threshold 0.8--control-flow-flattening:开启控制流扁平化,打破顺序执行结构。--control-flow-flattening-threshold:控制流扰乱的概率阈值(0.75 表示 75% 的节点被扁平化)。--string-array-encoding:字符串阵列编码方式,支持none、base64或rc4。--compact:压缩产物为紧凑单行格式,避免换行符暴露结构。
步骤 3:主流构建工具链配置(Webpack / Vite)
在实际生产打包中,通常结合打包工具自动完成。在 Webpack 中集成时,务必注意执行顺序与排除范围:
// webpack.config.js
const TerserPlugin = require('terser-webpack-plugin');
const WebpackObfuscator = require('webpack-obfuscator');

module.exports = {
  mode: 'production',
  entry: './src/index.js',
  optimization: {
    minimize: true,
    minimizer: [
      new TerserPlugin({
        terserOptions: {
          compress: {
            drop_console: true,
            drop_debugger: true,
          },
          mangle: true,
        },
        extractComments: false, // 不生成单独的 LICENSE 文本文件
      }),
    ],
  },
  plugins: [
    // 仅针对项目核心业务代码启用混淆,排除第三方依赖与常规页面
    new WebpackObfuscator({
      rotateStringArray: true,
      stringArray: true,
      stringArrayThreshold: 0.8,
      controlFlowFlattening: true,
      controlFlowFlatteningThreshold: 0.5,
    }, ['vendor.js', 'runtime~*.js']) // 排除外部 vendor 包
  ],
};webpack-obfuscator 全局应用在 node_modules 或大型公共类库(如 React、Vue、Lodash)上。这会导致构建打包时间暴增 10 倍以上,且输出的 JavaScript 解析开销极大,容易引发首屏主线程严重阻塞卡死。
四、性能开销、体积膨胀与防护强度的量化权衡
选择代码加固方案并非越复杂越好,而是一个典型的“安全性”与“可用性/性能”之间的技术权衡游戏。
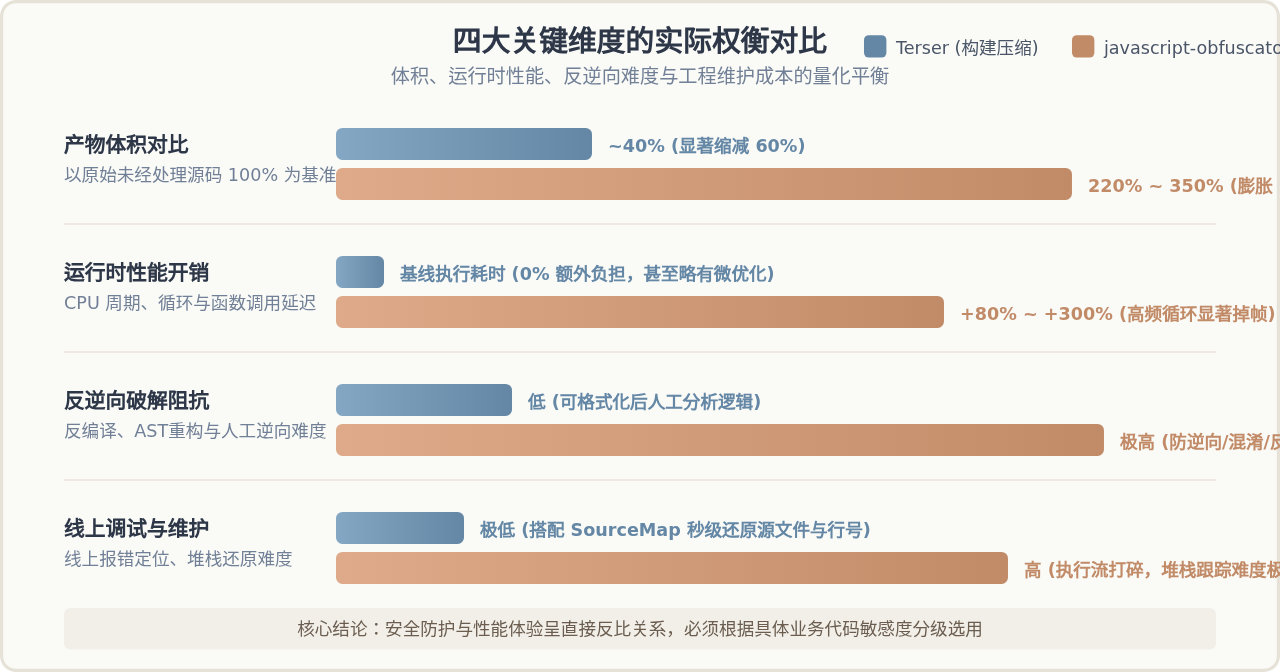
| 评估维度 | Terser | javascript-obfuscator | 工程选型考量 |
|---|---|---|---|
| 代码体积变化 | 减少 40% ~ 65%(极度精简) | 增加 150% ~ 350%(体积膨胀) | 公网 Web 应用需严格控制网络传输开销 |
| 运行时 CPU 损耗 | 0%(基线执行速度,无开销) | 增加 80% ~ 300%(状态机调度与解密开销) | 高频渲染或复杂计算逻辑易出现掉帧 |
| 静态反编译难度 | 低(美化工具即可读懂结构) | 极高(AST 分析失效,逻辑破碎) | 商业算法、离线密钥保护依赖高抗性 |
| 线上排错与 SourceMap | 完备支持,堆栈准确定位 | 堆栈被打碎,SourceMap 存在安全泄露风险 | 线上快速定位 Bug 与防护强度的冲突 |
为什么混淆会带来剧烈的性能与体积惩罚?
深入分析 javascript-obfuscator 的底层实现便不难理解:
-
控制流状态机:原本直接执行的三行赋值语句,被重写为由数组驱动的
while(true) + switch结构。现代 V8 引擎对于扁平化后的状态机难以进行内联优化(Inline Caching)和 JIT 优化编译,执行分支预测命中率骤降。 -
字符串解密包装:每个原本直接内联的字符串字面量,都被替换为一个函数调用
_0x4c21('0x0')。如果该字符串位于密集执行的循环体内部,每秒数十万次的解密调用会造成大量无效的调用栈分配与计算消耗。 - 僵尸代码注入:为了迷惑反编译器,工具会在代码中强行插入永远不会被触发的死循环与伪判断逻辑,这些冗余字节会直接线性增加打包产物的体积。
五、技术选型决策树与工程化推荐实践
结合业务形态与安全敏感等级,不同项目应当采用差异化的加固策略,而不是非此即彼的极端选择。
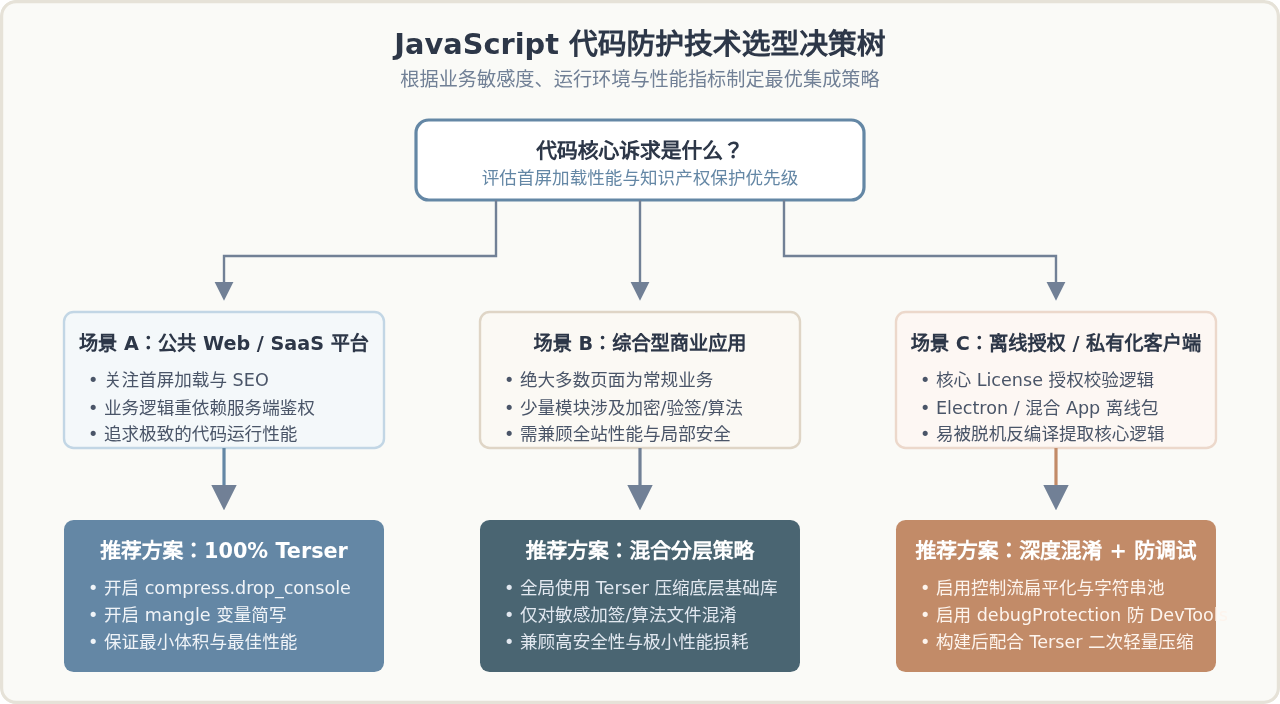
场景 1:公网面向普通消费者的 Web / SaaS 平台
推荐方案:100% 选用 Terser
对于常规的电商、内容资讯、企业门户或公共 SaaS 平台,首屏加载时间(FCP/LCP)和 SEO 表现直接关系到业务转化率与用户留存。前端所有的交互与展示逻辑本身不存在商业秘密,真正的安全屏障应设立在服务端接口鉴权、风控策略与 RBAC 权限系统中。此时使用 Terser 进行最彻底的代码精简与变量重命名,是性价比最高且最稳妥的方案。
场景 2:独立客户端应用与私有化交付系统
推荐方案:javascript-obfuscator 深度加固 + 针对性配置
在基于 Electron 开发的桌面客户端、微信小程序核心插件、混合移动 App 离线包、以及交付给客户私有服务器部署的 Node.js 后端应用中,运行环境完全脱离了开发者的控制范围。破解者可以随意使用 Chrome DevTools 挂载断点、查看本地文件与内存。对于这类应用,必须对涉及 License 授权算法校验、加解密签名核心、设备指纹生成 的核心模块施加中高强度的 javascript-obfuscator 混淆,并开启 debugProtection 防止攻击者通过控制台进行断点逆向。
场景 3:大型商业级前端工程的“分层混合防护”策略
在许多实际企业级大型工程中,最优的落地方式不是全局二选一,而是“分层组合拳”:
- 基础依赖层:所有第三方依赖包(Vue/React 运行时、UI 组件库、图表库)使用 Terser 进行极致压缩,保证加载与执行性能。
- 通用业务层:普通表单、视图渲染、页面路由同样仅经过 Terser 压缩,保障页面流畅度与错误堆栈的可排查性。
-
核心资产层:单独提取出敏感加签 SDK(如
security-core.js),单独配置 javascript-obfuscator 进行深度混淆(控制流扁平化 + 字符串数组加密),然后再合并到最终构建产物中。
六、工程落地中的典型陷阱与规避指南
-
陷阱 1:反调试机制在测试环境中引发死循环
debugProtection: true会在运行时动态注入debugger循环调用,一旦检测到开发者工具(DevTools)被打开,就会使浏览器标签页陷入假死状态。严禁在开发与测试环境中开启该选项,必须通过构建环境变量判断process.env.NODE_ENV === 'production'时才允许注入。 -
陷阱 2:属性重命名(Property Mangling)破坏 JSON 序列化与第三方组件协议
无论是 Terser 的mangle.properties还是混淆器的类似选项,若强行重命名对象的键名(如将user.username重命名为user.a),会导致前后端 API 数据交互、JSON 序列化解析失败。除非对私有属性做严格的前缀限定(如_myPrivateProp),否则不建议开启全局对象属性混淆。 -
陷阱 3:盲目发布 Source Map 导致混淆形同虚设
如果在生产环境打包混淆的同时,将包含原始代码映射的.map文件随包部署到公开 CDN 或 Web 服务器上,攻击者直接在浏览器开发者工具中就能一键还原未压缩混淆前的完整源码。生产环境的 Source Map 必须严格配置为仅上传至内部监控告警平台(如 Sentry/Datadog),严禁公开对外可读。
JS 单例模式会导致内存泄漏吗?闭包引用陷阱与排查方法
2026-11-05 17:29:14
JS reduce实战:数组去重、扁平化与分组统计
2026-11-05 13:05:36
JS代码怎么在线压缩?新手操作指南与工具推荐
2026-11-04 18:07:25
fflate 与 pako.js 性能对比:JS 解压库怎么选
2026-11-03 22:54:05
JS DOM查询性能优化:缓存引用与减少重排重绘
2026-11-03 22:48:27