

JS reduce实战:数组去重、扁平化与分组统计
深入解析JavaScript中Array.prototype.reduce的实战用法,涵盖数组去重、多维数组扁平化以及对象分组统计的完整代码实现、底层执行机制与性能优化避坑指南。
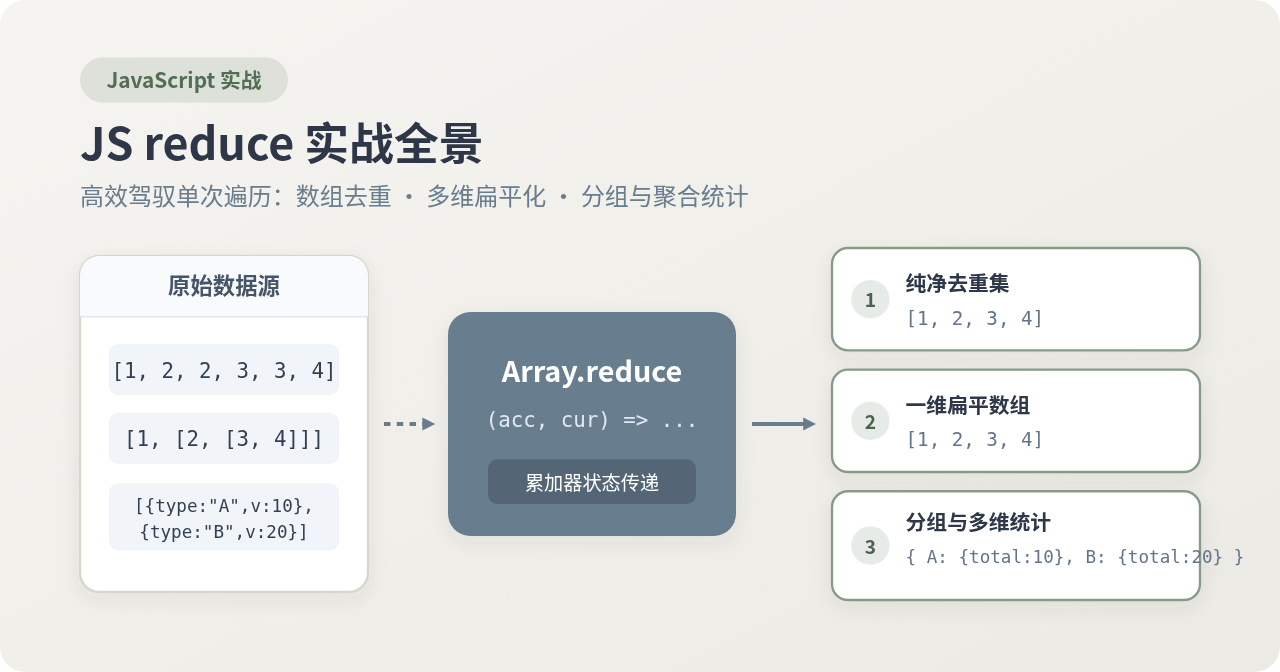
Array.prototype.reduce 往往被视作数组遍历的高级收敛工具。它的核心价值在于将多步的数据过滤、转换与结构组装,合并为一次线性的单趟迭代。本文将直入核心,通过具体的实现步骤、完整代码和运行推导,全面拆解数组去重、多维扁平化与分组统计三大高频实战场景,并深度剖析累加器原地推进与内存开销的关键防坑要点。
一、理解 reduce 的累加器流转机制
掌握 reduce 的关键在于明确其“状态推进模型”。不同于 map 的一对一投影或 filter 的筛选过滤,reduce 允许开发者维护一个跨迭代周期的容器对象——累加器(accumulator)。
标准语法格式为:array.reduce(callback(accumulator, currentValue, currentIndex, array), initialValue)。每当一次回调执行完毕,其返回值会无缝作为下一次回调执行时的 accumulator 输入,直至数组末尾返回最终收敛状态。
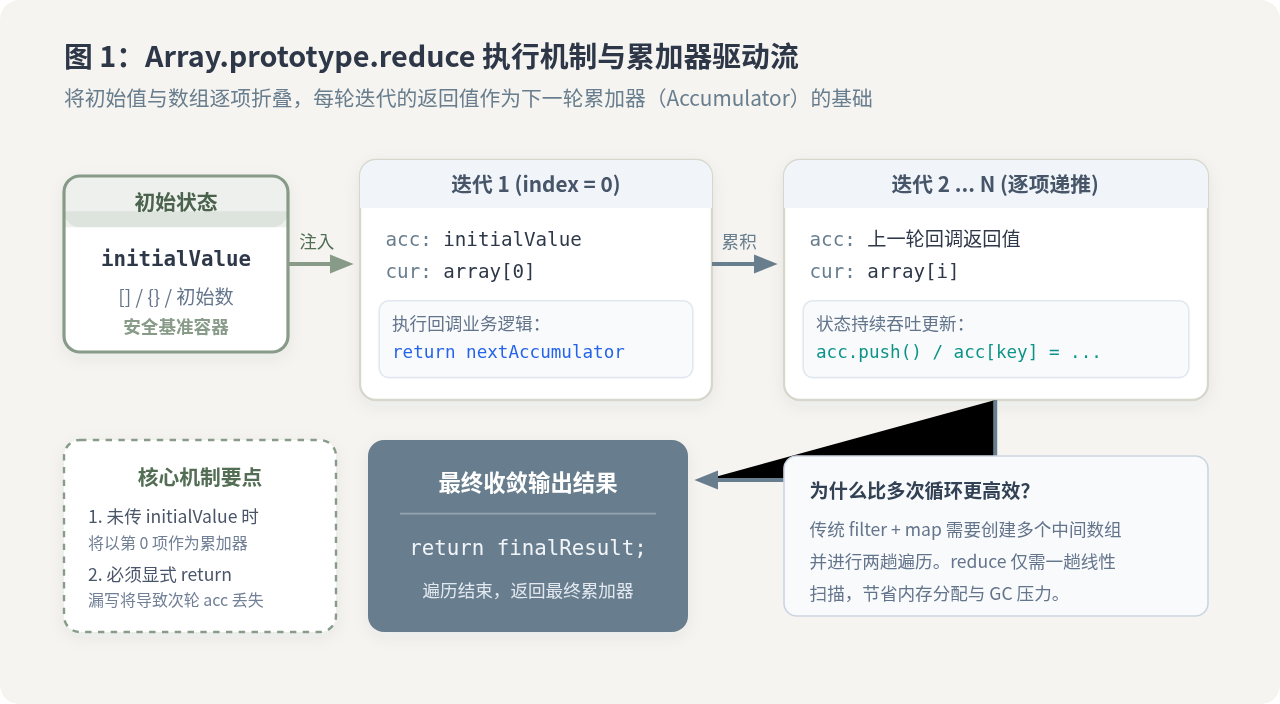
在实际编写中,最常犯的低级错误是忘记显式编写 return accumulator。一旦回调中某一分支漏掉返回值,下一轮迭代的累加器就会变成 undefined,导致后续属性读取直接抛出 TypeError 异常。
二、实战场景一:数组去重
去重是前端数据预处理的基本操作。虽然针对原始基本类型的简单数组,现代 JavaScript 提供了 [...new Set(arr)] 的极简写法,但在复杂业务场景中(例如根据对象的某个特定字段去重、或者在去重的同时执行数据清洗与格式化),reduce 展现出了无可比拟的掌控力。
1. 简单基本类型数组去重
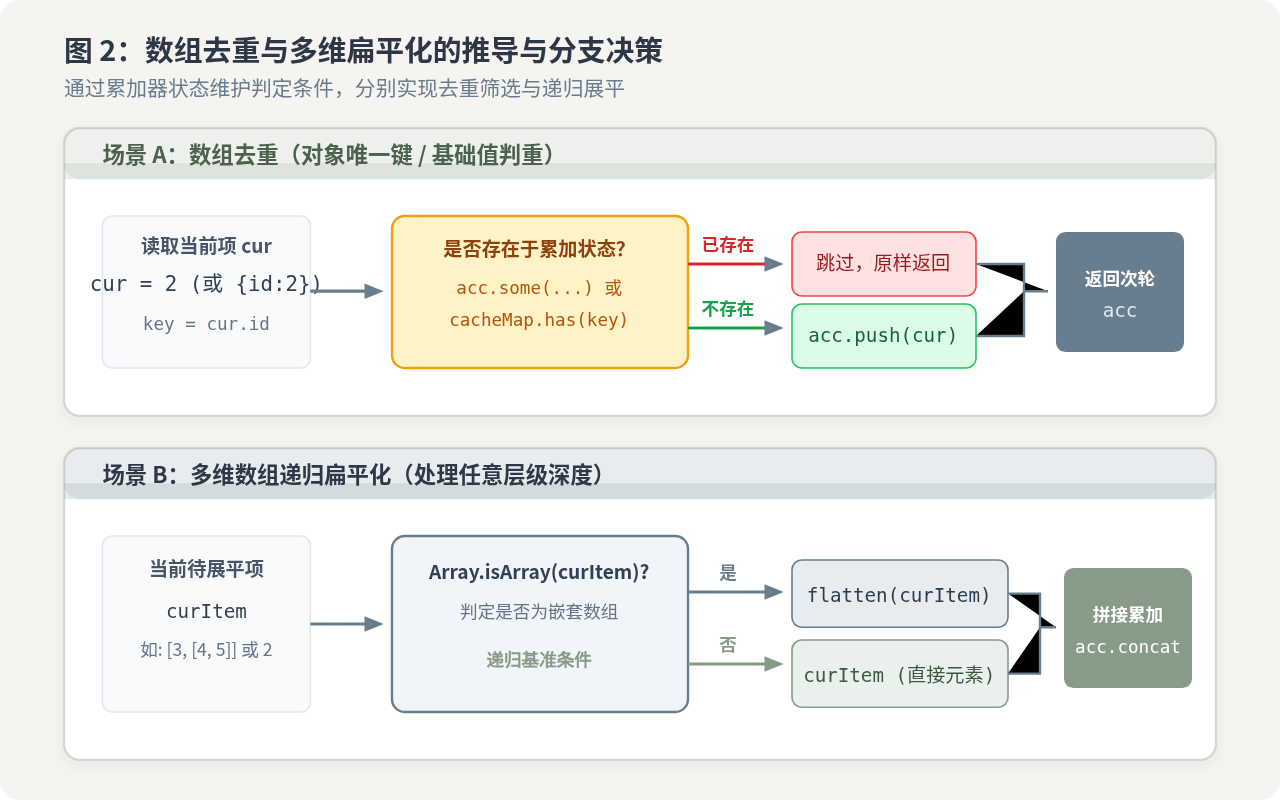
核心思路是将累加器初始为空数组 [],遍历数组时检查累加器中是否已经包含当前元素,若不存在则推入累加器。
// 基础值去重示例
const rawNumbers = [1, 2, 2, 3, 4, 4, 5, 1];

const uniqueNumbers = rawNumbers.reduce((acc, cur) => {
  if (!acc.includes(cur)) {
    acc.push(cur);
  }
  return acc;
}, []);

// 示例输出结果:[1, 2, 3, 4, 5]
console.log(uniqueNumbers);
2. 对象数组按唯一键(Key)去重
在处理服务端返回的列表时,常需要依据对象中的 id 或 code 进行去重。如果依然在每轮循环中使用 acc.some(item => item.id === cur.id),由于 some 每次都需要遍历累加器,算法复杂度会攀升至 O(n²)。
更优的做法是利用复合状态(或辅助 Map),借助哈希表的高效查找,使时间复杂度保持在 O(n):
// 对象数组按唯一键去重
const userList = [
  { id: 101, name: "张三", role: "admin" },
  { id: 102, name: "李四", role: "editor" },
  { id: 101, name: "张三(重复项)", role: "admin" },
  { id: 103, name: "王五", role: "viewer" }
];

// 利用 reduce 维护去重数组,结合 Set 进行 O(1) 索引查找
const uniqueUsers = userList.reduce((acc, user) => {
  if (!acc.seenIds.has(user.id)) {
    acc.seenIds.add(user.id);
    acc.result.push(user);
  }
  return acc;
}, { seenIds: new Set(), result: [] }).result;

// 示例输出结果:保留 3 条唯一记录(id 101, 102, 103)
console.log(uniqueUsers);
在一致条件(处理 10,000 条包含 50% 重复项的数据)下:直接在 reduce 中使用 acc.includes() 或 acc.some() 会导致内层嵌套遍历,执行耗时呈指数级上升;而采用 Map / Set 记录键值的索引方案,查找时间始终为 O(1),整体维持在 O(n) 线性复杂度。差异之所以重要,是因为前者在面对中大型数据量时极易造成浏览器主线程卡顿。
三、实战场景二:多维数组扁平化
虽然 ES2019 引入了原生的 Array.prototype.flat(),但理解基于 reduce 的扁平化实现,不仅是各类面试和深层技术考查的必考点,也是深入理解数据递归与累加状态的重要契机。
1. 一维浅层扁平化
对于仅有两层的二维数组,使用 reduce 结合 concat 即可单行实现展开:
const nested2D = [[1, 2], [3, 4], [5, 6]];
const flat1D = nested2D.reduce((acc, cur) => acc.concat(cur), []);
// 示例输出结果:[1, 2, 3, 4, 5, 6]
console.log(flat1D);
2. 任意深度的多维递归扁平化
面对嵌套层级未知的数据结构(如 [1, [2, [3, [4, 5]]]]),需要将 reduce 包装为递归函数。若当前项仍为数组,则递归调用展平逻辑,否则直接追加到累加器中:
// 任意嵌套深度递归扁平化
function flattenDeep(arr) {
  return arr.reduce((acc, cur) => {
    return acc.concat(Array.isArray(cur) ? flattenDeep(cur) : cur);
  }, []);
}

const complexNested = [1, [2, 3], [[4, [5, 6]]], 7];
const completelyFlat = flattenDeep(complexNested);

// 示例输出结果:[1, 2, 3, 4, 5, 6, 7]
console.log(completelyFlat);
3. 避免内存解构陷阱:[...acc, ...cur] 的隐患
在很多代码片段中,常有人写出 (acc, cur) => [...acc, ...(Array.isArray(cur) ? flatten(cur) : [cur])]。这种写法虽然形式上保持了所谓的“纯函数”,但每次迭代都在内存中创建了一个全新数组,并对历史元素进行全量拷贝,导致时间复杂度直接退化到 O(n²),引发频繁的垃圾回收。
正确的工程实践应当坚持在局部作用域内操作同一个累加器实例,使用 push 或原地拼接,保证内存复用与执行效率。
四、实战场景三:数据分组与多维统计
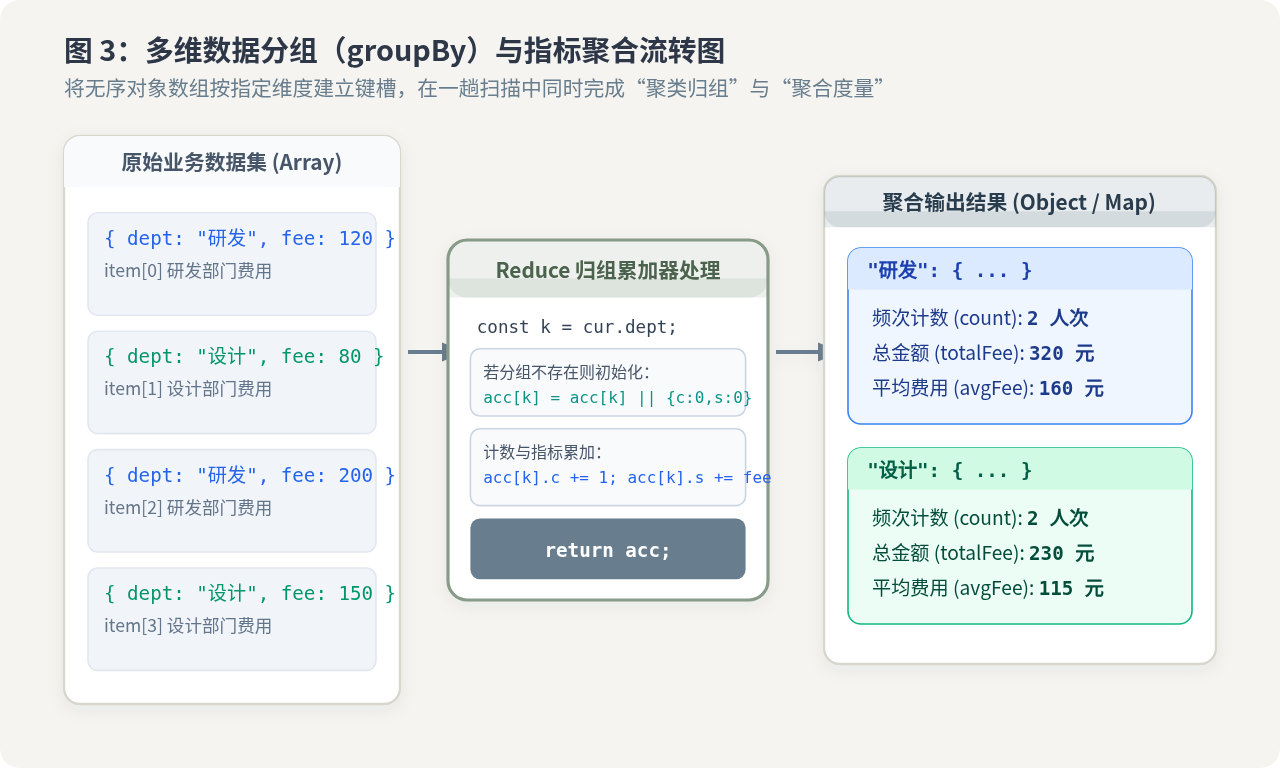
在后台管理系统与数据看板中,从后端拿到的通常是一维平铺的对象数组,前端需要按部门、类别或状态对其进行聚合分组,并同时统计频次与金额汇总。这是 reduce 最具实战威力的舞台。
1. 基础字段分类分组(groupBy)
将平铺数组重构为键值映射字典,按字段将条目归类到对应的数组槽位中:
const products = [
  { name: "笔记本", category: "电子产品", price: 6999 },
  { name: "人体工学椅", category: "办公家具", price: 1299 },
  { name: "机械键盘", category: "电子产品", price: 499 },
  { name: "升降桌", category: "办公家具", price: 2199 }
];

// 实现基础分组
const groupedByCategory = products.reduce((acc, product) => {
  const key = product.category;
  // 若当前分类槽位不存在,初始化空数组
  if (!acc[key]) {
    acc[key] = [];
  }
  acc[key].push(product);
  return acc;
}, {});

/* 示例输出结构:
{
  "电子产品": [ { name: "笔记本"... }, { name: "机械键盘"... } ],
  "办公家具": [ { name: "人体工学椅"... }, { name: "升降桌"... } ]
}
*/
console.log(groupedByCategory);
2. 一趟扫描同时完成分组与指标聚合
在实际生产中,往往不仅需要分组,还需要计算各类别的总金额、平均单价以及条目数量。使用 reduce 可以做到在一次循环中全量结算完毕,避免多次遍历:
// 复合指标统计聚合
const categoryMetrics = products.reduce((acc, item) => {
  const { category, price } = item;

  if (!acc[category]) {
    acc[category] = {
      count: 0,
      totalAmount: 0,
      items: []
    };
  }

  acc[category].count += 1;
  acc[category].totalAmount += price;
  acc[category].items.push(item.name);

  return acc;
}, {});

// 输出包含统计度量的结果对象
console.log(categoryMetrics);
五、方案对比与性能防坑全景
为了在实际项目中选出最稳妥的实现方式,我们需要在语法可读性、执行性能与适用场景之间建立清晰的判断标准:
| 业务任务 | 推荐方案 | 时间复杂度 | 空间复杂度 | 关键考量与注意事项 |
|---|---|---|---|---|
| 基础值去重 | new Set(arr) |
O(n) | O(n) | 简单类型推荐原生 Set,语法更精炼。 |
| 对象键去重 | reduce + Set/Map |
O(n) | O(n) | 避免在累加器内反复 includes,使用辅助 Map 保持线性效率。 |
| 深层扁平化 | flat(Infinity) / reduce 递归 |
O(n) | O(n) | 低版本环境使用 reduce + push 递归,坚决禁止解构展开拷贝。 |
| 分组统计 | reduce 累加器聚合 |
O(n) | O(n) | 最适合单次遍历产出包含计数、求和的多维报表模型。 |
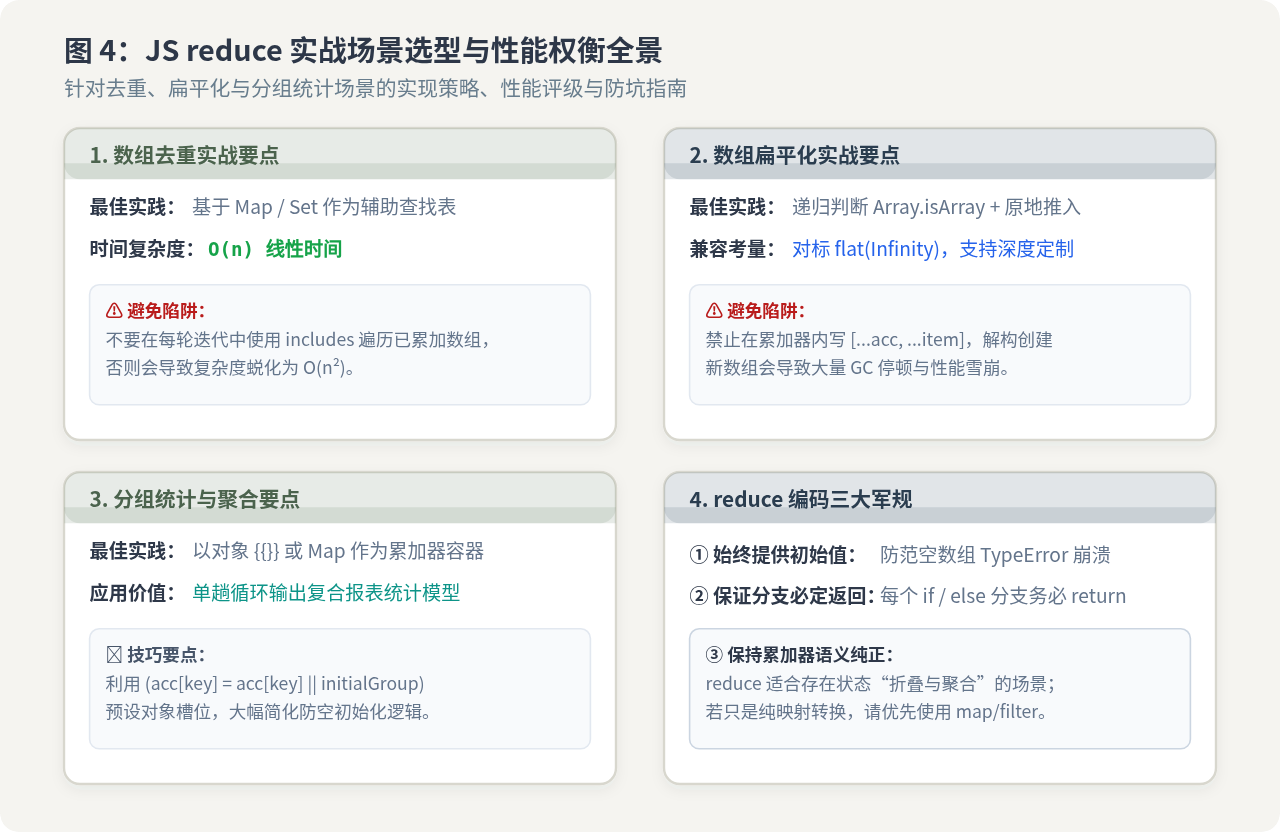
1. 务必显式声明 initialValue:如果省略第二个参数,在空数组调用时会直接抛出致命的 TypeError: Reduce of empty array with no initial value。显式声明 [] 或 {} 能够从源头杜绝线上偶发崩溃。
2. 理清 reduce 与 map/filter 的边界:如果仅仅是对每个元素做同构映射,请优先使用 map;如果只是挑选符合条件的元素,请优先使用 filter。只有当任务涉及数据降维、跨项状态积累、结构异构转换(从 Array 变为 Object/Map)时,reduce 才是真正的最优解。
结语
Array.prototype.reduce 绝非仅仅用于数值累加。在数组去重、嵌套扁平化以及结构化分组统计中,它通过一个持续演进的累加器容器,将传统多阶段数据流整合为单次线性推进。在工程实践中,严守初始值传递、杜绝循环内的解构拷贝、善用哈希索引保持 O(n) 复杂度,就能在编写出优雅、紧凑代码的同时,确保系统卓越的运行性能。
JS代码怎么在线压缩?新手操作指南与工具推荐
2026-11-04 18:07:25
fflate 与 pako.js 性能对比:JS 解压库怎么选
2026-11-03 22:54:05
JS DOM查询性能优化:缓存引用与减少重排重绘
2026-11-03 22:48:27
在线运行JavaScript代码时的沙箱限制与跨域问题
2026-11-03 22:29:33
怎么利用尾调用优化和记忆化提升JS递归效率
2026-11-03 20:39:34







