前端怎么用JavaScript实现Blob文件下载并自动清理内存
深入讲解在前端使用JavaScript将数据或二进制流构建为Blob对象并触发浏览器文件下载的完整实现方案,剖析Object URL的生命周期与内存驻留机制,提供稳妥的自动清理内存策略与生产级封装函数。
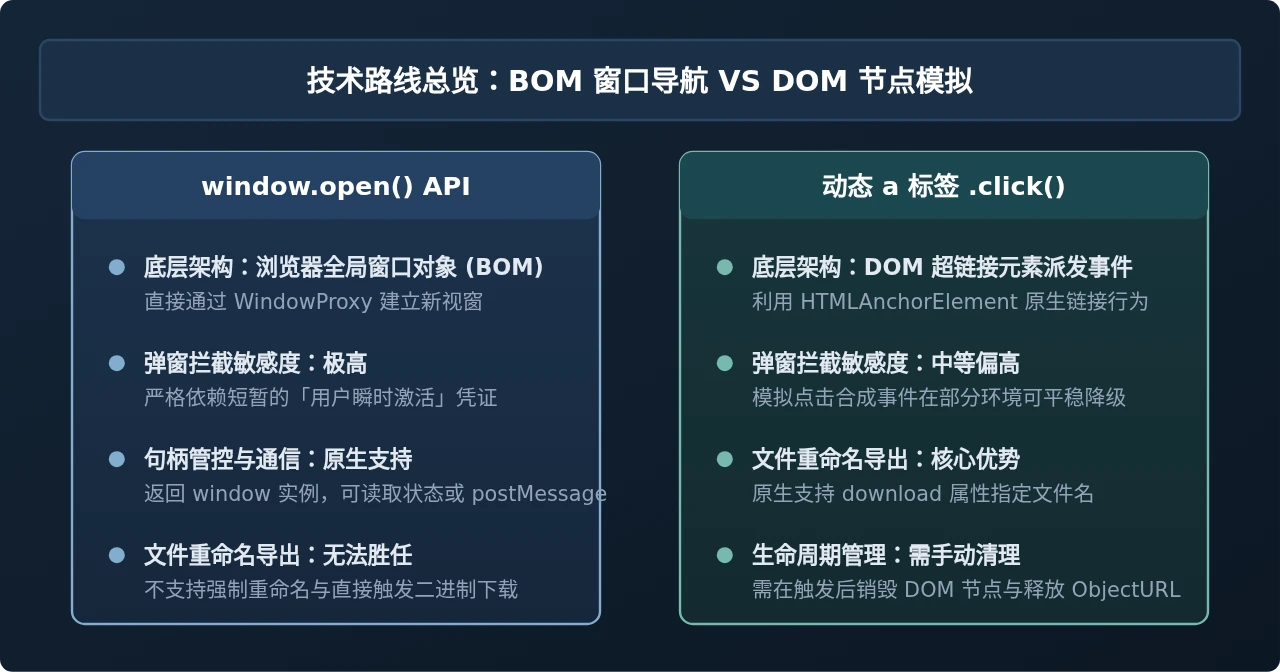
在前端业务场景中,无论是导出报表、打包图片、下载服务端流式生成的 PDF,还是导出前端内存中的 JSON 配置,最通用的技术方案就是将数据封装为 Blob 对象,利用 URL.createObjectURL() 生成一个专属的虚拟定位标识符,借由动态构造的 <a download> 标签触发浏览器的下载核心管线,最后调用 URL.revokeObjectURL() 注销该引用。本文将从核心实现步骤、内存驻留机制、注销时机陷阱以及通用工具函数封装四个方面,系统解答如何稳健实现该功能并杜绝内存泄漏。
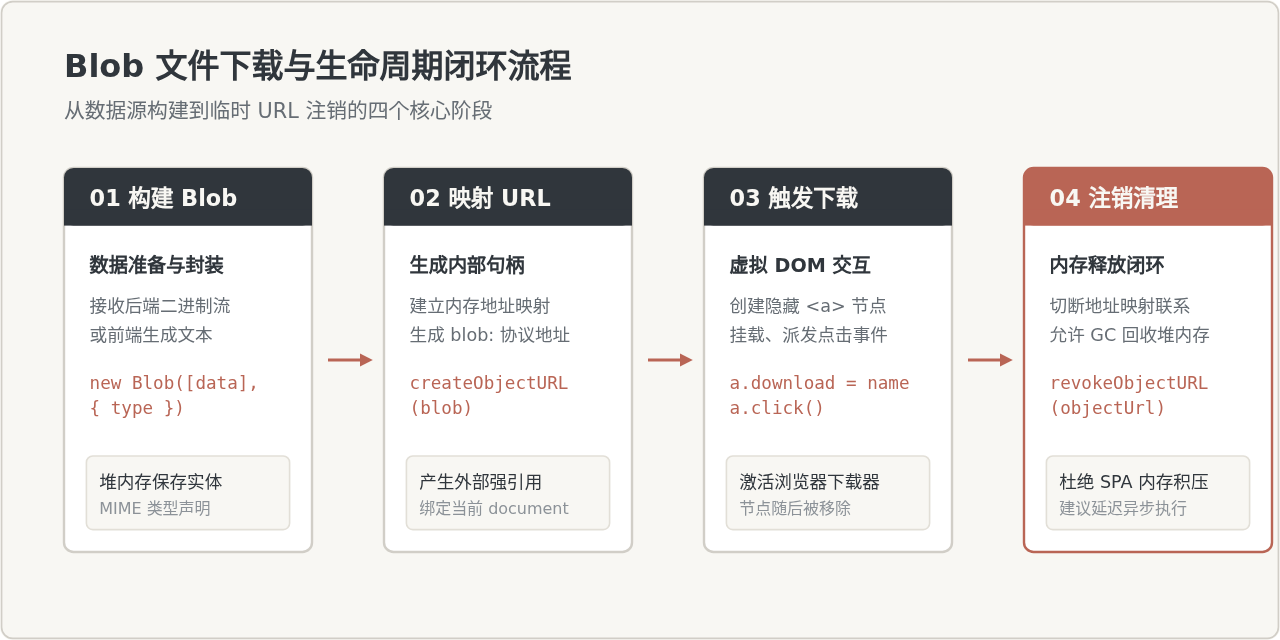
一、Blob 文件下载的极简实现与四步流程
前端由纯 JavaScript 发起文件下载,不依赖后端跳转或重定向,其核心逻辑是在客户端内存中搭建一条临时的“数据通路”。无论源数据是字符串、ArrayBuffer 还是接口返回的 responseType: 'blob',完整的实现均遵循严格的四步闭环。
function simpleDownload(content, fileName, mimeType = 'text/plain;charset=utf-8') {
  // 第一步:构建 Blob 容器
  const blob = new Blob([content], { type: mimeType });

  // 第二步:生成临时的 blob: 协议 URL
  const objectUrl = URL.createObjectURL(blob);

  // 第三步:创建隐藏链接并模拟点击
  const link = document.createElement('a');
  link.href = objectUrl;
  link.download = fileName;
  link.style.display = 'none';
  document.body.appendChild(link);
  link.click();

  // 第四步:移除 DOM 节点并释放内存映射
  document.body.removeChild(link);
  setTimeout(() => {
    URL.revokeObjectURL(objectUrl);
  }, 1000);
}
这四个步骤紧密相扣:首先将散落在 JavaScript 运行时中的数据段汇聚成一个不可变的原始数据块(Blob);其次通知浏览器在当前文档上下文中分配一个 blob: 协议的 URI;随后通过 HTML5 规范的 download 属性强行告知浏览器这是一个“需要保存到本地磁盘的文件”而非“页面内导航”;最后切断所有外部句柄,确保内存能被垃圾回收器顺利收回。
二、深入底层:为什么必须主动清理内存?
许多初学者容易产生一种直觉误区:既然函数执行完毕,局部变量 blob 和 objectUrl 超出了作用域,JavaScript 引擎的垃圾回收器(Garbage Collection, GC)不就会自动回收对应的内存吗?
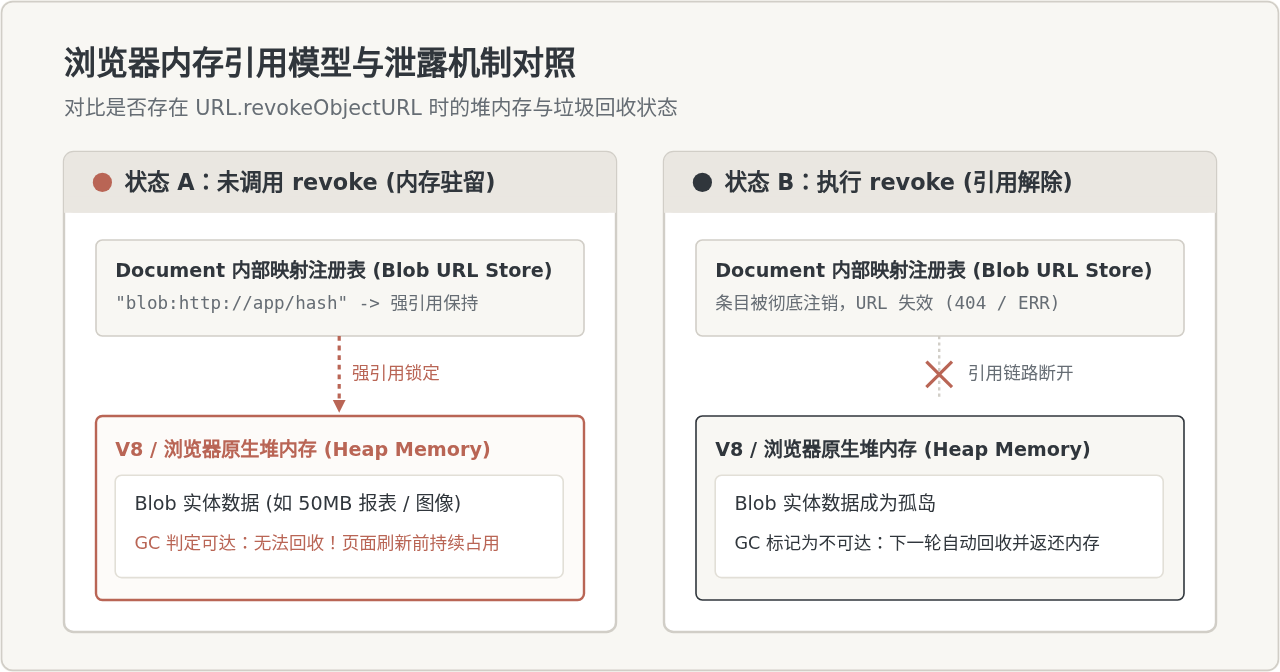
答案是不会立即回收。原因在于 URL.createObjectURL(blob) 的运行机制:
- 全局注册表强引用:为了让该 URL 能够在当前页面的任意位置(如
<img src="...">、fetch(url)或<a href="...">)被直接读取,浏览器底层会在原生 C++ 层的Document级别维护一张全局映射表(Blob URL Store)。 - 生命周期锚定页面:该映射表会将生成的唯一 URL 字符串与堆中的 Blob 物理数据牢牢绑定。只要当前网页(Document)不刷新或不关闭,这个强引用就会一直存在。
- 单页应用(SPA)的累积效应:在传统的服务端渲染页面中,每次页面跳转都会销毁整个 Document,从而释放所有未销毁的 Object URL。但在 Vue、React 等单页应用中,用户可能连续数天不刷新页面。如果用户频繁导出 10MB ~ 100MB 级别的数据报表且未调用
URL.revokeObjectURL(),几轮操作后浏览器标签页占用内存就会迅速攀升至数吉字节(GB),最终导致页面卡顿甚至崩溃闪退。
三、核心陷阱:为什么不能紧接着立即同步释放?
既然要及时清理内存,是不是在 link.click() 的下一行直接调用 URL.revokeObjectURL(objectUrl) 最干脆利落?
避坑警示:严禁在 link.click() 后立即同步调用 URL.revokeObjectURL(url)!在部分主流浏览器(特别是 Firefox、iOS Safari 或高负载环境下的 Chrome)中,这极易引发下载失败、生成 0 字节损坏文件或控制台抛出网络中断异常。
产生这一现象的本质是浏览器的跨进程与异步调度机制:
- 当 JavaScript 执行
link.click()时,DOM 主线程仅仅是向浏览器的下载管理器(Download Manager)或者网络进程派发了一个异步下载请求。 - 下载管理器接收到该请求后,需要在稍后的事件循环或独立工作线程中去解析
blob:http://...协议的资源地址,并从内核的 Blob URL Store 中读取二进制字节流。 - 如果我们在主线程同步执行了
URL.revokeObjectURL(),此时下载线程甚至还没来得及向内部存储区发起读取请求,对应的映射表条目就已被擦除。下载管理器因找不到对应的内存数据块,便会直接终止下载或报错ERR_FILE_NOT_FOUND。
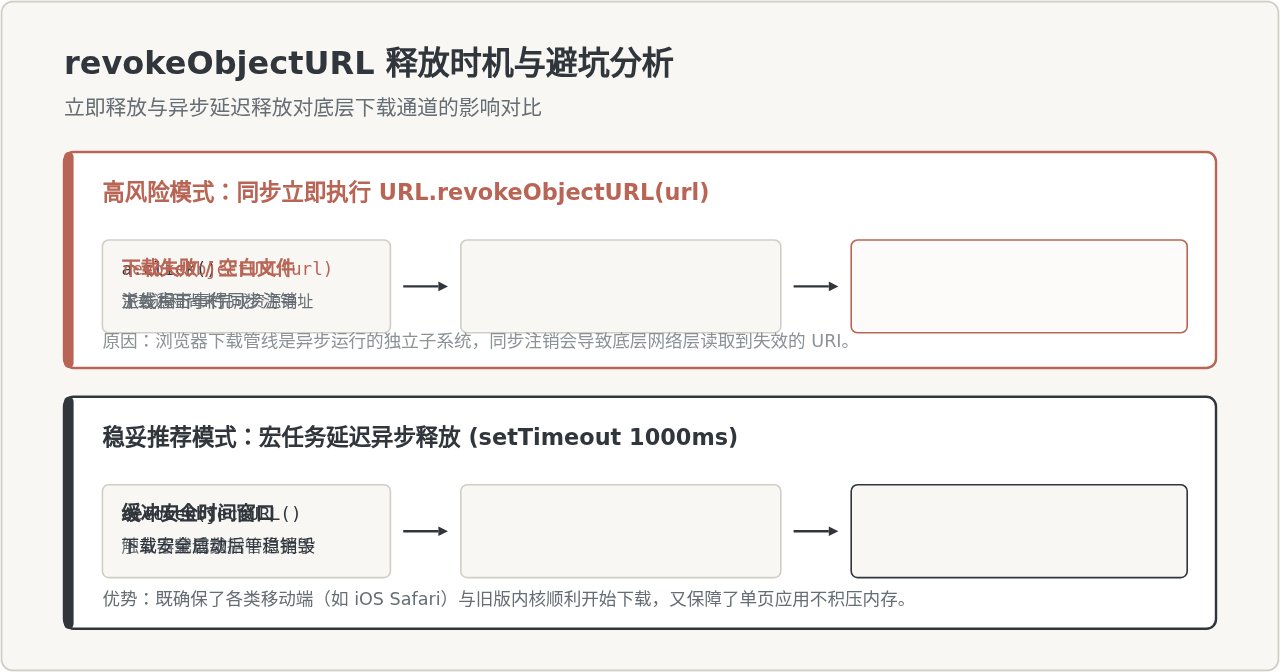
因此,业界通用的最佳实践是将 URL.revokeObjectURL() 包装在 setTimeout 宏任务中执行。设定 1000ms(在低配或大文件设备上可延长至 5000ms ~ 10000ms)足以让所有现代浏览器平稳完成文件流的句柄接收,之后执行注销不仅安全可靠,还能保证页面长期闲置时内存始终处于低水平。
四、生产级封装:高可靠通用下载工具
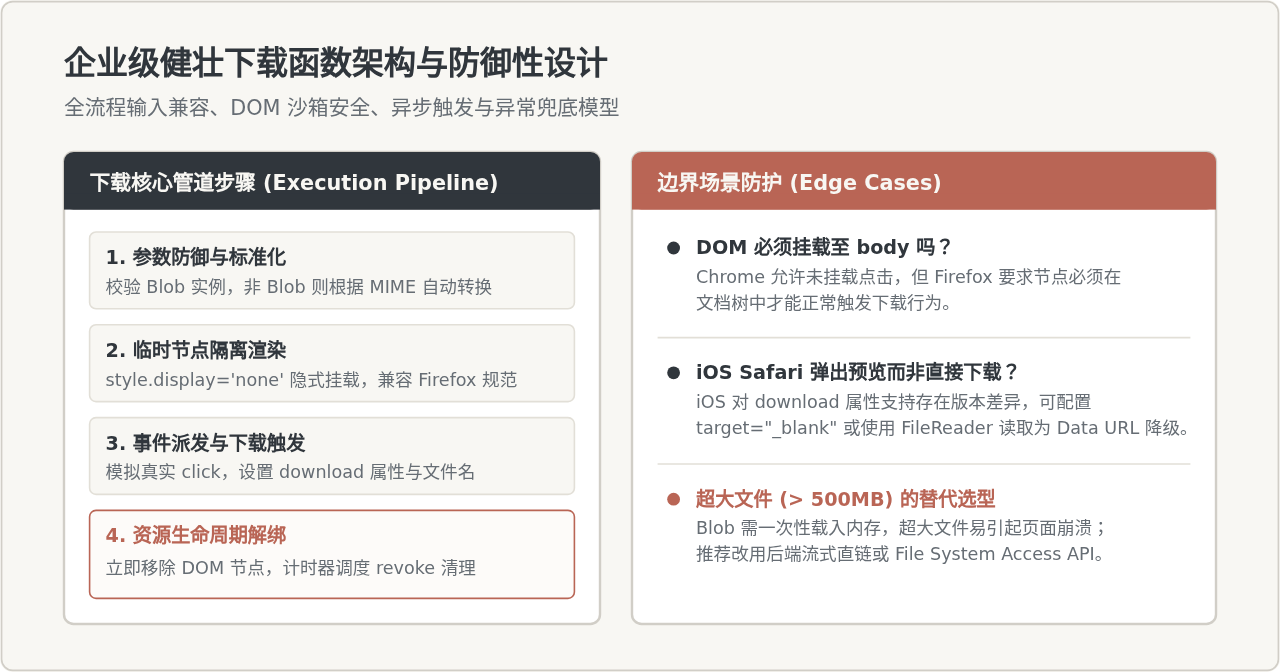
在实际企业级业务中,单纯几行代码往往无法应对多样的数据类型与边界情况。一个健壮的下载函数应当具备以下特征:
- 智能入参转换:能够无缝接收
Blob、纯文本、对象(自动JSON.stringify)或ArrayBuffer,并自动推导或应用默认 MIME 类型。 - DOM 树兼容挂载:虽然 Chrome 支持直接触发未挂载在 DOM 树中的
<a>标签,但 Firefox 和部分基于 WebKit 的嵌入式容器要求元素必须实际插入到document.body中才能生效。 - 防御性与异常恢复:采用
try...finally结构,即使触发过程出现未知异常,也能确保注入的 DOM 节点被干净移除,且定时释放任务始终能够排期运行。
/**
 * 通用 Blob 文件下载与自动内存清理函数
 * @param {Blob|ArrayBuffer|string|Object} rawData - 待下载的数据源
 * @param {string} fileName - 导出的文件名
 * @param {string} [customMime] - 可选的自定义 MIME 类型
 * @param {number} [revokeDelay=1000] - 注销 URL 的延迟毫秒数
 */
export function downloadBlobFile(rawData, fileName, customMime, revokeDelay = 1000) {
  if (!rawData) {
    throw new Error('[downloadBlobFile] 下载数据不能为空');
  }

  // 1. 规范化构建 Blob 实例
  let blobInstance;
  if (rawData instanceof Blob) {
    blobInstance = rawData;
  } else if (rawData instanceof ArrayBuffer || ArrayBuffer.isView(rawData)) {
    blobInstance = new Blob([rawData], { type: customMime || 'application/octet-stream' });
  } else if (typeof rawData === 'object') {
    const jsonStr = JSON.stringify(rawData, null, 2);
    blobInstance = new Blob([jsonStr], { type: customMime || 'application/json;charset=utf-8' });
  } else {
    blobInstance = new Blob([String(rawData)], { type: customMime || 'text/plain;charset=utf-8' });
  }

  // 2. 创建内部资源句柄
  const objectUrl = window.URL.createObjectURL(blobInstance);
  const link = document.createElement('a');

  try {
    link.href = objectUrl;
    link.download = fileName || 'downloaded_file';
    link.style.display = 'none';

    // 兼容 Firefox 等严格规范浏览器
    document.body.appendChild(link);

    // 派发原生点击
    link.click();
  } finally {
    // 无论成功与否,立即解绑 DOM 结构
    if (link.parentNode) {
      link.parentNode.removeChild(link);
    }

    // 异步延迟注销,彻底归还内存
    setTimeout(() => {
      window.URL.revokeObjectURL(objectUrl);
    }, Math.max(500, revokeDelay));
  }
}
五、常见业务问题与排查清单
在不同平台与复杂网络环境下,Blob 下载常会遇到一些隐蔽的边缘问题,可对照以下清单排查:
| 表现症状 | 根因机理 | 应对与解决方案 |
|---|---|---|
| 导出的文件名未生效 | 若使用的并非当前域下的本地 Blob URL,而是跨域 URL,浏览器会忽略 download 属性。 |
必须先通过 fetch 或 axios 将跨域资源以 Blob 形式完整拉取到当前内存,再创建同源的 blob: URL 下载。 |
| 文件下载为 0 字节或损坏 | 在主线程同步调用了 URL.revokeObjectURL(),下载器尚未读取映射表。 |
使用 setTimeout(() => URL.revokeObjectURL(url), 1000) 将注销操作放入宏任务队列延迟处理。 |
| Firefox 下无任何反应 | Firefox 严格执行 HTML 标准:未添加到 DOM 树中的链接元素派发点击事件不会触发实际行为。 | 在派发 link.click() 前执行 document.body.appendChild(link),并在 finally 块中 removeChild。 |
| iOS Safari 打开预览而非保存 | WebKit 历史版本对客户端触发的 download 属性支持不一致,常强制调用内置预览器。 |
设置 link.target = '_blank';或对于较小文件转为 FileReader.readAsDataURL() 降级。 |
六、技术边界:何时不该使用 Blob 下载?
虽然 Blob 下载非常便捷,但它并非适用于所有场景。其核心物理限制在于:Blob 数据完全保存在客户端运行时的物理内存(RAM)中。
当文件体积超出 500MB 甚至达到几个吉字节(例如超大数据库备份、高清视频文件、海量原始影像打包)时,前端若尝试将其读取为整个 Blob,会导致浏览器标签页内存暴涨甚至触发操作系统 OOM(Out Of Memory)直接杀掉进程。在此类超大文件场景下,应优先考虑以下替代架构:
- 后端直链 + Content-Disposition:由后端服务端提供带有标准 HTTP 响应头
Content-Disposition: attachment; filename="example.ext"的直链或短期预签名 URL,前端只需常规跳转或新标签打开,让浏览器直接从网络流写入磁盘。 - Streams API + File System Access API:在支持的现代桌面浏览器(Chromium 核心)中,使用
window.showSaveFilePicker()获取本地文件的可写流句柄(FileSystemWritableFileStream),配合fetch(url).then(res => res.body.pipeTo(...))实现真正的边下载边落盘,内存占用始终仅维持在单个分片大小(几十千字节)。
七、总结
前端利用 JavaScript 实现 Blob 下载的核心机制,是通过 URL.createObjectURL() 在浏览器内核层建立数据映射,配合带有 download 属性的隐藏 <a> 标签触发原生下载。而保障单页应用性能与健康度的关键,在于绝不遗漏 URL.revokeObjectURL() 的自动注销,并且必须采用宏任务延迟释放(如 setTimeout 1000ms),避免在底层尚未完成数据管道握手前提前注销句柄。通过结合 DOM 安全插拔与入参防御,即可在各类业务中打造稳定、优雅且内存无忧的文件导出方案。
JavaScript零基础入门:从环境搭建到运行第一段代码
2026-11-05 15:29:58
HTML链接中javascript:void(0)的作用及现代替代方案
2026-11-05 10:07:47
在线调试 JS 时怎么引入 jQuery 或 Vue 等第三方库
2026-11-05 08:53:56
原生JavaScript实现简易颜色选择器原理与代码
2026-11-03 23:22:19
JS原生表单序列化:FormData与URLSearchParams用法详解
2026-11-03 23:13:21