JavaScript前端大文件下载内存优化:避免浏览器崩溃的策略
深入剖析前端处理大文件下载时导致浏览器内存溢出(OOM)崩溃的根源,并系统讲解从服务端直传、Streams API流式落盘到Service Worker虚拟拦截下载等核心内存优化策略与代码实现。
在前端处理数百兆甚至数吉字节(GB)的文件下载时,若盲目将响应全部转为 Blob 缓存,极易导致浏览器堆内存耗尽并抛出内存溢出(OOM)崩溃。优化大文件下载的核心逻辑在于打破全量驻留模型,改用流式分块边下边存。本文将分析内存暴增的机制,并详解原生直传、FileSystem Access API 流式落盘与 Service Worker 虚拟拦截三种实用优化方案。
一、内存崩溃的根源:传统 Blob 全量缓存
许多业务代码中实现文件下载的标准范式通常是先使用 fetch 或 axios 请求文件接口,等待数据整体返回后再转换为 Blob,随后通过 URL.createObjectURL(blob) 构造虚拟地址并触发 <a download> 点击事件。
// 存在严重内存崩溃隐患的传统写法
async function downloadFileUnsafe(url, filename) {
  const response = await fetch(url);
  // 数据全量加载到 V8 堆内存/渲染进程内存中
  const blob = await response.blob();
  const downloadUrl = URL.createObjectURL(blob);

  const a = document.createElement('a');
  a.href = downloadUrl;
  a.download = filename;
  document.body.appendChild(a);
  a.click();
  document.body.removeChild(a);
  URL.revokeObjectURL(downloadUrl);
}
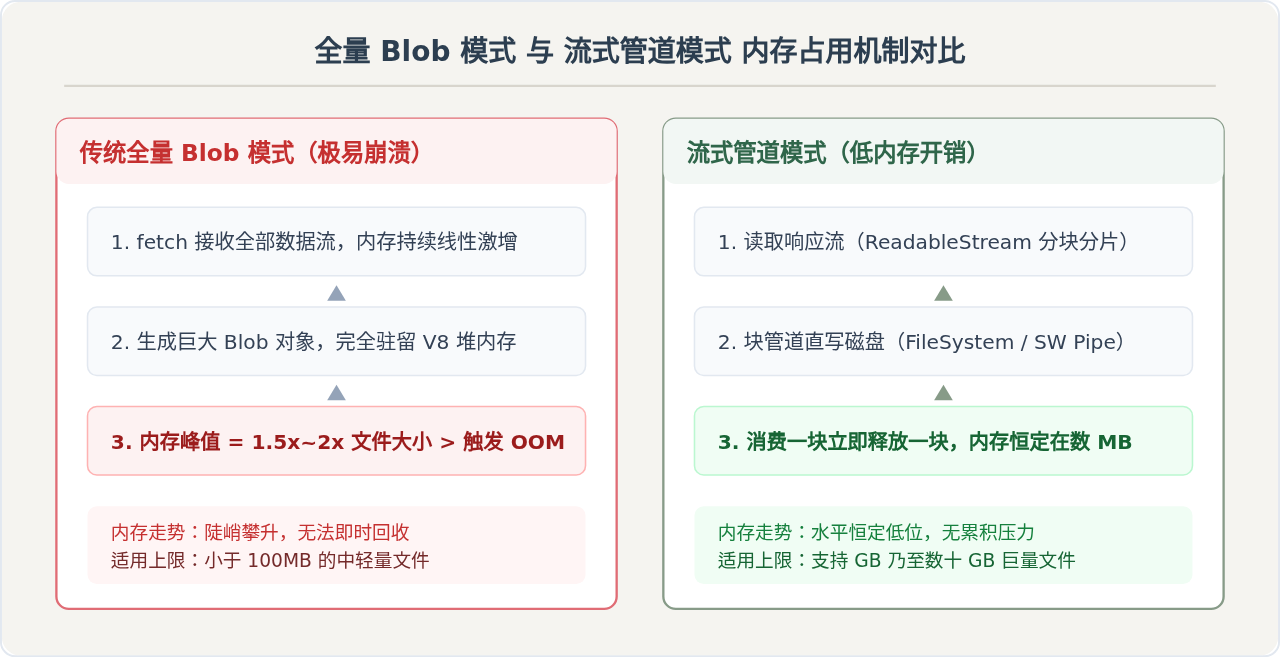
这种模式处理几十兆的图片或文档表现良好,但当文件增长到 500MB 或数 GB 时,浏览器进程极可能崩溃。原因主要有三点:
- 渲染进程内存上限:大多数桌面端 Chromium 浏览器对单个渲染进程分配的堆内存和缓冲区上限通常在 1.4GB 到 4GB 之间。
- 多重内存拷贝:网络数据包从底层传输缓冲区解包到 JavaScript 运行时的
ArrayBuffer,再封装为Blob,并在内存中维系对象映射,往往会导致内存占用达到文件本身大小的 1.5 到 2 倍。 - 不可预期的垃圾回收时机:即使调用了
URL.revokeObjectURL(),已经生成的庞大 Blob 实例仍须等待 V8 垃圾回收周期才能完全释放,此期间若用户并发或快速重复发起下载,内存会瞬间击穿阈值。
二、策略一:服务端 Content-Disposition 原生直传
在寻找复杂的前端解决方案前,首先需要评估下载是否必须经过前端 JavaScript 介入。如果文件下载接口不需要在 Request Header 中注入动态的 Authorization: Bearer <token>,最稳妥、零前端内存占用的方案始终是直接委托给浏览器底层的网络下载管理器。
1. 服务端关键响应头
服务端需要设置标准的下载标头,指示浏览器将响应作为附件写入本地磁盘,而不是直接在窗口内预览:
Content-Disposition: attachment; filename="large-dataset.zip"
Content-Type: application/octet-stream
2. 前端触发方式
前端只需要通过常规超链接或动态创建不可见表单/<iframe> 触发地址导航,浏览器的独立下载进程会接管所有数据落盘操作,网页渲染线程的堆内存占用始终为零:
function downloadViaNativeBrowser(url) {
  const link = document.createElement('a');
  link.href = url;
  // 必须确保同源或者服务端已设置 Content-Disposition
  link.style.display = 'none';
  document.body.appendChild(link);
  link.click();
  document.body.removeChild(link);
}三、策略二:基于 FileSystem Access API 的流式落盘
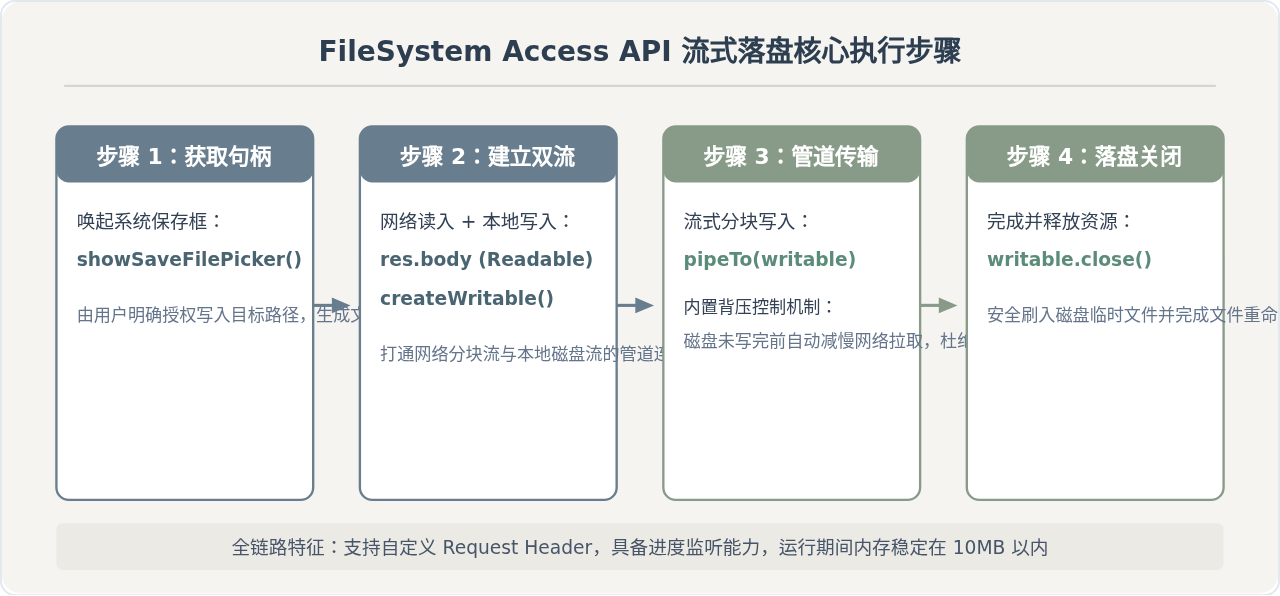
现代 Chromium 浏览器(Chrome 86+、Edge 等)支持 FileSystem Access API。该接口允许网页直接向用户指定的文件句柄写入流式数据。借助 fetch 返回的 ReadableStream,我们可以建立一条管道:网络层每到达一个 Chunk 数据块,就立即通过 WritableStream 写入磁盘,随后该数据块便可被垃圾回收,内存占用始终被约束在单个 Chunk 的大小以内。
1. 完整落地代码实现
以下代码展示了如何获取文件写入句柄,并通过 TransformStream 结合 pipeTo 在传输过程中兼顾进度反馈与流式落盘:
/**
 * 使用 FileSystem Access API 进行流式低内存下载
 * @param {string} url 下载地址
 * @param {string} defaultFilename 建议保存的文件名
 * @param {Function} onProgress 进度回调 (loaded, total) => void
 */
async function downloadWithFileSystemStream(url, defaultFilename, onProgress) {
  // 1. 检查浏览器支持性
  if (!('showSaveFilePicker' in window)) {
    throw new Error('当前浏览器不支持 FileSystem Access API,需使用降级方案');
  }

  // 2. 引导用户选择保存路径并获取文件句柄
  const fileHandle = await window.showSaveFilePicker({
    suggestedName: defaultFilename,
  });

  // 3. 发起请求并携带鉴权信息
  const response = await fetch(url, {
    method: 'GET',
    headers: {
      'Authorization': 'Bearer ' + localStorage.getItem('token'),
    },
  });

  if (!response.ok) {
    throw new Error(`网络请求失败:HTTP ${response.status}`);
  }

  const contentLength = Number(response.headers.get('Content-Length')) || 0;
  let receivedBytes = 0;

  // 4. 创建本地文件的写入流
  const writableStream = await fileHandle.createWritable();

  // 5. 构造进度追踪转换流(用于统计进度,同时透传数据)
  const progressTrackingStream = new TransformStream({
    transform(chunk, controller) {
      receivedBytes += chunk.length;
      if (typeof onProgress === 'function') {
        onProgress(receivedBytes, contentLength);
      }
      controller.enqueue(chunk);
    }
  });

  // 6. 建立管道连接:网络响应流 -> 进度转换流 -> 本地文件写入流
  // pipeTo 自动处理了背压(Backpressure):如果磁盘写入较慢,会自动限制网络读取
  try {
    await response.body
      .pipeThrough(progressTrackingStream)
      .pipeTo(writableStream);
    console.log('文件下载并成功写入本地磁盘');
  } catch (err) {
    // 异常情况下尝试中止写入流
    await writableStream.abort(err);
    throw err;
  }
}pipeTo 默认集成了背压机制(Backpressure)。如果本地磁盘写入速度慢于网络接收速度,管道会向上游发出暂停拉取的信号,从而避免未消费的数据块在渲染进程内存队列中持续挤压。
四、策略三:非 Chromium 环境兼容降级——Service Worker 虚拟流拦截
Firefox、Safari 以及非安全上下文(未启用 HTTPS 的内网测试域)并不支持 showSaveFilePicker。在这些环境中,若直接回退到全量 Blob 仍然会面临崩溃风险。此时的最佳策略是利用 Service Worker 虚拟流拦截(即 StreamSaver.js 所使用的底层原理)。
1. 运作原理
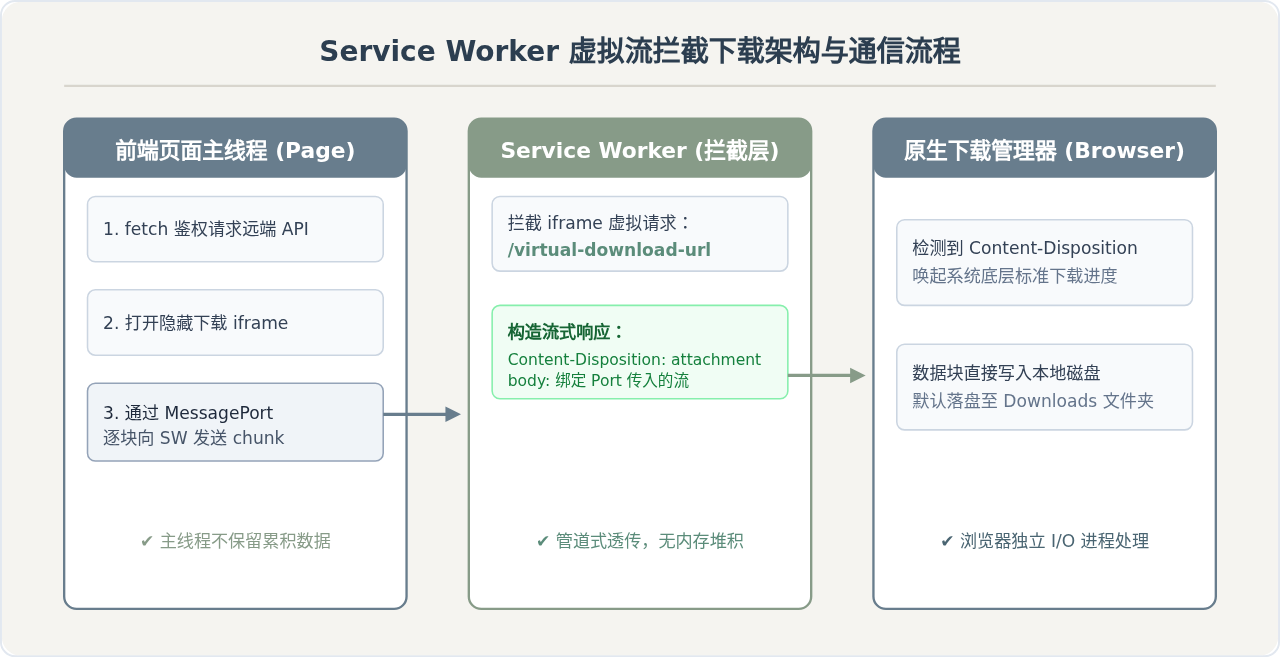
Service Worker 作为独立的网络代理线程,具备拦截和构造网络响应的能力。它的运行逻辑如下:
- 前端页面向 Service Worker 发送一条包含目标文件名和下载意向的消息,并附带一个
MessageChannel。 - Service Worker 注册一个虚拟下载地址(例如
/sw-download-virtual-stream)。 - 前端页面通过隐藏的
<iframe>访问该虚拟地址。 - Service Worker 拦截该请求,并返回一个
Response,在该响应的标头中注入Content-Disposition: attachment; filename="..."。 - 其响应体直接绑定到前端通过
MessagePort逐块转发过来的数据流。 - 浏览器发现这是一个携带附件下载头的 HTTP 响应,便会自动启动原生的下载管理器将流数据写入用户的“下载”目录,避免了将全部数据加载到主线程内存中。
2. 核心拦截代码示例
在 sw.js 中监听 fetch 事件,拦截专用的虚拟路由:
// service-worker.js
self.addEventListener('fetch', (event) => {
  const url = new URL(event.request.url);

  // 匹配约定的虚拟下载路径
  if (url.pathname === '/mock-stream-download') {
    const filename = url.searchParams.get('filename') || 'download.bin';

    // 建立 TransformStream 作为中继传输通道
    const { readable, writable } = new TransformStream();

    // 监听来自页面的数据块输入
    event.respondWith(
      new Response(readable, {
        headers: {
          'Content-Type': 'application/octet-stream; charset=utf-8',
          'Content-Disposition': `attachment; filename="${encodeURIComponent(filename)}"`,
          'Content-Security-Policy': "default-src 'none'",
          'X-Content-Type-Options': 'nosniff',
        },
      })
    );

    // 等待页面主线程通过 MessageChannel 将 writer 绑定
    event.waitUntil(setupStreamBridge(event.clientId, writable));
  }
});
五、工程化落地时的关键边界与避坑细节
在具体工程化实践中,除选定下载方案外,还需要在连接控制、断点处理与内存泄漏防范上做好容错处理:
1. 警惕手动分块缓冲区的隐式内存泄漏
部分开发者在实现分块下载或计算进度时,喜欢定义一个内部数组收集分片:
// 错误模式:虽然使用了流,但内部又把全部 chunks 推入了数组
const chunks = [];
const reader = response.body.getReader();
while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  chunks.push(value); // 错误:内存依然随文件体积持续累加!
}
const finalBlob = new Blob(chunks); // 依然会触发 OOM
优化方案必须保证每个 value (Uint8Array) 在完成写入或进度累加后,不再被任何全局变量或闭包引用,以便 JavaScript 引擎在下一次 GC 周期能顺利将其标记清理。
2. 使用 AbortController 保证异常时的资源释放
大文件传输耗时较长,用户可能会随时取消操作或遭遇网络波动中断。必须通过 AbortController 绑定 fetch 的 signal,并在捕获到异常时显式关闭或中止本地可写流:
const abortController = new AbortController();

async function handleCancel() {
  abortController.abort();
  if (writableStream) {
    await writableStream.abort('用户手动取消');
  }
}
3. 服务端 Range 分块与断点续传配合
对于超过 2GB 的极端巨型文件,单次 HTTP 连接长时间维持极易因网络抖动中断而全功尽弃。前端应配合服务端的 Accept-Ranges: bytes 头,采用“按范围分片请求(如每次请求 20MB)+ FileSystem 连续写入特定偏移量(writer.seek(offset))”的策略,这样不仅内存安全,还能实现真正可靠的断点续传。
六、方案选型矩阵与决策树
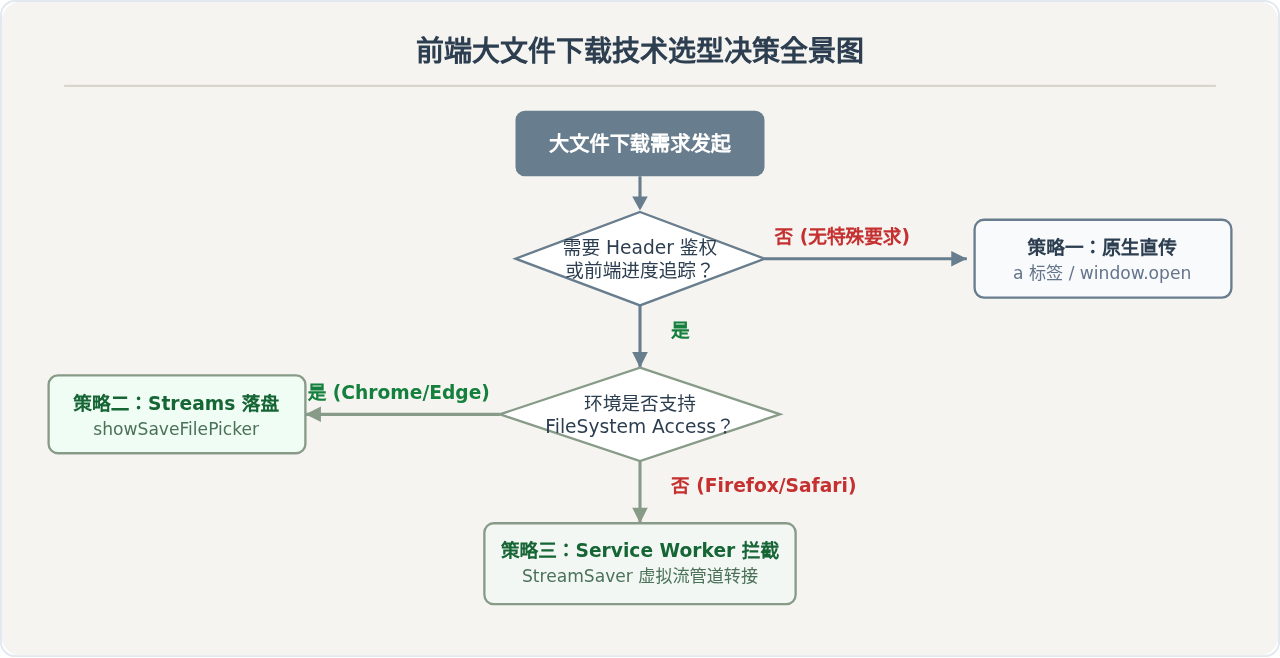
不同下载策略在浏览器兼容性、鉴权控制力以及内存表现上的对比总结如下表:
| 策略名称 | 内存占用 | 自定义 Header 鉴权 | 下载进度监听 | 浏览器兼容范围 |
|---|---|---|---|---|
| 原生直传 (Content-Disposition) | 0 MB(完全不占 JS 内存) | 不支持(仅支持 Cookie/Query) | 无法在页面感知 | 全平台全浏览器通用 |
| FileSystem Access API | 极低(< 15 MB 恒定) | 完整支持 | 支持精确进度与速度计算 | Chrome / Edge 86+ (HTTPS) |
| Service Worker 虚拟拦截 | 低(< 30 MB 恒定) | 完整支持 | 支持页面端进度统计 | 现代主流浏览器 (HTTPS) |
| 全量 Blob 模式 (反面教材) | 极高(1.5x ~ 2x 文件大小) | 完整支持 | 支持 | 全浏览器(但大文件易崩溃) |
七、总结
前端大文件下载导致浏览器崩溃的本质是内存全量驻留模型与有限堆内存空间之间的冲突。在面对海量数据传输需求时,应优先遵循以下优化步骤:
- 审视网络与鉴权模型:如果通过 Cookie 或临时签名 URL 即可鉴权,优先采用服务端
Content-Disposition原生直传,让下载脱离前端运行时。 - 拥抱现代 Streams 规范:在需要 Header 鉴权和进度监控的现代浏览器环境中,全面转向
FileSystem Access API与ReadableStream.pipeTo(),实现即收即写、内存恒定的流式落盘。 - 完备降级策略:对未提供直接落盘 API 的浏览器环境,使用
Service Worker将流管道封装为虚拟下载任务,确保全平台体验一致且无内存溢出隐患。
为什么JS调用reload后页面没有立即更新
2026-11-05 13:38:29
crypto-js 加密结果与 Java/Python 后端不一致怎么解决
2026-11-05 12:09:48
js文件缓存导致代码不更新怎么强制刷新
2026-11-04 22:30:24
JS逆向调试技巧:编写Hook脚本监控加密函数输入输出
2026-11-04 10:42:46
Babylon.js 性能优化技巧:实例化网格与遮挡剔除
2026-11-03 23:43:22