

Node.js环境下使用fs模块批量处理文件的JavaScript脚本
本文深入讲解在Node.js环境下利用原生fs模块(fs/promises)编写高性能批量文件处理脚本的完整方法,包含目录扫描、过滤规则、安全试运行机制、并发控制及错误隔离方案。
在日常开发与数据整理工作中,针对成百上千个文件进行统一重命名、内容模板替换、格式转换或清理冗余数据是极其普遍的需求。Node.js 凭借非阻塞 I/O 特性及内置的 fs(File System)模块,无需安装任何第三方库,即可在本地高效完成大批量文件的自动化处理。本文将基于现代 Node.js 的 node:fs/promises 规范,提供一套健壮、安全且可直接运行的批量文件处理脚本,并详解递归扫描、安全过滤、试运行保护与并发控制的核心细节。
一、批量文件处理流程设计与执行阶段
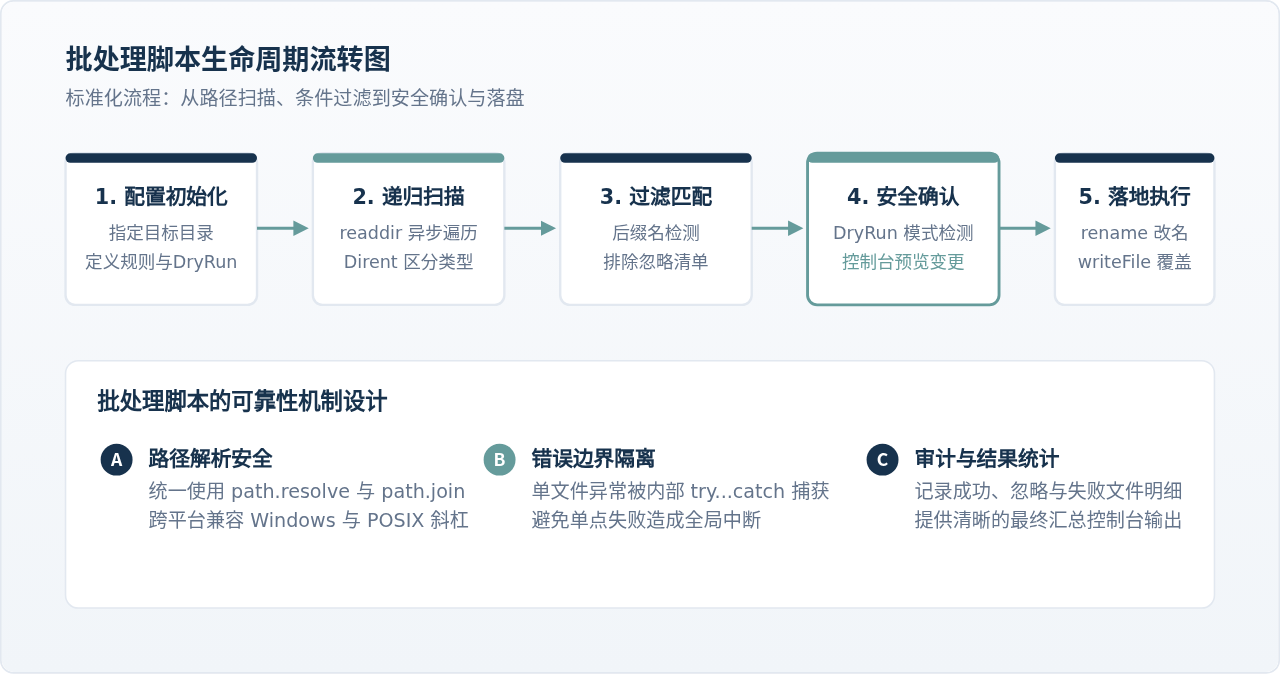
编写任何自动化批处理脚本时,首要原则是“防御性编程”。如果缺乏有效的前置过滤与安全确认机制,一条带有逻辑缺陷的脚本可能在毫秒内覆写或破坏目标目录中的所有数据。一个规范的批量处理脚本应当严格划分为五个递进阶段:
- 参数定义与上下文准备:明确目标根路径、目标文件扩展名、重命名规则或内容变换函数,并设定安全开关(如
dryRun试运行模式)。 - 深度目录扫描:使用非阻塞方式递归遍历目标文件夹,收集所有符合条件的待处理文件相对与绝对路径。
- 模式匹配与规则筛选:排除临时文件、版本控制隐藏目录(如
.git)以及非目标类型的文件。 - 变换与原子化执行:在内存中计算目标文件名或文件内容,按序或受控批次执行文件重命名或内容写入。
- 审计日志与结果汇总:输出明确的处理成功、跳过与错误统计,提供可复盘的操作清单。
二、核心 API 解析与 fs/promises 的优势
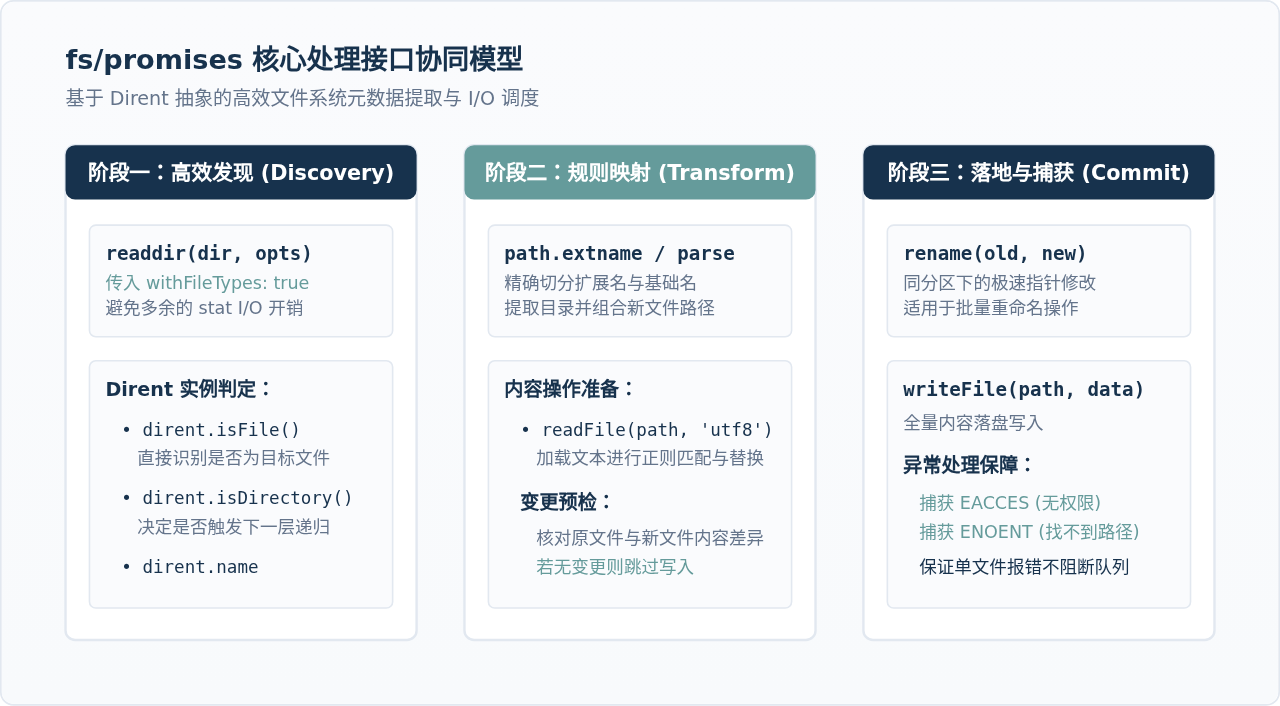
在旧版 Node.js 代码中,常能见到传统回调函数风格(fs.readdir(path, (err, files) => {}))或同步调用(fs.readdirSync)。在现代 Node.js 脚本编写中,强烈建议优先引入 node:fs/promises。它直接返回原生 Promise,完美配合 async/await 语法,既具备非阻塞异步的高性能,又保持了线性同步代码的易读性。
此外,目录扫描的关键在于 fs.promises.readdir(dirPath, { withFileTypes: true }) 参数。启用 withFileTypes: true 后,返回的数组中不再是简单的文件名字符串,而是 fs.Dirent 实例对象。这一改进省去了对每个文件单独执行 fs.stat 判定是文件还是文件夹的系统调用开销,大幅提升了对包含海量文件目录的扫描效率。
三、可直接运行的完整批量处理脚本
以下 JavaScript 脚本实现了一个完整的批处理范例:对指定目录下的文件进行递归扫描,支持过滤特定后缀名(如 .md、.txt 或 .json),在正文中统一替换指定模式的内容,并为文件名规范化添加前缀。同时,内置了非常关键的 dryRun 开关。
// batch_processor.mjs
import fs from 'node:fs/promises';
import path from 'node:path';

/**
 * 批处理任务配置对象
 */
const CONFIG = {
  // 目标根目录(绝对路径或相对当前执行位置的路径)
  targetDir: './documents',
  // 只处理这些后缀的文件(留空数组表示不限制后缀)
  allowedExtensions: ['.md', '.txt'],
  // 忽略的目录名称(不进入递归)
  ignoredDirectories: ['.git', 'node_modules', 'dist', 'build'],
  // 是否启用试运行模式(true 时只打印日志,不产生任何实际修改)
  dryRun: true,
  // 文本内容替换规则:将旧关键词替换为新关键词
  contentReplacements: [
    { search: /OLD_PROJECT_NAME/g, replaceWith: 'NEW_CORE_SYSTEM' },
    { search: /http:\/\/localhost:3000\/g, replaceWith: 'https://api.example.com' }
  ],
  // 文件名修改规则(如不需重命名,返回 null 即可)
  renameTransformer: (oldFilename) => {
    // 示例:如果文件名不以 2026- 开头,则添加时间前缀
    if (!oldFilename.startsWith('2026-')) {
      return `2026-${oldFilename}`;
    }
    return null;
  }
};

/**
 * 递归扫描目录,收集所有符合条件的文件路径
 * @param {string} currentDir 当前扫描的目录路径
 * @param {object} options 扫描配置
 * @returns {Promise<string[]>} 文件的绝对路径列表
 */
async function scanFilesRecursively(currentDir, options) {
  const resultFiles = [];
  let entries;

  try {
    // 使用 withFileTypes: true 避免额外的 fs.stat 调用
    entries = await fs.readdir(currentDir, { withFileTypes: true });
  } catch (err) {
    console.error(`[目录扫描失败] 无法读取目录: ${currentDir},原因: ${err.message}`);
    return resultFiles;
  }

  for (const entry of entries) {
    const fullPath = path.join(currentDir, entry.name);

    if (entry.isDirectory()) {
      if (!options.ignoredDirectories.includes(entry.name)) {
        const subFiles = await scanFilesRecursively(fullPath, options);
        resultFiles.push(...subFiles);
      }
    } else if (entry.isFile()) {
      const ext = path.extname(entry.name).toLowerCase();
      if (options.allowedExtensions.length === 0 || options.allowedExtensions.includes(ext)) {
        resultFiles.push(fullPath);
      }
    }
  }

  return resultFiles;
}

/**
 * 单个文件的处理核心函数
 * @param {string} filePath 文件绝对路径
 * @param {object} config 配置选项
 * @returns {Promise<{status: string, message: string}>}
 */
async function processSingleFile(filePath, config) {
  try {
    const dir = path.dirname(filePath);
    const originalName = path.basename(filePath);

    // 1. 读取原文本内容
    const originalContent = await fs.readFile(filePath, 'utf8');
    let modifiedContent = originalContent;

    // 2. 执行文本内容替换
    for (const rule of config.contentReplacements) {
      modifiedContent = modifiedContent.replace(rule.search, rule.replaceWith);
    }
    const hasContentChanged = (modifiedContent !== originalContent);

    // 3. 计算重命名新路径
    let targetPath = filePath;
    const newName = config.renameTransformer ? config.renameTransformer(originalName) : null;
    const hasNameChanged = Boolean(newName && newName !== originalName);

    if (hasNameChanged) {
      targetPath = path.join(dir, newName);
    }

    if (!hasContentChanged && !hasNameChanged) {
      return { status: 'SKIPPED', message: `内容及文件名均无变化: ${originalName}` };
    }

    // 4. 若处于试运行状态,仅打印预期动作
    if (config.dryRun) {
      const actions = [];
      if (hasContentChanged) actions.push('文本内容将被替换');
      if (hasNameChanged) actions.push(`重命名为 -> ${newName}`);
      return { status: 'DRY_RUN', message: `[预演] ${originalName} (${actions.join(', ')})` };
    }

    // 5. 正式落盘:先写回内容,再执行重命名
    if (hasContentChanged) {
      await fs.writeFile(filePath, modifiedContent, 'utf8');
    }
    if (hasNameChanged) {
      await fs.rename(filePath, targetPath);
    }

    return { status: 'SUCCESS', message: `已处理完成: ${originalName} -> ${hasNameChanged ? newName : originalName}` };
  } catch (error) {
    return { status: 'ERROR', message: `处理失败 [${path.basename(filePath)}]: ${error.message}` };
  }
}

/**
 * 批量处理执行入口
 */
async function runBatchJob() {
  const absoluteTargetDir = path.resolve(CONFIG.targetDir);
  console.log('='.repeat(65));
  console.log(`Node.js 批量文件处理任务启动`);
  console.log(`目标路径: ${absoluteTargetDir}`);
  console.log(`执行模式: ${CONFIG.dryRun ? '【试运行 DRY-RUN】(数据安全,无写操作)' : '【正式写入 LIVE】'}`);
  console.log('='.repeat(65));

  // 1. 扫描文件
  const filesToProcess = await scanFilesRecursively(absoluteTargetDir, CONFIG);
  console.log(`扫描完成,共命中 ${filesToProcess.length} 个候选文件。\n`);

  if (filesToProcess.length === 0) {
    console.log('未找到符合条件的文件,流程正常退出。');
    return;
  }

  // 2. 统计量
  const stats = { SUCCESS: 0, DRY_RUN: 0, SKIPPED: 0, ERROR: 0 };

  // 3. 顺序遍历执行(可换用批次并发,见下文解析)
  for (let i = 0; i < filesToProcess.length; i++) {
    const file = filesToProcess[i];
    const result = await processSingleFile(file, CONFIG);
    stats[result.status] = (stats[result.status] || 0) + 1;
    console.log(`[${i + 1}/${filesToProcess.length}] [${result.status}] ${result.message}`);
  }

  // 4. 汇总报告
  console.log('\n' + '='.repeat(65));
  console.log('批量处理结果审计清单:');
  console.log(`- 成功写入: ${stats.SUCCESS}`);
  console.log(`- 试运行预演: ${stats.DRY_RUN}`);
  console.log(`- 规则跳过: ${stats.SKIPPED}`);
  console.log(`- 错误异常: ${stats.ERROR}`);
  console.log('='.repeat(65));
}

// 启动执行
runBatchJob().catch(err => {
  console.error('全局未捕获异常:', err);
});
四、高并发 I/O 陷阱与批量并发控制
许多初学者在熟悉了 Promise.all 后,习惯于将整个数组直接映射并发执行:await Promise.all(files.map(file => process(file)))。在处理几十个小文件时,这种写法速度极快且通常不会报错;但一旦面对包含数万个文件的大型项目或归档数据,这种写法将直接导致程序崩溃。
操作系统对单个进程同时能够打开的文件描述符(File Descriptors)数量设有严格上限(在 Linux/macOS 上通常为 1024 或 4096)。如果不加控制地瞬间发起上万个 fs.readFile 操作,内核会直接抛出 EMFILE: too many open files 错误导致整个任务中途瘫痪。
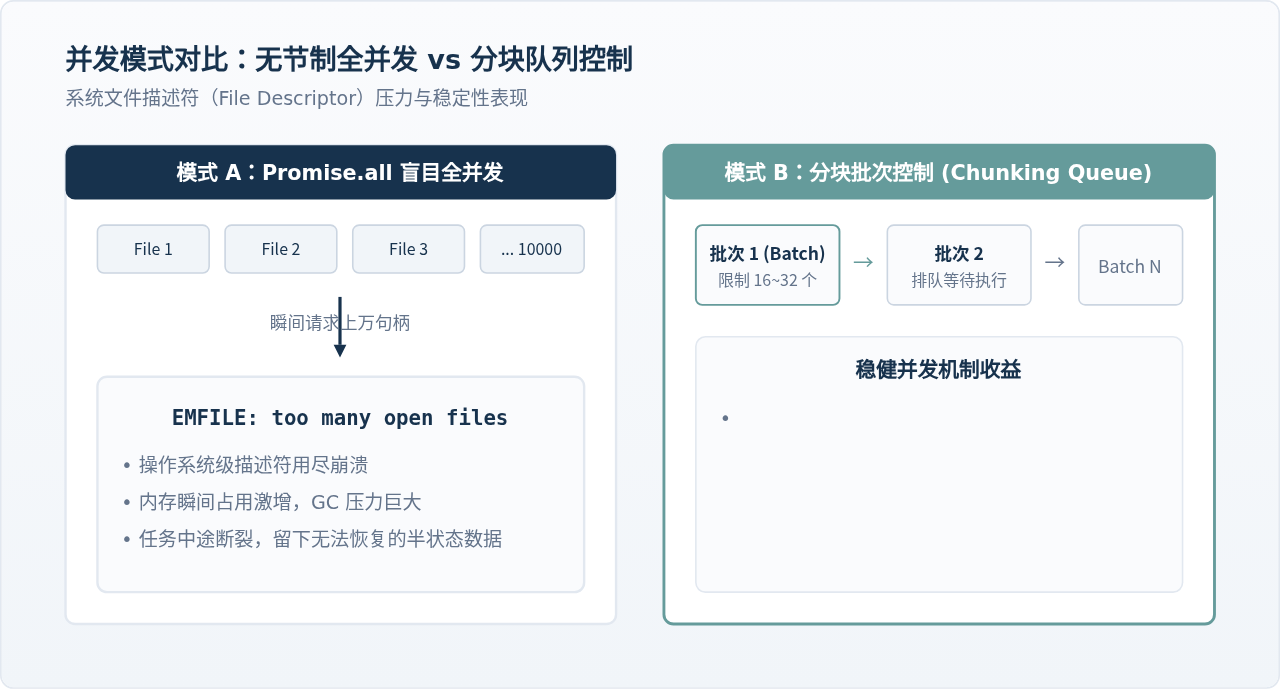
实现可控并发非常简单,无需安装外部复杂队列库。我们只需编写一个简单的数组分块辅助函数即可:
/**
 * 将长数组按照固定规格切分为小批次数组
 */
function chunkArray(array, chunkSize) {
  const chunks = [];
  for (let i = 0; i < array.length; i += chunkSize) {
    chunks.push(array.slice(i, i + chunkSize));
  }
  return chunks;
}

// 在批量任务中使用:每次只并发执行 20 个文件的处理
const BATCH_SIZE = 20;
const fileBatches = chunkArray(filesToProcess, BATCH_SIZE);

for (let batchIndex = 0; batchIndex < fileBatches.length; batchIndex++) {
  const currentBatch = fileBatches[batchIndex];

  // 使用 Promise.allSettled 确保某个文件读写错误不会导致同批次其他任务终止
  const batchResults = await Promise.allSettled(
    currentBatch.map(filePath => processSingleFile(filePath, CONFIG))
  );

  batchResults.forEach(res => {
    if (res.status === 'fulfilled') {
      console.log(res.value.message);
    } else {
      console.error('批次处理未知异常:', res.reason);
    }
  });
}
五、操作步骤、结果验证与常见陷阱排查
为了确保脚本在开发机与生产服务器上的行为完全一致且不发生意外事故,执行过程应遵循标准化操作规范:
1. 环境与执行前准备
- 推荐环境:Node.js v16.0.0 以上版本(原生内置稳定
node:fs/promises与 ES 模块支持)。 - 保存文件:将上述脚本保存为
batch_processor.mjs(使用.mjs后缀或在package.json中设置"type": "module")。 - 创建模拟测试环境:不要一开始就拿真实数据做实验。创建一个测试目录
mkdir documents,并在其中生成几个包含旧文本的文件。
2. 运行与验证过程
- 第一步(试运行验证):确保
CONFIG.dryRun = true,执行命令:
预期输出示例:node batch_processor.mjs================================================================= Node.js 批量文件处理任务启动 目标路径: /Users/username/project/documents 执行模式: 【试运行 DRY-RUN】(数据安全,无写操作) ================================================================= 扫描完成,共命中 3 个候选文件。 [1/3] [DRY_RUN] [预演] readme.md (文本内容将被替换, 重命名为 -> 2026-readme.md) [2/3] [DRY_RUN] [预演] config.txt (文本内容将被替换) [3/3] [SKIPPED] 内容及文件名均无变化: 2026-notes.txt ================================================================= 批量处理结果审计清单: - 成功写入: 0 - 试运行预演: 2 - 规则跳过: 1 - 错误异常: 0 ================================================================= - 第二步(真实写入执行):核对输出日志,确认被修改的文件与新名称均符合预期后,将配置修改为
CONFIG.dryRun = false,再次执行脚本完成落盘。 - 第三步(二次幂等性验证):不改动文件,紧接着再次执行一次
node batch_processor.mjs。此时所有文件应当显示为[SKIPPED],成功确认脚本具备良好的幂等性。
3. 常见问题排查与关键提醒
| 异常现象 / 错误代号 | 根本原因 | 解决方案 |
|---|---|---|
EACCES: permission denied |
当前 Node.js 进程没有该目标文件或文件夹的写权限。 | 检查终端运行用户的权限,或在操作前通过 fs.access(file, fs.constants.W_OK) 进行预判。 |
| Windows 系统下路径斜杠错乱 | 使用了硬编码的 / 或 \ 拼接路径。 |
始终使用 path.join 和 path.resolve,切勿使用字符串模版手动拼接路径。 |
| 中文或特殊字符乱码 | 以未指定编码的方式读取文件,默认返回 Buffer 对象。 | 在 readFile 中显式传入 'utf8' 字符串编码参数。 |
| 重命名目标已存在导致覆盖 | 变换规则生成了与同目录下已有文件重复的名字。 | 在执行 fs.rename 前,通过辅助方法检查新路径是否已存在,或增加防重后缀。 |
六、批处理脚本工程化总结与实施清单
使用 Node.js 原生 fs 模块编写批量处理脚本,不仅零外部依赖、启动迅速,而且跨平台能力出众。为了在未来的开发工作中快速复用并确保每次批量修改的安全性,可参照下述工程化四维准则进行核对:
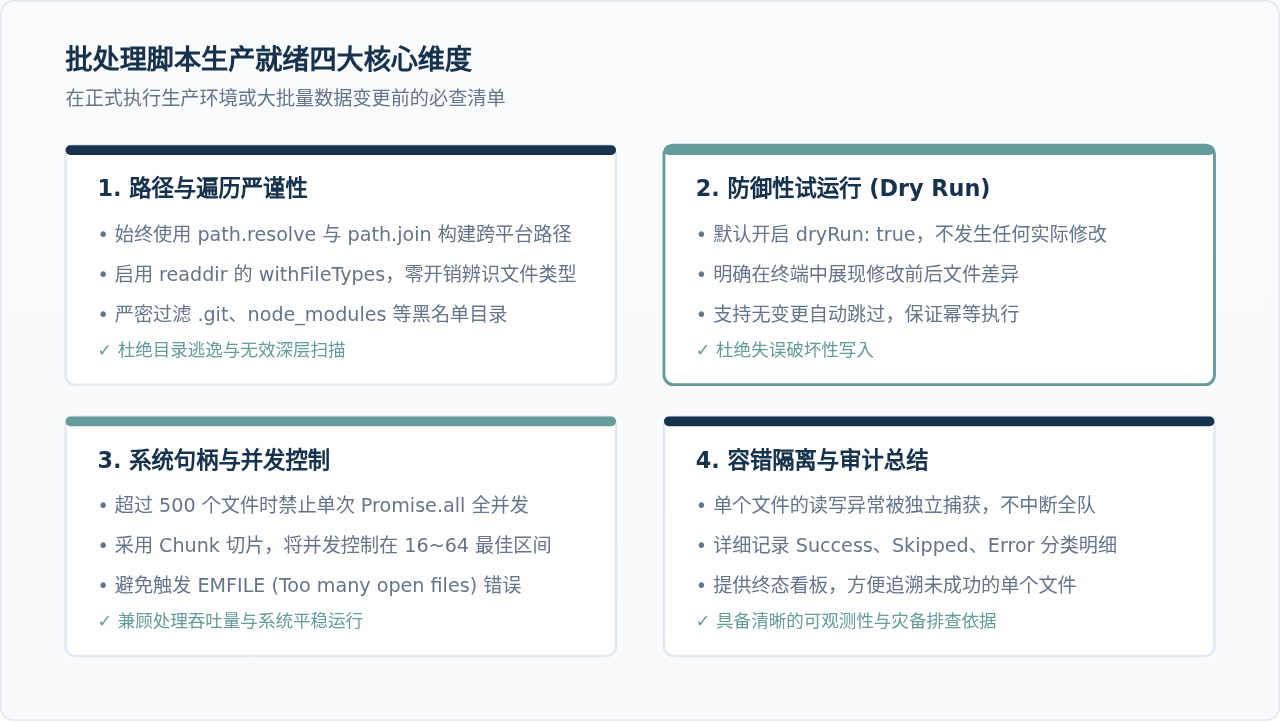
通过遵循上述流程与架构模式,你可以根据实际业务场景灵活扩展转换规则(例如针对 JSON 文件修改配置键值、针对 Markdown 文档清洗图片外链、提取文件修改时间重置归档目录等)。这种基于 Node.js 现代异步特性的轻量级脚本,不仅执行高效,更具备坚实的稳定性和可维护性。
Node.js 安装配置与第一个 HTTP 服务器编写
2026-11-05 11:41:40
怎么使用 nvm 管理并平滑升级 Node.js 版本
2026-11-04 23:15:07
Node.js 怎么使用 zlib 模块解压 gzip 和 deflate
2026-11-03 23:40:50
直接覆盖安装还是用版本管理器?Node.js 升级方式对比
2026-11-03 22:59:07
Express.js 是什么:Node.js Web 框架核心概念与适用场景
2026-11-03 20:00:12







