JS大体积XML文件流式解析避免内存溢出
在JavaScript和Node.js环境下处理大体积XML文件时,DOM树解析极易引发V8堆内存溢出。本文详细讲解基于ReadableStream与SAX事件驱动的流式解析原理,提供完整的按条提取、背压控制、异步消费与内存监控实操方案。
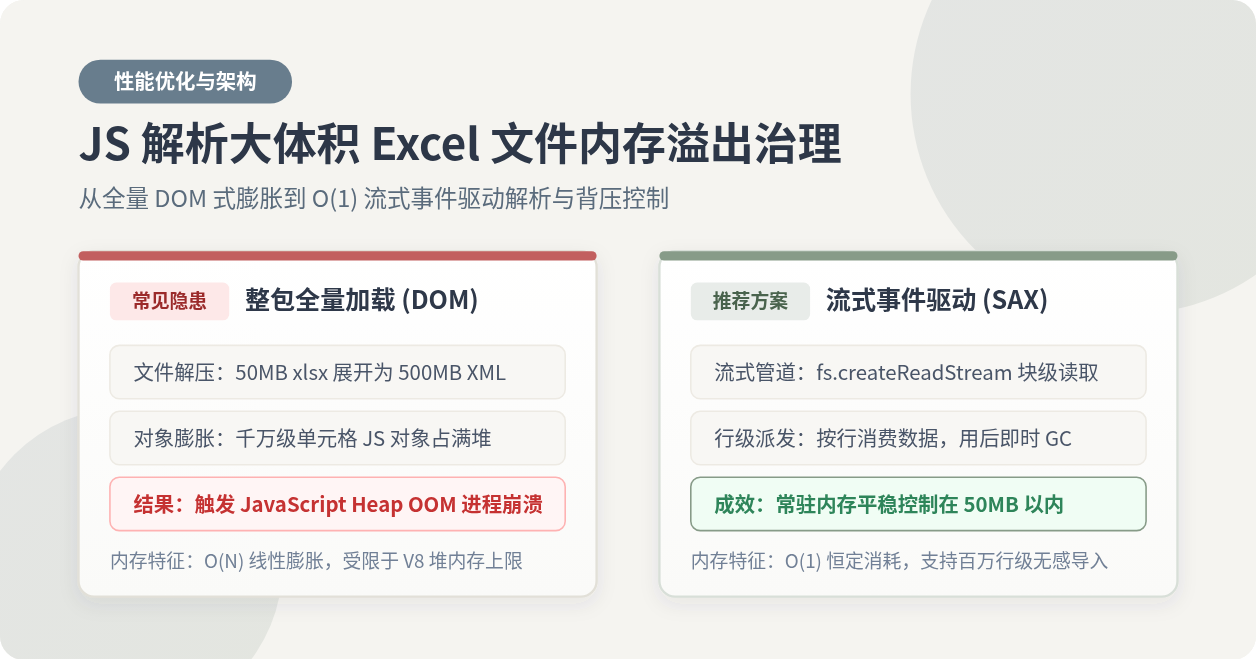
全量加载 DOM 树的崩溃根源
在日常开发中,许多开发者习惯使用 fs.readFileSync 读取整个文件,再通过 DOMParser 或全量 JSON 转换工具将 XML 转换为 JavaScript 对象树。对于几十千字节或几兆字节的 XML 配置文件,这种方式简单直接。但当文件体积达到数百兆(如大型数据库导出、日志流水或电商目录文件)时,这种写法会立刻使服务陷入瘫痪。
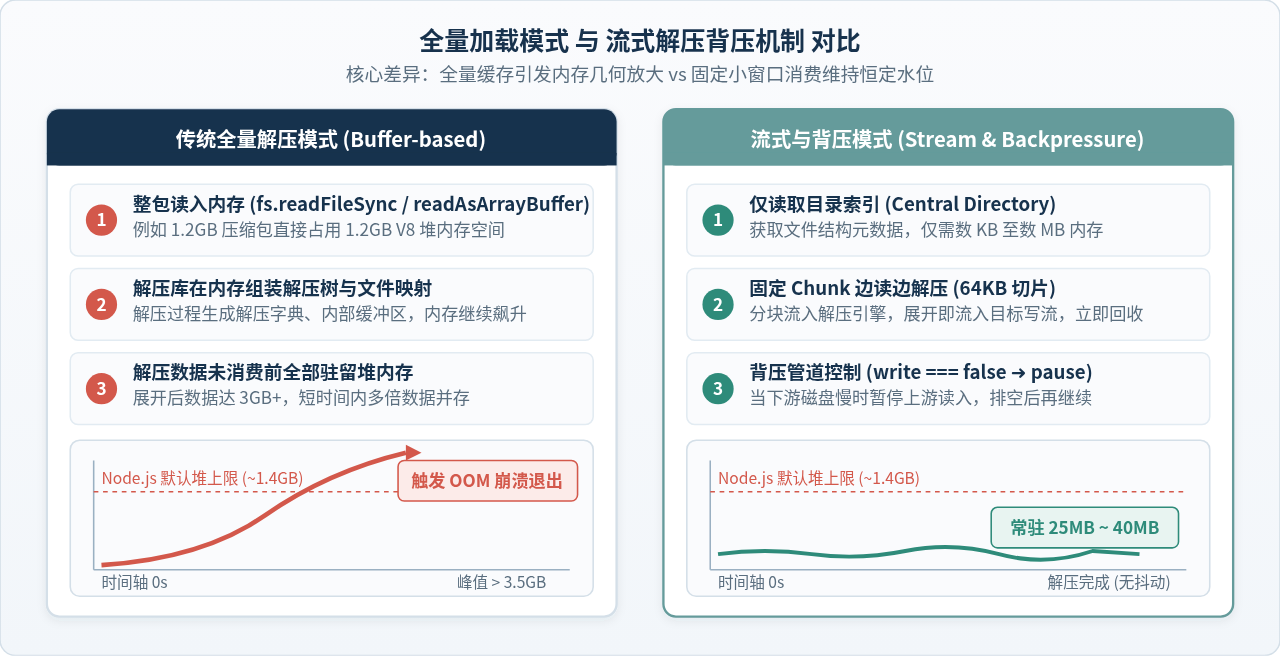
造成崩溃的核心原因在于 DOM 树的数据膨胀效应。XML 文本在转为内存对象时,不仅要保存字符内容,还要为每一个标签创建包含父子引用、属性字典、兄弟节点指针的复杂数据结构。一个 500MB 的 XML 文本,在内存中生成的 DOM 对象树通常需要消耗 2.5GB 到 5GB 的内存空间。
在 64 位操作系统中,V8 引擎默认的堆内存限制通常在 1.4GB 至 4GB 之间。一旦堆内存分配触及上限,垃圾回收器(GC)将频繁发起全量暂停(Stop-The-World),CPU 占用飙升至 100%,随后进程直接被操作系统终止,抛出 FATAL ERROR: Ineffective mark-compacts near heap limit Allocation failed - JavaScript heap out of memory。
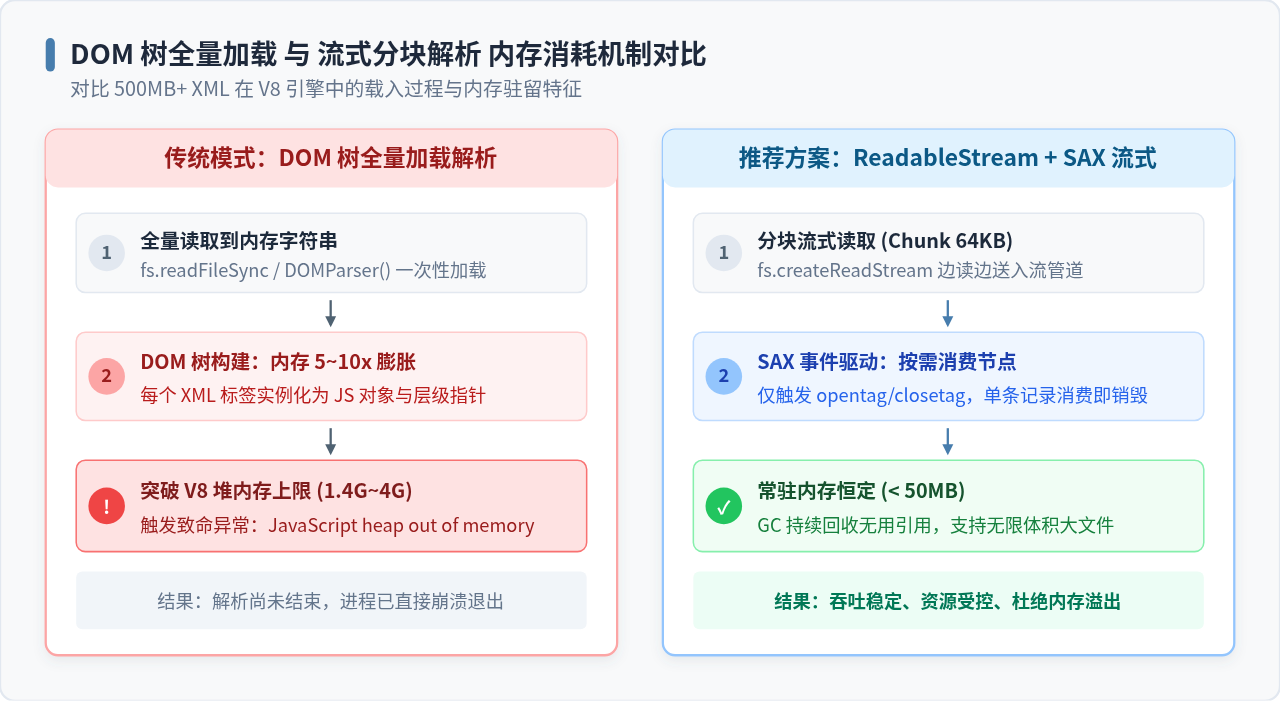
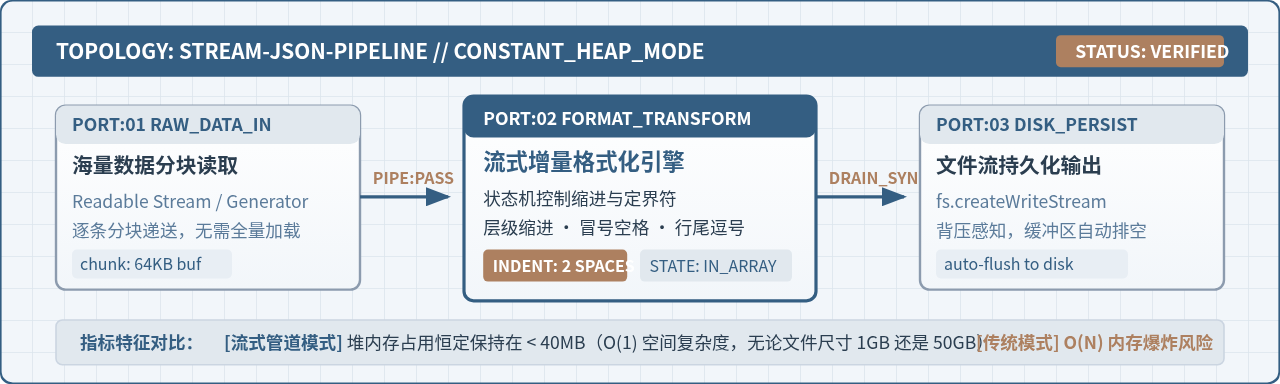
从图 1 可以看出,流式解析不再要求将全部数据一次性读入。它将大文件切分成固定大小(如 64KB)的数据块(Chunk),以事件通知的方式边解析、边消费、边释放。无论原始文件是 1GB 还是 100GB,进程的常驻内存(RSS)都可以稳定在一条平直的水平线上。
流式解析器(SAX)的运行机制与选型
流式解析大体积 XML 最主流的模型是 SAX(Simple API for XML)。不同于在内存中构建完整树状结构的 DOM 模式,SAX 是纯粹基于有限状态机(FSM)的单向事件流。
SAX 解析器逐字节扫描数据流。每当识别出特定语法片段,便向外部发布对应的轻量事件:
opentag:扫描到开始标签(如<record id="1001">),携带标签名及其属性对象。ontext:扫描到标签内的文本字符。需要注意,当文本跨越两个 Chunk 时,该事件会分段多次触发。closetag:扫描到闭合标签(如</record>),标志当前节点的结束。onerror:流中出现不合法 XML 语法时触发。onend:整个数据流读取完毕。
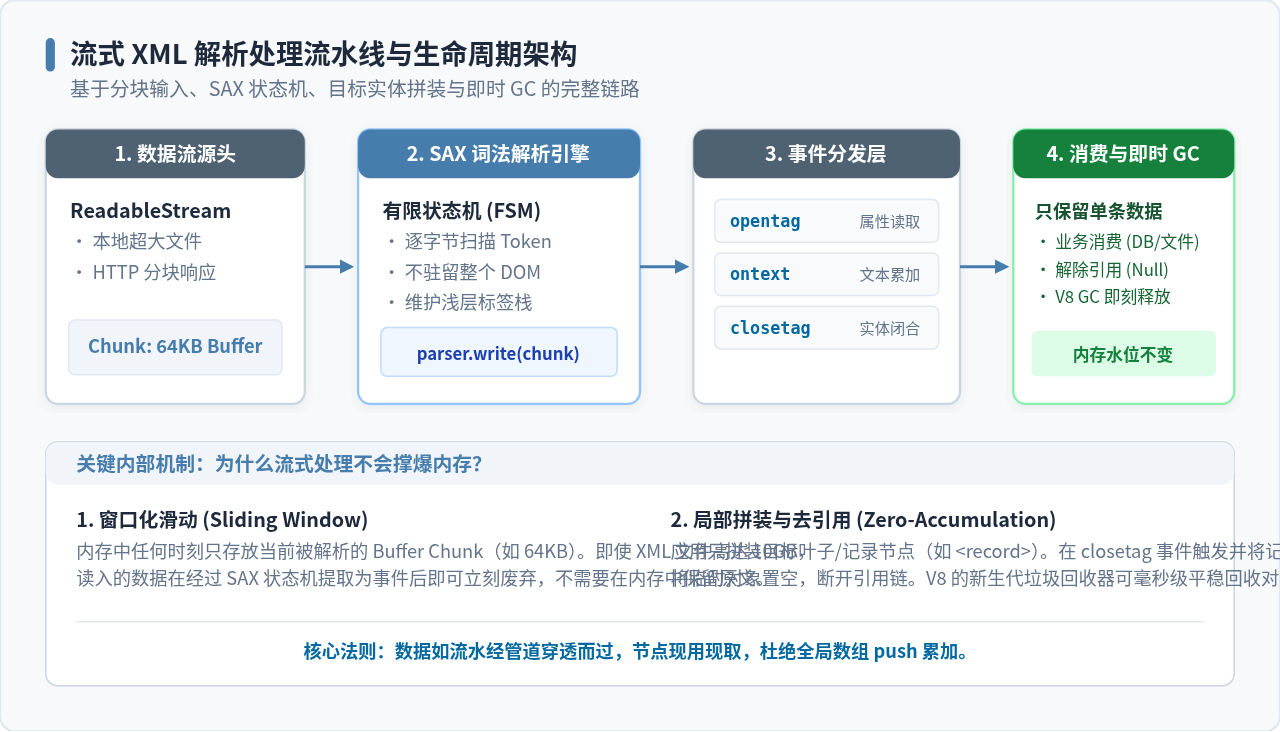
常用 JavaScript 流式 XML 解析库对比
在 Node.js 生态中,有几个常用库可供选择:
| 库名称 | 底层机制 | 内存占用表现 | 适用场景与评价 |
|---|---|---|---|
| sax-js | 纯 JavaScript 状态机 | 极低(< 30MB) | 兼容性最好,无原生 C++ 编译依赖,支持严格模式,Node.js 与浏览器双端可用。推荐首选。 |
| node-expat | C++ libexpat 绑定 | 极低,吞吐极高 | 解析速度比纯 JS 快 2~3 倍,但需要 node-gyp 本地编译,跨平台容器部署成本稍高。 |
| fast-xml-parser | 流模式 (FXP Stream) | 中低(依赖配置) | 支持直接映射为 JSON,但需谨慎配置标签栈,避免无意间在内存缓存大对象。 |
Node.js 实战:管道构建与按条提取记录
下面演示如何使用 Node.js 原生 fs.createReadStream 与 sax 库,从一个包含数十万条 <item> 的大文件中按条提取结构化数据,并保证堆内存平稳。
假设 XML 结构如下:
<?xml version="1.0" encoding="UTF-8"?>
<catalog>
  <metadata>...</metadata>
  <items>
    <item id="1">
      <title>高性能流式计算</title>
      <price>89.00</price>
    </item>
    <!-- 此处存在数百万个 item -->
  </items>
</catalog>
完整实现脚本如下。代码中只在进入目标 <item> 标签时分配临时对象,一旦闭合便交由下游处理并解除引用:
const fs = require('fs');
const sax = require('sax');

// 创建严格模式的 SAX 流
const strict = true;
const parserStream = sax.createStream(strict, {
  trim: true,
  normalize: true
});

let currentItem = null;
let currentField = null;
let textBuffer = '';
let totalCount = 0;

// 1. 遇到开始标签
parserStream.on('opentag', (node) => {
  if (node.name === 'item') {
    // 开始组装单个业务对象
    currentItem = {
      id: node.attributes.id,
      title: '',
      price: 0
    };
  } else if (currentItem) {
    // 记录 item 内部的子字段名称,并清空文本暂存区
    currentField = node.name;
    textBuffer = '';
  }
});

// 2. 遇到文本节点(重点:分段拼接,防止跨 chunk 截断)
parserStream.on('text', (text) => {
  if (currentItem && currentField) {
    textBuffer += text;
  }
});

// 3. 遇到闭合标签
parserStream.on('closetag', (tagName) => {
  if (tagName === 'item') {
    totalCount++;
    // 同步消费:写入文件或本地处理
    consumeRecord(currentItem);

    // 核心:断开引用,释放内存交由 GC 回收
    currentItem = null;
    currentField = null;
    textBuffer = '';
  } else if (currentItem && currentField === tagName) {
    // 将累积好的文本填入目标字段
    if (tagName === 'price') {
      currentItem.price = parseFloat(textBuffer) || 0;
    } else {
      currentItem[tagName] = textBuffer;
    }
    currentField = null;
    textBuffer = '';
  }
});

parserStream.on('error', (err) => {
  console.error('XML 解析错误:', err);
});

parserStream.on('end', () => {
  console.log(`解析完成,累计提取 ${totalCount} 条记录`);
});

// 创建 64KB 分块文件输入流并通过 pipe 输送给 SAX
const fileStream = fs.createReadStream('./large_data.xml', {
  highWaterMark: 64 * 1024
});
fileStream.pipe(parserStream);

function consumeRecord(record) {
  // 业务处理逻辑:避免将其 push 到全局长数组
  if (totalCount % 50000 === 0) {
    const mem = process.memoryUsage();
    console.log(`已处理: ${totalCount}, 堆已用: ${(mem.heapUsed / 1024 / 1024).toFixed(2)} MB`);
  }
}
关键进阶:异步消费与背压(Backpressure)流控
在很多实际生产场景中,消费一条 XML 记录往往涉及异步操作,例如批量插入数据库(MySQL/MongoDB)或调用远程接口。
如果上游磁盘读取速度为 80MB/s,而下游数据库并发插入速度仅为 5MB/s,解析器会极速抛出成千上万个未完成的 Promise。这些悬挂任务和未销毁的对象将全部堆积在 Node.js 事件循环的微任务队列中,直接导致内存溢出。
解决该问题的机制是背压控制(Backpressure):当下游缓冲区达到阈值时,显式暂停(pause())上游文件流读取;等待异步批量操作提交完毕后,再显式恢复(resume())读取。
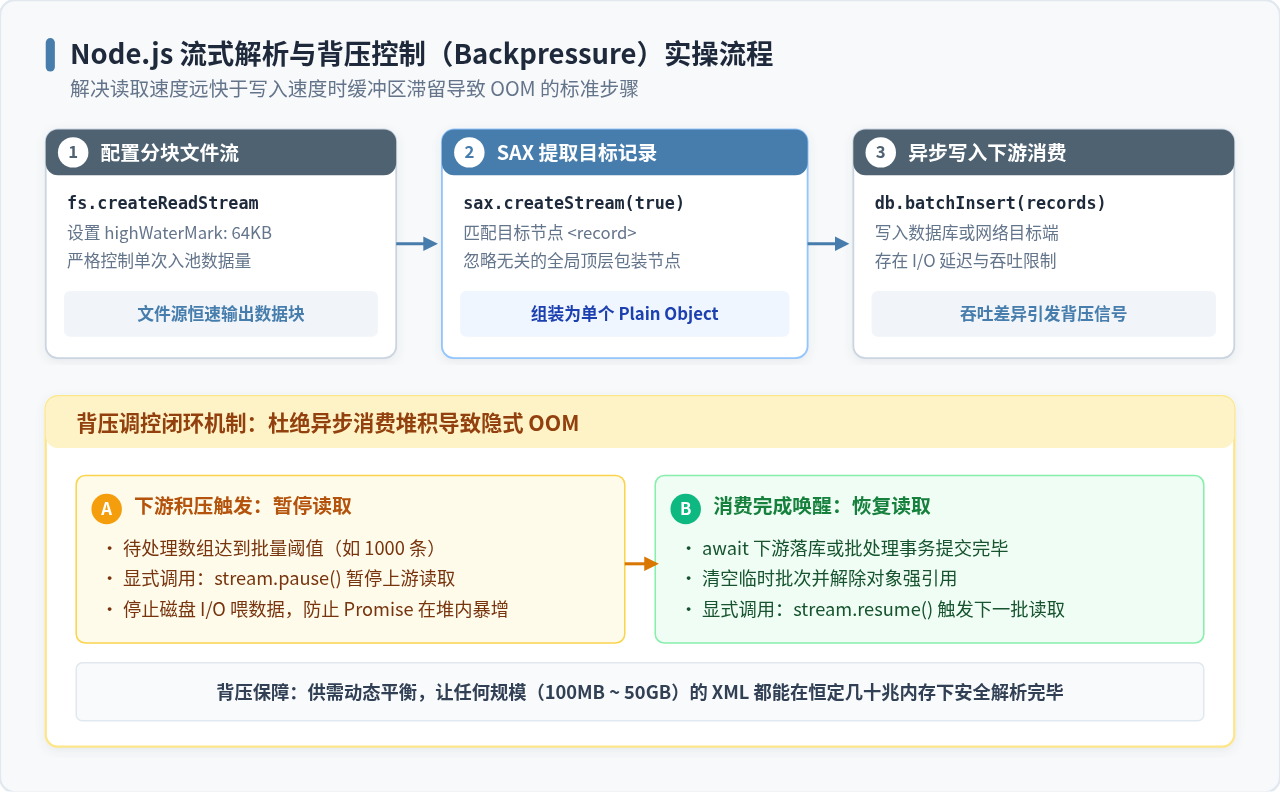
下面是配合背压机制的批处理消费代码:
const BATCH_SIZE = 1000;
let batchBuffer = [];
let isFlushing = false;

parserStream.on('closetag', async (tagName) => {
  if (tagName === 'item') {
    batchBuffer.push(currentItem);
    currentItem = null;

    // 当批次达到容量上限且没有正在落库时
    if (batchBuffer.length >= BATCH_SIZE && !isFlushing) {
      isFlushing = true;
      // 1. 触发背压:立即暂停文件流
      fileStream.pause();

      const toSave = batchBuffer;
      batchBuffer = [];

      try {
        // 2. 等待下游异步写入完成
        await db.bulkInsert(toSave);
      } finally {
        isFlushing = false;
        // 3. 消费完成,接触背压:恢复文件流读取
        fileStream.resume();
      }
    }
  }
});
浏览器端:Web Streams 与分块 SAX 结合
在现代前端浏览器环境中,当用户通过 <input type="file"> 上传或使用 fetch() 下载数以百兆的 XML 数据时,同样不能使用 response.text() 一次性读取。
现代浏览器支持 Web Streams API,可以通过分块读取 ReadableStream,并将其逐块喂给 SAX 解析器:
async function parseLargeXmlFromNetwork(url) {
  const response = await fetch(url);
  const reader = response.body.getReader();
  const decoder = new TextDecoder('utf-8');

  // 初始化 SAX parser
  const parser = sax.parser(true);
  parser.onopentag = (node) => { /* 提取逻辑 */ };
  parser.onclosetag = (name) => { /* 处理逻辑 */ };

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;

    // 将二进制分块转为字符分片,喂入解析器
    const chunkText = decoder.decode(value, { stream: true });
    parser.write(chunkText);
  }

  parser.close();
}
排查清单与避坑指南
为了保证流式解析服务在生产环境中高可用、零泄漏,需重点核查以下四个核心维度:
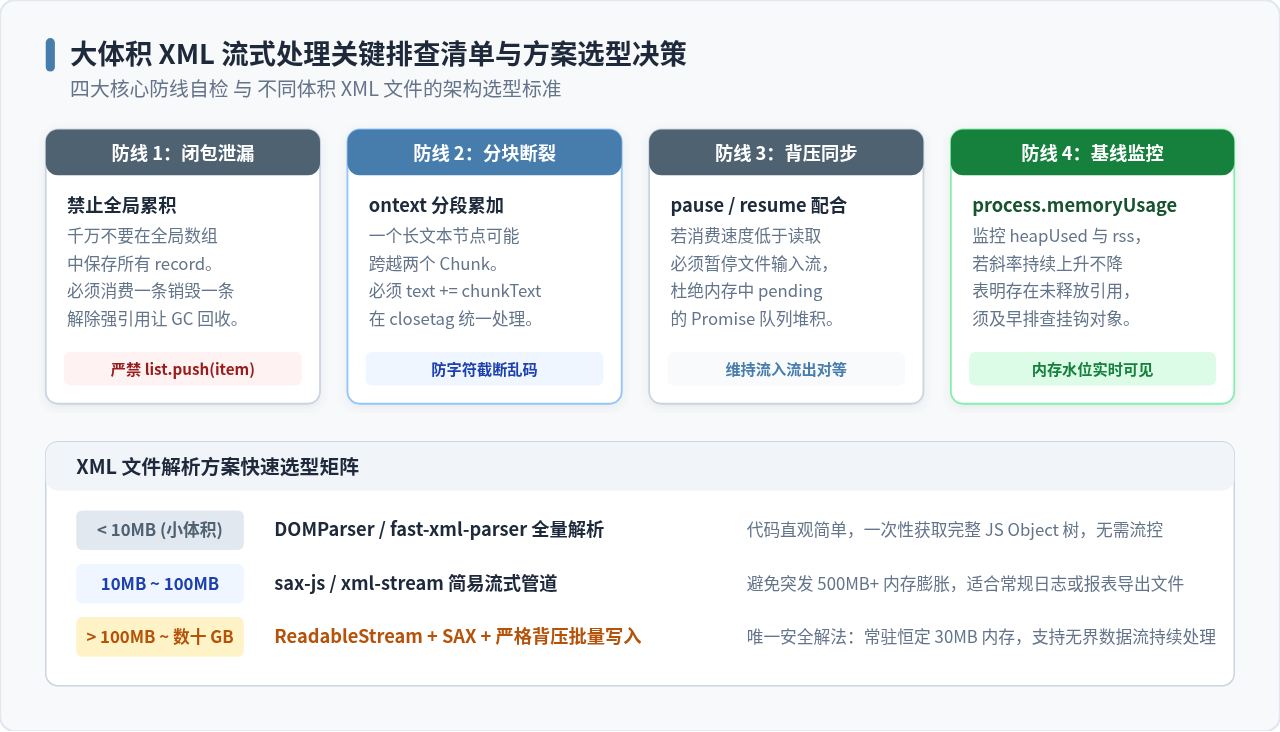
-
排查闭包引用泄漏:绝对不能在解析器外层声明全局列表(如
const all = [])并将每个item都push进去。流式解析的优势在于边走边抛,一旦保存了全量引用,依然会导致 OOM。 -
防范文本分片截断:流的 Chunk 是按固定字节(如 64KB)分割的,这意味着中文字符或标签内的文本可能正好被切在一半。在 SAX 的
ontext回调中必须使用字符串累加(buffer += text),必须且只能在匹配到当前字段的closetag时,才能取用完整的文本结果。 -
确保异常时销毁流:若在处理某条记录时抛出异常,务必调用
fileStream.destroy()终止读取,并关闭数据库事务连接,防止句柄悬挂。 -
建立内存监控基线:在处理过程中定时打印
process.memoryUsage().heapUsed。健康流式处理的堆内存曲线应当呈现类似锯齿状(分配后随 Minor GC 快速回落),如果呈单调递增态势,说明代码中存在对象未解除强引用。
JSONP与CORS对比:为什么现代Web开发不再推荐JSONP
2026-11-21 12:40:42
JavaScript动态生成缩略图列表的DOM操作方法
2026-11-20 22:57:25
为什么 JavaScript 无法直接关闭浏览器开发者工具面板?
2026-11-20 22:45:58
JavaScript幻灯片切换闪烁或白屏怎么解决
2026-11-20 21:51:52
JS刷新父页面报错Permission denied怎么解决
2026-11-20 14:07:12