

解决JavaScript加密中文字符串出现乱码的问题
深入剖析JavaScript在对包含中文的字符串进行加密时产生乱码的根本机制,提供基于原生Web Crypto API和CryptoJS的标准解决方案、代码范例与排查对齐指南。
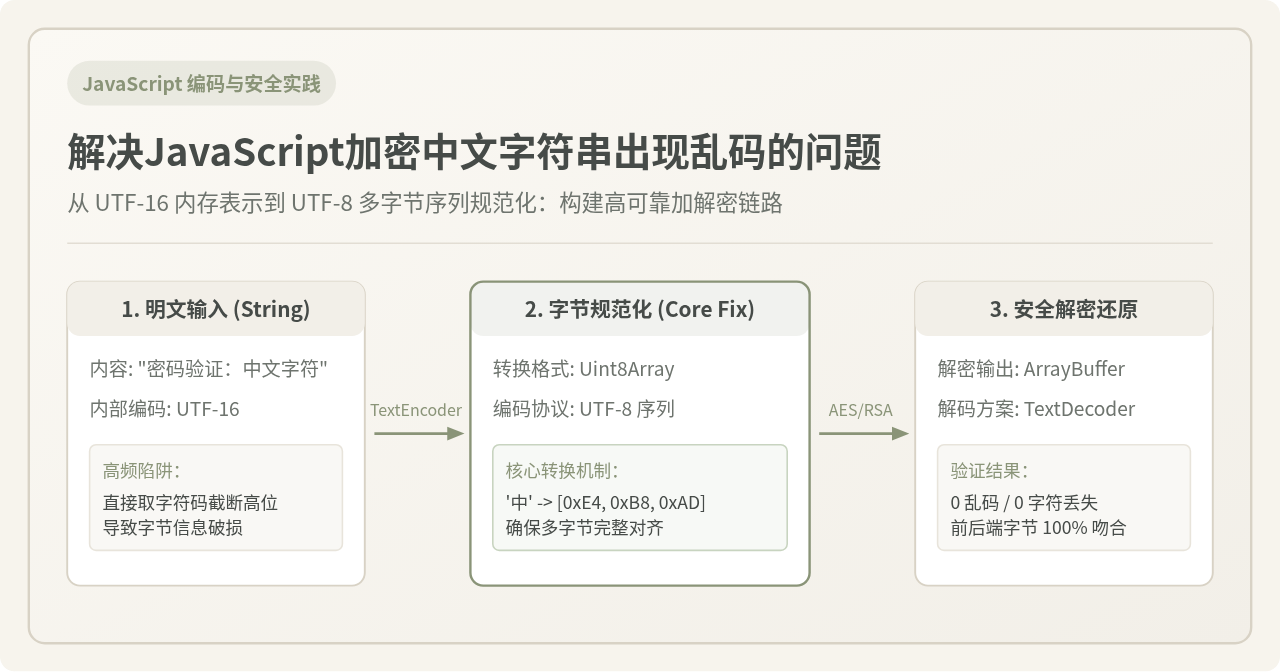
TextEncoder(或加密库对应的 UTF-8 解析器)将中文字符串转为标准的 UTF-8 字节数组,解密后再通过 TextDecoder 将二进制字节数组还原为中文字符串。本文将针对这一核心问题,说明乱码产生的底层机制、不同主流工具的修复代码以及前后端对接排查对齐的完整步骤。
一、乱码产生的底层机制:为什么加密算法“不认识”中文?
在排查加密乱码时,首先需要区分“字符”与“字节”。现代加密算法(如 AES、DES、RSA)属于数学运算模型,它们在设计上只接收固定长度的二进制比特块或字节流(例如 16 字节的明文分组),并不感知上层自然语言是 ASCII 英文还是多语言汉字。
JavaScript 引擎在内存中以 UTF-16 编码存储字符串。对于 ASCII 范围内的英文字母(如 'A',码点 65),它只占用一个低 8 位字节;而常用中文字符(如 '中',码点 0x4E2D,十进制 20013)在 UTF-16 中占用 2 个字节,在 UTF-8 编码下则会被序列化为 3 个连续字节:0xE4、0xB8、0xAD。
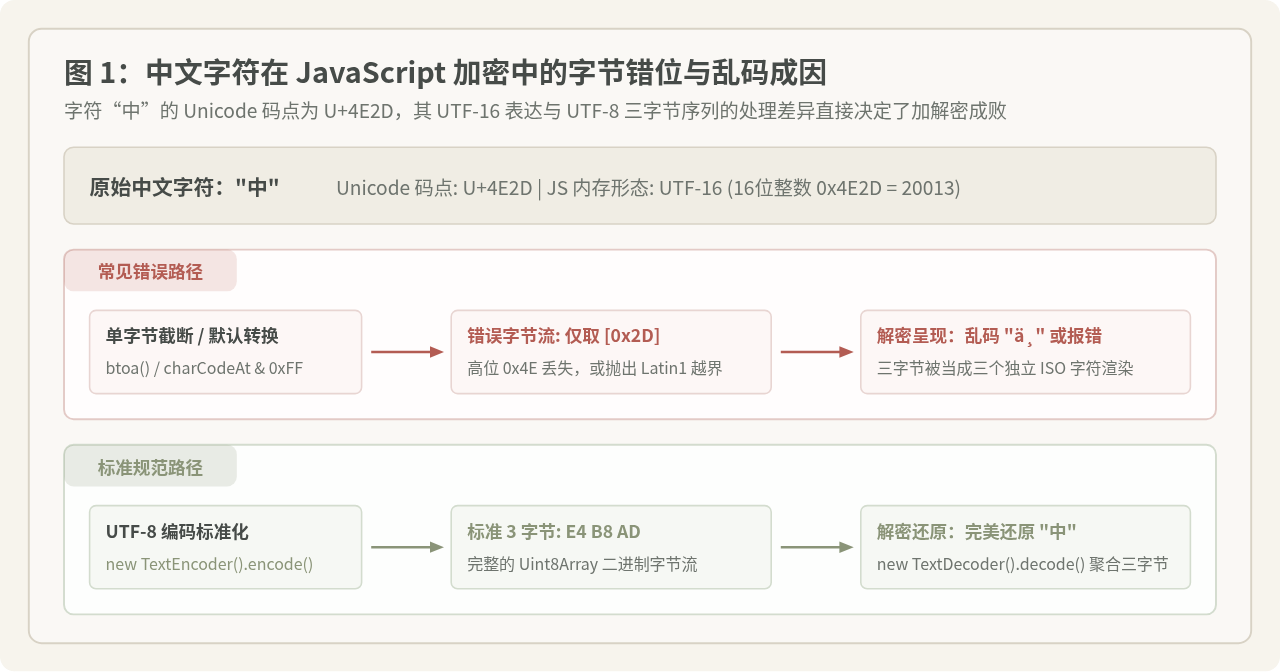
当开发者直接将含有中文的 JavaScript 字符串交给某些加密函数或原生工具(如 window.btoa())时,系统默认假设每个字符的码点都在 0x00 ~ 0xFF(即 Latin1 单字节范围)之内:
- 报错崩溃场景:
btoa("中文")会直接抛出DOMException: Failed to execute 'btoa' on 'Window': The string to be encoded contains characters outside of the Latin1 range.。 - 字节截断乱码场景:部分旧式加密库在获取字节时,内部简单执行
str.charCodeAt(i) & 0xFF,强行丢弃了高位字节(例如0x4E2D丢弃高位0x4E,仅剩0x2D)。此时密文所加密的内容本身已经损坏,解密端无论如何也无法复原。 - 解码分裂乱码场景:中文字符已按 UTF-8 正确加密成 3 字节,但解密端没有使用 UTF-8 解码器,而是使用类似
String.fromCharCode逐个字节读取,导致0xE4 0xB8 0xAD被渲染成三个独立的西文字符ä¸(即典型的 Mojibake 乱码)。
二、容易混淆的常见说法与历史方案辨析
在解决该问题时,技术交流中经常出现两类看似合理但不够准确的说法,需要根据现代标准进行明确区分:
为什么看似合理:初学者直接把中文字符串传给加密函数时,往往报错或解密出乱码,更换某些包含自动转码特性的封装库后现象消失,容易得出算法不支持中文的推论。
成立条件与修正:算法数学本身完全独立于人类语言。无论 AES 还是 RSA,处理的都是纯净的二进制 Uint8Array 或 ArrayBuffer。只要在调用算法前将字符串编码为标准字节流,任何通用加密算法都能完美支持中文,不需要也不应该为了支持中文而更换加密算法。
为什么看似合理:在浏览器缺乏现代编码 API 的时期,开发者常用 btoa(unescape(encodeURIComponent(str))) 来规避 btoa 的报错。这是因为 encodeURIComponent 先将中文转为百分号形式(如 %E4%B8%AD),unescape 再将其转成单字节字符,从而安全通过 btoa。
成立条件与修正:该方案仅适用于纯纯的前端 Base64 编解码闭环,或者两端约定了非标准的 URI 字符映射。一旦与 Java、Go、Python 或 C# 后端标准加解密对接,这种做法会引入多余的字符开销与转义偏差。现代工程应优先使用标准的 TextEncoder 与 TextDecoder,直接输出合规的二进制字节数组。
三、标准解决流程:原生 Web Crypto API 实现
在现代浏览器与 Node.js 16+ 环境中,推荐直接使用 W3C 标准的 Web Crypto API。该规范要求所有加解密数据必须使用 BufferSource(如 Uint8Array),从接口层面杜绝了字符编码的不确定性。
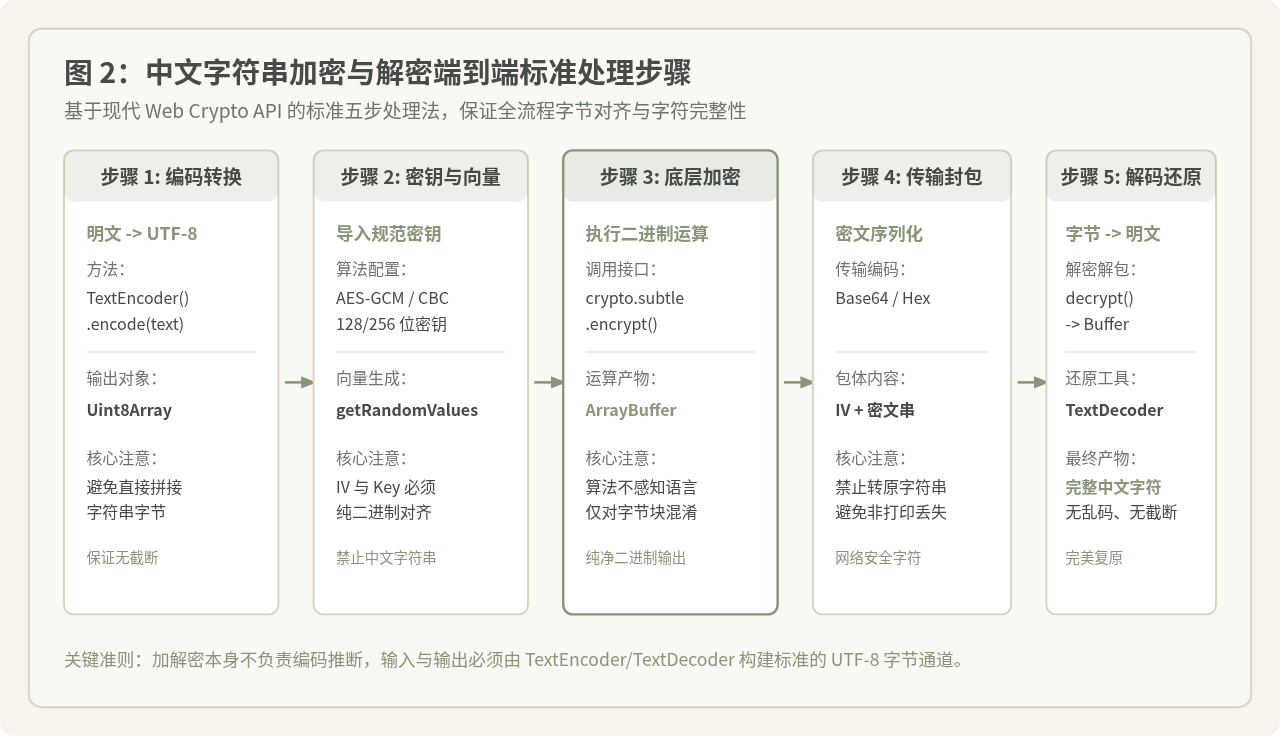
1. 端到端实现代码(AES-GCM)
以下为完整的端到端中文字符串加密与解密实现,包含明文编码、向量生成、密文序列化以及逆向解码还原:
// 步骤 1:明文字符串转 UTF-8 字节流
function stringToUtf8Bytes(str) {
  const encoder = new TextEncoder();
  return encoder.encode(str); // 返回 Uint8Array
}

// 步骤 5 对应函数:UTF-8 字节流还原中文字符串
function utf8BytesToString(buffer) {
  const decoder = new TextDecoder("utf-8");
  return decoder.decode(buffer);
}

// 辅助工具:Uint8Array 与 Base64 互转(安全传输格式)
function bufferToBase64(buffer) {
  const bytes = new Uint8Array(buffer);
  let binary = "";
  for (let i = 0; i < bytes.byteLength; i++) {
    binary += String.fromCharCode(bytes[i]);
  }
  return window.btoa(binary);
}

function base64ToBuffer(base64) {
  const binary = window.atob(base64);
  const bytes = new Uint8Array(binary.length);
  for (let i = 0; i < binary.length; i++) {
    bytes[i] = binary.charCodeAt(i);
  }
  return bytes.buffer;
}

// 核心流程:加密函数
async function encryptChineseText(plainText, rawKeyBytes) {
  // 1. 将中文明文统一转为 UTF-8 Uint8Array
  const encodedData = stringToUtf8Bytes(plainText);

  // 2. 导入对称密钥(此处以 256 位 AES-GCM 为例)
  const cryptoKey = await crypto.subtle.importKey(
    "raw",
    rawKeyBytes,
    { name: "AES-GCM" },
    false,
    ["encrypt"]
  );

  // 3. 生成 12 字节的随机初始化向量 (IV)
  const iv = crypto.getRandomValues(new Uint8Array(12));

  // 4. 执行加密运算
  const cipherBuffer = await crypto.subtle.encrypt(
    { name: "AES-GCM", iv: iv },
    cryptoKey,
    encodedData
  );

  // 5. 组合 IV 与密文并导出为 Base64 字符串用于传输
  return {
    iv: bufferToBase64(iv),
    cipherText: bufferToBase64(cipherBuffer)
  };
}

// 核心流程:解密函数
async function decryptChineseText(cipherObj, rawKeyBytes) {
  const iv = new Uint8Array(base64ToBuffer(cipherObj.iv));
  const cipherData = base64ToBuffer(cipherObj.cipherText);

  const cryptoKey = await crypto.subtle.importKey(
    "raw",
    rawKeyBytes,
    { name: "AES-GCM" },
    false,
    ["decrypt"]
  );

  // 1. 解密得到原始明文字节流 ArrayBuffer
  const decryptedBuffer = await crypto.subtle.decrypt(
    { name: "AES-GCM", iv: iv },
    cryptoKey,
    cipherData
  );

  // 2. 将 UTF-8 字节流准确解码为中文字符串
  return utf8BytesToString(decryptedBuffer);
}
在上述代码中,stringToUtf8Bytes 与 utf8BytesToString 构成了防乱码的核心屏障。加密前通过 new TextEncoder().encode() 输出的 Uint8Array 保证了每个汉字对应合法的 3 字节序列;解密后通过 new TextDecoder().decode() 将字节序列一次性组装回 UTF-16 字符,避免了中间过程任何单字节丢弃。
四、主流第三方库的适配方案与代码示例
在很多现有项目中,可能依然广泛使用 CryptoJS 或针对 RSA 的 JSEncrypt。了解这些库内部的中文转换接口同样重要。
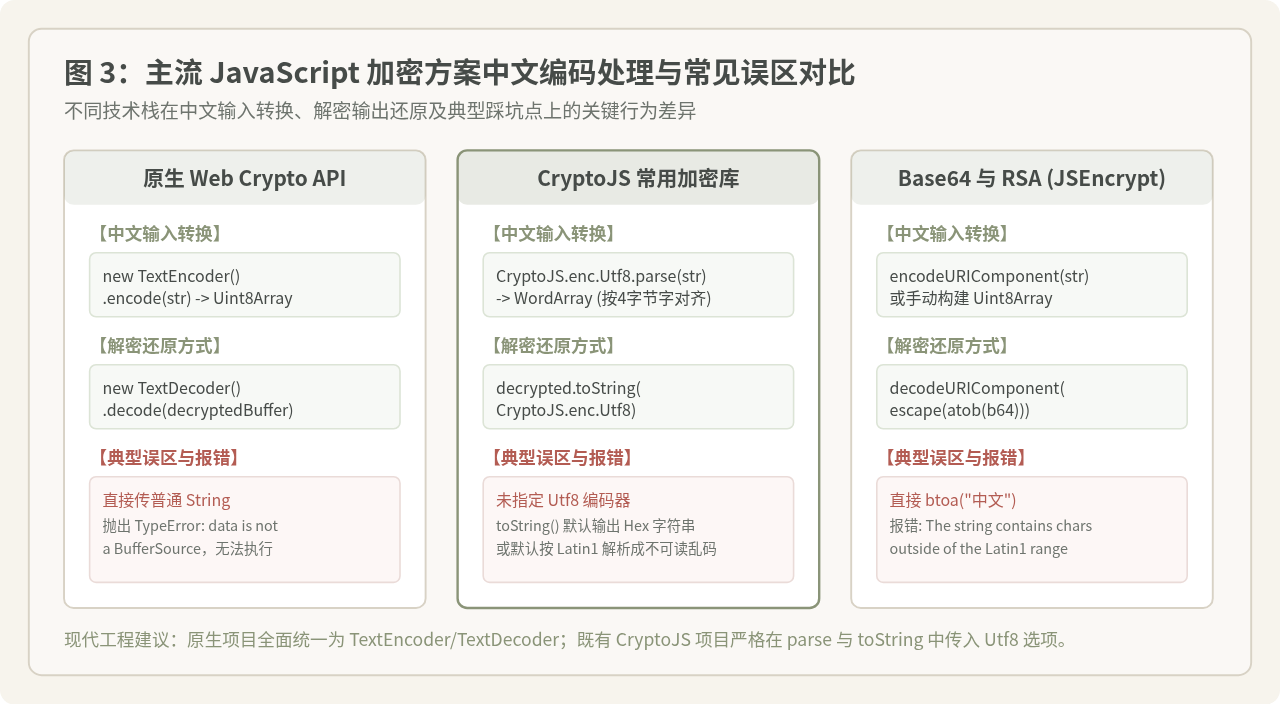
1. CryptoJS 中的正确用法
CryptoJS 内部使用专有的 WordArray 数据结构(32 位整数数组)。直接传入 JavaScript 字符串时,CryptoJS 的某些函数可能默认使用 Latin1 编码进行解析,导致中文字符高位被直接截断。
正确的做法是显式调用 CryptoJS.enc.Utf8.parse() 与 toString(CryptoJS.enc.Utf8):
// 需提前引入 crypto-js 库
// 1. 准备明文与密钥
const message = "用户隐私数据:北京市海淀区";
const secretKeyString = "16ByteSecretKey!"; // 16 字节密钥

// 2. 关键步骤:显式将中文字符串以 UTF-8 解析为 WordArray
const utf8Plaintext = CryptoJS.enc.Utf8.parse(message);
const utf8Key = CryptoJS.enc.Utf8.parse(secretKeyString);
const iv = CryptoJS.lib.WordArray.random(16); // 16 字节随机 IV

// 3. 加密操作(AES-CBC 模式,PKCS7 填充)
const encrypted = CryptoJS.AES.encrypt(utf8Plaintext, utf8Key, {
  iv: iv,
  mode: CryptoJS.mode.CBC,
  padding: CryptoJS.pad.Pkcs7
});

// 密文输出(Base64 格式字符串)
const cipherBase64 = encrypted.toString();
const ivBase64 = CryptoJS.enc.Base64.stringify(iv);

// 4. 解密操作
const decryptedCipher = CryptoJS.AES.decrypt(cipherBase64, utf8Key, {
  iv: CryptoJS.enc.Base64.parse(ivBase64),
  mode: CryptoJS.mode.CBC,
  padding: CryptoJS.pad.Pkcs7
});

// 5. 关键步骤:解密结果必须传入 CryptoJS.enc.Utf8 转换为字符串
// 若写成 decryptedCipher.toString(),默认返回十六进制字符串 Hex,而非明文
const originalText = decryptedCipher.toString(CryptoJS.enc.Utf8);

console.log("解密还原结果:", originalText); // 正常输出原中文
2. RSA(JSEncrypt)与长中文处理
使用 JSEncrypt 进行公钥加密时,中文字符串如果过长,不仅容易出现乱码,还会触发 Message too long for RSA 异常。
- RSA-1024 配合 PKCS1Padding 填充时,单次最大加密明文长度为
128 - 11 = 117个字节; - 一个英文字符占用 1 字节,而一个汉字占用 3 字节。因此 117 个字节只能容纳约 39 个汉字;
- 如果在加密中文前未计算真实字节长度,而仅按
str.length计算字符数,就会在超过字节上限时损坏密文并抛出解码错误。遇到长中文字符串时,应采用“AES 对称加密中文正文 + RSA 加密 AES 密钥”的混合加密架构。
五、前后端对接时的乱码排查与对齐清单
当 JavaScript 前端与 Java、Python、Go 等后端系统进行加密通信时,出现乱码往往不是单侧代码写错,而是两端约定存在微小偏差。遇到问题时,可对照以下四步清单进行结构化定位:
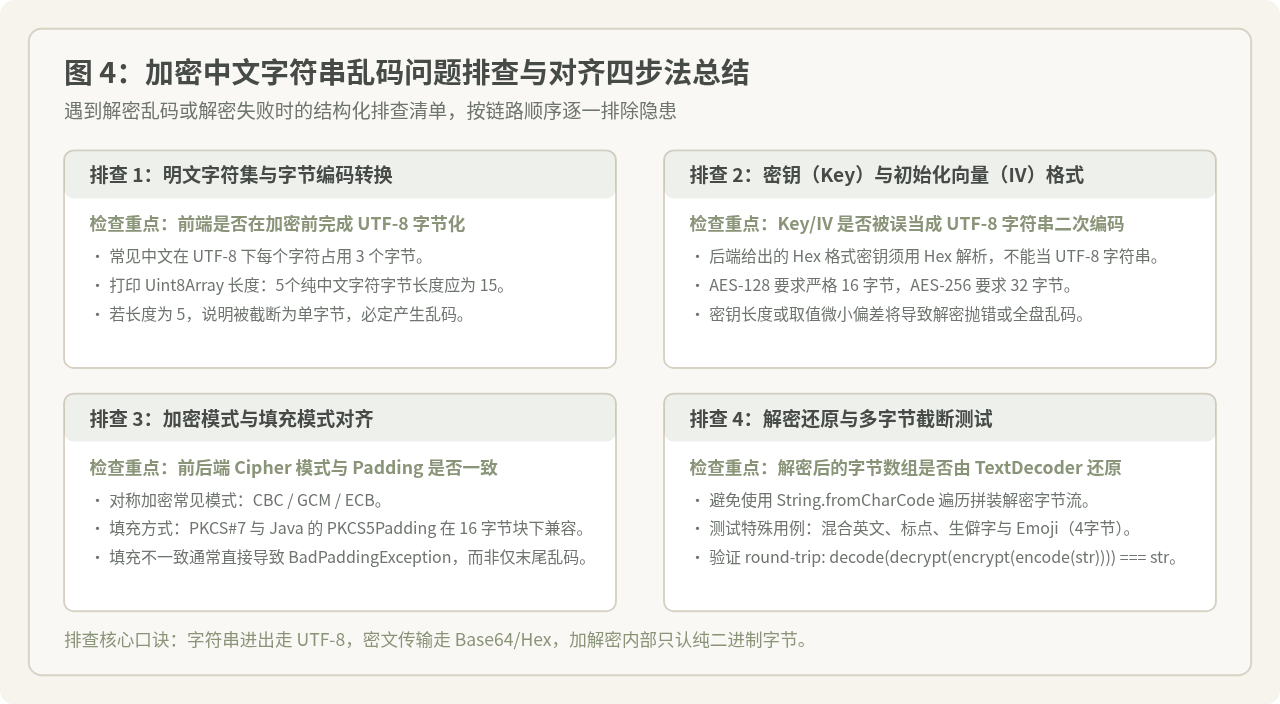
| 检查阶段 | 前端(JavaScript)重点核对项 | 后端(Java/Python/Go)重点核对项 | 不一致导致的故障表现 |
|---|---|---|---|
| 1. 明文编码 | 是否通过 TextEncoder 转为 UTF-8 字节流 |
解密后是否使用 StandardCharsets.UTF_8 读取字符串 |
中文显示为 ä¸æ–‡(西文乱码)或 ??? |
| 2. 密钥格式 | Hex/Base64 是否已准确解析为原始二进制字节 | key.getBytes(StandardCharsets.UTF_8) 与直接 Hex 解码是否混淆 |
解密直接抛出签名失败或 InvalidKeyException |
| 3. 算法模式与填充 | 确认是 CBC 还是 GCM,是否配置了 PKCS7 填充 | 确认使用 AES/CBC/PKCS5Padding(与 PKCS7 兼容) |
解密抛出 BadPaddingException(解密块损坏) |
| 4. 密文传输协议 | Base64 或 Hex 串,禁止直接传输未序列化二进制 | 传输层反序列化是否保持字节一致无字符截断 | 密文长度异常或 Base64 解码抛出非法字符异常 |
六、验证修复效果与边界场景测试
确认问题是否真正解决,不能只使用单个“测试”汉字验证,而应覆盖边界测试用例:
1. 边界用例清单
- 中文与 ASCII 混排:如
"Order#2026_订单状态:已支付_¥99.8",检验不同字节长度混合时的排版准确性。 - 生僻字与多字节 Unicode(4 字节):例如
"𪚥"(Unicode 码点U+2A6A5)以及 Emoji 表情(如"🔐🚀")。这类字符在 JavaScript 中由两个 UTF-16 代理对(Surrogate Pairs)组成,在 UTF-8 下占用 4 个字节,最能检验编码器是否完全合规。 - 空白字符与标点符号:全角空格(
2. 往返一致性自动化验证脚本
// 验证测试脚本:在浏览器 Console 中直接运行验证
async function runEncodingVerifySuite() {
  const testCases = [
    "普通中文字符串测试",
    "中英混合 Test with numbers 123456 and symbols !@#$%",
    "生僻字与Emoji边界测试:𪚥 𠮷 🔐 🚀",
    "全角符号与换行:
【重要提示】	金额:¥100.00;全角空格: 结束。"
  ];

  // 生成测试用的 256 位随机密钥
  const testKey = crypto.getRandomValues(new Uint8Array(32));
  let passCount = 0;

  for (let i = 0; i < testCases.length; i++) {
    const original = testCases[i];
    try {
      // 执行加密与解密
      const encryptedData = await encryptChineseText(original, testKey);
      const decrypted = await decryptChineseText(encryptedData, testKey);

      if (original === decrypted) {
        console.log(`[PASS] 用例 ${i + 1} 验证通过: 长度 ${original.length} 字符`);
        passCount++;
      } else {
        console.error(`[FAIL] 用例 ${i + 1} 不匹配:
期望: "${original}"
实际: "${decrypted}"`);
      }
    } catch (err) {
      console.error(`[ERROR] 用例 ${i + 1} 执行抛出异常:`, err);
    }
  }

  console.log(`验证完成: 共 ${testCases.length} 项,通过 ${passCount} 项。`);
}

// 运行测试
runEncodingVerifySuite();
当上述测试套件中所有包含 Emoji、生僻字与复杂排版的用例均输出 [PASS],且控制台打印的 Uint8Array 字节长度符合预期时,即可确认当前系统的 JavaScript 中文字符加密链路已完全消除了乱码隐患。
JS三元运算符与if-else的性能差异及选型建议
2026-11-21 11:59:51
Web前端开发除了JavaScript还需要掌握哪些技术?
2026-11-21 09:37:21
万级数据量下JS表格排序性能优化方案
2026-11-20 18:29:53
原生JS实现滚动加载:Intersection Observer API实战教程
2026-11-20 09:24:35
JS混淆真的能保护前端代码安全吗?局限性分析
2026-11-19 22:12:33







