

JS兼容性处理:为什么特性检测优于浏览器嗅探
深入解析JavaScript跨浏览器兼容性处理中,为什么特性检测(Feature Detection)相较于浏览器嗅探(Browser Sniffing)是更健壮、面向未来的标准实践,涵盖底层原理、代码实现、对比分析与最佳落地步骤。
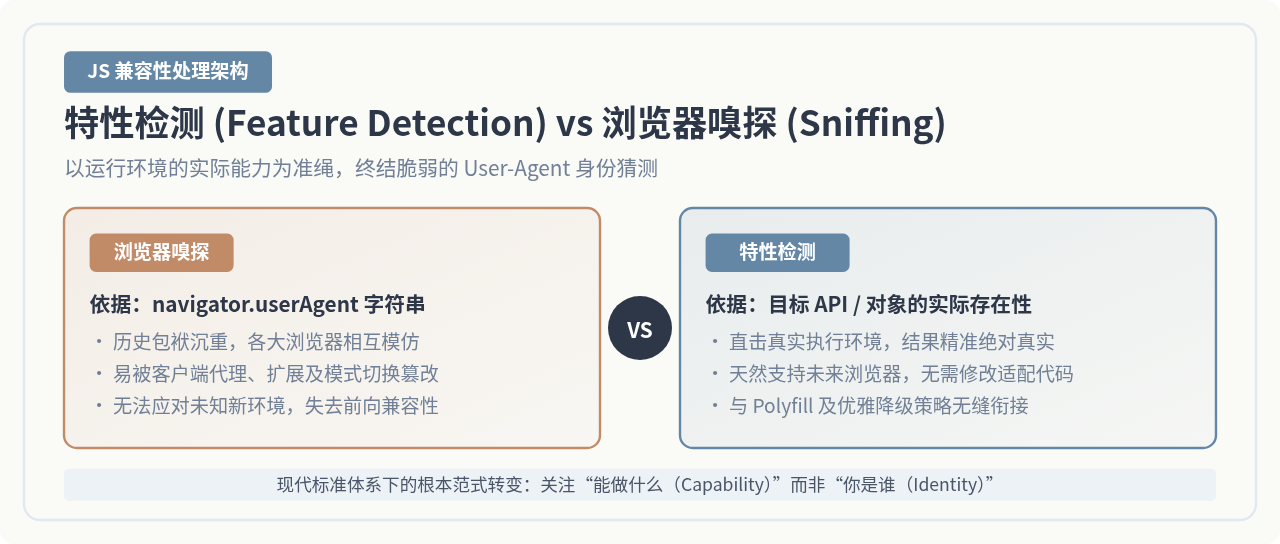
在 JavaScript 处理跨浏览器兼容性差异时,最核心的技术准则是:直接检测当前运行环境是否具备某项具体能力(特性检测,Feature Detection),而不是通过解析 navigator.userAgent 字符串猜测用户正在使用哪一款浏览器及其版本(浏览器嗅探,Browser Sniffing)。浏览器嗅探依赖漫长且充斥历史伪装的标识字符串,无法反映真实的运行上下文与未来版本变化;而特性检测以目标 API 或行为的真实存在性为准绳,具备天然的前向兼容性与高可靠度。
一、浏览器嗅探的机制与演变历程
在早期 Web 开发中,“浏览器嗅探”曾是一种普遍的做法。它的核心逻辑十分直观:读取全局对象 navigator.userAgent 返回的字符串,使用正则表达式匹配关键特征词(例如 MSIE、Firefox、Chrome、Safari),一旦匹配到某个特定名称和版本号,便认定该环境具备或不具备某项功能,进而执行差异化脚本。
下面是一段典型的传统浏览器嗅探代码示例:
// 传统浏览器嗅探反例:通过匹配 UA 字符串来推测功能支持
const ua = navigator.userAgent;

if (/Chrome\/([0-9]+)/.test(ua)) {
    const version = parseInt(RegExp.$1, 10);
    if (version >= 66) {
        // 假设 Chrome 66+ 一定支持异步剪贴板 API
        navigator.clipboard.writeText(text);
    } else {
        legacyClipboardFallback(text);
    }
} else {
    legacyClipboardFallback(text);
}
这种做法在早期浏览器各自为政、私有 API 盛行的阶段曾短期奏效,但随着 Web 规范的成熟与多端环境的爆发,其致命缺陷迅速暴露。为什么这份看似直接的判断规则在真实项目中极其不可靠?其背后的推导链条如图 1 所示。
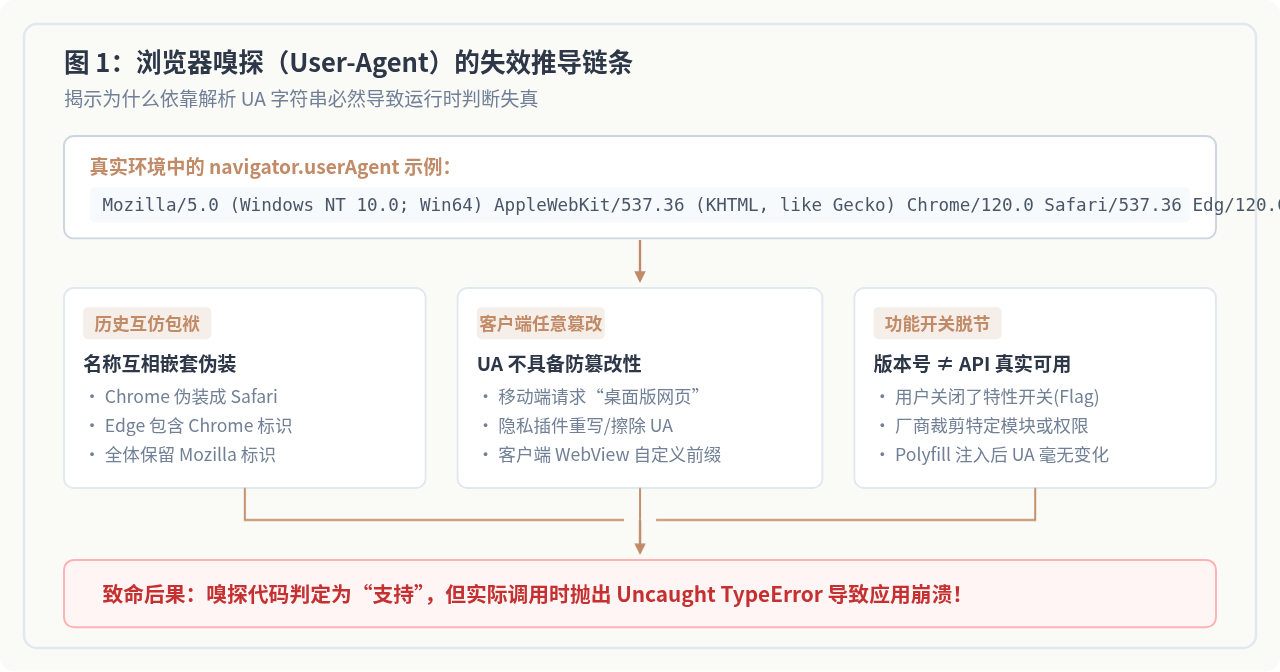
从推导链条中可以看出,依赖浏览器嗅探必然面临三道不可逾越的屏障:
- 历史互仿造成的身份混乱:在网景与微软竞争初期,许多网站只为标识为
Mozilla的浏览器提供高级页面,IE 为了兼容便将自身 UA 标记为Mozilla/4.0 (compatible; MSIE ...);此后,Safari 崛起时加入了AppleWebKit并声明兼容 Mozilla;Chrome 问世时为了兼容又将Safari和WebKit写入自身 UA;现代 Edge 转向 Chromium 后又追加了Edg/标识。如今一个常见的 UA 字符串同时包含 Mozilla、AppleWebKit、Chrome、Safari 甚至 Edge,单纯依靠字符串切分和正则匹配极易产生误判。 - UA 字符串极易被客户端干预与篡改:在移动端浏览器中,用户点击“切换为电脑版网站”时,浏览器会直接发送桌面端的 UA;各类隐私安全插件也会主动擦除或伪造 UA 字符串;同时,微信、支付宝、钉钉等移动端混合容器(Hybrid WebView)常会向 UA 中插入或覆盖自定义标识,导致原本有效的正则逻辑全面瘫痪。
- 版本号脱离真实 API 可用性:即便真实版本确实是 Chrome 120,若用户在
chrome://flags中手动禁用了某项实验性功能,或者网页处于非安全上下文(HTTP 环境下诸如navigator.clipboard、crypto.subtle等 API 会被浏览器原生禁用),UA 依然标明是 Chrome 120,但代码调用时却会立即抛出Uncaught TypeError导致应用崩溃。
二、特性检测的核心原理与实现范式
与嗅探“你是谁”不同,特性检测的核心在于“你能做什么”。它完全不管用户使用的是哪一家厂商的浏览器、版本号是多少,而是在执行某项操作之前,直接使用 JavaScript 运行时的内省机制,校验目标对象、方法或属性在当前内存中是否真实存在且可用。
在实际编码中,特性检测通常分为三个由浅入深的实现层级:
1. 属性与接口存在性探测
这是最基础也是使用最高频的检测方式,直接使用 in 操作符或 typeof 运算符探查对象链:
// 1. 检测全局构造函数或接口是否存在
if ('IntersectionObserver' in window) {
    // 原生支持交叉观察器,执行高性能图片懒加载
    const observer = new IntersectionObserver(callback);
} else {
    // 不支持,降级为监听 window scroll 事件
    setupScrollListenerFallback();
}

// 2. 使用 typeof 校验特定方法是否为可执行函数
if (typeof window.fetch === 'function') {
    window.fetch('/api/data');
} else {
    // 降级采用 XMLHttpRequest
    ajaxViaXHR('/api/data');
}if (fetch) 或 if (window.fetch) 作为检测语句。若未声明的全局变量直接在作用域中求值会触发 ReferenceError;而 'fetch' in window 或 typeof window.fetch 不会抛出任何异常,是绝对安全的检测手段。
2. DOM 原型与属性赋值行为检测
当需要判断某个 HTML 元素是否支持某个新特性(例如 <canvas> 的 2D 绘图上下文,或 <input> 是否支持 type="date"),可动态创建轻量测试节点进行赋值探测:
// 检验浏览器是否原生支持 input type="date"
function isDateInputSupported() {
    const input = document.createElement('input');
    input.setAttribute('type', 'date');
    const notADateValue = 'not-a-date';
    input.setAttribute('value', notADateValue);
    // 若浏览器不支持 date 类型,其 value 会保留无效字符串;若支持则会自动过滤
    return input.value !== notADateValue;
}
3. 行为与执行级能力测试
某些高级 API 虽然属性名存在,但在特定安全模式、无痕模式或特殊平台下可能被沙箱限制。例如在 Safari 无痕模式历史版本中,全局存在 window.localStorage,但一旦调用 setItem 就会抛出配额超限异常。此时需要结合 try...catch 完成行为验证:
// 严格的 localStorage 可用性特性检测
function isLocalStorageAvailable() {
    const testKey = '__storage_test__';
    try {
        window.localStorage.setItem(testKey, testKey);
        window.localStorage.removeItem(testKey);
        return true;
    } catch (e) {
        return false;
    }
}
三、核心差异对比:为什么特性检测全面占优
特性检测与浏览器嗅探代表了完全不同的工程哲学。前者以能力为导向,后者以身份为推断。图 2 详细列出了二者在实际架构中的对比关系。
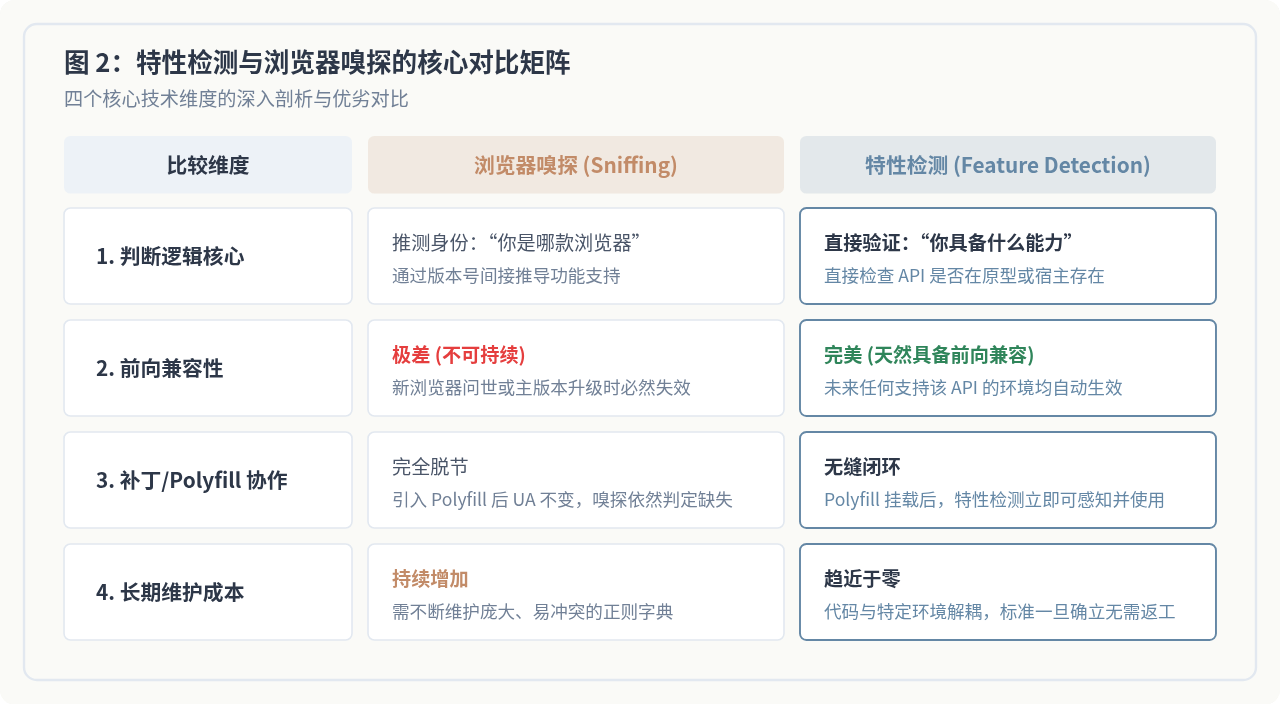
为了更清晰地评估两者在长期项目维护中的差异,我们可以通过下表进行横向比对:
| 对比维度 | 浏览器嗅探 (User-Agent Sniffing) | 特性检测 (Feature Detection) |
|---|---|---|
| 核心判断依据 | 通过 UA 字符串猜测“浏览器是谁”,间接推测功能 | 直接探查目标对象与方法,直接验证“能做什么” |
| 前向兼容性 | 极差。未来发布的新浏览器不在正则白名单内,直接被错判为不支持 | 极强。未来任何只要实现了该标准 API 的环境,无须改动代码即可自动受益 |
| Polyfill 协同能力 | 脱节。在页面打入补丁代码后,UA 并不改变,嗅探代码仍会走老旧降级分支 | 完美协同。一旦 Polyfill 挂载到全局原型上,特性检测立刻返回 true 并正常调用 |
| 抗篡改与环境适应 | 脆弱。客户端插件、桌面模式、跨端容器覆写 UA 均会导致逻辑失效 | 绝对真实。直接在当前 JavaScript 运行时作用域内验证,不受外层标识干扰 |
| 代码维护成本 | 持续攀升。必须时刻跟进新浏览器版本号、处理正则表达式特例与冲突 | 趋近于零。逻辑基于 Web 标准编写,一旦定义好检测边界,永久稳定运行 |
其中最具决定性意义的优势是前向兼容性(Forward Compatibility)。假设你在 2018 年使用特性检测编写了 if ('fetch' in window),当 2024 年甚至 2026 年一款全新的基于 Chromium 或全新内核的浏览器诞生时,你的代码无需做任何修改,就能直接调用该浏览器原生的 fetch 实现。相反,若是基于 2018 年版本的 Chrome UA 规则做嗅探,新浏览器要么被漏判,要么需要开发团队加班更新正则库。
四、特性检测的标准实施步骤与实战范例
将特性检测运用到现代 Web 项目中,需要一套标准化、规范化的操作流程,确保不仅能准确检测出功能状态,还能平滑引导降级方案。图 3 梳理了标准的四步实施闭环。
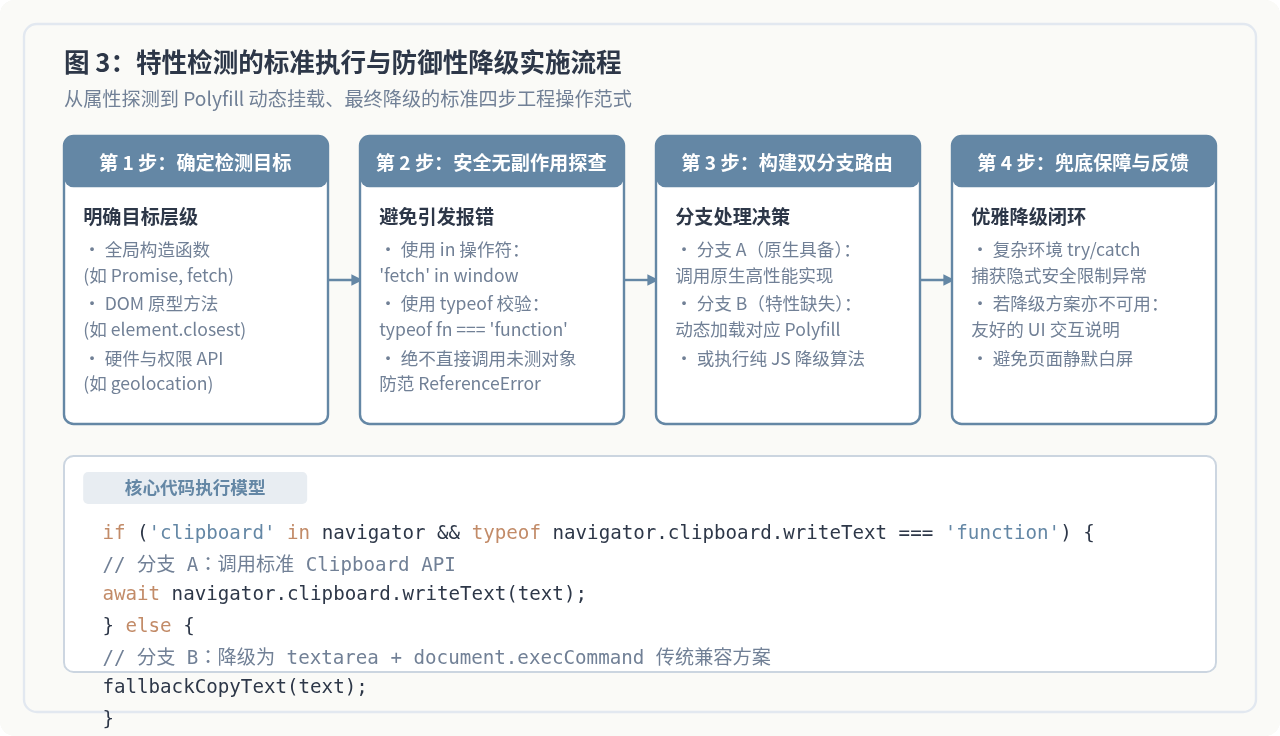
按照上述流程,标准的实施步骤分为四个环节:
- 步骤一:明确检测目标与层级
在开始编写代码前,明确当前所需特性的类型:是全局构造函数(如WebSocket、Worker)、DOM 元素属性(如dataset、hidden),还是需要安全上下文的原生硬件接口(如navigator.geolocation)。不同层级的检测点决定了探测语句的挂载位置。 - 步骤二:编写安全且无副作用的检测逻辑
避免直接调用未校验的方法。统一使用'prop' in target或typeof target.prop === 'function'。若特性涉及 DOM 节点操作,应在内存中创建临时节点进行测试,并在测试完毕后解除引用,避免触发无意义的页面重绘(Reflow/Repaint)或内存泄露。 - 步骤三:构建双分支路由机制
在业务代码中设立标准分支通道:- 分支 A(原生支持):直接调用宿主提供的高性能原生接口;
- 分支 B(特性缺失):动态加载按需补丁(如 Polyfill 脚本),或执行基于纯 JavaScript 编写的替代算法。
- 步骤四:边界兜底与用户反馈保障
对于极特殊场景(例如浏览器虽然存在该 API 但权限被操作系统策略封锁),使用try...catch进行末端拦截。若降级方案同样因环境限制无法执行,必须提供清晰的 UI 状态提示,避免页面发生无响应假死。
下面我们以现代前端非常常见的“一键复制文本到剪贴板”功能为例,展示完整的标准工程实现:
/**
 * 跨浏览器文本复制:标准特性检测与优雅降级方案
 * @param {string} text 需要复制的内容
 * @returns {Promise<boolean>} 是否复制成功
 */
async function copyTextToClipboard(text) {
    // 步骤一 & 二:安全无副作用特性检测(同时校验安全上下文与目标函数)
    const isAsyncClipboardSupported =
        typeof navigator !== 'undefined' &&
        'clipboard' in navigator &&
        typeof navigator.clipboard.writeText === 'function';

    // 步骤三:双分支决策
    if (isAsyncClipboardSupported) {
        try {
            // 分支 A:使用现代高性能 Clipboard API
            await navigator.clipboard.writeText(text);
            return true;
        } catch (err) {
            // 步骤四:若因权限或安全沙箱被拒,向下流转进入降级方案
            console.warn('Clipboard API 权限受阻,转入降级处理', err);
        }
    }

    // 分支 B:传统 DOM 降级方案(基于 textarea + execCommand)
    return fallbackCopyUsingExecCommand(text);
}

function fallbackCopyUsingExecCommand(text) {
    const textArea = document.createElement('textarea');
    textArea.value = text;
    // 设置样式避免触发页面滚动与显示
    textArea.style.position = 'fixed';
    textArea.style.top = '0';
    textArea.style.left = '-9999px';
    textArea.style.opacity = '0';
    document.body.appendChild(textArea);
    textArea.focus();
    textArea.select();

    let successful = false;
    try {
        // 检测并执行传统命令
        successful = document.execCommand('copy');
    } catch (err) {
        console.error('降级方案执行失败:', err);
    } finally {
        document.body.removeChild(textArea);
    }
    return successful;
}
五、例外考量:极罕见的边缘场景与 Bug 隔离
在绝大多数业务场景中,特性检测都能百分之百覆盖需求。然而,在前端工程实践中,是否存在必须使用 UA 嗅探的特例?
答案是:只有在处理特定厂商、特定版本的“非标准内部 Bug(Vendor-specific Bug)”时,且该 Bug 无法通过常规特性检测探测出来,才允许极度克制地使用嗅探。
- 特性缺失(Feature Absence):例如浏览器没有实现
IntersectionObserver。该场景是规范支持问题,必须 100% 采用特性检测。 - 厂商 Bug(Vendor Bug):例如某老版本 iOS WebKit 存在特定的光标错位 Bug,或者特定版本 Android WebView 在硬件加速下渲染圆角产生黑边。这种情况下,相关的 CSS 属性或 JS API 全部存在,特性检测会返回
true,但实际渲染存在肉眼可见的缺陷。
即便面对极个别的厂商 Bug,也必须遵守以下防护规范:
- 严格限定版本区间:绝不编写无上限的正则(例如只写
/iPhone/是严重错误的,会导致后续无数代正常设备全被波及),必须明确锁定具体受影响的内核区间(如iOS 13.4.0 ~ 13.4.1)。 - 隔离在独立模块并注明过期时间:将针对特定 Bug 的规避代码抽取到专有补丁文件,附带官方 Issue 跟踪链接与团队评审删除日期(如半年后或次年主版本发布后清理)。
六、现代 JS 兼容性治理全景总结
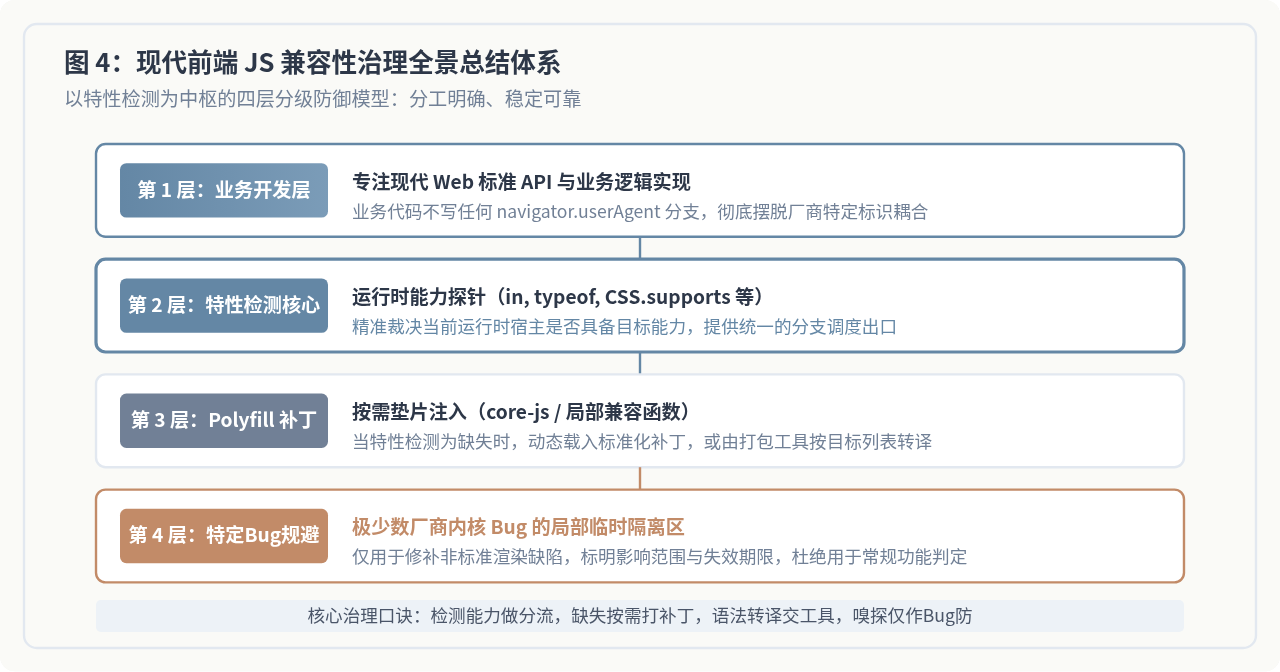
在现代前端工程化生态中,兼容性处理已经从过去手写条件分支,演进为系统化的分层防御体系。如图 4 所示,特性检测在其中居于承上启下的核心枢纽地位。
一个成熟团队的兼容性治理自查清单如下:
- 语法层面转译:对于箭头函数、可选链(
?.)、解构赋值等 JavaScript 静态语法,交由构建工具(Babel / SWC / esbuild)结合browserslist配置在编译阶段统一降级转译。 - 运行时标准 API:对于
Promise、fetch、Array.prototype.flat等运行时对象与方法,通过core-js配合特性检测自动按需 Polyfill。 - 业务逻辑编写:彻底移除所有用于功能判断的
navigator.userAgent正则;全局优先使用in、typeof等无副作用探测手段。 - 设计优雅降级:当探测到环境确实不支持某项能力时,代码结构保持清晰的降级路径,为用户呈现功能可用或友好提示的界面,杜绝未捕获异常造成的白屏。
总结而言,特性检测是 Web 开放标准能够向前持续演进的基础保障。抛弃脆弱的浏览器嗅探,以环境的真实能力为决策依据,是每一位前端工程师写出健壮、面向未来的高质量 JavaScript 代码的必经之路。
JS动态生成HTML时怎么正确插入换行
2026-11-20 21:41:39
JavaScript能直接读取用户本地文件吗?浏览器安全限制解析
2026-11-20 18:52:29
JS点击事件触发URL跳转失效的常见原因排查
2026-11-20 15:26:14
JS使用classList.remove删除元素class的方法
2026-11-20 14:43:33
结合Intersection Observer实现视口内触发JS数字滚动
2026-11-20 11:56:43







