JS生成PDF中文乱码怎么办?字体嵌入完整方案
JavaScript 生成 PDF 时出现中文乱码、问号或黑方块,根本原因在于 PDF 默认内置字体缺失 CJK 字形。本文详解 jsPDF、pdfmake 及 pdf-lib 嵌入 TrueType (TTF) 矢量字体的完整操作步骤、VFS 注册机制与字体子集化瘦身方案,帮助开发者彻底解决中文渲染与性能问题。
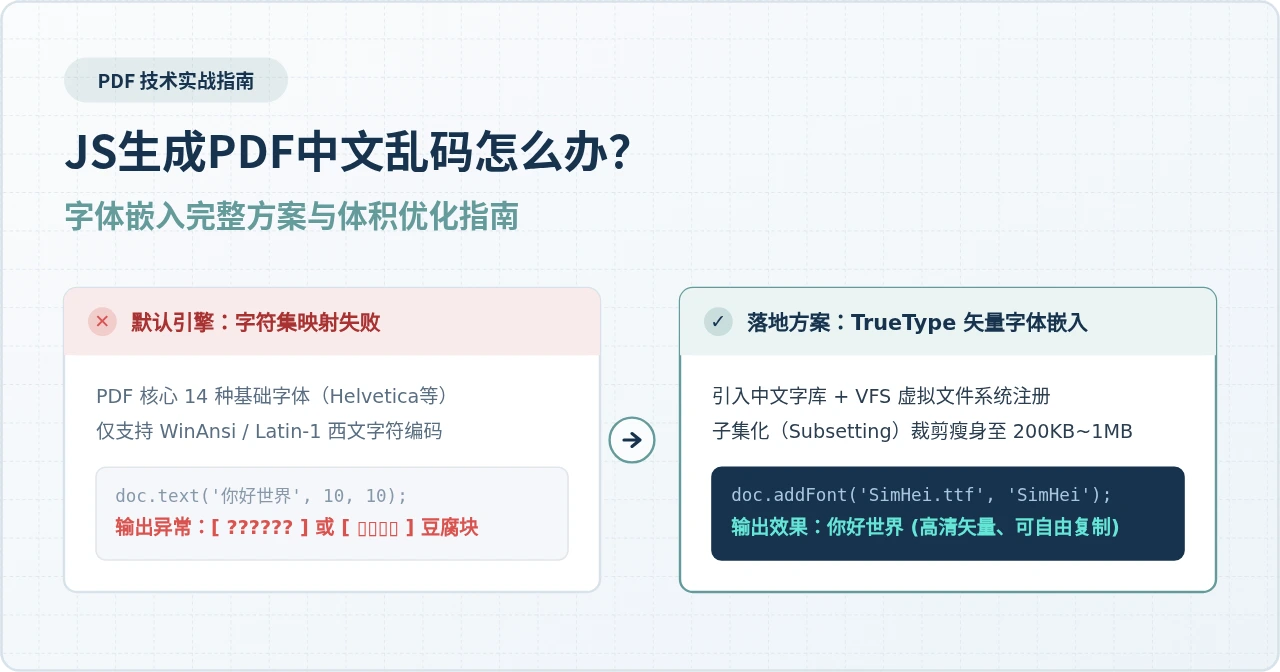
在前端或 Node.js 环境中通过 JavaScript 生成 PDF 文档时,中文输出为方块豆腐块、问号或乱码,根本原因在于 PDF 规范默认内置的 14 种标准字体(如 Helvetica、Times、Courier 等)仅支持 WinAnsi/Latin-1 西文字符编码,完全不含中文字形与 Unicode 映射表。彻底且专业的解决路径是:准备单字重 TrueType(.ttf)中文字体,进行子集化裁剪瘦身,将其注入虚拟文件系统(VFS)或字体引擎中注册,并在绘制文本时激活该字体。
一、乱码根源:为什么网页显示正常,直出 PDF 却是一堆问号?
许多初次在前端生成 PDF 的开发者会遇到一个困惑:页面在 Chrome 或 Edge 浏览器中渲染正常,所有汉字清晰无误,页面头部的 <meta charset="UTF-8"> 声明也完整无缺,但调用 doc.text('发票明细', 10, 10) 生成的 PDF 打开后却全变成了 ???? 或者一连串类似 ▯▯▯▯ 的小方块。
之所以出现这种现象,核心在于 PDF 文件格式与 HTML/CSS 网页渲染机制完全不同:
- 网页渲染依靠操作系统系统字体栈: 浏览器遇到汉字时,会根据 CSS 的
font-family回退链,在宿主操作系统中自动调用“苹方(PingFang SC)”、“微软雅黑(Microsoft YaHei)”或“思源黑体”等本地字库绘制字符点阵。 - PDF 规范是完全自治的跨平台二进制文档: PDF 渲染器(如 Adobe Acrobat、Chrome 内置 PDF Viewer、Foxit Reader)只识别 PDF 文件流内部声明的字体对象。为了控制文件体积,PDF 规范自诞生之初仅预置了 14 种标准西文字体(Standard 14 Fonts,包含 Helvetica、Times-Roman、Courier、Symbol 等)。
- 编码表缺失汉字映射(CMap): 这些内置基础字体使用的是单字节 Latin-1 字符集(编码范围为 0x00 至 0xFF),对于汉字庞大的 Unicode 范围(0x4E00 至 0x9FA5)完全没有任何索引。当 JS 引擎强行将双字节甚至三字节的 UTF-8 字符塞进这些西文字体时,找不到对应的 Glyph ID,渲染器只能回退触发
.notdef标志,最终呈现为黑方块、空白或问号。
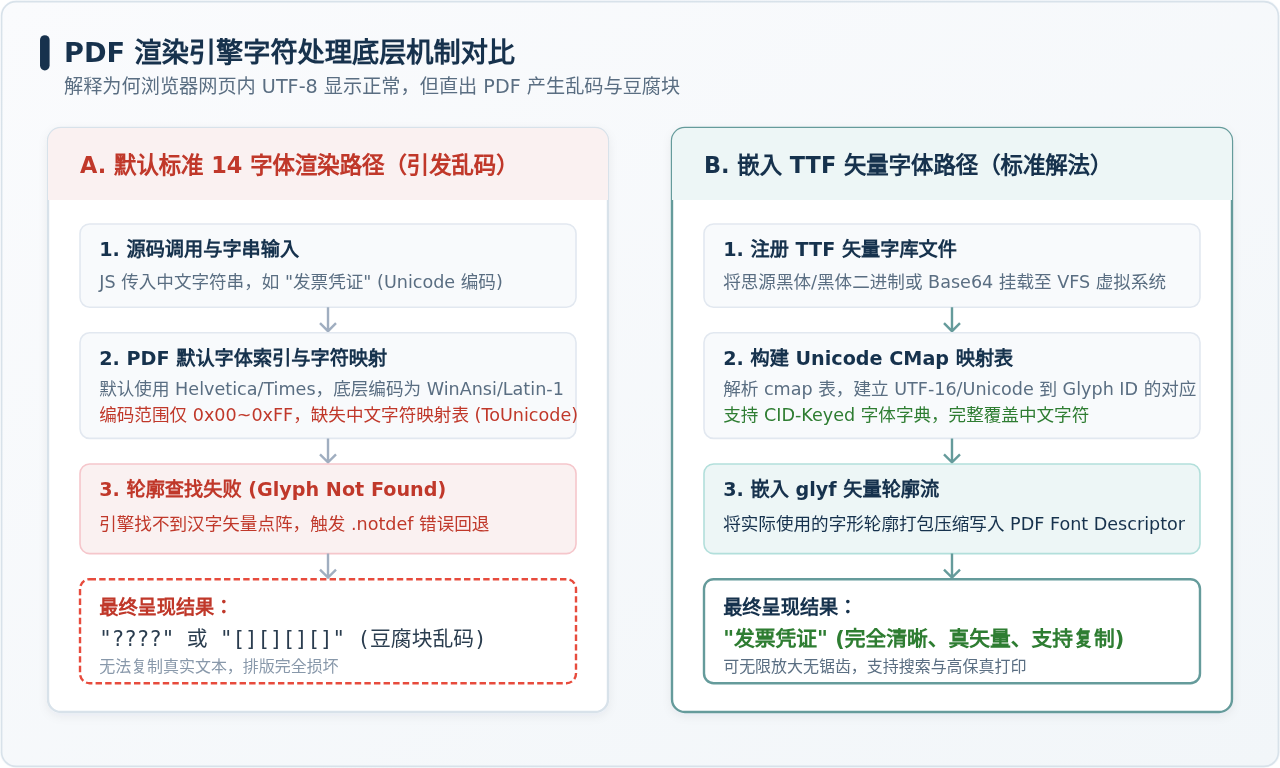
因此,单纯给网页加 UTF-8 声明或对字符串执行 encodeURIComponent 对 PDF 生成毫无效果。要让 PDF 正确显示中文,必须向 PDF 二进制流中嵌入包含中文字形与 ToUnicode 映射表的矢量字库。
二、技术选型:纯矢量字体嵌入 vs. DOM 栅格化截图
在前端实现中文 PDF 导出,目前主要有两种主流技术路径:矢量字体嵌入直出 与 DOM 栅格化(html2canvas + jsPDF 拼接截图)。在决定技术实现之前,了解两者的权衡至关重要:
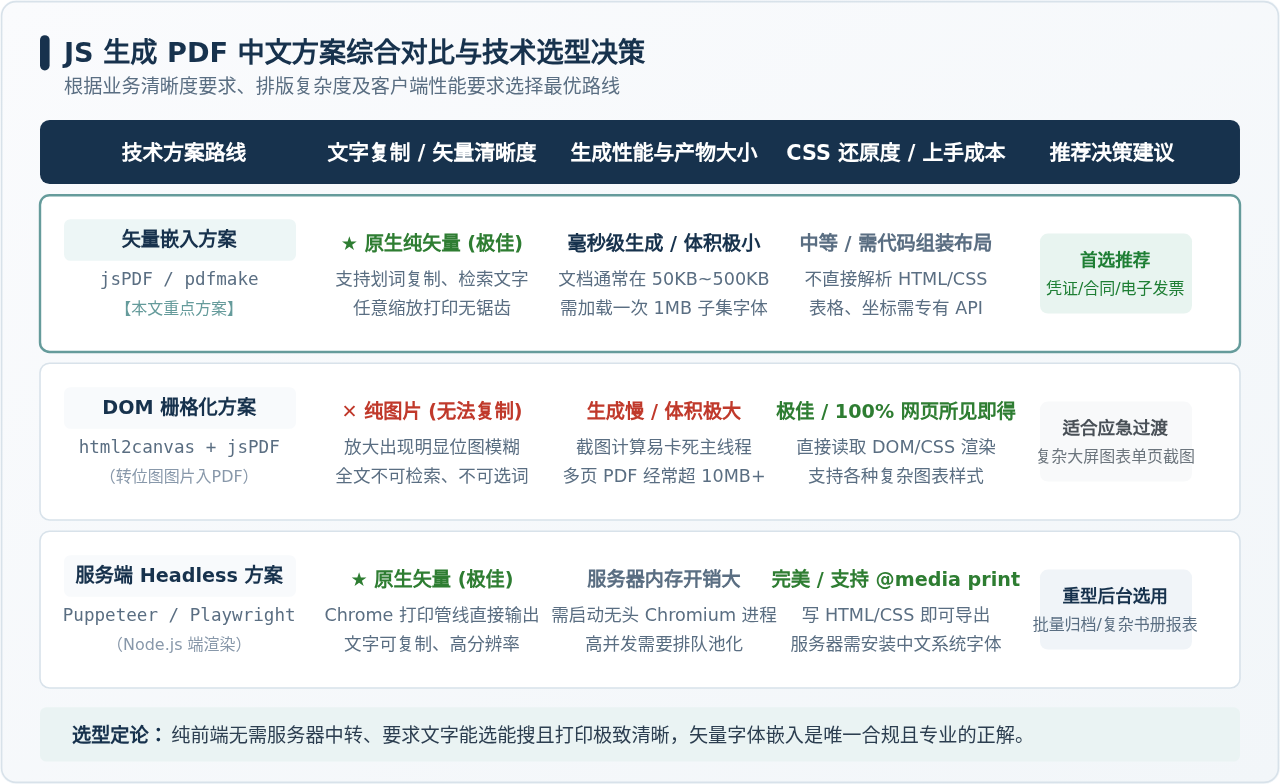
结论与建议:
- 强烈建议使用矢量字体嵌入: 如果导出的文档是合同、报价单、财税发票、物流运单或出库凭证,必须保证打印极度锐利,且要求买方或审计方能够选中文本复制单号,矢量字体嵌入是唯一合规且专业的正解。
- 截图方案仅作应急过渡:
html2canvas + jsPDF适合大屏图表、复杂数据可视化看板的“当前页面一键存图转 PDF”。对于纯文字或表格文档,其位图发虚、分页断行混乱、体积臃肿的缺陷在正式商业项目中极易引发客诉。
三、核心操作实战:jsPDF 字体嵌入三步法
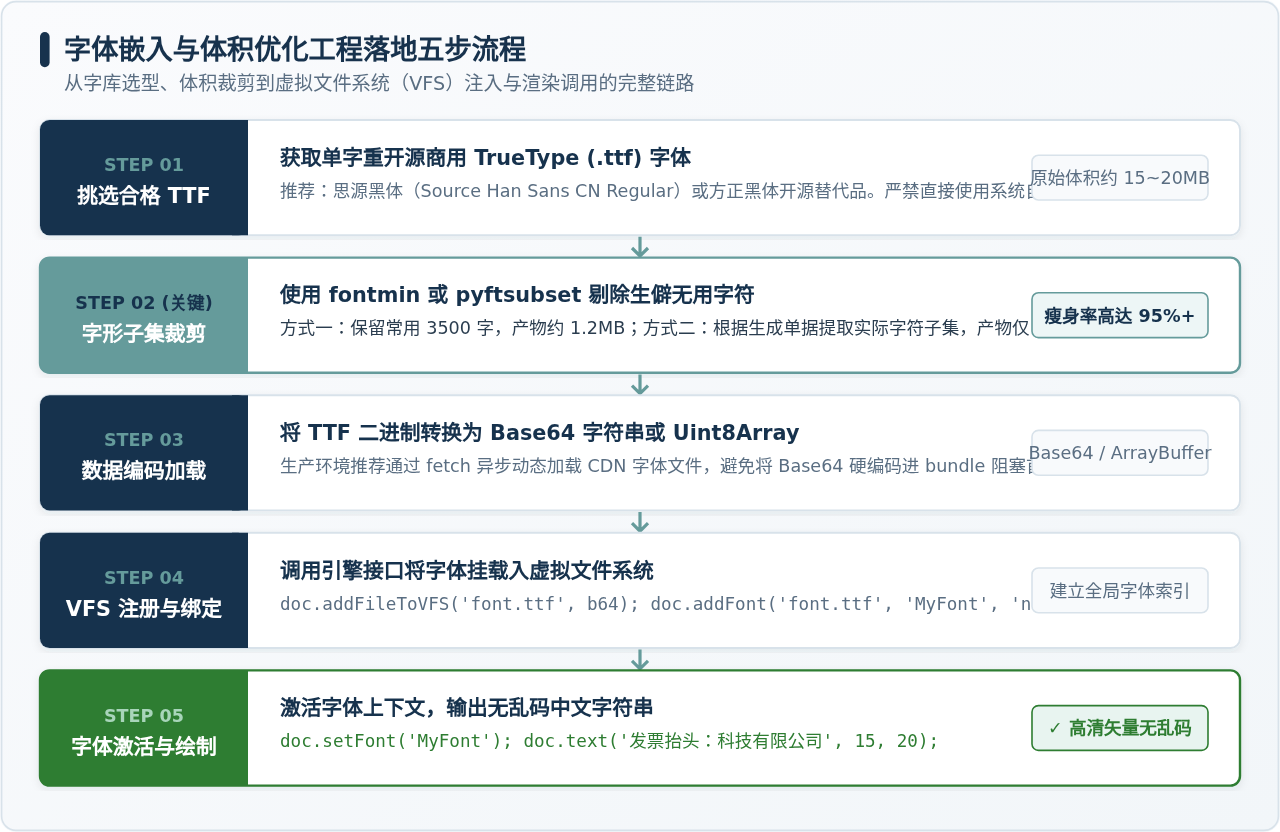
jsPDF 是前端最为通用的轻量级 PDF 生成库。要在 jsPDF 中输出中文,标准流程可分为三步:准备 TTF 字体、转换为 Base64 并挂载 VFS、注册并激活字体。
Windows 系统的 msyh.ttc(微软雅黑)或 macOS 的 PingFang.ttc 属于 TrueType Collection(字体集合包),内部打包了多个字重与字体。jsPDF 底层的解析器不支持解析 TTC 容器,强行挂载会抛出 Unknown font format 错误。必须使用单个独立权重的 .ttf(TrueType)文件,例如开源的思源黑体(Source Han Sans CN Normal.ttf)。
步骤一:将 TTF 字体转换为 Base64 编码
jsPDF 运行在浏览器端时,没有直接读取服务端本地磁盘文件的权限,它依赖一个名为 VFS(Virtual File System,虚拟文件系统) 的内存字典对象来管理外部资源。因此需要先将 TTF 字体文件的二进制流转换为 Base64 纯文本字符串。
在 Node.js 构建脚本或临时开发环境中,可以通过以下命令快速提取字体的 Base64:
// Node.js 转换脚本:convert-font.js
const fs = require('fs');
const fontBuffer = fs.readFileSync('./SourceHanSansCN-Normal.ttf');
const base64Font = fontBuffer.toString('base64');
fs.writeFileSync('./font-base64.txt', base64Font);
console.log('Base64 转换完成,长度:', base64Font.length);
步骤二与三:挂载 VFS、注册并在文档中激活
在业务代码中,依次调用 addFileToVFS()、addFont() 和 setFont():
import { jsPDF } from 'jspdf';

// 1. 模拟或动态拉取 Base64 字体字串(生产环境建议通过 fetch 获取)
async function generateChinesePdf() {
  // 创建标准 A4 纵向文档(单位:毫米)
  const doc = new jsPDF({
    orientation: 'portrait',
    unit: 'mm',
    format: 'a4'
  });

  // 异步拉取优化后的中文字体 Base64 文本
  const res = await fetch('/fonts/SourceHanSansCN-Subset.base64.txt');
  const fontBase64 = await res.text();

  const virtualFileName = 'SourceHanSansCN-Normal.ttf';
  const fontPostScriptName = 'SourceHanSansCN';

  // 2. 将字串注入 jsPDF 虚拟文件系统(VFS)
  doc.addFileToVFS(virtualFileName, fontBase64.trim());

  // 3. 建立字体索引:关联 VFS 文件、字体名称别名、字重(normal)
  doc.addFont(virtualFileName, fontPostScriptName, 'normal');

  // 4. 激活当前字体上下文
  doc.setFont(fontPostScriptName);

  // 5. 执行中文矢量文本渲染
  doc.setFontSize(20);
  doc.text('增值税电子普通发票', 105, 25, { align: 'center' });

  doc.setFontSize(12);
  doc.text('购买方名称:北京科技有限公司', 20, 45);
  doc.text('纳税人识别号:91110108MA00000000', 20, 53);
  doc.text('开票日期:2026年11月16日', 20, 61);

  // 6. 导出并触发浏览器下载
  doc.save('电子发票凭证.pdf');
}
四、其他主流库方案:pdfmake 与 pdf-lib 字体配置
除了 jsPDF,在处理更复杂的声明式报表排版(如自动分页表格、栅格布局)或在已有现成 PDF 模板上套打文字时,pdfmake 与 pdf-lib 同样应用极广。它们的字体嵌入配置逻辑如下:
1. pdfmake 的中文字体配置
pdfmake 是声明式语法,其默认集成的 vfs_fonts.js 仅包含西文 Roboto 字体。要支持中文,只需重写其全局 pdfMake.fonts 字典:
import pdfMake from 'pdfmake/build/pdfmake';

// 1. 注入 Base64 字典到 pdfMake.vfs
pdfMake.vfs['SourceHanSansCN-Regular.ttf'] = fontBase64String;

// 2. 定义字体族名及其对应的四个字重文件
pdfMake.fonts = {
  Roboto: {
    normal: 'Roboto-Regular.ttf',
    bold: 'Roboto-Medium.ttf',
    italics: 'Roboto-Italic.ttf',
    bolditalics: 'Roboto-MediumItalic.ttf'
  },
  ChineseFont: {
    normal: 'SourceHanSansCN-Regular.ttf',
    bold: 'SourceHanSansCN-Regular.ttf',       // 无独立粗体文件时可共用同一文件
    italics: 'SourceHanSansCN-Regular.ttf',    // 避免 fallback 导致西文乱码
    bolditalics: 'SourceHanSansCN-Regular.ttf'
  }
};

// 3. 在文档定义中将 defaultStyle.font 指向自定义中文字体
const docDefinition = {
  content: [
    { text: '销售出库凭单', fontSize: 18, bold: true, alignment: 'center' },
    { text: '仓库主管:张三  |  核验员:李四', margin: [0, 10, 0, 15] }
  ],
  defaultStyle: {
    font: 'ChineseFont' // 全局应用
  }
};

pdfMake.createPdf(docDefinition).download('出库单.pdf');
2. pdf-lib 的中文字体扩展与嵌入
pdf-lib 是现代纯 JavaScript 编写的底层 PDF 操作库,专用于合并、拆分或在现有 PDF 上做增量修改。pdf-lib 原生同样不支持直接解析 TTF 的 Unicode 映射,需要结合 @pdf-lib/fontkit 插件:
import { PDFDocument, rgb } from 'pdf-lib';
import fontkit from '@pdf-lib/fontkit';

async function fillPdfTemplate() {
  const pdfDoc = await PDFDocument.create();
  // 必须注册 fontkit 引擎
  pdfDoc.registerFontkit(fontkit);

  const fontBytes = await fetch('/fonts/SourceHanSansCN-Regular.ttf').then(r => r.arrayBuffer());
  // 嵌入字体字节流(底层自动生成 CIDFont 与 ToUnicode 映射)
  const customChineseFont = await pdfDoc.embedFont(fontBytes);

  const page = pdfDoc.addPage([595, 842]);
  page.drawText('合同签署完成:授权盖章有效', {
    x: 50,
    y: 750,
    size: 16,
    font: customChineseFont,
    color: rgb(0.09, 0.20, 0.30)
  });

  const pdfBytes = await pdfDoc.save();
}
五、性能痛点突破:中文字体体积从 20MB 裁剪至 200KB
很多开发者在打通字体嵌入后,马上遇到了第二个致命问题:页面卡死与前端打包体积爆裂。
英文字体通常只有 26 个字母加常见符号,体积往往只有数十 KB;而中文字体完整版包含两万多个汉字汉字字形、注音和多国 CJK 扩展字符,一个标准的思源黑体(Source Han Sans)单文件往往高达 15MB 至 25MB。如果将该字体转为 Base64 直接打包进前端 JS 文件,打包产物瞬间暴涨 30MB 以上,首次加载将耗费数十秒甚至使移动端浏览器崩溃。
解决这一性能瓶颈的业界成熟策略分为三层:
| 裁剪与优化策略 | 实现工具与方法 | 体积控制水平 | 适用业务场景 |
|---|---|---|---|
| 1. GB2312 常用一级字库裁剪 | 使用 fontmin 或 pyftsubset 提取 3500 常用字及标准数字标点 |
从 18MB 裁剪至 1.1MB ~ 1.5MB(Gzip 后约 800KB) | 面向大众用户的通用前端界面,字库固定且覆盖 99.8% 日常书写需求 |
| 2. 服务端动态按需子集化 | 后端在组装单据数据时,提取当前单据实际用到的文字集合,动态裁剪后推回前端 | 直接压缩至 20KB ~ 80KB | 电子发票、货运运单、员工离职证明等内容有限但频次极高的企业文档 |
| 3. 异步分发与持久化缓存 | 不打包进 JS 源码,放静态资源 CDN,客户端通过 IndexedDB / Cache API 本地持久化 | 零主应用体积影响,首次加载一次,后续毫秒秒开 | 企业 ERP、CRM、SaaS 复杂前端工作台 |
实操:使用 Fontmin 快速生成 3500 常用字精简字库
在项目中可以使用开源的 fontmin 库编写一行自动化脚本,完成字形过滤:
const Fontmin = require('fontmin');
const fs = require('fs');

// 读取常用的 3500 个现代汉语常用字及标点符号列表
const commonChineseChars = fs.readFileSync('./common-3500.txt', 'utf-8');

const fontmin = new Fontmin()
  .src('./fonts/SourceHanSansCN-Normal.ttf')
  .use(Fontmin.glyph({
    text: commonChineseChars + '0123456789abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ.,;:!@#$%^&*()_+-=[]{}|/<>?'
  }))
  .dest('./dist/fonts/');

fontmin.run((err, files) => {
  if (err) throw err;
  console.log('精简中文字库生成成功!');
});
六、高频故障排查与避坑检查清单
在实际生产部署中,即便按照教程引入了字体,依然可能因细节疏漏导致中文乱码复发。以下 4 项是最高频的失误排查点:
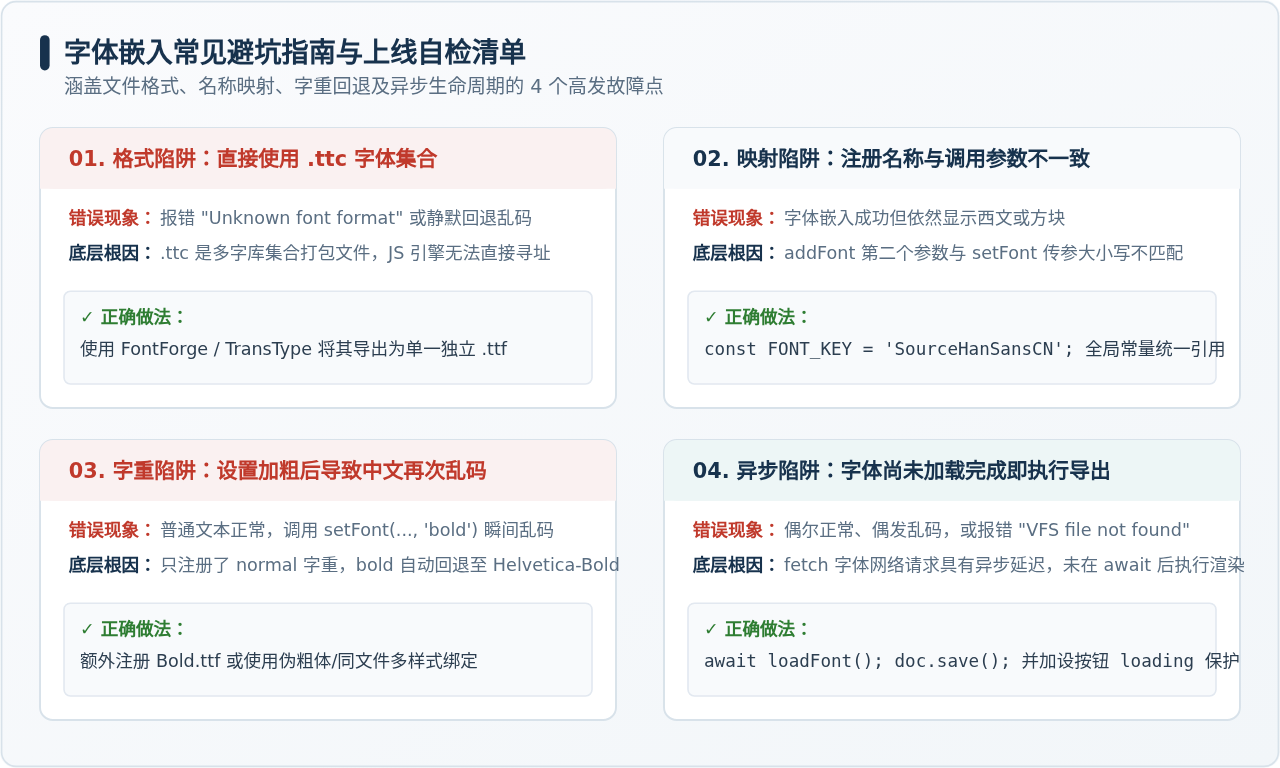
-
检查字体名称(PostScriptName)大小写与空格:
在doc.addFont('myfont.ttf', 'CustomFont', 'normal')中定义的第二个参数'CustomFont',必须与后续doc.setFont('CustomFont')完全一致(包括大小写)。如果两者存在哪怕一个字母差异,引擎在内部字体字典中查找不到,会静默回退至默认西文字体并导致乱码。 -
加粗样式引发的“二次乱码”陷阱:
如果只调用了doc.addFont('font.ttf', 'MyFont', 'normal')注册了常规字重,但在输出标题时执行了doc.setFont('MyFont', 'bold'),引擎会寻找该字体族下的bold文件。由于未注册粗体,它会自动回退到西文的Helvetica-Bold,导致正文中文正常、标题中文全是方块。解决方案:要么显式为bold也注册该字体,要么在配置中将bold映射到同一个已注册文件。 -
异步网络加载时序竞态:
当字体文件托管在静态 CDN 上通过fetch()动态拉取时,必须确保点击“导出 PDF”按钮后使用await阻塞等待字体加载与 VFS 注册完成。务必在界面上增加loading禁用交互,避免用户快速连续点击在字体尚未到位时触发渲染。 -
生僻字“开天窗”现象:
如果采用了字库子集化(Subsetting),当遇到用户姓名中包含生僻汉字(如“䶮”、“赟”、“珅”)或生僻地名时,若该字不在精简字符集内,该单字会变成方块。对于严肃金融级场景,前端应预先对即将导出的文本进行字符校验,遇到超集字符时触发动态后备字体补偿加载。
七、总结
JavaScript 生成 PDF 过程中的中文乱码问题,其根源不是网页编码缺陷,而是 PDF 规范对于字形数据的严格封装要求。只要遵循以下核心要点,即可稳定输出清晰无瑕的专业级矢量 PDF:
- 选用单一字重的开源商用 .ttf 格式(首选思源黑体);
- 通过 子集化(Subsetting) 将十几兆的大字体裁剪至 1MB~1.5MB(或动态按需裁剪),解决传输与内存瓶颈;
- 规范执行 VFS 注入、字体索引别名注册及上下文激活,注意大小写一致与字重 fallback 处理;
- 将字体文件放置在 CDN 进行异步拉取并利用客户端本地缓存,保证前端首屏性能与导出效率的双赢。
JSON字符串转JS对象:JSON.parse()解析与异常处理
2026-11-17 17:58:18
JS数组取值越界或为undefined时的安全处理技巧
2026-11-17 17:46:46
JavaScript常用字符串方法详解:slice、substring与split
2026-11-17 16:45:53
JS对象合并:展开运算符与Object.assign的区别及用法
2026-11-17 15:01:39
解决JS序列化JSON时报错Converting circular structure to JSON
2026-11-17 14:48:47