Node.js Buffer用法:字符串、Hex与二进制的快速转换
全面讲解 Node.js 中 Buffer 的核心转换机制,涵盖 UTF-8 字符串、十六进制(Hex)与 01 二进制位串(Binary/Bits)的高效互转方法、代码实现与分片截断等常见陷阱处理。
在 Node.js 服务端开发中,网络协议传输、文件读写、数字签名以及加密哈希等高频场景,都需要在文本字符串、十六进制(Hex)与原始二进制位之间来回切换。Node.js 提供了全局可用的 Buffer 类作为这三者之间的通用载体。通过标准 API 与简单的位运算,可以快速实现零损耗的数据互转,同时避开奇数截断、多字节乱码等经典工程陷阱。
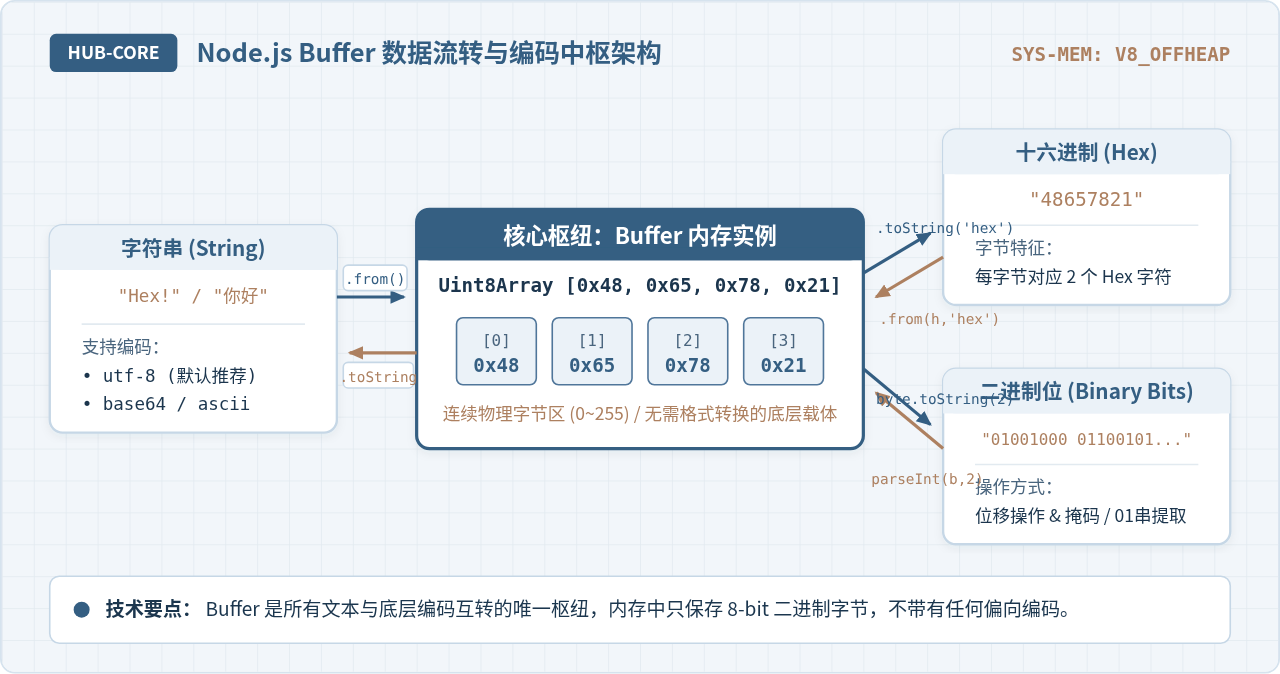
一、Buffer 的底层机制与内存模型
很多开发者容易将 Buffer 误认为是带有特定字符编码的“高级字符串”,但从底层来看,Buffer 实际上是 V8 虚拟机堆内存之外(Off-Heap)直接分配的一块固定长度的连续物理内存空间。在 JavaScript 运行环境中,它是 Uint8Array 类型的子类。
在内存单元内部,Buffer 仅以 8 位无符号整数(0~255,即十六进制 0x00 ~ 0xFF)的形式存储字节数据。数据本身并没有任何编码偏向,所谓字符串、Hex 还是二进制位,仅仅是外部观察和解析这块内存时的“视图规则”(View)。
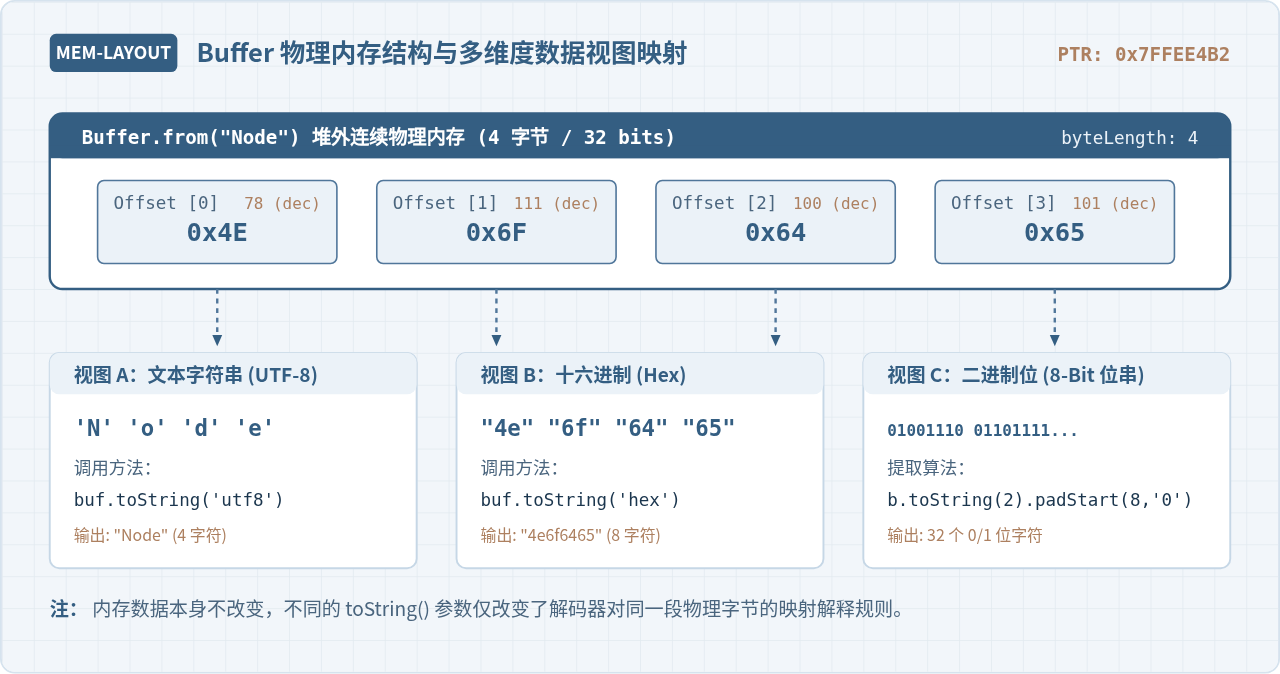
现代 Node.js 已完全弃用了不安全的 new Buffer() 构造器,创建 Buffer 统一采用工厂方法:
Buffer.from(...):基于现有字符串、数组或 ArrayBuffer 复制并创建新 Buffer。Buffer.alloc(size):在内存中申请指定字节大小的空间,并将所有字节自动置为 0(安全)。Buffer.allocUnsafe(size):申请指定大小的内存空间但不执行清零操作,分配极快,但包含旧内存残留,只适合分配后立刻被全部覆写的吞吐优化场景。
二、字符串与 Buffer 的快速互转
字符串与 Buffer 的双向转换依赖明确的字符编码指定。Node.js 原生支持 'utf8'、'base64'、'ascii'、'latin1' 以及 'hex' 等编码参数,默认编码均为 'utf8'。
1. 字符串转换为 Buffer
// 基础转换:默认采用 UTF-8 编码
const buf1 = Buffer.from('Node.js 快速指南');
console.log('字节长度 (byteLength):', buf1.byteLength); // 中文通常占 3 个字节
console.log('内存展示:', buf1);

// 指定编码转换(如 Base64 还原为 Buffer)
const base64Str = 'SGVsbG8gV29ybGQ=';
const buf2 = Buffer.from(base64Str, 'base64');
console.log('从 Base64 还原的文本:', buf2.toString('utf8')); // 示例输出: Hello World
2. Buffer 转换为字符串
调用 buf.toString([encoding], [start], [end]) 即可导出字符串。如果不传递编码参数,默认按 'utf8' 解码。
const buf = Buffer.from([0x48, 0x65, 0x6c, 0x6c, 0x6f]);
const text = buf.toString('utf8');
console.log(text); // 示例输出: Hello
UTF-8 是变长编码,一个中文字符通常占用 3 个字节。在通过
Stream 或 Socket 接收数据时,网络数据包可能会刚好截断在汉字的第 1 或第 2 个字节处。若直接在 data 事件中对每个分块调用 chunk.toString('utf8'),不完整的末尾字节会被转换成不可逆的乱码字符(� )。正确做法:使用 Node.js 原生的
string_decoder 模块。它会在内部维护多字节状态机,自动暂存末尾未完成的字节,直到下一分块到达拼接完整后再行输出:
const { StringDecoder } = require('string_decoder');
const decoder = new StringDecoder('utf8');

// 模拟一个汉字 "你" (3 字节: E4 BD A0) 被拆分为两个分包
const chunk1 = Buffer.from([0xE4, 0xBD]);
const chunk2 = Buffer.from([0xA0]);

console.log(decoder.write(chunk1)); // 输出: "" (暂存等待补全,避免乱码)
console.log(decoder.write(chunk2)); // 输出: "你" (拼接完整后输出)
三、十六进制(Hex)与 Buffer 的快速互转
十六进制由 0-9 与 a-f / A-F 构成。因为一个字节包含 8 位,恰好可以用 2 个十六进制字符(每字符代表 4 位,即半字节 Nibble)精准表达,因此 Hex 成为密码学哈希、密钥交换和二进制协议调试的标准文本格式。
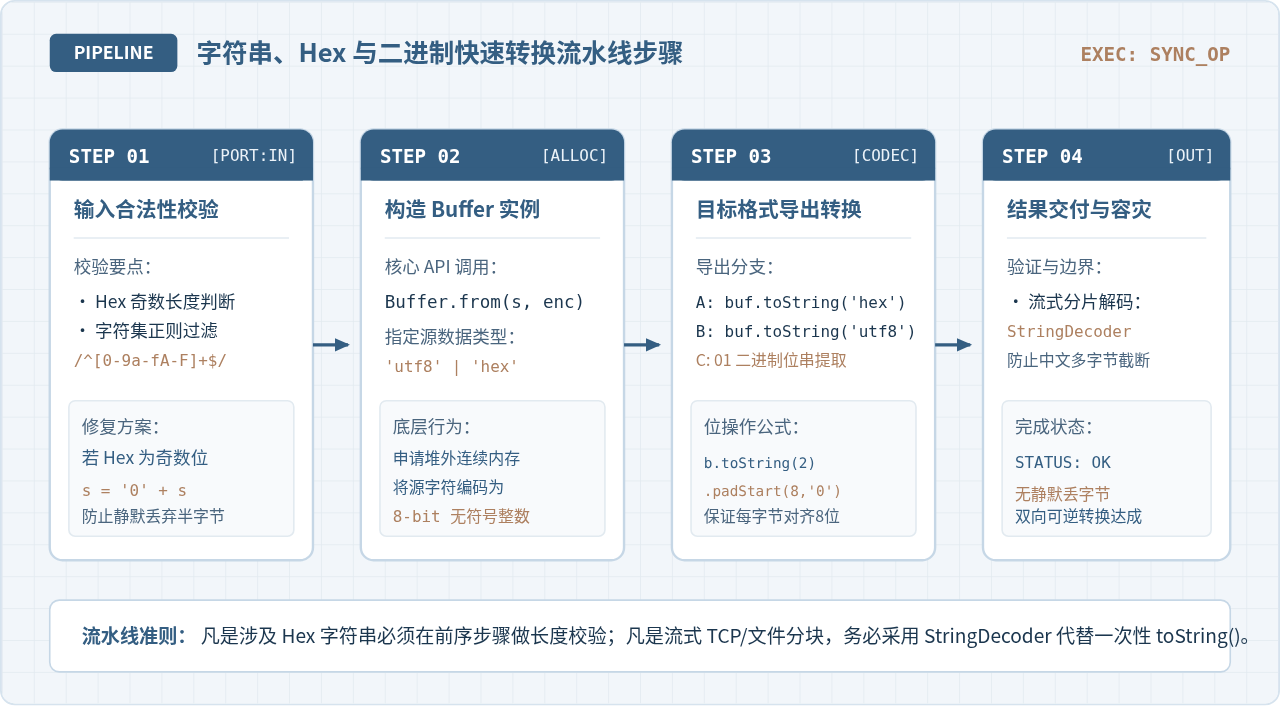
1. Buffer 导出为 Hex 字符串
const originalBuf = Buffer.from('Antigravity');
const hexString = originalBuf.toString('hex');
console.log('Hex 字符串:', hexString);
// 示例输出: 416e746967726176697479 (每个字符对应 2 位 hex)
2. Hex 字符串解析为 Buffer
const inputHex = '416e746967726176697479';
const restoredBuf = Buffer.from(inputHex, 'hex');
console.log('还原为文本:', restoredBuf.toString('utf8')); // 示例输出: Antigravity
- 奇数长度静默丢弃:若传入长度为奇数的 Hex 字符串(例如
'abc'),Node.js 会直接丢弃最后一位,仅将'ab'转化为 1 字节 Buffer。在处理用户输入或截断数据时,必须确保长度为偶数:const safeHex = hexStr.length % 2 === 0 ? hexStr : '0' + hexStr;。 - 非法字符静默截断:遇到非
0-9a-fA-F字符时,Node.js 会在非法字符处终止解析或跳过,建议在调用前使用正则/^[0-9a-fA-F]*$/提前做前置校验。
四、二进制位(Binary Bits / 01 串)与 Buffer 的快速操作
需要特别注意:在 Node.js 中,'binary' 编码并不是指由 '0' 和 '1' 构成的文本,而是历史遗留下来的 'latin1' 单字节编码别名。如果业务场景需要将数据真正转换为 01 组成的二进制位字符串(例如进行前缀哈希碰撞、掩码比对或物联网硬件接口交互),需要通过逐字节位运算来提取。
1. Buffer 转换为 01 二进制位字符串
/**
 * 将 Buffer 转换为连续的 01 二进制位字符串
 * @param {Buffer} buf
 * @returns {string}
 */
function bufferToBinaryString(buf) {
  const bitParts = [];
  for (let i = 0; i < buf.length; i++) {
    // 将单个字节转为 2 进制,并补齐高位 0 确保每字节占 8 位
    bitParts.push(buf[i].toString(2).padStart(8, '0'));
  }
  return bitParts.join('');
}

const testBuf = Buffer.from('Hi');
console.log('二进制位流:', bufferToBinaryString(testBuf));
// 示例输出: 0100100001101001 (分别对应 'H': 0x48 和 'i': 0x69)
2. 01 二进制位字符串转换为 Buffer
/**
 * 将 01 二进制位字符串转换为 Buffer
 * @param {string} bitStr
 * @returns {Buffer}
 */
function binaryStringToBuffer(bitStr) {
  // 补齐 8 位整倍数
  const remainder = bitStr.length % 8;
  const padded = remainder === 0 ? bitStr : bitStr.padStart(bitStr.length + (8 - remainder), '0');

  const byteCount = padded.length / 8;
  const buf = Buffer.alloc(byteCount);

  for (let i = 0; i < byteCount; i++) {
    const byteChunk = padded.slice(i * 8, (i + 1) * 8);
    buf[i] = parseInt(byteChunk, 2);
  }
  return buf;
}

const bitString = '0100100001101001';
const recoveredBuf = binaryStringToBuffer(bitString);
console.log('还原文本:', recoveredBuf.toString('utf8')); // 示例输出: Hi
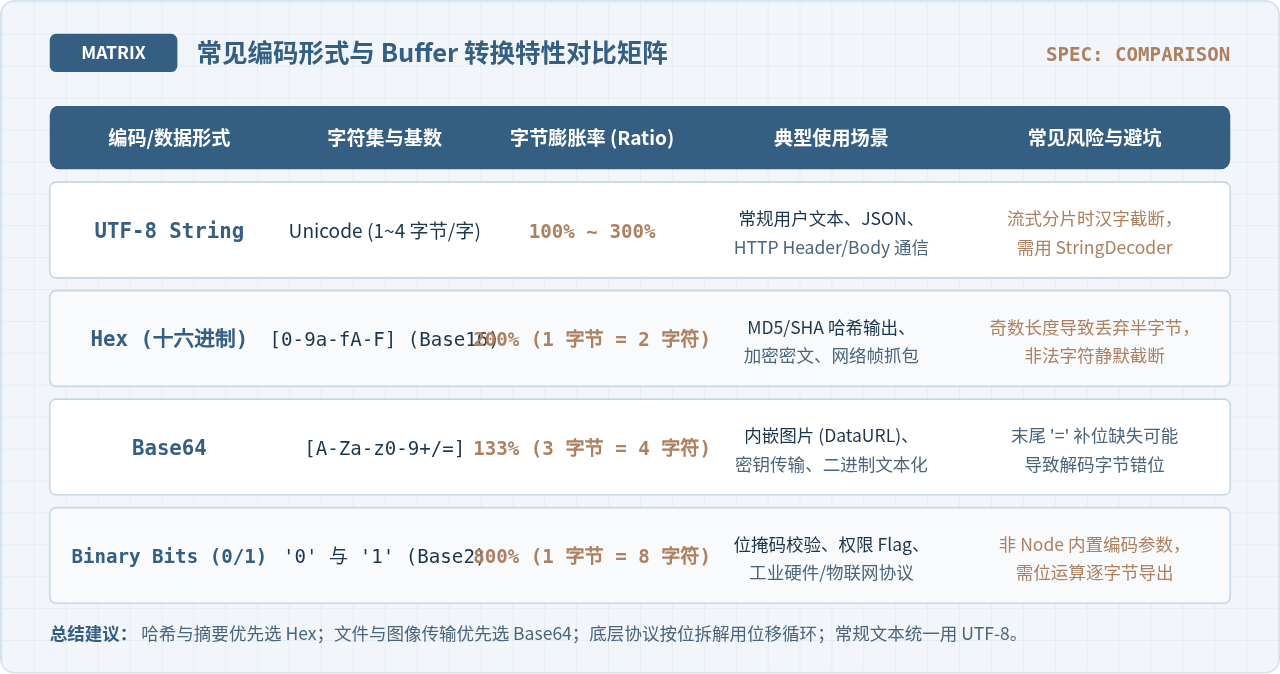
五、生产级端到端实战:全流程转换与防护
在工程实践中,常常需要串联整个链路:用户输入字符串 → 构造 Buffer → 提取 Hex 用于签名/传输 → 提取二进制 Bit 用于位掩码 → 接收端安全解码。下面提供一套具备输入安全校验的完整实现:
// 生产级转换管线封装
class CodecPipeline {
  /**
   * 字符串转 Hex
   */
  static stringToHex(str, encoding = 'utf8') {
    return Buffer.from(str, encoding).toString('hex');
  }

  /**
   * Hex 安全还原为字符串
   */
  static hexToString(hexStr, encoding = 'utf8') {
    if (typeof hexStr !== 'string') throw new TypeError('输入必须为字符串');
    // 清除可能存在的前缀与空白
    let cleanHex = hexStr.replace(/^0x/i, '').replace(/\s+/g, '');
    if (!/^[0-9a-fA-F]*$/.test(cleanHex)) {
      throw new Error('Hex 字符串包含非法十六进制字符');
    }
    // 奇数长度向前补 0 防御
    if (cleanHex.length % 2 !== 0) {
      cleanHex = '0' + cleanHex;
    }
    return Buffer.from(cleanHex, 'hex').toString(encoding);
  }

  /**
   * Hex 转 01 二进制位串
   */
  static hexToBinaryBits(hexStr) {
    const buf = Buffer.from(hexStr, 'hex');
    return Array.from(buf).map(b => b.toString(2).padStart(8, '0')).join('');
  }
}

// 执行测试
const sourceText = 'Buffer快速转换';
const hexResult = CodecPipeline.stringToHex(sourceText);
console.log('[Hex 结果]:', hexResult);

const bitsResult = CodecPipeline.hexToBinaryBits(hexResult);
console.log('[二进制位流前 32 位]:', bitsResult.slice(0, 32));

const restoredText = CodecPipeline.hexToString(hexResult);
console.log('[还原文本]:', restoredText);
console.log('[验证一致性]:', sourceText === restoredText); // 示例输出: true
六、快速决策与自查总结
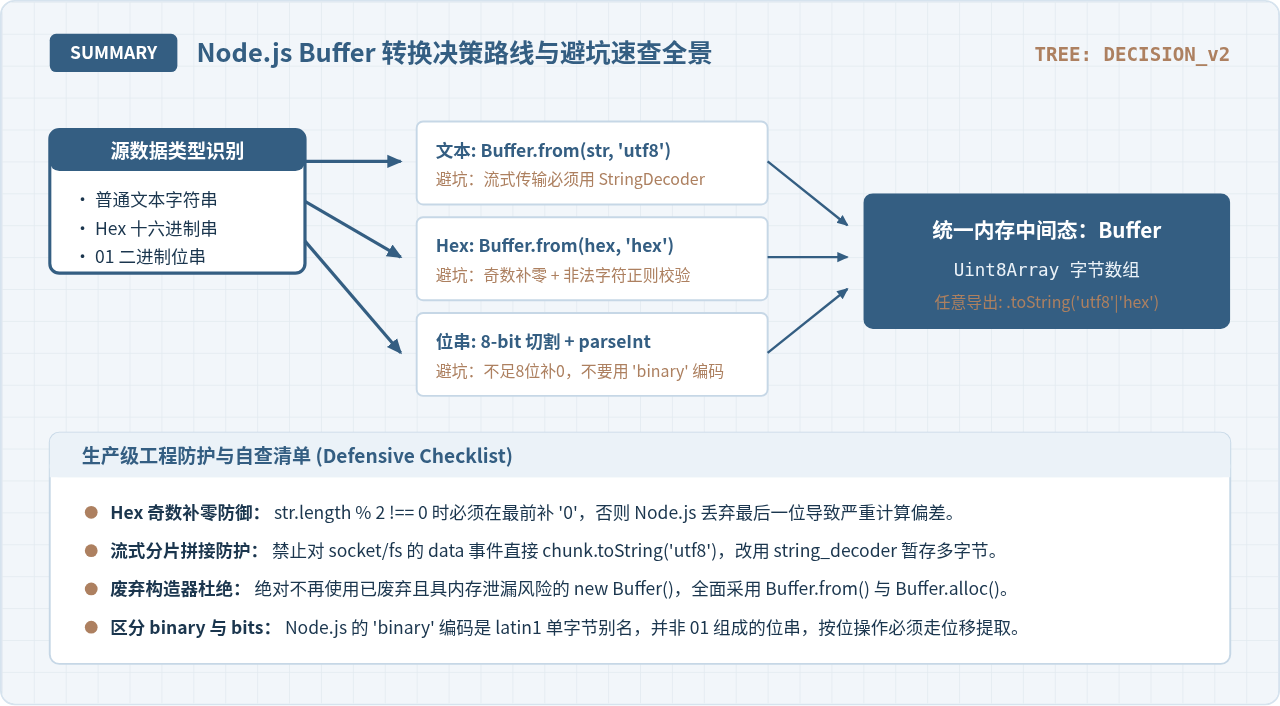
掌握 Node.js Buffer 的转换精髓在于牢记“Buffer 是无偏向的物理内存载体”这一本质,在具体编码实践中,遵循以下三条准则即可确保转换过程高效且健壮:
- 格式导出选择:常规文本解析默认
utf8;加密哈希、网络抓包输出选择hex;小体积二进制媒体内嵌选择base64;硬件位标志按位移提取。 - 输入容错防御:解析外部传入的 Hex 串前,必须进行偶数长度补零与字符集白名单校验,防止底层静默吞字节。
- 流式边界隔离:涉及网络包或大文件流式拼接解码文本时,放弃单块
chunk.toString(),改用标准StringDecoder守护多字节分片边界。
llama.cpp b12457 的 A7 内核为什么要区分后端和模型路径?
2026-11-17 13:36:42
Node.js中怎么使用fast-xml-parser高效解析XML
2026-11-17 08:52:18
Node.js环境使用JS生成Excel并保存至服务器
2026-11-16 13:19:17
在iPhone/iPad上通过iSH安装Node.js的详细步骤
2026-11-12 22:18:40
macOS安装Node.js:pkg安装包与Homebrew命令行的区别
2026-11-12 16:26:58