JavaScript对象封装基础:从字面量到构造函数
深入解析JavaScript中对象封装的基础演进历程,从简单直观的对象字面量,到解决批量创建的工厂函数,再到结合new操作符与原型的构造函数模式,剖析其背后的内存机制与设计考量。
一、对象字面量:最直接的对象声明与简单封装
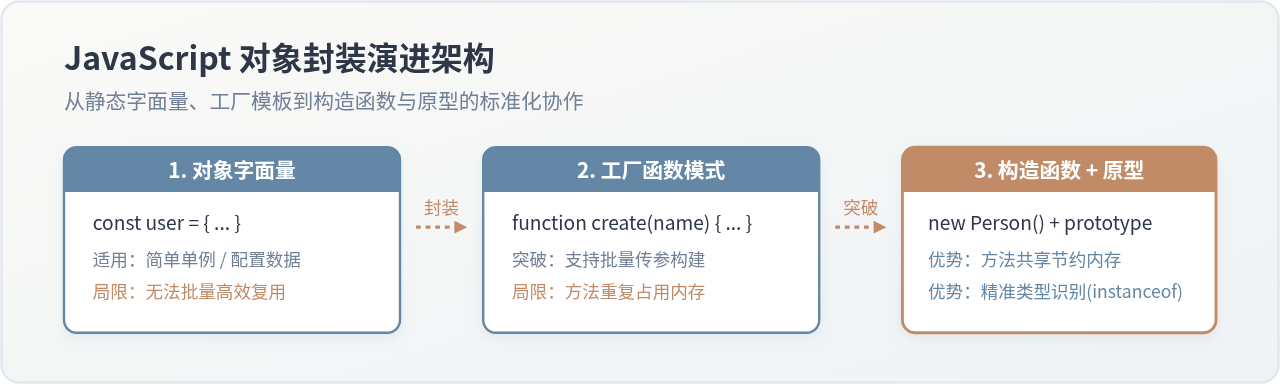
在 JavaScript 中,创建对象最直观、也是语法最简捷的方式就是对象字面量(Object Literal)。通过一对大括号 {},开发者可以直接以键值对的形式组织属性和方法,把一个事物的数据与操作打包在一起。
// 声明一个用户对象
const user = {
  name: '李明',
  age: 24,
  role: '工程师',
  greet: function() {
    console.log(`你好,我是${this.name},职务是${this.role}。`);
  }
};

// 调用属性与方法
console.log(user.name); // 示例输出: 李明
user.greet();          // 示例输出: 你好,我是李明,职务是工程师。
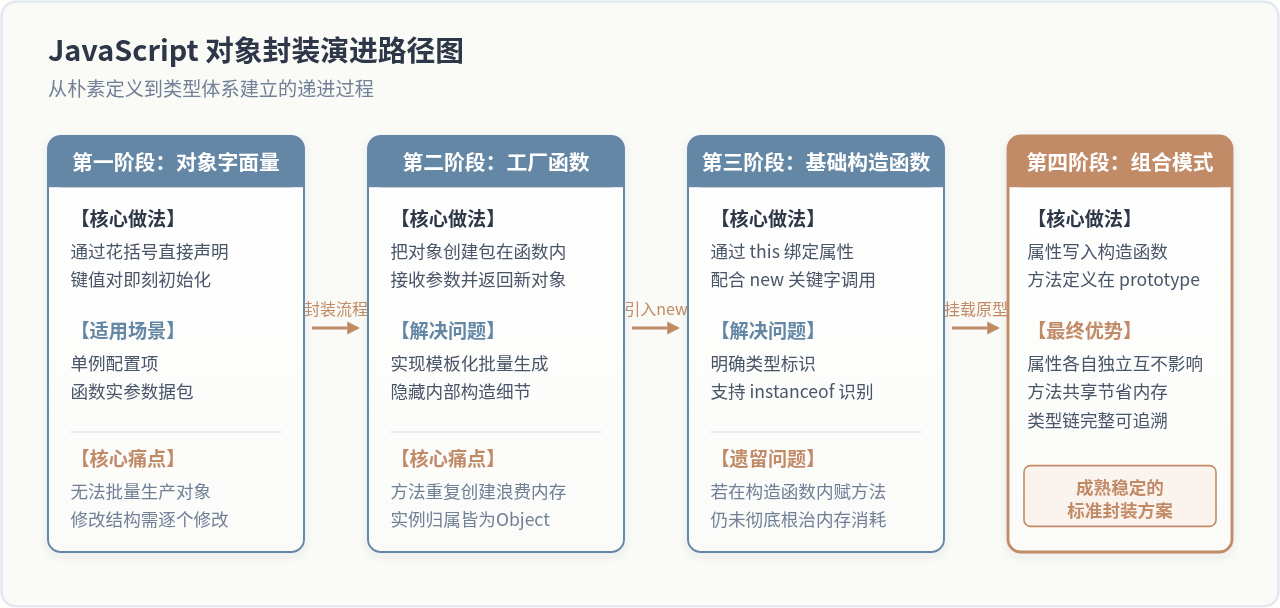
字面量封装具有非常明确的优势:代码紧凑、语法直观、无须预先定义任何模板类或构建逻辑,解析执行极为高效。在配置传参、声明模块常量或单例数据结构时,它是 JavaScript 中最自然的首选。
核心局限:无法批量复用模板
然而,当业务场景需要创建大量同构对象(例如系统中的多个用户、列表中的多个商品)时,对象字面量便暴露出根本性的短板:
- 代码高度冗余:每次创建新对象,都必须完整手写一次属性名和方法体。如果要创建 50 个员工对象,不仅工作量繁琐,代码行数也会成倍膨胀。
- 缺乏修改弹性:一旦需要为该结构补充一个属性或修改一个方法的逻辑,必须遍历并修改每一个对象字面量,极易出现遗漏与不一致。
二、工厂函数:解决批量生产的初步尝试
为了解决对象字面量无法批量复用模板的问题,开发者自然会想到利用函数的形参与返回值机制,将对象的创建过程包裹起来。这种能够源源不断“生产”出相似对象的函数,被称为工厂函数(Factory Function)。
// 定义生产用户对象的工厂函数
function createEmployee(name, age, role) {
  return {
    name: name,
    age: age,
    role: role,
    work: function() {
      console.log(`${this.name} 正在处理业务需求...`);
    }
  };
}

// 批量生产实例
const emp1 = createEmployee('张华', 28, '前端开发');
const emp2 = createEmployee('王磊', 31, '架构师');

emp1.work(); // 示例输出: 张华 正在处理业务需求...
emp2.work(); // 示例输出: 王磊 正在处理业务需求...
工厂函数通过参数化,彻底消除了手工书写重复键名的麻烦,使对象的创建具备了模板化能力。外部使用者只需关心传入什么参数,内部的具体构造逻辑由函数统一管理。
尽管工厂函数解决了批量生产问题,但它留下了两个制约工程规模化的关键问题:
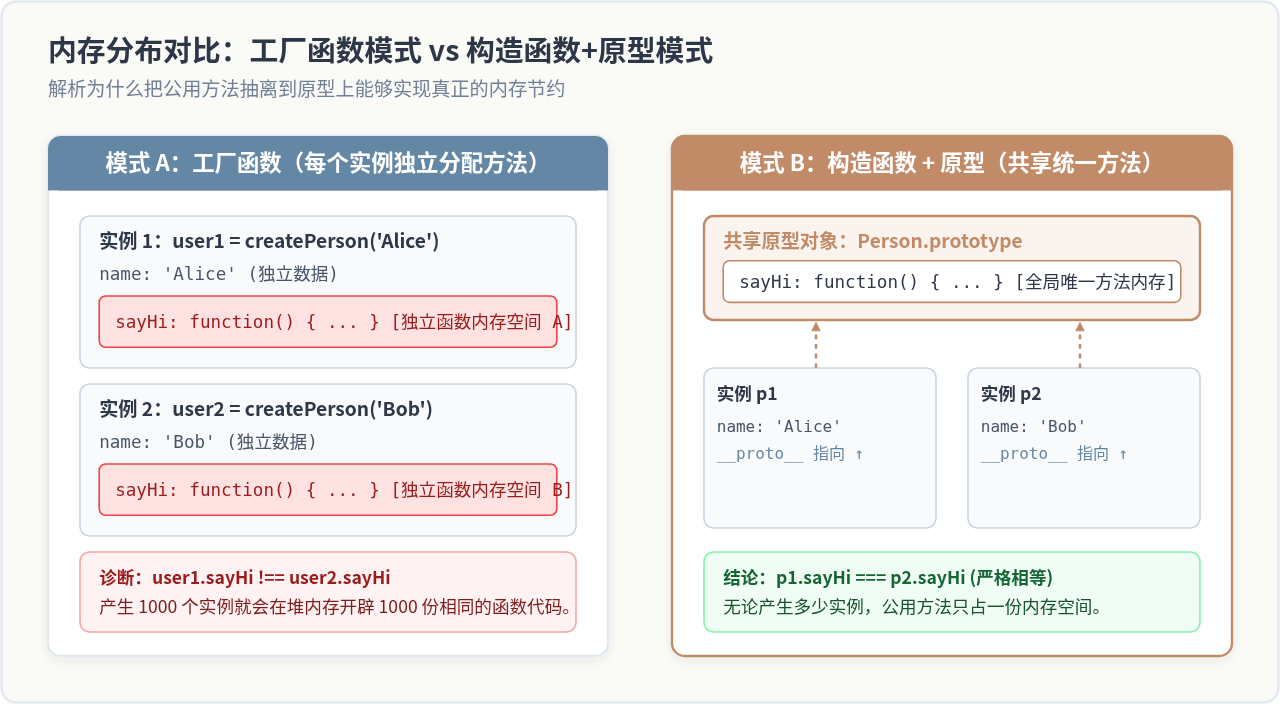
- 方法重复创建带来内存开销:每次调用
createEmployee,内部都会重新定义并分配一个新的work函数。如果有 1000 个员工,内存中就驻留了 1000 个完全相同的函数副本。 - 对象类型识别缺失:工厂函数返回的本质上仍然是一个普通的
Object实例。在代码中通过emp1 instanceof createEmployee进行类型检验时,结果恒为false,无法识别其实际所属的业务类型。
三、构造函数与 new 关键字:建立标准类型与规范调用
针对工厂函数的不足,ECMAScript 规范引入了构造函数(Constructor Function)与 new 操作符。构造函数在语法上仍然是一个普通函数,但在约定与调用方式上具有鲜明特征:
- 命名约定:构造函数函数名通常采用首字母大写(如
Person、Employee),以此与普通工具函数做视觉区分。 - 属性绑定:函数内部不再显式创建对象,而是直接将属性挂载在
this关键字上。 - 无需显式 return:函数体内一般不使用
return语句返回对象,默认会把新生成的实例暴露出来。
// 构造函数定义
function Employee(name, age, role) {
  this.name = name;
  this.age = age;
  this.role = role;
  // 注意:如果在此处直接挂载方法,依然会在每个实例中重复创建
}

// 通过 new 关键字实例化
const emp = new Employee('陈晨', 26, 'UI设计师');

console.log(emp.name);                  // 示例输出: 陈晨
console.log(emp instanceof Employee);   // 示例输出: true (类型识别成功)
console.log(emp.constructor === Employee); // 示例输出: true
new 操作符背后的四步底层机制
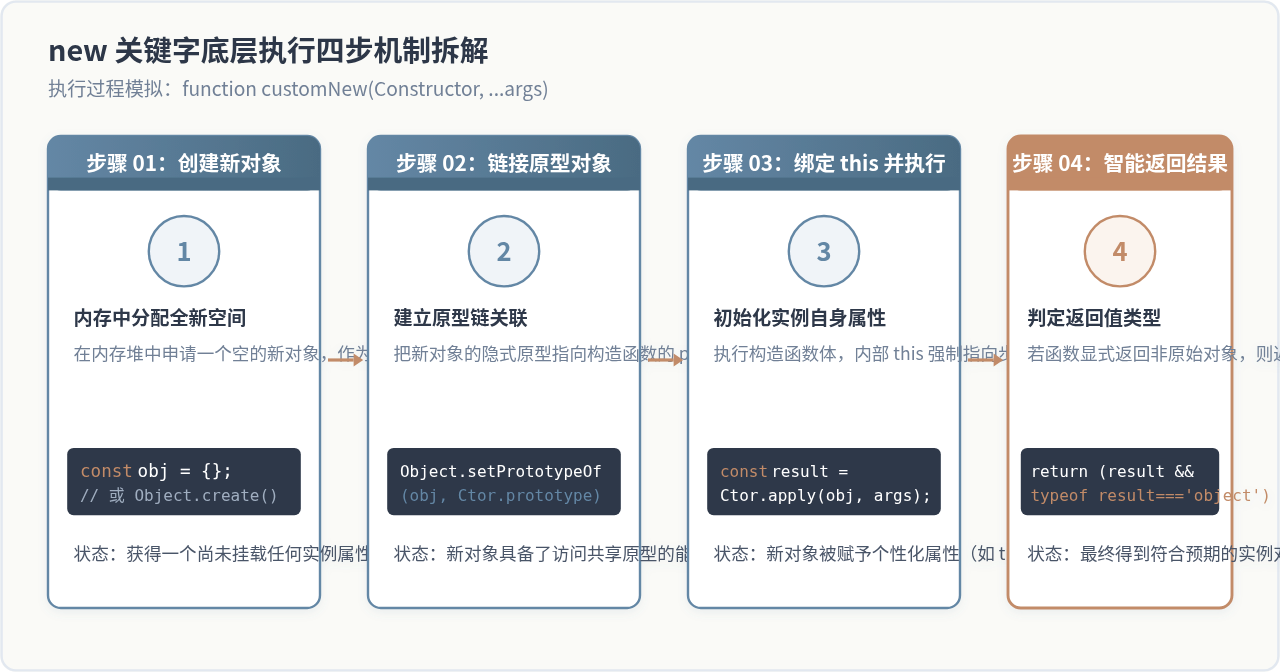
当我们写下 new Employee(...) 时,JavaScript 引擎在底层严格执行了四个连续的操作步骤:
- 创建新对象:在内存堆中开辟一块新的存储空间,创建一个全新的空对象。
- 链接原型:将这个新对象的内部隐藏原型
[[Prototype]](在浏览器中通常表现为__proto__)指向构造函数的prototype属性对象。 - 绑定 this 并执行:调用构造函数,并将构造函数执行上下文中的
this强制指向第一步创建的新对象,随后执行函数体内的赋值逻辑。 - 智能返回实例:检查构造函数的执行结果。如果构造函数显式返回了一个引用类型对象,则返回该对象;否则,自动返回第一步创建的新对象。
四、原型协同:实现方法复用与内存终极优化
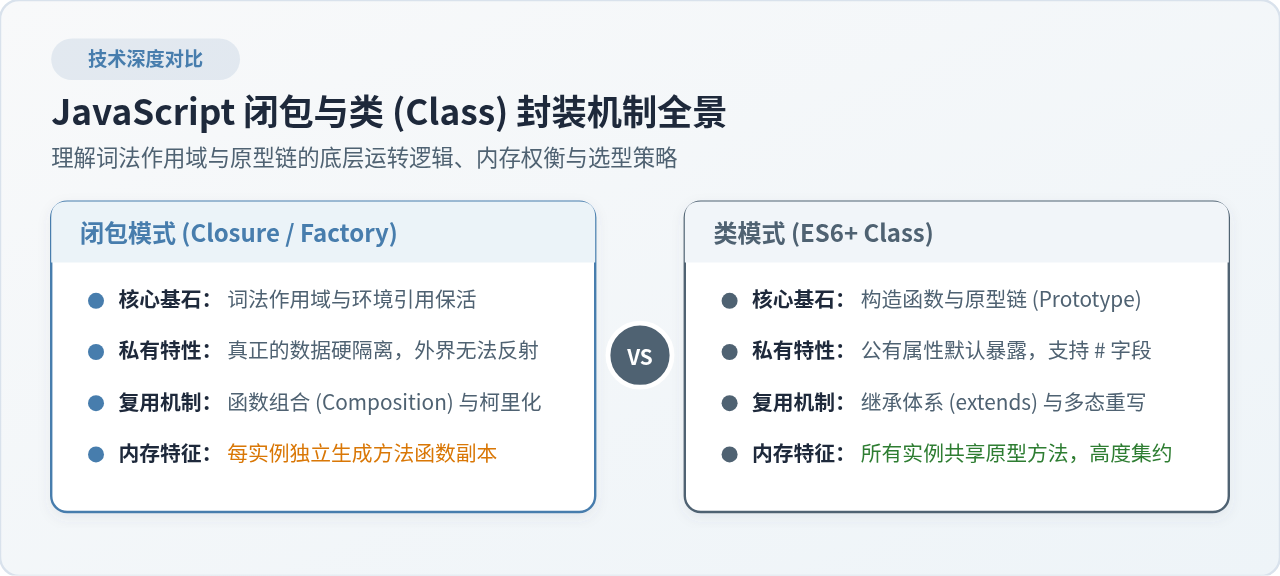
构造函数解决了类型识别问题,但如果直接在构造函数内部写 this.work = function() { ... },那么每次 new 依然会为每个实例单独生成一份函数实例,内存浪费的问题依旧存在。
在 JavaScript 中,每个函数在诞生时都会自动拥有一个名为 prototype 的属性,它指向一个专门存放公共属性和方法的原型对象。所有由该构造函数生成的实例,都会通过原型链共享这个对象上的成员。
// 1. 构造函数内只负责初始化实例特有的数据属性
function Student(name, grade) {
  this.name = name;
  this.grade = grade;
}

// 2. 所有实例共享的方法统一挂载到 prototype 上
Student.prototype.study = function(subject) {
  console.log(`${this.name} 正在认真复习 ${subject}。`);
};

Student.prototype.getInfo = function() {
  return `[学生] ${this.name} - ${this.grade}年级`;
};

// 实例化两个学生
const s1 = new Student('小明', 3);
const s2 = new Student('小红', 3);

// 验证方法是否共享同一个内存地址
console.log(s1.study === s2.study); // 示例输出: true (引用完全相同)

s1.study('JavaScript'); // 示例输出: 小明 正在认真复习 JavaScript。
s2.study('算法导论'); // 示例输出: 小红 正在认真复习 算法导论。这种将构造函数模式与原型模式结合的做法,被称为组合模式。它是现代 JavaScript 面向对象封装(包括 ES6 的 class 语法糖)的底层核心实现。
调用共享方法时 this 是如何正确工作的?
很多初学者会产生疑问:既然 study 方法只在原型上定义了一份,为什么在 s1.study(...) 运行时,函数内部的 this.name 能够准确拿到 小明 而不是 小红 呢?
答案在于 JavaScript 的 this 动态绑定规则:当通过 s1.study() 调用方法时,JavaScript 引擎会在 s1 自身查找 study,发现自身没有,便顺着原型链找到 Student.prototype.study。而在执行该函数时,调用者(点号前面的对象)就是 s1,因此 this 自动指向了 s1。由此兼顾了方法代码仅存一份与运行环境精确独立。
五、工程实践中的注意事项与常见避坑
构造函数本身是普通函数,如果调用时忘记添加 new 关键字,例如 const s = Student('张三', 2);:
- 在非严格模式下,
this会指向全局对象window(或 Node.js 环境下的global),直接污染全局变量。 - 函数因为没有显式返回,
s的值将变成undefined。
防御措施:可以在构造函数顶部使用 new.target 进行防御检测,或者开启严格模式('use strict';)让未绑定的 this 为 undefined 并直接抛错:
function SafeStudent(name, grade) {
  // 防御性判断:若调用者忘记 new,自动补全 new 调用
  if (!new.target) {
    return new SafeStudent(name, grade);
  }
  this.name = name;
  this.grade = grade;
}原型上的属性是所有实例完全共享的。如果把基本数据类型(如数字、字符串)挂在原型上,实例修改时会自动在自身创建“同名遮蔽属性”,不会影响其他实例。但如果把数组或对象等引用类型挂在原型上,任何一个实例修改该引用,都会直接影响所有其他实例!
// 错误示范:在原型上挂载引用类型
Student.prototype.hobbies = [];

const a = new Student('甲', 1);
const b = new Student('乙', 1);

a.hobbies.push('篮球');
console.log(b.hobbies); // 输出: ['篮球']!实例乙的爱好被意外篡改!规范准则:特有数据与引用类型必须定义在构造函数体内(通过 this 声明),只有无需更改状态的纯函数方法才应该挂载在 prototype 上。
六、方案对比与技术选型总结
从字面量、工厂函数到构造函数与原型的演进,体现了 JavaScript 在灵活性与工程化之间的权衡过程。在实际业务开发中,并不是所有场景都要盲目套用构造函数,而应根据数据规模与业务复用性按需选择。
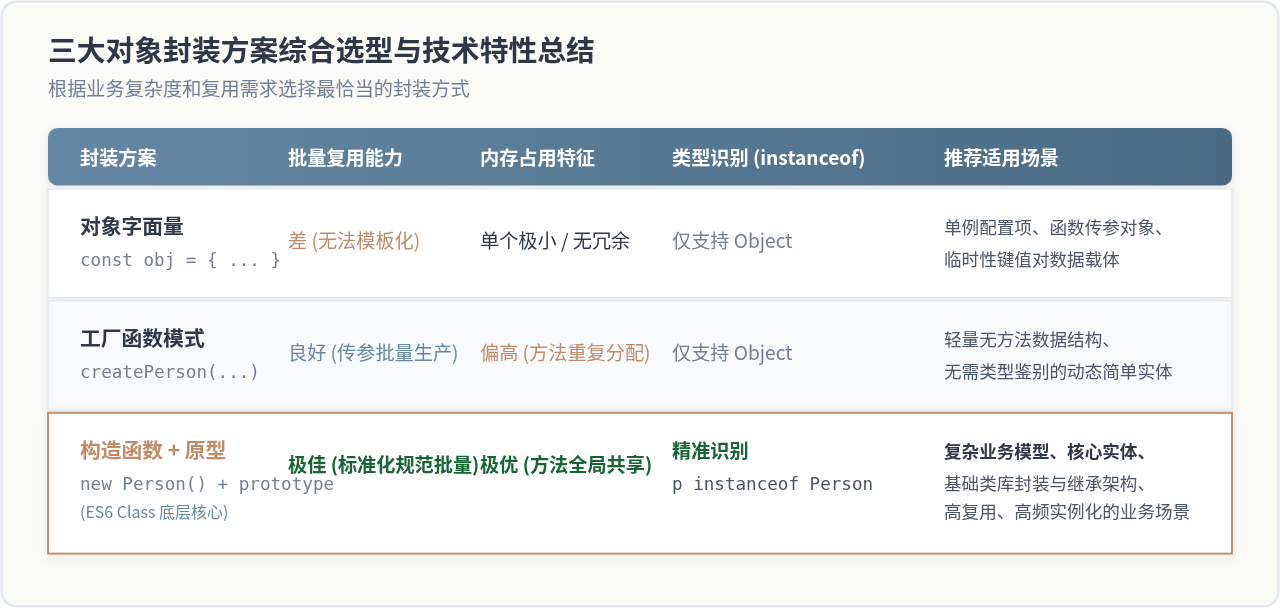
| 方案类型 | 批量复用 | 内存利用率 | 类型追踪 | 典型场景 |
|---|---|---|---|---|
| 对象字面量 | 不可批量复用 | 单例开销极小 | 仅为 Object | 组件配置项、一次性方法参数、Redux Action 等简单数据载体 |
| 工厂函数 | 支持参数化批量生成 | 每次新建方法副本,开销偏高 | 无法识别具体构造器 | 返回轻量数据结构(无方法)、闭包私有变量封装、简单组件创建 |
| 构造函数 + 原型 | 标准化批量实例构建 | 方法公用,内存利用率极高 | 支持 instanceof 精准溯源 | 复杂业务实体、SDK 基础模块、状态模型与多实例系统架构 |
理解从字面量到构造函数再到原型的推导脉络,是掌握 JavaScript 面向对象体系的关键基石。即便在当今广泛采用 ES6 class 语法的时代,底层运行机制依然完全建立在构造函数与 prototype 之上。掌握这一底层原理,不仅能帮助开发者写出更高效、健壮的代码,还能在排查深层原型链故障与性能瓶颈时游刃有余。
为什么if(obj)无法判断JS空对象
2026-11-17 16:14:05
JavaScript怎么使用class关键字定义类
2026-11-17 15:57:28
JS防水砂浆是什么?成分解析与适用场景
2026-11-17 14:18:55
ES6解构赋值中怎么根据变量名动态获取JS对象属性
2026-11-17 11:45:55
JavaScript计算阶乘的5种实现:递归、循环与reduce
2026-11-17 09:22:23