ts字符串转数组泛型写法
深入讲解 TypeScript 中字符串转数组(元组)的泛型写法,包含单字符逐字拆分、指定分隔符拆分、尾递归累加器优化、宽类型防御及常见认知误区解析。
str.split() 调用,而是利用模版字面量类型(Template Literal Types)与条件类型推断(infer),在编译期将字符串字面量解析为保持精确项数与字面量信息的元组(Tuple)类型。本文将系统拆解单字符逐字拆分、指定分隔符拆分两种核心写法,剖析编译器递归上限及尾调用优化机制,并给出防御宽类型与边界空项的工业级完整实现。
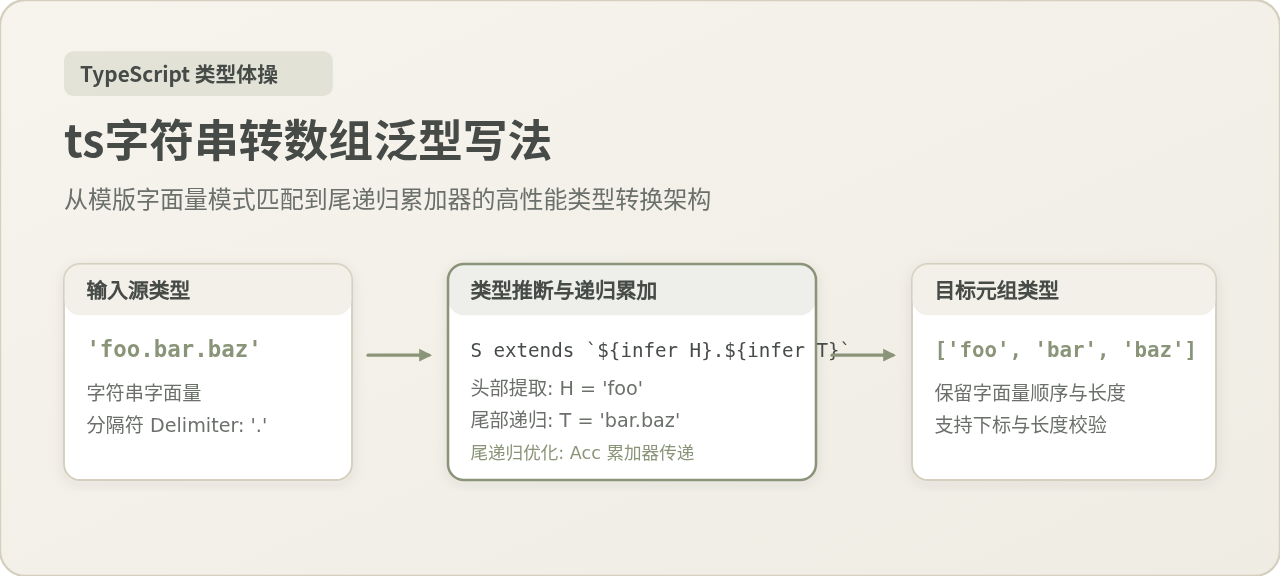
一、为什么是“元组”而不是普通数组?
在 JavaScript 运行时中,"a,b".split(",") 会得到一个普通的数组 ["a", "b"]。但在 TypeScript 的类型系统里,若泛型简单返回 string[],所有的字面量约束、元素排列顺序和元组长度信息都将丢失。
我们之所以在类型层需要“字符串转数组”泛型,通常是为了实现更严密的类型推导:例如根据路由路径 /users/:id/posts/:postId 解析出各个路径参数名,或者解析 CSV 结构字面量。因此,泛型的目标是产出定长字面量元组(如 ['foo', 'bar', 'baz']),而非宽泛的 string[]。
二、模式匹配基石:模版字面量与 infer
自 TypeScript 4.1 引入模版字面量类型后,条件类型中的 infer 关键字具备了从字符串字面量中捕获子串的能力。
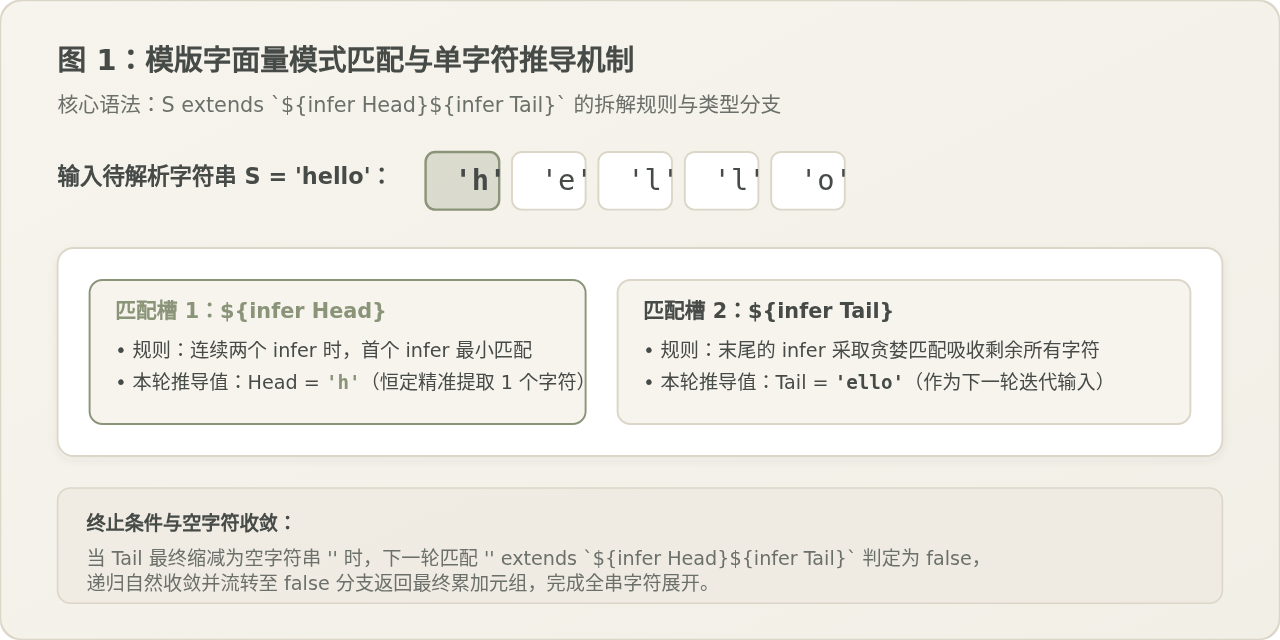
最基础的核心语法模式为:S extends `${infer Head}${infer Tail}`。理解该模式的关键在于 TypeScript 对连续推断变量的分配原则:
- 首个变量(Head)的非贪婪性:当两个
infer变量直接相连时,前面的Head总是固定匹配单个字符。 - 末尾变量(Tail)的贪婪性:紧随其后的
Tail会吸纳剩余的所有字符。如果输入串只有一个字符,Tail将被推断为空字符串''。
三、写法一:字符串逐字拆分(StringToChars)
将字符串 'hello' 拆分为单字符元组 ['h', 'e', 'l', 'l', 'o'],可以通过递归提取首字符并将剩余部分继续传入自身来实现。
1. 基础递归实现
type StringToCharsNaive<S extends string> =
  S extends `${infer Head}${infer Tail}`
    ? [Head, ...StringToCharsNaive<Tail>]
    : [];

// 验证测试
type Result1 = StringToCharsNaive<'ts'>; // ['t', 's']
type ResultEmpty = StringToCharsNaive<''>; // []
上述写法在处理短字符串时清晰明了,但 [Head, ...StringToCharsNaive<Tail>] 在条件类型的返回分支中进行了展开操作。TypeScript 编译器必须维护每一层递归的调用栈,当输入字符串长度超过约 45~50 个字符时,就会触发编译报错:Type instantiation is excessively deep and possibly infinite.
2. 工业级推荐:尾递归累加器模式(Accumulator)
TypeScript 4.5 引入了条件类型尾递归优化(Tail-call Recursion Optimization)。只要递归调用发生在最外层的直接泛型实例化位置,且无需在外层对结果进行包装,TypeScript 编译器便会将递归转为扁平循环,将栈深度上限提升至约 1000 级。
type StringToChars<
  S extends string,
  Acc extends string[] = []
> = S extends `${infer Head}${infer Tail}`
  ? StringToChars<Tail, [...Acc, Head]>
  : Acc;

// 验证长字符串
type LongStr = 'abcdefghijklmnopqrstuvwxyz0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZ';
type LongResult = StringToChars<LongStr>; // 正常编译,正确返回 62 项字符元组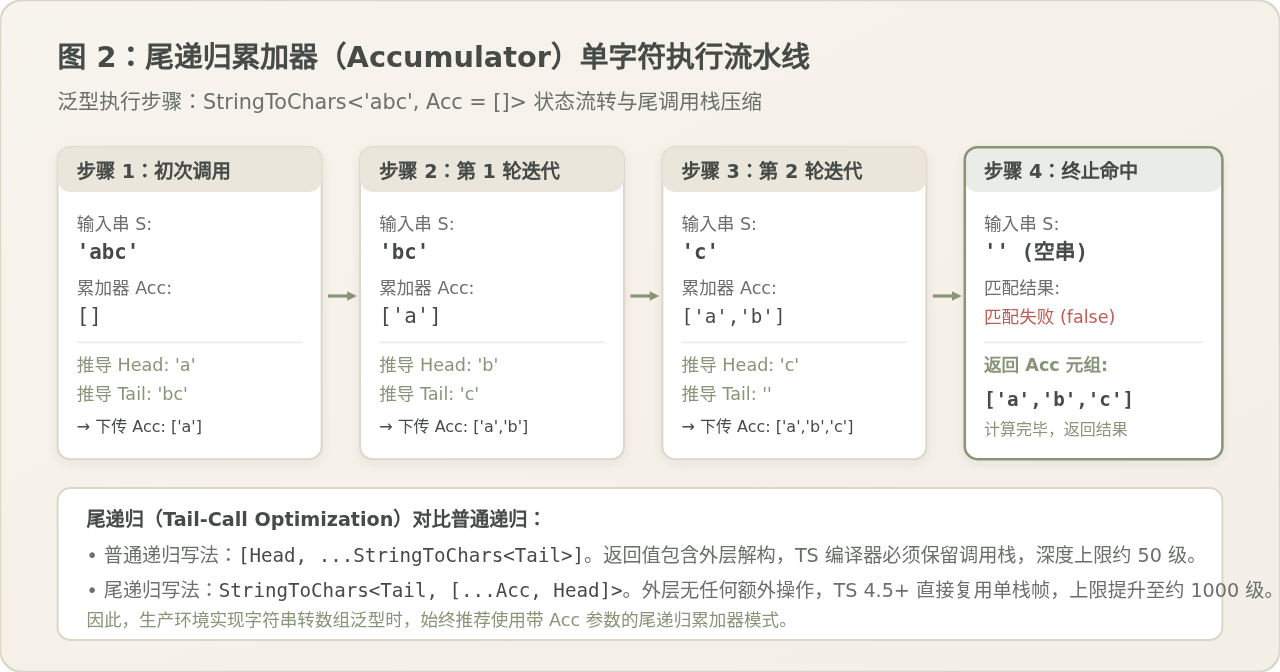
四、写法二:指定分隔符切分(Split<S, Delimiter>)
更常见的场景是按照固定字符(如逗号 ,、斜杠 / 或句点 .)对字符串进行分割。
1. 核心模式匹配表达式
当存在明确的分隔符 Delimiter 时,模版匹配结构应写为:S extends `${infer Head}${Delimiter}${infer Tail}`。TypeScript 会以 Delimiter 为锚点,在首次出现该分隔符处将字符串切分为前后两块。
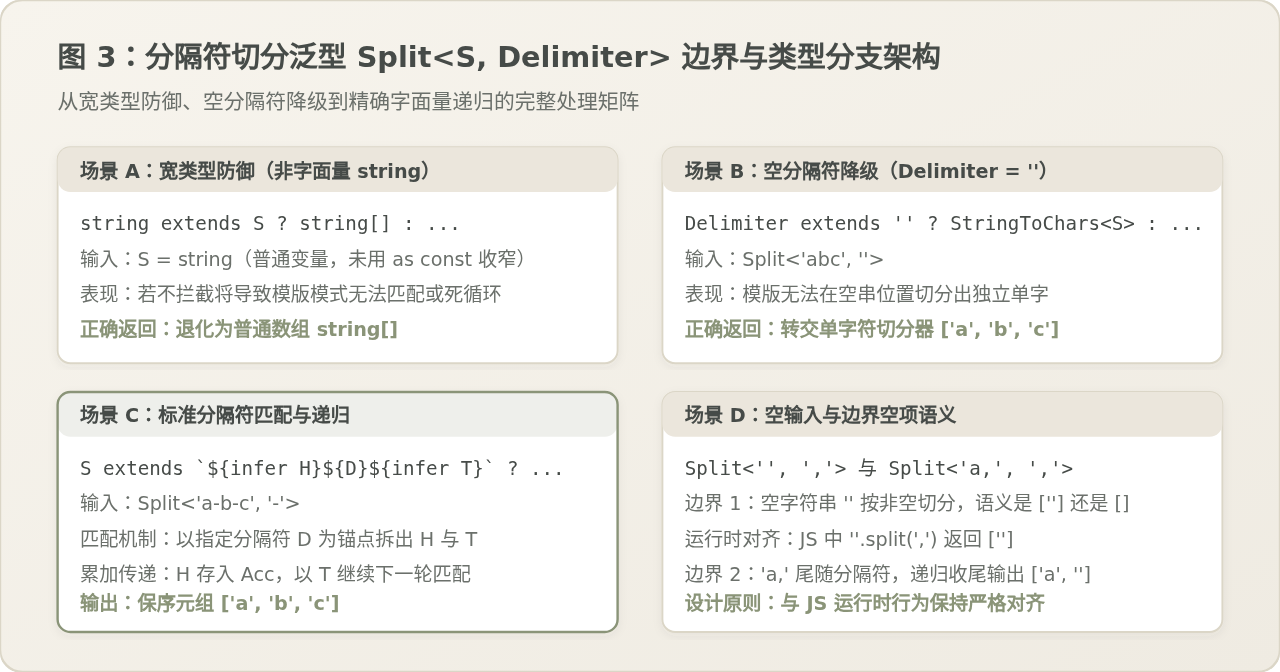
2. 必须处理的四类边界条件
- 宽类型(Wide string)防御:若传入未收窄的
string变量,string extends `${infer H}${D}${infer T}`会发生异常推导甚至陷入类型死循环。必须显式判断string extends S并直接返回string[]。 - 空分隔符(Delimiter = ''):如果分隔符传入空串,
`${infer H}${''}${infer T}`无法正常工作,应平滑转接至上文实现的StringToChars<S>。 - 无匹配分隔符:当输入串中不再包含分隔符时,说明已到达最后一节,应将当前剩余字符串并入累加器。
- 空输入串(S = ''):与 JavaScript 运行时的
"".split(",")行为保持一致,若原串为空,返回[""];若同时分隔符也为空,返回[]。
3. 工业级 Split 完整实现
结合尾递归累加器与全部边界处理,完整的类型实现如下:
/**
 * 将字符串 S 按照指定 Delimiter 切分为元组
 */
export type Split<
  S extends string,
  Delimiter extends string = '',
  Acc extends string[] = []
> =
  // 1. 宽类型 string 防御:非字面量时返回 string[]
  string extends S
    ? string[]
    : // 2. 空分隔符时转交单字符切分器
      Delimiter extends ''
        ? StringToChars<S>
        : // 3. 递归寻找分隔符
          S extends `${infer Head}${Delimiter}${infer Tail}`
            ? Split<Tail, Delimiter, [...Acc, Head]>
            : // 4. 递归收尾:将末尾子串推入 Acc
              [...Acc, S];
4. 执行效果与验证示例
// 基础点号切分
type Case1 = Split<'foo.bar.baz', '.'>;
// 结果:['foo', 'bar', 'baz']

// 多字符分隔符
type Case2 = Split<'item1::item2::item3', '::'>;
// 结果:['item1', 'item2', 'item3']

// 默认空分隔符
type Case3 = Split<'typescript'>;
// 结果:['t', 'y', 'p', 'e', 's', 'c', 'r', 'i', 'p', 't']

// 连续分隔符与尾部保留
type Case4 = Split<'a,,b,', ','>;
// 结果:['a', '', 'b', '']

// 宽类型安全兜底
type Case5 = Split<string, ','>;
// 结果:string[] (避免了类型死循环报错)
五、容易混淆的常见说法辨析
1. 辨析一:“字符串本身有 length 和索引,直接通过 keyof 或下标就能转数组”
分析:在 TypeScript 中,如果声明 type Chars = S[number],得到的并不是保序的元组,而是一个字符的联合类型(Union),例如 'a' | 'b' | 'c'。更严重的是,keyof "abc" 还会包含 "charAt" | "indexOf" | "slice" 等字符串原生原型方法的属性名。联合类型本身是无序且去重的,无法还原字符串在位置上的先后关系,更无法表达数组长度。因此,只有通过递归模式匹配才能构造出保留索引信息的有序元组。
2. 辨析二:“TS 4.5 之后不用累加器也可以随便写递归”
分析:这是一个常见的误解。TypeScript 4.5 针对的仅是尾调用形式(Tail recursion)的条件类型。若返回值写成 [Head, ...Split<Tail, Delimiter>],解构操作是在当前层完成的,属于非尾调用,编译器依然受到 ~50 层堆栈的限制。只有严格将结果向下传给 Acc 参数、使最外层返回值完全等于递归调用本身,尾调用优化才会生效。
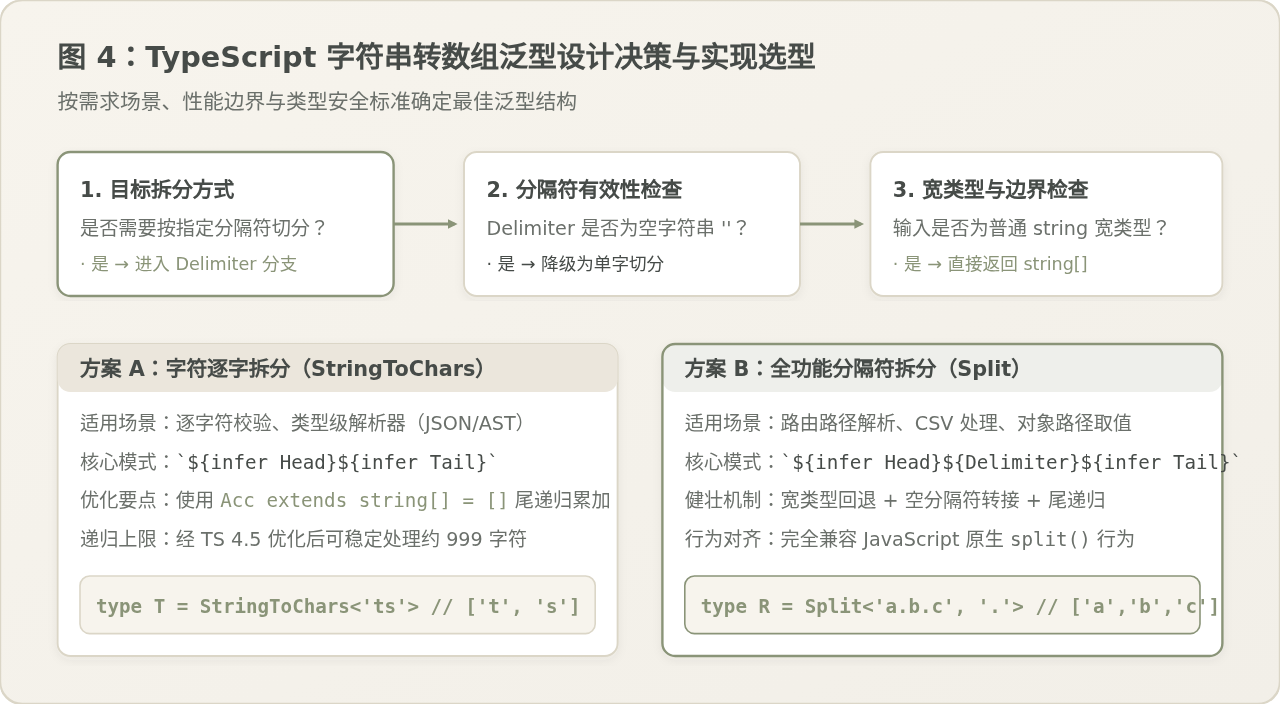
六、方案对比与选型指南
| 方案类型 | 核心匹配模式 | 递归机制 | 单次解析字符上限 | 典型适用场景 |
|---|---|---|---|---|
| 朴素单字拆分 | `${infer H}${infer T}` |
返回值展开 [H, ...R] |
约 45 字符 | 短常量代码、简单枚举拆解 |
| 尾递归单字拆分 | `${infer H}${infer T}` |
累加器 [...Acc, H] |
约 999 字符 | 词法分析器、语法树(AST)解析 |
| 工业级 Split | `${infer H}${D}${infer T}` |
尾递归累加器 + 宽类型防护 | 约 999 分隔段 | 路由路径解析、配置键打平、CSV 转化 |
在实际工程中,建议将上文中的 Split 封装至基础类型工具库中。通过合理设置默认参数 Delimiter = '' 与 Acc = [],即可在单一泛型中同时兼顾单字符切分与自定义分隔符切分两种需求,为各类类型级解析提供可靠的底层支撑。
js字符串matchAll转数组所有匹配
2026-11-13 16:27:09
js字符串转数组ES2024isWellFormed修复乱码
2026-11-13 13:56:24
js字符串转数组避免中间数组IteratorES2025
2026-11-13 13:22:25
ts字符串怎么转数组类型标注
2026-11-13 12:52:17
ts字符串转数组和元组tuple区别
2026-11-13 12:00:29