ts字符串转数组和元组tuple区别
深入解析TypeScript中字符串转普通数组与转元组(Tuple)的核心区别。涵盖类型契约、运行时安全转换步骤、编译期模板字面量递归推导与实际技术选型依据。
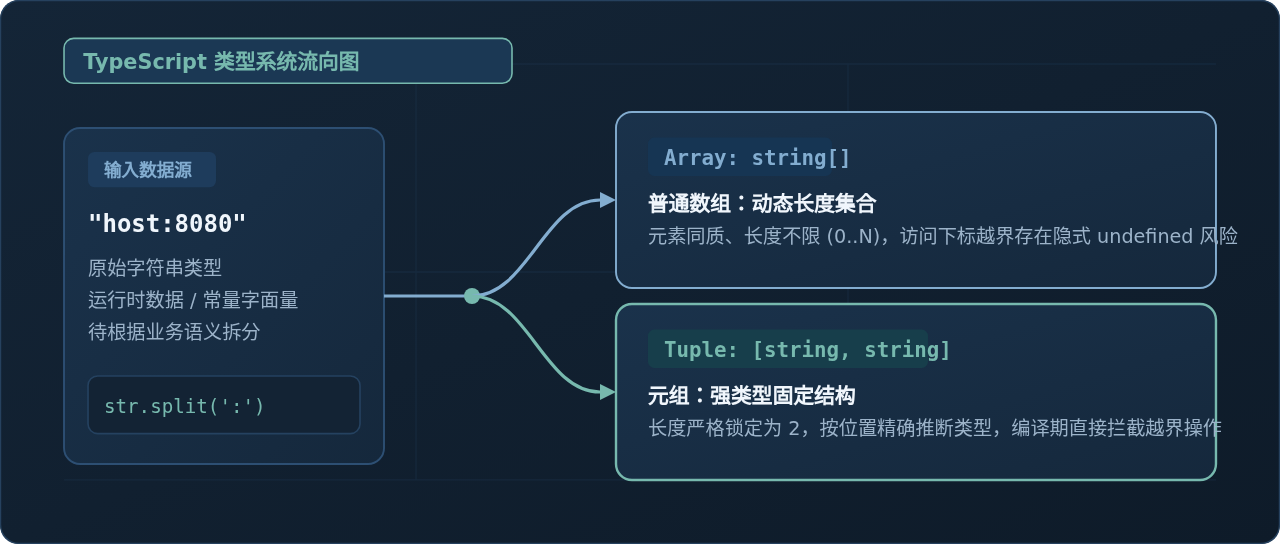
在日常业务开发中,我们常常需要从外部数据源接收复合格式的字符串并进行分解。例如从 URL 查询参数解析坐标 "120.15,30.28"、从环境变量读取服务端口配置 "0.0.0.0:8080",或者从服务端接口拉取用逗号分隔的多标签文本 "ts,frontend,web"。在 JavaScript 中,开发者通常调用 str.split() 即可直接得到一个数组;然而在 TypeScript 的严密类型体系中,切分出的结果是应该被定义为普通数组(Array / string[]),还是被限定为元组(Tuple / [string, string]),会直接决定代码在编译期的类型安全保障与智能提示质量。
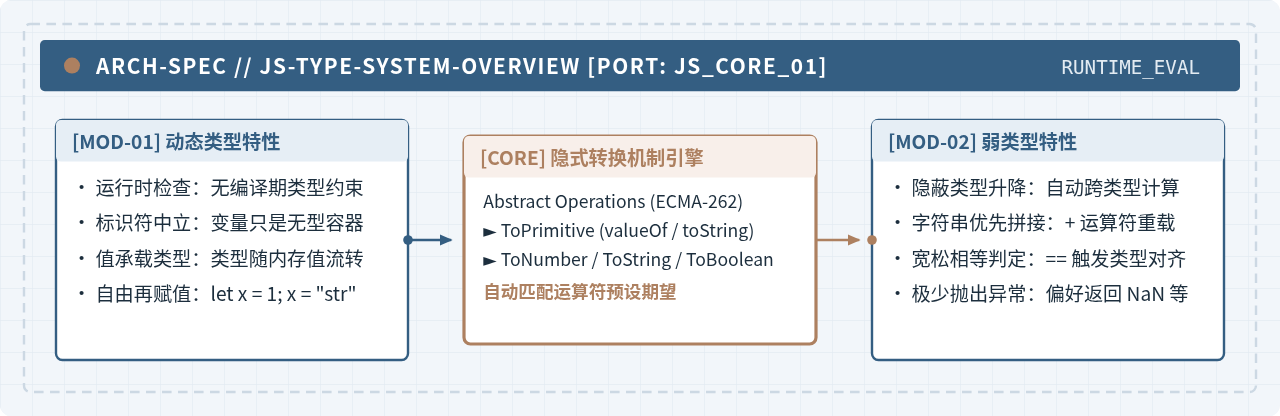
核心答案与本质差异:在 JavaScript 运行期,无论是普通数组还是元组,底层的运行载体没有任何区别,都是标准的 JavaScript Array 实例对象。二者的核心鸿沟存在于 TypeScript 的静态类型契约中:普通数组 string[] 代表的是长度未知、元素类型同质的集合容器,编译器在静态分析时无法保证某一下标必定存在;而元组 [string, string] 则代表了长度固定、各索引位置具备特定类型声明的严格数据契约,不仅禁止越界访问,还能与解构赋值、固定参数列表无缝结合。
一、核心定义与类型契约深度对比
为了透彻理解为什么同样是拆分字符串会产生不同的结果,我们首先需要在 TypeScript 类型系统内部审视 string[] 与 [string, string] 的底层差异。
在 TypeScript 的类型定义中,普通数组类型的接口声明具有开放的数字索引签名:[n: number]: string,并且其 length 属性的类型就是宽泛的 number。这意味着对于编译器而言,数组可能包含 0 个、2 个,也可能是 1000 个元素。
相比之下,元组在类型层面上为每一个索引位分配了显式的属性。例如类型 [string, number],在编译期被赋予了专属的类型约束:索引 0 为 string,索引 1 为 number,其 length 属性不再是普通的 number,而是数值字面量 2。
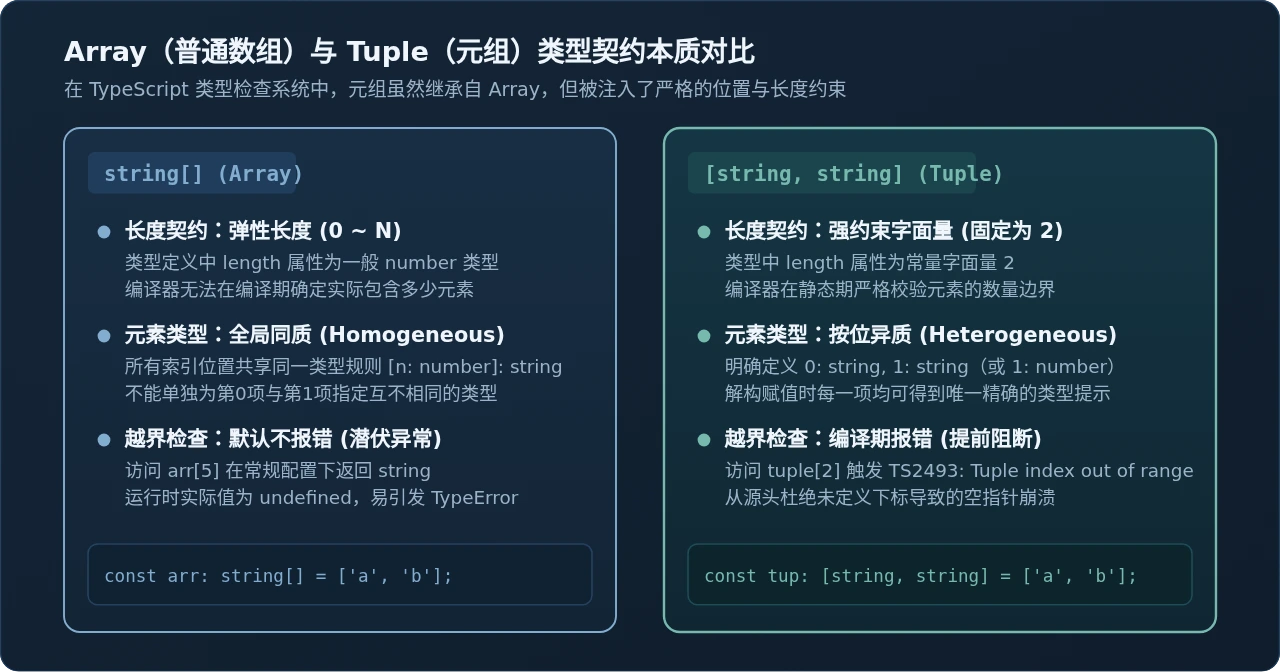
通过下表可以直观对比二者在类型检查层面的关键差异:
| 对比维度 | 普通数组(string[]) | 元组([string, string]) |
|---|---|---|
| 长度属性(length) | 宽泛的 number,未知动态范围 |
严格的字面量常数(如 2) |
| 元素类型(Elements) | 同质约束(所有项均为 string) | 异质支持(不同下标可独立声明类型) |
| 越界访问检查 | 默认配置下推断为 string,运行时返回 undefined | 编译期直接报错(TS2493: Tuple index out of range) |
| 解构赋值体验 | 各变量类型为 string(存在未定义隐患) | 各变量精确推导,编译器保证每一项必然存在 |
| 函数参数展开 | 无法直接传给固定形参函数 fn(a, b) |
可直接通过展开语法 fn(...tuple) 安全传参 |
二、运行时:字符串转数组与转元组的操作差异
假设我们需要解析形如 "theme:dark" 的键值配置。如果直接使用标准的 split 方法并尝试赋值给元组类型:
const rawConfig = "theme:dark";

// 1. 转普通数组:顺利通过类型检查
const arr: string[] = rawConfig.split(":");

// 2. 直接赋值给元组:编译期直接报错!
// TS2322: Type 'string[]' is not assignable to type '[string, string]'.
// Target requires 2 element(s) but source may have any number.
const tuple: [string, string] = rawConfig.split(":");
TypeScript 之所以阻止这种直接赋值,是因为 split() 在 JavaScript 运行时的行为是不可预测的。如果传入的字符串是 "theme"(没有冒号),切分出来的数组长度只有 1;如果传入 "a:b:c",切分长度则是 3。如果编译器允许直接把 string[] 当作 [string, string] 使用,后续代码执行 tuple[1].toLowerCase() 时就可能在运行时引发经典的 TypeError: Cannot read properties of undefined 崩溃。
安全转换为元组的标准操作步骤
要在运行时把不可控的字符串安全转换为高契约的元组,正确的做法是结合运行时校验与自定义类型守卫(User-Defined Type Guard),在确保数据长度符合预期的前提下实现类型收窄。
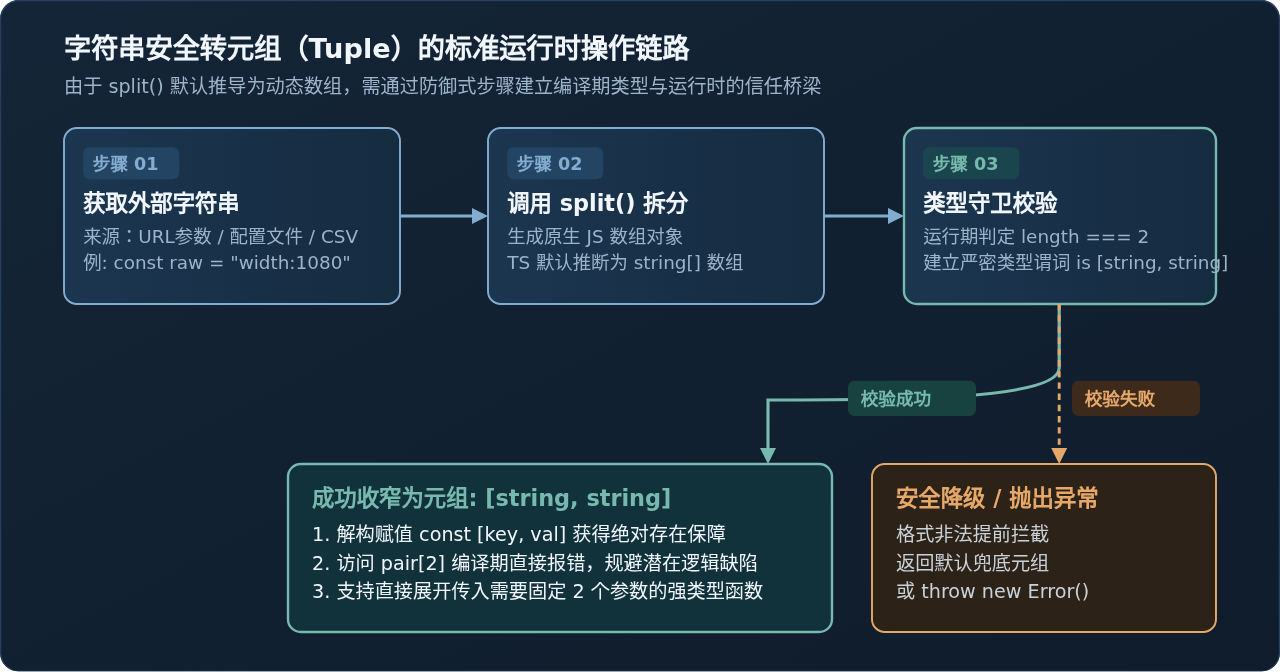
以下是经过工程化验证的防御式转换代码示例:
// 定义类型谓词:明确声明输入是否满足二元元组结构
function isPair(items: string[]): items is [string, string] {
  return items.length === 2;
}

// 安全转换解析函数
function parseKeyValue(raw: string): [string, string] {
  const parts = raw.split(":");

  if (isPair(parts)) {
    // 在此分支内,parts 的类型已由 string[] 收窄为 [string, string]
    return parts;
  }

  // 防御性异常处理或返回默认安全元组
  throw new Error(`配置字符串格式非法,期望包含一个冒号,实际接收: "${raw}"`);
}

// 使用场景验证
const [key, value] = parseKeyValue("status:active");
console.log(key.toUpperCase(), value.toUpperCase());初学者常常为了省事使用
raw.split(":") as [string, string] 强制绕过编译器检查。类型断言只是对编译器的单方面承诺,并不具备任何运行时校验效果。如果外部输入不符合格式,后续针对第二项的操作依然会引发难以排查的线上 Bug。
三、编译期:字符串字面量转元组的类型体操
上述讨论针对的是运行时的动态字符串。但在现代 TypeScript 开发中(如构建高阶类型、路由路径参数推导、SQL/GraphQL 语句分析),我们经常面对的是已知的常量字符串字面量类型,例如 "GET /api/v1/users"。
利用 TypeScript 4.1 引入的模板字面量类型(Template Literal Types)与递归条件类型推断(Recursive Conditional Types with infer),我们完全可以在编译期不编写任何 JavaScript 运行逻辑,纯靠类型系统将字符串类型切分为字面量元组类型。
// 纯类型层面的 Split 工具类型:递归推导切分
type Split<
  S extends string,
  Delimiter extends string
> = S extends `${infer Head}${Delimiter}${infer Tail}`
  ? [Head, ...Split<Tail, Delimiter>]
  : S extends ""
  ? []
  : [S];

// 1. 切分为定长字符串字面量元组
type PathTuple = Split<"api/v1/users/info", "/">;
// 推导结果为: ["api", "v1", "users", "info"]
// 其 length 属性精确为 4!

// 2. 对比普通数组类型
type GeneralArray = string[];
// 普通数组无法保留 "api"、"v1" 等精确字符定义,更无法锁定长度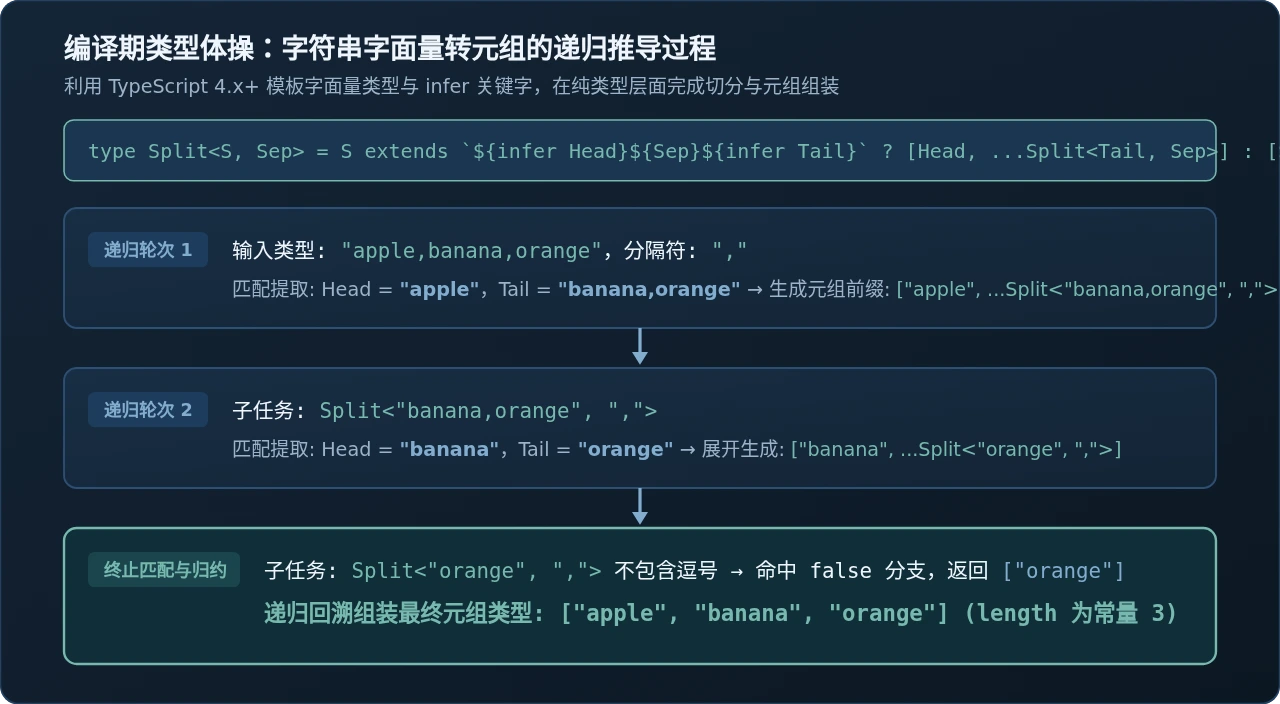
为什么编译期推导出元组如此重要?
因为只有推导为元组类型,TypeScript 才能保留每个位置的字面量特征与精确的元素计数。例如在前端框架开发动态路由系统时,根据 "/user/:id/posts/:postId" 提取参数名列表,如果返回普通数组,编译器就无法检查组件传参是否漏掉了 postId;唯有返回精确的元组类型 ["id", "postId"],才能在静态阶段实现 100% 的形参完整性校验。
四、关键行为差异:可变性与解构保护
在日常编码实践中,数组与元组在与常用 API 配合时表现出显著的差异,需要开发者重点注意以下两处特性:
1. 原生数组变异方法(push/pop)的陷阱
由于 TypeScript 的元组底层在 JavaScript 运行时依旧是 Array 实例,默认情况下元组实例上依然存在 push()、pop() 等改变长度的原生方法。
const point: [number, number] = [100, 200];
point.push(300); // 编译器不报错,但元组实际长度被破坏变成了 3!
为了杜绝这种运行时对契约的隐式破坏,在定义不应被变动的元组时,建议始终搭配 readonly 修饰符:
const strictPoint: readonly [number, number] = [100, 200];
// strictPoint.push(300); // 编译期直接拦截: Property 'push' does not exist on type 'readonly [number, number]'
2. 开启 noUncheckedIndexedAccess 后的不同影响
在 tsconfig.json 中启用 "noUncheckedIndexedAccess": true 是提高代码健壮性的现代标准配置。此时二者的差异尤为鲜明:
- 对于普通数组
const arr: string[] = ["a", "b"];,访问arr[0]的推导类型会变成string | undefined,强制要求开发者在使用前处理可能为空的分支。 - 对于元组
const tup: [string, string] = ["a", "b"];,访问声明范围内的tup[0]和tup[1]仍然精确保持为纯string,无需多余的判空代码;而访问tup[2]会直接产生编译期报错。
五、全景决策树与总结
在实际项目重构或新特性开发中,面对一段待拆分的字符串,可以通过以下决策链路快速决定使用普通数组还是元组:
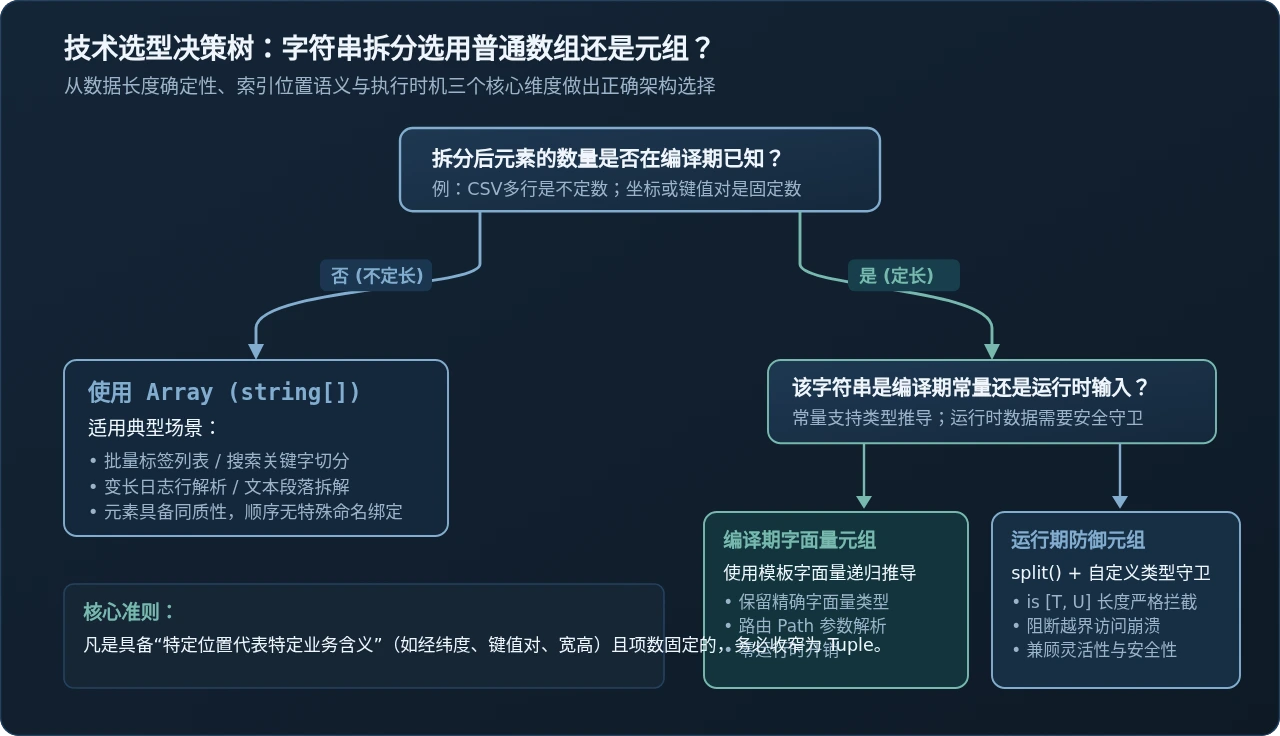
选型决策总结指南:
-
选择普通数组(Array /
string[])的场景: 拆分后的元素个数由用户输入或外部长列表动态决定(如 CSV 逐行拆分、搜索词空格切分、博客标签列表);数组内所有项在业务逻辑中具有等价的地位,不需要根据特定下标赋予不同含义。 -
选择元组(Tuple /
[T, U])的场景: 拆分项具有强位置语义与固定项数。例如"IP:PORT"(第0项是主机名,第1项是端口号)、"lat,lng"(经纬度坐标)、"key=value"(环境变量对)、React Hook 风格的状态配对返回值等。 -
生产环境规范:
从动态外部源转换元组时,务必编写如
isPair这类的类型守卫函数完成长度校验后再收窄;对于无需追加改动的元组数据,优先添加readonly关键字加固类型防线。
为什么 JavaScript 负数向下取整结果是 -4 而不是 -3?
2026-11-13 08:07:40
JavaScript Math.round()四舍五入取整基础用法
2026-11-12 18:48:07
JavaScript ES6新增字符串方法详解:includes、padStart等
2026-11-12 18:33:11
JS封装兼容浏览器与Node的字符串转Hex函数
2026-11-12 16:33:15
JS中设置length=0清空数组与重新赋值的区别
2026-11-12 14:46:01