js字符串转数组URL编码decodeURIComponent
深入解析在JavaScript中如何安全将URL编码字符串转换为数组,详解decodeURIComponent与split的执行次序、URIError异常防护、多值参数解析及生产级代码实现。
在 JavaScript 中处理包含 URL 编码的字符串并将其解析为数组时,核心关键是“先切分还是先解码”的顺序裁决以及针对非法编码序列的异常捕获。标准场景下应优先对分隔符执行切分,再对各子元素调用 decodeURIComponent,以避免数据内部的编码分隔符引发错误截断。
一、核心场景与基本转换范式
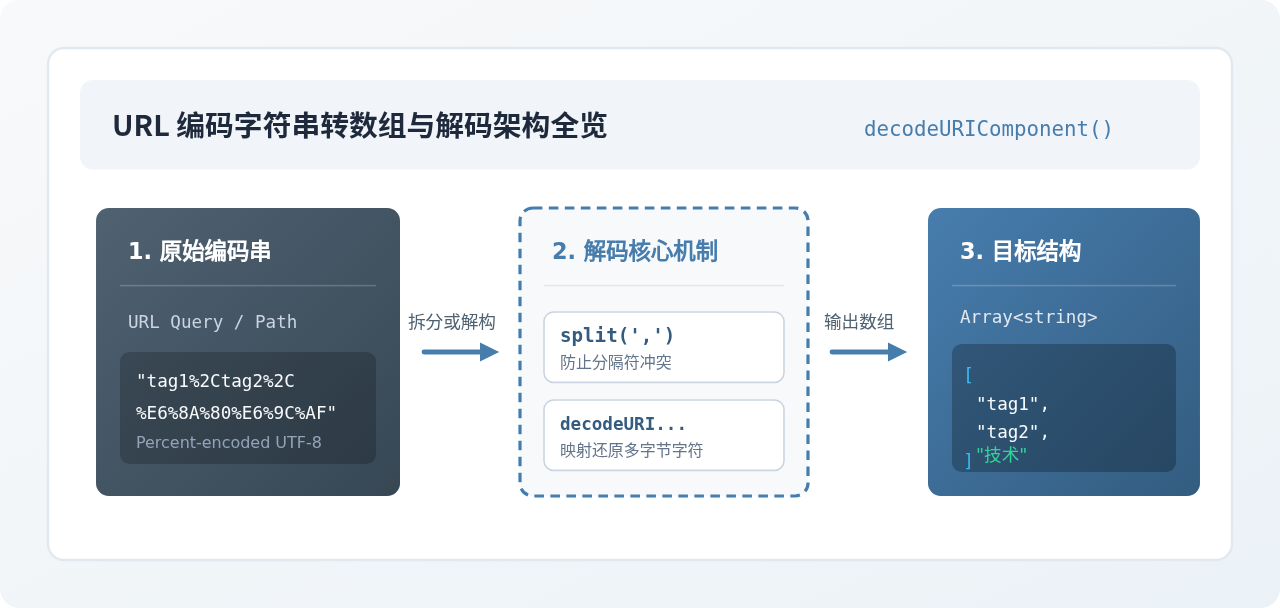
Web 开发中,客户端与服务器通过 URL 传递列表数据极其常见。例如从 Query 查询参数 ?categories=%E5%89%8D%E7%AB%AF%2C%E5%90%8E%E7%AB%AF%2CNode.js 或路径段提取以特定符号(如逗号、分号或斜线)分隔的列表。
JavaScript 原生提供的全局函数 decodeURIComponent() 专门负责将由 encodeURIComponent 生成的 UTF-8 百分比编码序列(形如 %XX)还原为真实字符。完成“编码字符串转数组”的最基础且规范的写法如下:
// 原始输入:URL编码的逗号分隔字符串
const encodedStr = "%E5%89%8D%E7%AB%AF%2C%E5%90%8E%E7%AB%AF%2CNode.js";

// 规范转换流程:先分割为独立单元,再对各单元执行解码
const resultArray = encodedStr
  .split(,)
  .map(item => decodeURIComponent(item.trim()));

console.log(resultArray);
// 输出结果: ["前端", "后端", "Node.js"]
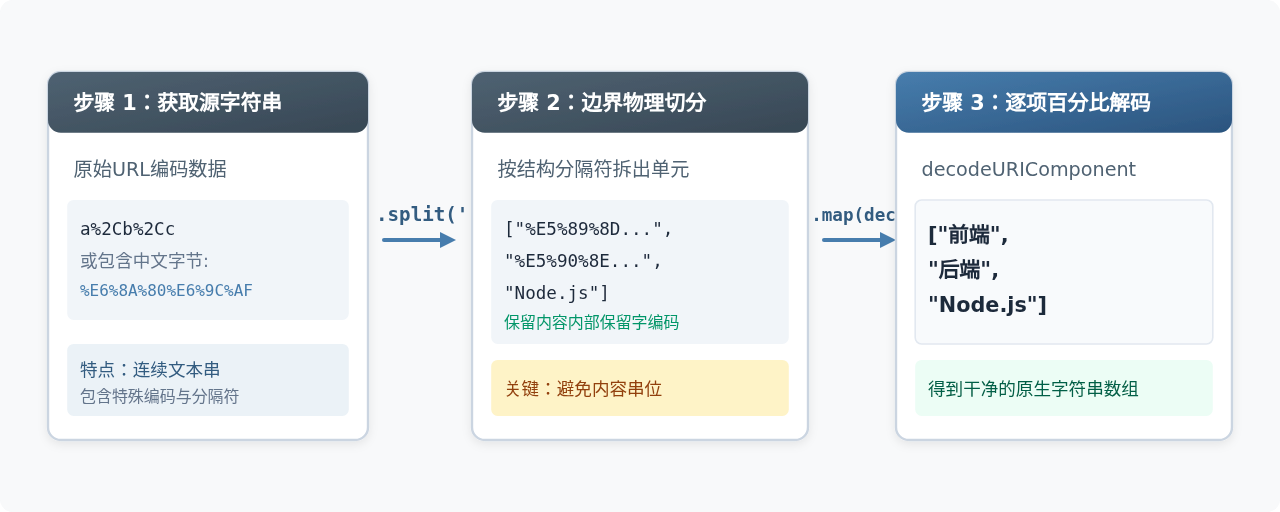
在这段逻辑中,split(,) 首先根据既定分隔符把字符串拆分为含有 3 个子项的临时数组:["%E5%89%8D%E7%AB%AF", "%E5%90%8E%E7%AB%AF", "Node.js"];接着通过 Array.prototype.map 对每一个单元调用 decodeURIComponent,最终得到包含中文字符的干净数组。
二、执行顺序辨析:先解码还是先分割?
初学者在实现该逻辑时,极易写出看似精简的写法:decodeURIComponent(str).split(,)。这是一种在绝大多数生产环境都会埋下严重数据截断隐患的写法。
当某一个数组元素本身就含有逗号时,规范的 URL 编码会将该元素内部的逗号转换为 %2C。
-
错误路径(先解码后分割):若对整体调用
decodeURIComponent,数据内部合法的%2C会被立即解码为纯文本字符,。紧接着执行的.split(,)无法区分哪一个是数组项间的分隔符,哪一个是元素本身的内容,导致单个元素被意外撕裂成两个元素。 -
正确路径(先分割后解码):先用纯文本分隔符(如外部未编码的逗号)切分数组元素;此时元素内部的
%2C依旧保持百分比编码状态,不受切分影响。切分完成后,再独立对各项执行decodeURIComponent,元素内的%2C被安全恢复为逗号且数组结构完整。
// 业务场景:列表中第1项本身含有半角逗号 "Hello, World"
// 规范序列化后的 URL 串:
const rawQuery = "Hello%2C%20World,Vue.js,React";

// ❌ 错误做法:先整体解码再分割
const wrongWay = decodeURIComponent(rawQuery).split(,);
console.log(wrongWay);
// 结果长度变成了 4!"Hello, World" 被破坏性地切开了:
// ["Hello", " World", "Vue.js", "React"]

//  正确做法:先分割元素,再分别解码每个元素
const correctWay = rawQuery.split(,).map(item => decodeURIComponent(item));
console.log(correctWay);
// 结果长度为 3,内容完整保留:
// ["Hello, World", "Vue.js", "React"]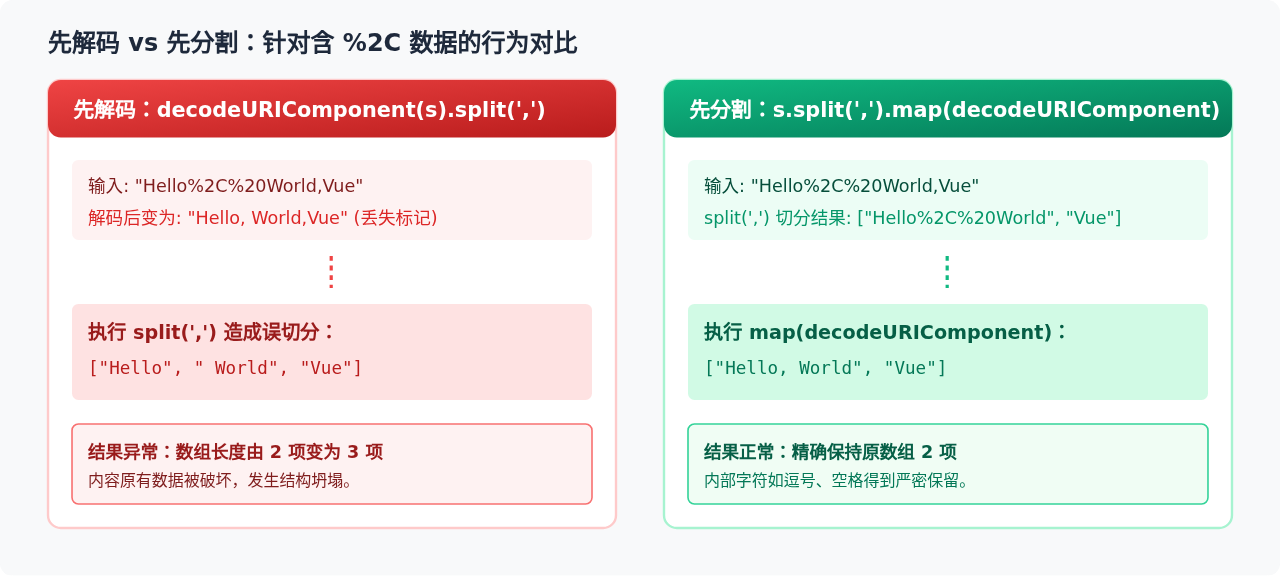
三、防御性编程:捕获并处理 URIError 异常
decodeURIComponent() 是一个带有硬性校验的函数。如果传入的字符串包含不合规的百分号编码(例如末尾孤立的 %,或者 UTF-8 字节序截断残缺序列如 %E4%BD),JavaScript 引擎将直接抛出 URIError: malformed URI sequence。
decodeURIComponent 处理用户不可控的 URL 参数,一旦出现被恶意篡改或网络传输截断的非法串,会导致页面整个 JS 执行线程崩溃。
为了保证生产环境的稳定性,应封装安全解码函数(Safe Decode),借助 try...catch 实现异常回退与容错,避免单一脏数据瘫痪全局流程:
/**
 * 安全解码单个字符串片段
 * @param {string} str 需要解码的片段
 * @param {string} fallback 解码失败时的备用值,默认为原串
 * @returns {string}
 */
function safeDecodeURIComponent(str, fallback = null) {
  try {
    return decodeURIComponent(str);
  } catch (error) {
    if (error instanceof URIError) {
      console.warn(`[URIError] 非法URL编码序列: "${str}",采用降级处理。`);
      return fallback !== null ? fallback : str;
    }
    throw error;
  }
}

// 包含合法与残缺非法编码的测试串
const mixedEncodedStr = "%E5%89%8D%E7%AB%AF,%E4%BD%A0%E5%A5%BD,bad%E4%BD";

const robustArray = mixedEncodedStr
  .split(,)
  .map(item => safeDecodeURIComponent(item.trim()));

console.log(robustArray);
// 输出: ["前端", "你好", "bad%E4%BD"] 正常完成解析,无抛错中断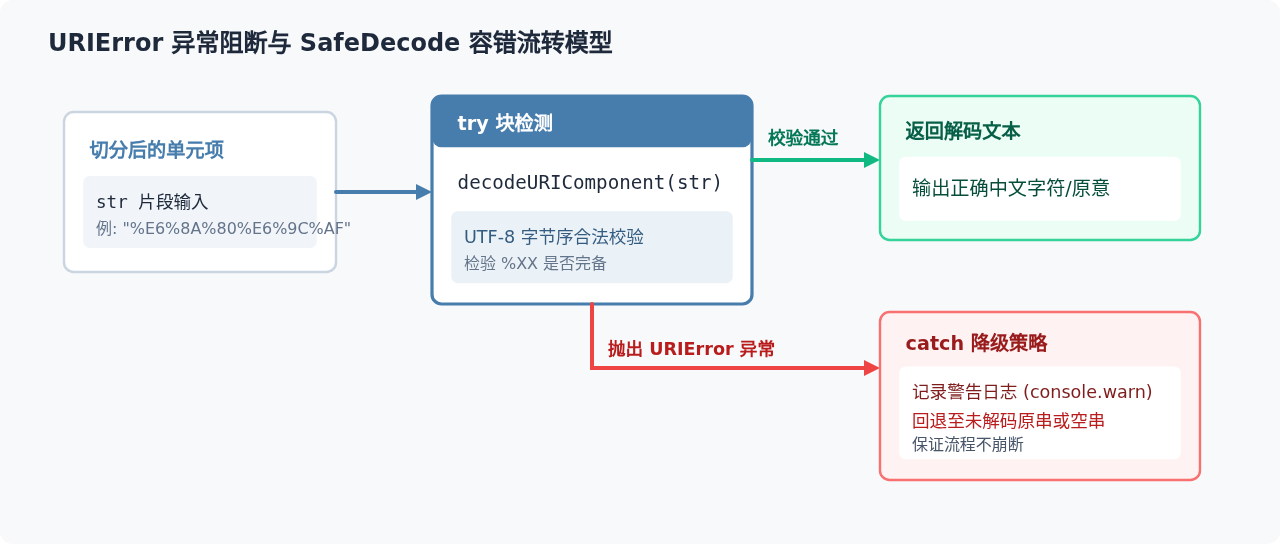
四、常见业务形态解析方案
在实际项目中,URL 中存放数组的表现形式不仅限于逗号分隔串。针对不同的 URL 协议与后端规范,需要适配恰当的技术方案:
1. 现代浏览器原生方案:URLSearchParams 重复键解析
当 URL 采用 ?tag=前端&tag=架构&tag=JavaScript 或 ?tags[]=a&tags[]=b 格式时,现代 JavaScript 标准推荐使用 URLSearchParams。其内置了自动解码机制,无需手动调用 decodeURIComponent:
// 模拟浏览器当前 URL 查询串
const searchStr = "?tag=%E5%89%8D%E7%AB%AF&tag=%E6%9E%B6%E6%9E%84&tag=JavaScript";

const params = new URLSearchParams(searchStr);
// 使用 getAll() 方法获取同名键的所有值,自带自动 URL 解码
const tagList = params.getAll(tag);

console.log(tagList);
// 结果: ["前端", "架构", "JavaScript"]
2. 复杂数据:序列化 JSON 数组解码
若 URL 参数传递的是复杂对象数组,常见格式是将 JSON.stringify() 后的字符串进行 encodeURIComponent。将此类字符串还原为数组时,顺序必须是先 decode 再 JSON.parse:
// 原始输入:JSON数组经URL编码后的文本
const encodedJsonArray = "%5B%22%E7%A7%BB%E5%8A%A8%E7%AB%AF%22%2C%22Web%E7%AB%AF%22%5D";

try {
  // 必须先解码百分比串,得到合法的 JSON 字符串
  const decodedJsonStr = decodeURIComponent(encodedJsonArray);
  const parsedArray = JSON.parse(decodedJsonStr);
  console.log(parsedArray);
  // 输出: ["移动端", "Web端"]
} catch (e) {
  console.error("解析JSON数组失败", e);
}
3. 路由路径片段转数组
在前端路由(如无 Hash 的 History 路由)中,常需解析形如 /articles/%E5%89%8D%E7%AB%AF/%E7%9B%AE%E5%BD%95/2026 的多级路径:
const pathname = "/articles/%E5%89%8D%E7%AB%AF/%E7%9B%AE%E5%BD%95/2026";

// 规范操作:按斜杠分割、过滤空项、分别解码
const segments = pathname
  .split(/)
  .filter(Boolean)
  .map(seg => safeDecodeURIComponent(seg));

console.log(segments);
// 输出: ["articles", "前端", "目录", "2026"]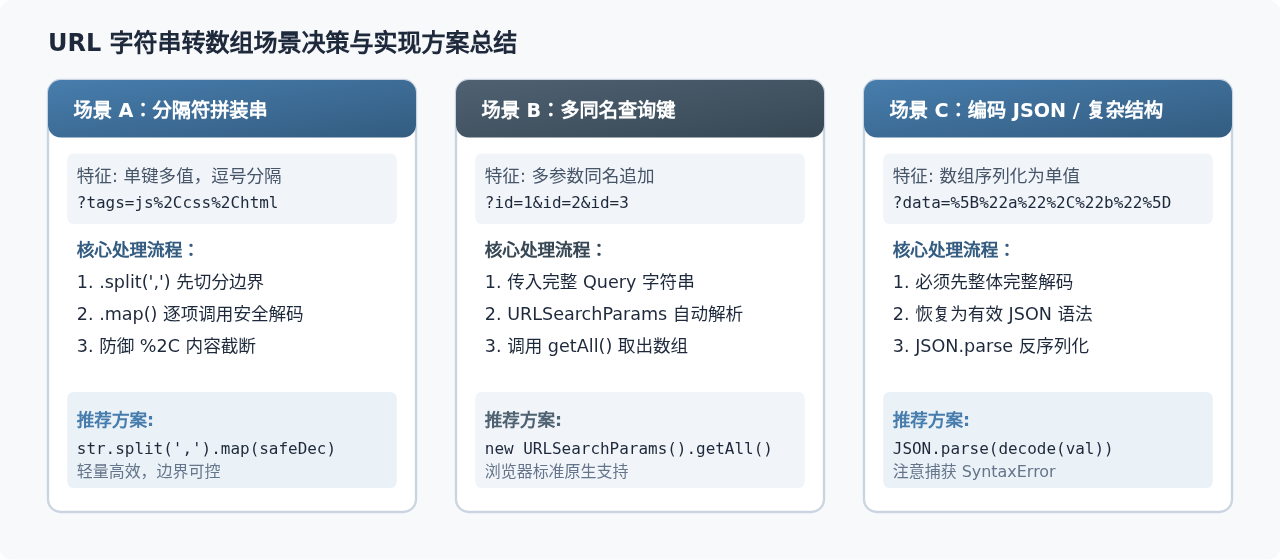
五、生产环境高容错通用函数
综合前述所有的边界条件、顺序要求和异常预防,可将这一处理过程封装为一个通用工具函数 parseUrlArray,直接应用于生产环境:
/**
 * 解析 URL 编码的字符串为数组
 * @param {string} input 待处理的字符串
 * @param {Object} [options] 配置项
 * @param {string|RegExp} [options.separator=,] 分隔符
 * @param {boolean} [options.filterEmpty=true] 是否自动剔除空元素
 * @param {boolean} [options.trim=true] 是否裁剪各元素前后空白
 * @returns {Array<string>}
 */
function parseUrlArray(input, options = {}) {
  const {
    separator = ,,
    filterEmpty = true,
    trim = true
  } = options;

  if (typeof input !== string || !input.trim()) {
    return [];
  }

  // 1. 先按分隔符切分物理结构,维持内部编码完整
  let items = input.split(separator);

  // 2. 预处理空白字符
  if (trim) {
    items = items.map(item => item.trim());
  }

  // 3. 过滤空元素
  if (filterEmpty) {
    items = items.filter(item => item.length > 0);
  }

  // 4. 逐项安全解码并捕获 URIError
  return items.map(item => {
    try {
      return decodeURIComponent(item);
    } catch (e) {
      if (e instanceof URIError) {
        console.warn(`[parseUrlArray] 解码失败,保留原始项: "${item}"`);
        return item;
      }
      throw e;
    }
  });
}

// 生产测试用例
console.log(parseUrlArray("%E6%B7%B1%E5%9C%B3,%E5%8C%97%E4%BA%AC,%E4%B8%8A%E6%B5%B7"));
// 输出: ["深圳", "北京", "上海"]

console.log(parseUrlArray("tag1%2Cdetail,tag2, ,tag3", { filterEmpty: true }));
// 输出: ["tag1,detail", "tag2", "tag3"] (包含逗号的项依然正确保留)
遵循“按需先行分割、安全映射解码、严格捕获异常”的规范路径,便能在各种复杂与异常的 URL 参数输入下,兼顾数据结构的准确性与应用运行的高健壮性。
js字符串转数组中文每个字单独成元素
2026-11-13 15:32:42
js字符串对象数组JSON.parse转换
2026-11-13 08:37:56
js字符串"a=1&b=2"怎么转数组或对象
2026-11-13 08:35:23
js字符串怎么转数组用reduce实现
2026-11-13 08:12:40
Moment.js停止维护后,JS项目日期格式化迁移指南
2026-11-13 08:05:09