js字符串转数组处理百万字符性能
深入解析JavaScript在处理百万级大字符串转数组时的性能瓶颈、V8堆内存膨胀机制与GC垃圾回收影响,提供针对性的分块流式迭代与类型化数组高性能实践方案。
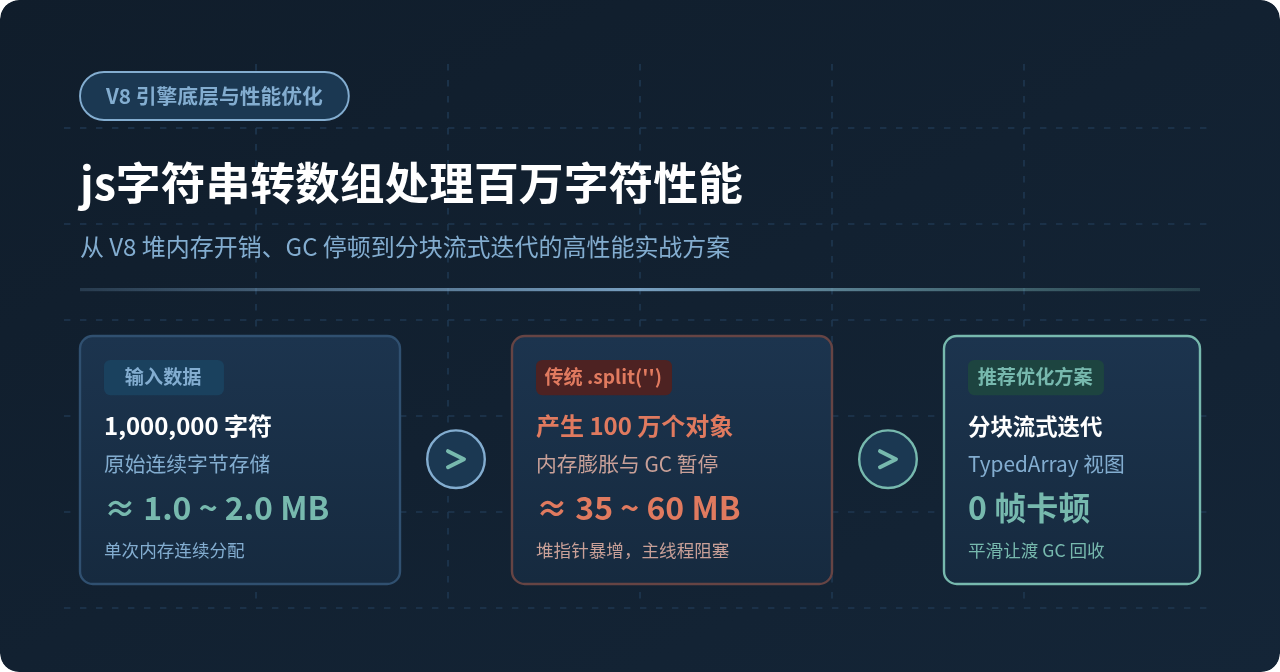
在前端或 Node.js 服务端开发中,当我们需要解析上万行的服务器日志、格式化基因序列数据(FASTA 格式)、计算百万级代码文件的文本差异(Diff),或者在浏览器端预览大型 CSV 导出文件时,经常会面对长度达到 1,000,000 个字符的大型字符串。如果我们习惯性地写下 str.split('') 或 [...str],往往会直接遇到主线程卡顿数十毫秒乃至数百毫秒、内存占用飙升甚至浏览器页面崩溃(Aw, Snap!)的故障现象。
要安全高效地处理这种规模的数据,核心结论是:除非业务严格需要独立字符引用的扁平数组,否则应优先通过字符串直接索引 str[i]、类型化数组(Uint16Array / TextEncoder)或分块流式迭代(Chunking + Yield)来消除瞬间产生的一百万个堆对象与 GC 停顿。本文将从 V8 引擎的底层内存机制出发,对比常见转换方案的真实开销,并提供工业级可用的高性能分块方案。
一、为什么百万字符转换会引发性能危机:V8 堆内存模型解析
很多开发者会产生疑问:100 万个英文字符在磁盘或内存中不过占据约 1 MB(单字节 ASCII/Latin1)或 2 MB(双字节 UTF-16)空间,为什么将其转换成数组后,JavaScript 进程的内存会激增到数十兆字节甚至上百兆字节?
这个问题的根源在于 JavaScript 引擎(以 Google Chrome 和 Node.js 的 V8 为例)对字符串和数组所采取的截然不同的对象管理方式:
- 原始大字符串的存储形态:在 V8 中,长连续字符串通常被存储为顺序字符串(
SeqOneByteString或SeqTwoByteString)。这是一种紧凑的连续内存块,100 万个字符只需要占用一个对象头和约 1MB ~ 2MB 的平铺缓冲区。 - 数组转换后的存储形态:当调用
split('')将其转为字符数组时,V8 会在内存中分配一个容量为 100 万的JSArray。在这个数组底层,除了容纳 100 万个元素指针的底层缓冲区(在指针压缩开启时占用 4MB,未开启时占用 8MB)外,还需要在堆上分配或维护 100 万个独立单字符字符串对象(即使内部存在单字符常量池缓存,切片引用依然会产生巨量堆描述信息)。
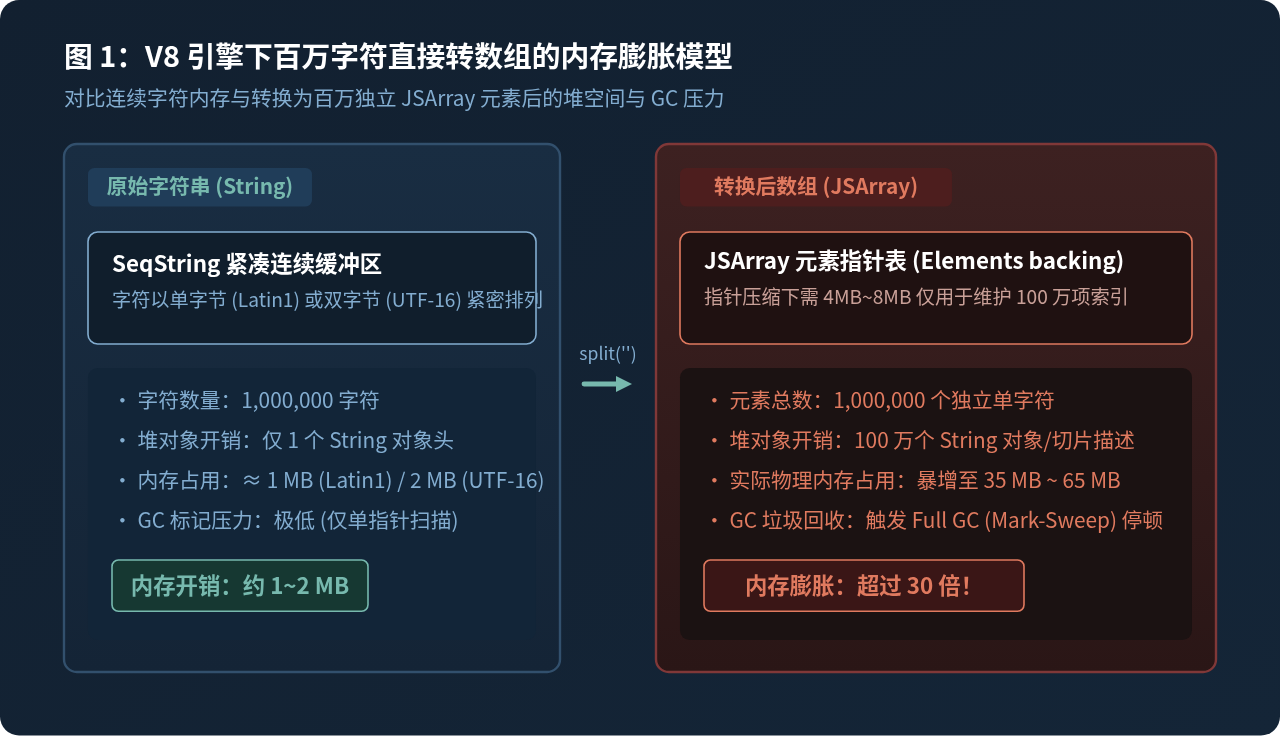
内存暴涨不仅意味着 RAM 占用的增加,更致命的是垃圾回收器的负担。当 100 万个单字符对象在短时间内被分配到新生代(New Space)并迅速溢出晋升到老生代(Old Space)时,V8 必须启动耗时极长的全堆标记与指针扫描(Mark-Sweep)。在单线程执行的浏览器主线程中,这会导致渲染流水线中断,出现严重的丢帧与界面假死。
二、常见转换方案底层机制与性能基准比对
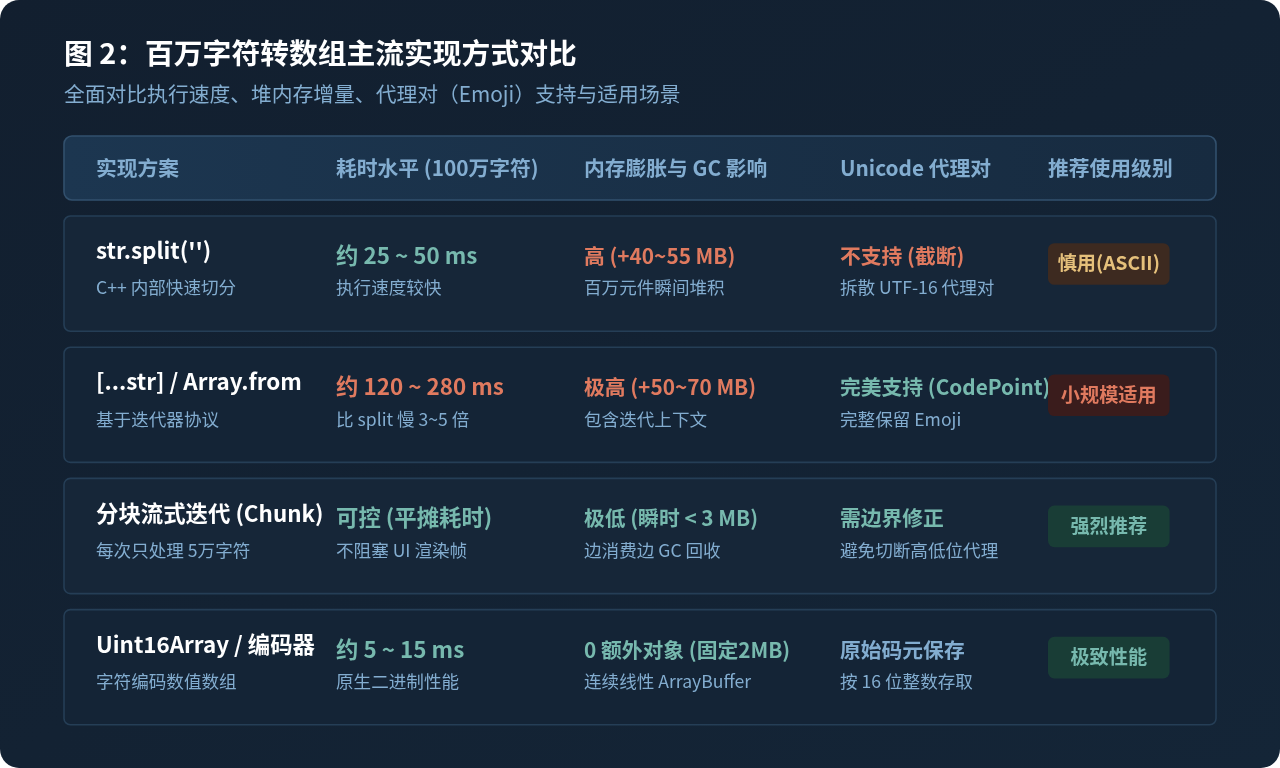
在 JavaScript 中,将字符串切分为单个字符构成的数组通常有四种常见写法。它们的执行耗时与底层机制存在本质差异:
1. 原生 str.split('')
// 传统全量切分
const arr = str.split('');底层行为:由 V8 引擎内部的 C++ 快速实现。对于常规 ASCII 字符串,它的执行速度是最快的(在主流机器上处理 100 万字符大约耗时 25 ~ 50 毫秒)。但它的缺陷也极其明显:它完全无法感知 Unicode 扩展平面的代理对(Surrogate Pairs),如果文本中包含 Emoji(例如 👨👩👧👦、😊)或生僻汉字,它会粗暴地将其拆散为无法独立显示的非法高低位码元(如 \uD83D 和 \uDE0A)。同时,瞬间在内存中建立 100 万个数组项,内存峰值骤增 40MB 以上。
2. 解构展开 [...str] 与 Array.from(str)
// 基于迭代器协议的转换
const arr = [...str];
// 或
const arr2 = Array.from(str);底层行为:ES6 规范引入的解构展开与 Array.from 严格遵循了 String.prototype[Symbol.iterator]()。这种机制能正确识别 4 字节的 Unicode 码点,保证 Emoji 字符不被破坏。然而,每一次迭代都需要调用迭代器的 .next() 方法并返回一个形如 { value: 'x', done: false } 的过渡对象。处理百万级字符时,迭代器协议的开销被放大了 100 万倍,导致耗时高达 150 ~ 300 毫秒,较 split('') 慢 3 到 5 倍,内存抖动更为剧烈。
3. 基于固定长度预分配的 for 循环
const len = str.length;
const arr = new Array(len); // 提前指定容量,避免动态扩容
for (let i = 0; i < len; i++) {
  arr[i] = str[i];
}底层行为:通过 new Array(len) 预先分配连续的元素空间,避免了 arr.push() 在容量不足时反复执行的 1.5 倍或 2 倍数组重新扩容与内存复制。但它依然逃不脱向数组中填充 100 万个字符引用的本质代价。
4. 零堆对象开销方案:类型化数组(TypedArray)
// 使用 Uint16Array 存储 UTF-16 码元
const len = str.length;
const typedArr = new Uint16Array(len);
for (let i = 0; i < len; i++) {
  typedArr[i] = str.charCodeAt(i);
}

// 或者使用 TextEncoder 直接导出 UTF-8 二进制缓冲区
const utf8Bytes = new TextEncoder().encode(str);底层行为:类型化数组直接映射到底层紧凑的 ArrayBuffer,不会在堆上创建任何多余的 JS 字符串对象。处理 100 万个字符只需 2 MB 连续物理内存,耗时仅需约 5 ~ 15 毫秒,垃圾回收器几乎感知不到额外负担。
三、工业级实践:百万字符分块异步流式处理
在绝大多数真实的 Web 应用场景中,我们之所以需要将大字符串转为数组,往往是为了进行后续的批处理(例如批量渲染列表、批量提交搜索索引、分词或文本替换)。此时,一次性将 100 万个字符完整装入内存数组不仅耗费资源,而且完全违背了浏览器的渲染节奏。
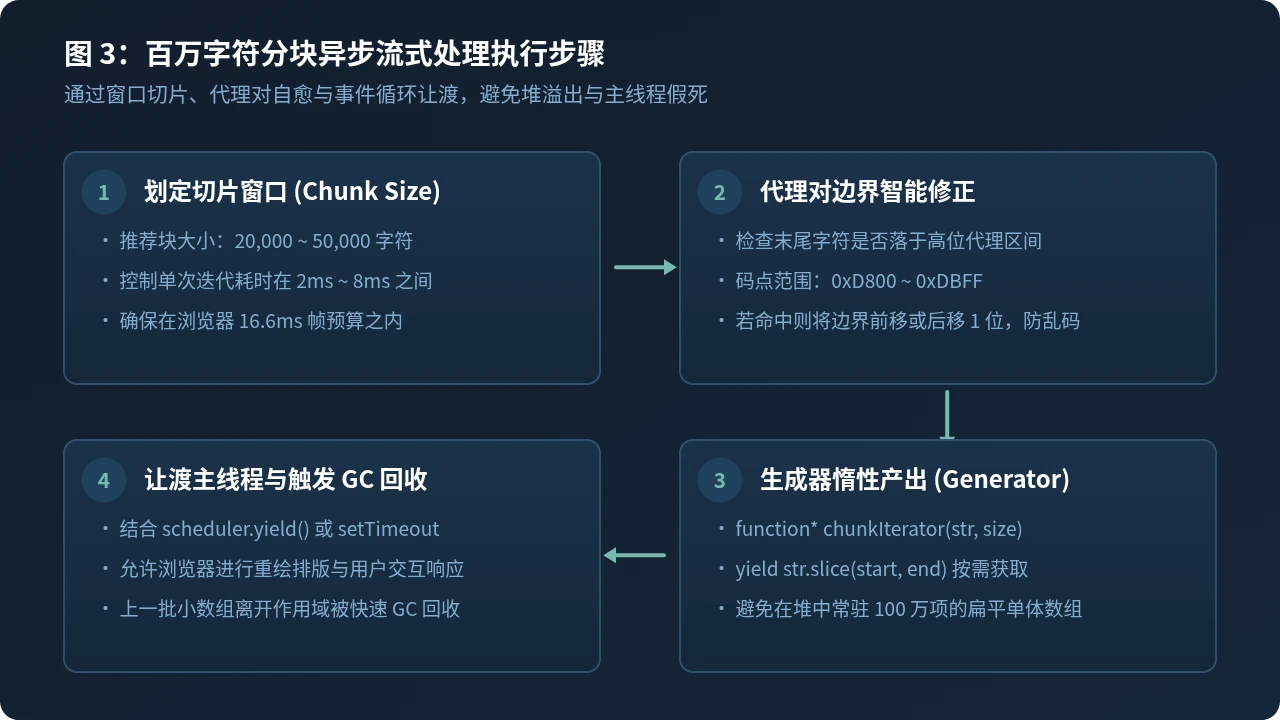
业界标准的高性能解决策略是:采用生成器(Generator)进行分块切片,并通过调度器让渡主线程执行权。这样可以在每个微小的时间片内只产生几万个字符的轻量级数组,消费完毕后立即由垃圾回收器回收,实现内存占用的平缓恒定。
完整可运行的高性能分块实现
下面是一个兼顾了 Unicode 代理对边界防护 与 事件循环让渡 的完整实现方案:
/**
 * 带有 Unicode 代理对保护的大字符串切片生成器
 * @param {string} str - 百万级原始大字符串
 * @param {number} chunkSize - 每批切片大小(推荐 20,000 ~ 50,000)
 */
function* chunkStringIterator(str, chunkSize = 50000) {
  const len = str.length;
  let start = 0;

  while (start < len) {
    let end = Math.min(start + chunkSize, len);

    // 边界保护:若切片末尾恰好落在高位代理区(0xD800 ~ 0xDBFF),后移一位避免拆断 Emoji
    if (end < len) {
      const code = str.charCodeAt(end - 1);
      if (code >= 0xd800 && code <= 0xdbff) {
        end += 1;
      }
    }

    // 返回当前块的子切片数组(此时单次切片仅消耗几百KB内存)
    yield str.slice(start, end).split('');
    start = end;
  }
}

/**
 * 异步流式处理引擎,确保 UI 零掉帧
 */
async function processLargeStringAsync(largeStr, processChunkCallback) {
  const iterator = chunkStringIterator(largeStr, 50000);
  let batchIndex = 0;

  for (const chunkArray of iterator) {
    // 执行具体的业务逻辑(例如字频分析、分块比对)
    processChunkCallback(chunkArray, batchIndex++);

    // 关键优化:每隔若干批次让渡主线程,允许浏览器执行重绘与微任务
    if (batchIndex % 2 === 0) {
      await yieldToMainThread();
    }
  }
}

/**
 * 现代事件循环让渡工具函数
 */
function yieldToMainThread() {
  // 优先采用现代标准的 Scheduler API
  if (typeof scheduler !== 'undefined' && scheduler.yield) {
    return scheduler.yield();
  }
  // 降级方案:使用 MessageChannel 或 setTimeout
  return new Promise(resolve => setTimeout(resolve, 0));
}在上述代码中,str.slice(start, end).split('') 只负责针对 50,000 字符的小范围片段切分。处理 50,000 字符的耗时通常在 1 毫秒以内,产生的临时小对象会在退出当前循环迭代后迅速变成垃圾候选对象,完全在新生代(Nursery)内被 Scavenge 快速回收,不会触发老生代全量 GC。
四、Unicode 代理对(Surrogate Pairs)避坑指南
当处理现代用户生成内容(UGC)时,文本中极易混入 Emoji 符号(如 💻、🎉)或生僻字。JavaScript 的字符串内部采用 UTF-16 编码,每个常规字符占用一个 16 位码元(Code Unit)。超出基本多语言平面(BMP)的字符则由一对高位代理(High Surrogate: 0xD800 ~ 0xDBFF)和低位代理(Low Surrogate: 0xDC00 ~ 0xDFFF)共同组成。
如果在转换数组时盲目使用 str.split(''),会导致代理对断裂。但如果全量使用 [...str],又会承受数倍的性能损耗。如果业务必须精确提取完整的 Unicode 字符数组,推荐使用基于 codePointAt 的线性扫描构建器:
/**
 * 兼顾性能与 Emoji 代理对完整性的数组转换函数
 */
function safeUnicodeSplit(str) {
  const len = str.length;
  const result = [];
  let i = 0;

  while (i < len) {
    const code = str.charCodeAt(i);
    // 判断是否为高位代理
    if (code >= 0xd800 && code <= 0xdbff && i + 1 < len) {
      const nextCode = str.charCodeAt(i + 1);
      if (nextCode >= 0xdc00 && nextCode <= 0xdfff) {
        // 合并提取完整的双码元字符
        result.push(str.slice(i, i + 2));
        i += 2;
        continue;
      }
    }
    result.push(str[i]);
    i += 1;
  }

  return result;
}
此方法避免了 ES6 Iterator 的对象包装损耗,同时确保了代理对的准确切分,处理 100 万字符的耗时通常只有 [...str] 的三分之一左右。
五、工程选型与性能调优决策全景
为了让不同场景下的开发者能够快速做出最优架构选择,下表与决策图汇总了处理百万级字符时的选型判定路径:
| 业务核心诉求 | 推荐方案 | 内存特征 | 性能瓶颈与防范 |
|---|---|---|---|
| 仅需顺序读取字符进行统计算法 | 直接下标访问 str[i] |
0 额外内存 | 完全无需转数组,切忌滥用 split |
| 需要进行字节级计算/数据传输 | Uint16Array / TextEncoder |
1MB~2MB 连续定长 | 需在数字编码与字符形态间转换 |
| 前端界面大文本渲染/分批解析 | 异步分块迭代 (Chunk + Yield) | 恒定在 3MB 以内 | 注意配置合理的 ChunkSize (2w~5w) |
| 需要完整保留 Emoji 且数据量极小 | 解构操作符 [...str] |
对象开销极大 | 仅限 < 10,000 字符场景,百万字符绝对禁用 |
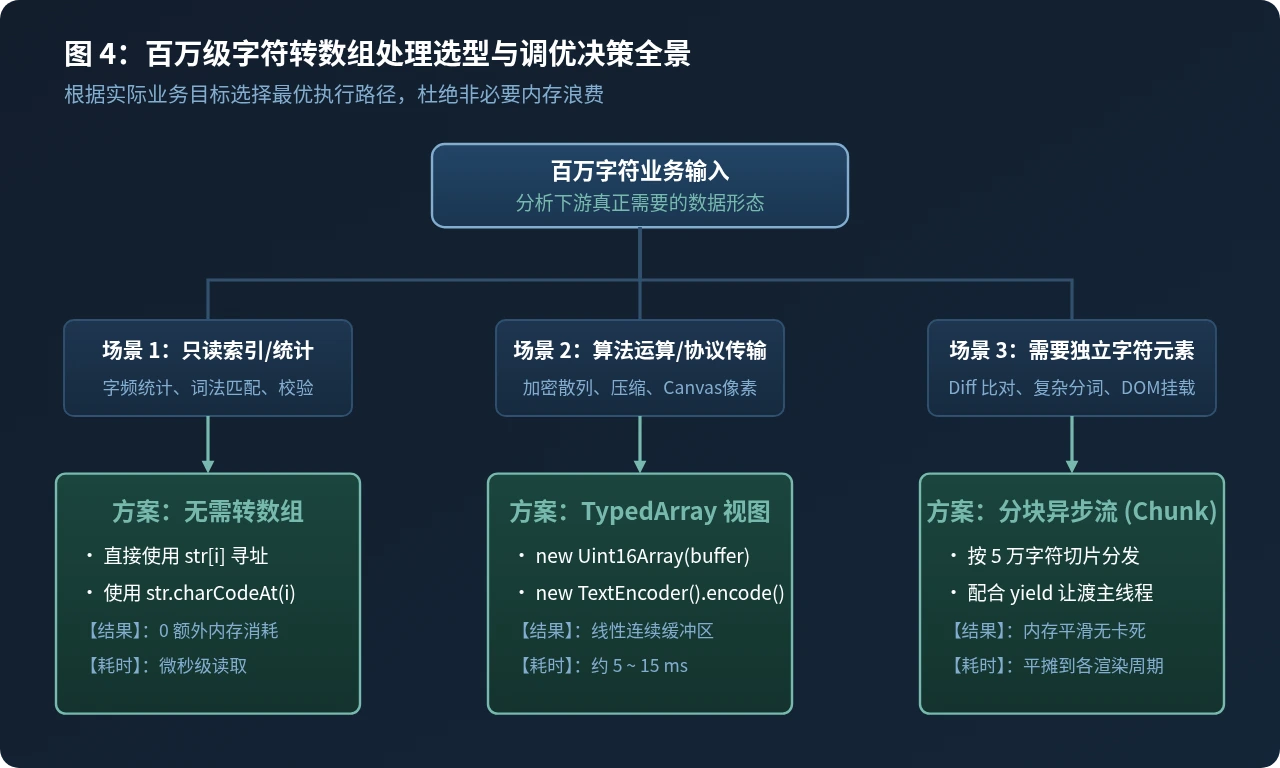
六、总结与落地建议
在面对“百万字符”这一数量级时,JavaScript 代码的瓶颈往往已经从纯 CPU 运算耗时转移到了 V8 内存分配压力与垃圾回收停顿 上。直接对大字符串调用 split('') 或 [...str] 会瞬间在内存中制造 100 万个独立的堆对象,导致数十倍的内存膨胀并引发界面无响应。
在实际工程中,请遵循以下三条黄金准则:
- 反思是否真的需要数组:如果只是查找、正则校验或词法统计,利用字符串原生支持的
str.charCodeAt()和str[i]拥有微秒级的性能和零额外内存。 - 善用类型化数组:对于纯 ASCII、算法处理或协议编码场景,用
Uint16Array或TextEncoder替代普通对象数组,内存直接下降 95% 以上。 - 必须生成数组时务必分块:将单次全量切分重构为生成器分块流式迭代,控制单批切片规模在 20,000 ~ 50,000 字符之间,配合
scheduler.yield()释放主线程,彻底消除大文本处理引发的 UI 卡死问题。
JS合并对象数组时怎么处理相同ID的数据
2026-11-12 12:01:59
js判断整数正则表达式造成内存泄漏怎么排查
2026-11-08 08:17:14
Windsurf编辑器常见报错及性能优化解决方案
2026-11-07 09:44:46
JavaScript框架库漏洞怎么校验用户输入是否合法
2026-11-07 08:12:59
hls.js 性能调优:缓冲策略与内存占用优化指南
2026-11-05 23:58:42