JavaScript框架库漏洞怎么校验用户输入是否合法
深入剖析JavaScript框架库中原型链污染、DOM注入等常见漏洞机理,提供基于Schema白名单、危险键拦截与上下文净化的完整用户输入校验实施方案与工程代码。
一、JavaScript 框架中常见的输入漏洞类型与防御切入点
JavaScript 作为一门高度动态、基于原型的弱类型语言,在现代框架(如 React、Vue、Express、NestJS 等)及高频辅助类库(如深度合并、模板渲染、路径寻址等工具库)处理输入时,极易因输入结构模糊而暴露安全漏洞。所谓“框架库漏洞校验”,本质上是要针对框架和类库最薄弱的数据消费节点建立输入边界。
在实际工程中,未经校验或弱校验的用户输入主要诱发以下三类典型漏洞:
-
原型链污染(Prototype Pollution):当外部输入包含
__proto__、constructor或prototype等特权键名,并被直接送入深度递归合并(如旧版lodash.merge、defaultsDeep)或对象扩展函数时,攻击者可以篡改所有普通对象继承的Object.prototype,造成全局逻辑越权甚至远程代码执行(RCE)。 -
DOM 型 XSS 与属性逃逸:前端框架虽然默认对文本插值进行转义,但在处理动态属性(如
href="javascript:...")、富文本渲染(如 React 的dangerouslySetInnerHTML或 Vue 的v-html)以及组件动态 Props 时,若未对协议与标签进行白名单校验,恶意脚本便能直接在用户浏览器中执行。 - 类型混淆与 DoS 递归崩溃:攻击者传入极端深度的嵌套 JSON 对象或超长字符串,利用框架解析时的弱类型隐式转换触发逻辑分支错误,或者耗尽调用栈导致事件循环阻塞,引发拒绝服务(DoS)。
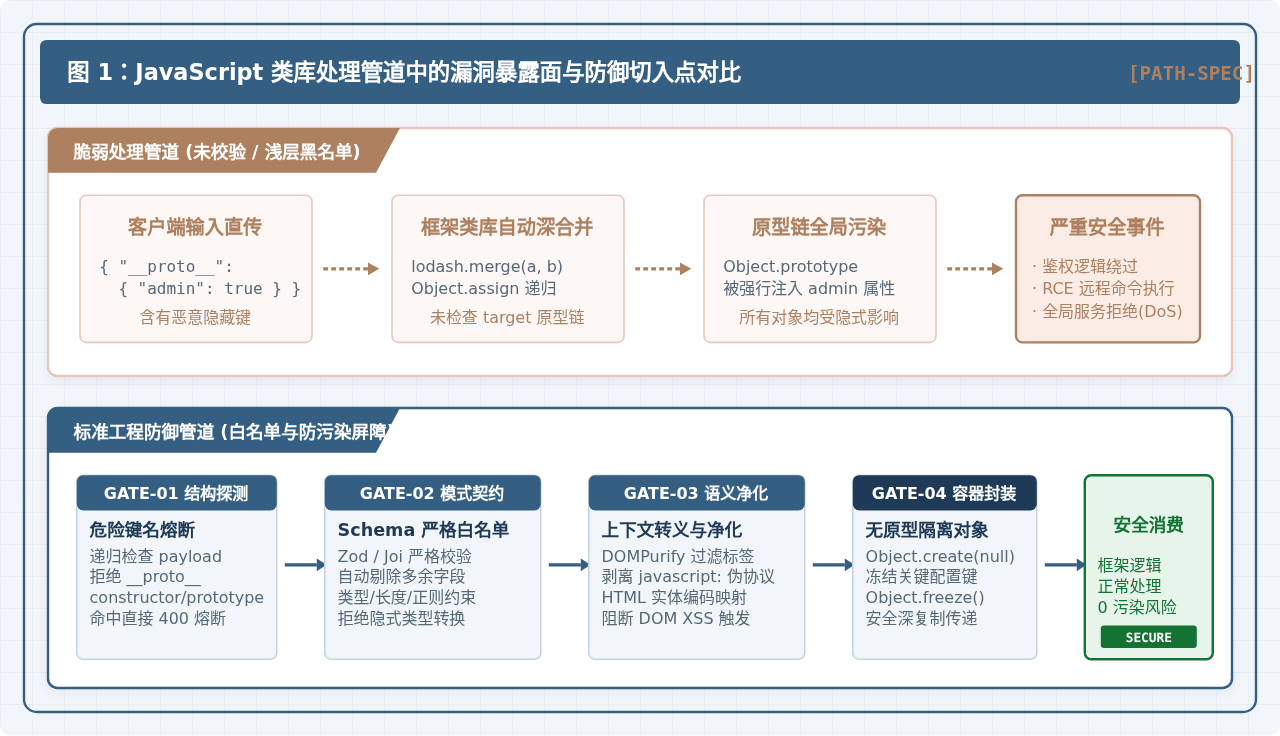
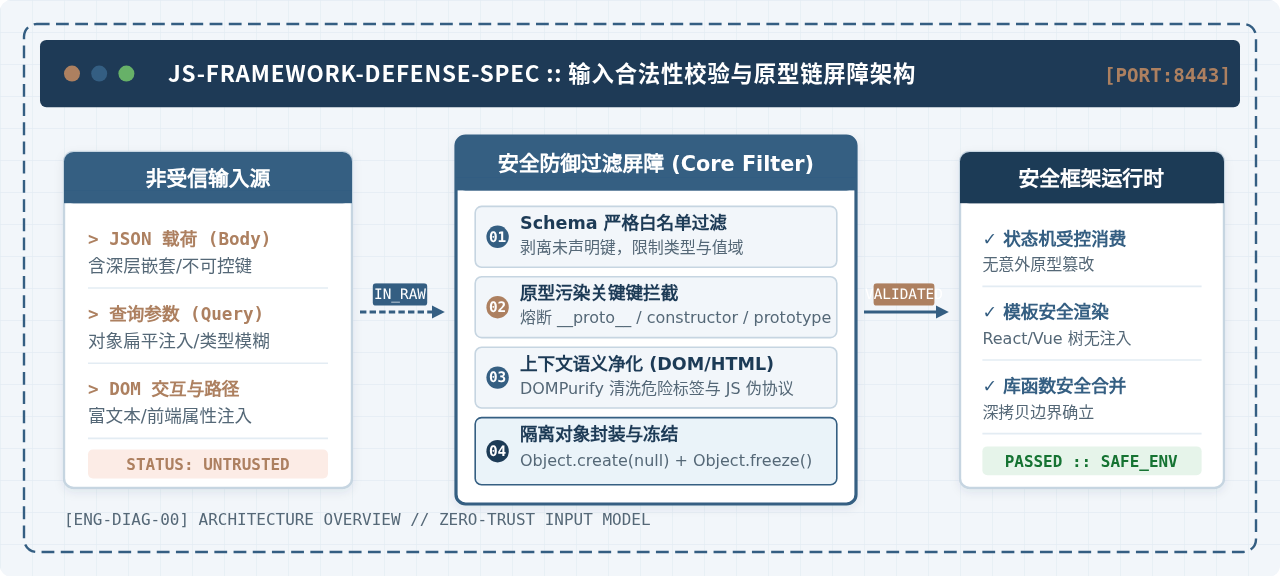
如图 1 所示,脆弱处理管道之所以失守,是因为开发者往往假设类库会自动处理所有非法结构,或者仅在业务层使用简单的字符串检查。而在标准工程防御管道中,输入校验必须作为一道独立的“前置防护屏障”,在数据触达任何框架业务逻辑前完成清洗与整形。
二、实施结构化输入校验的四步标准流程
要确保进入 JavaScript 框架库的数据绝对合法,应当遵循标准化的输入校验实施顺序。每个环节各司其职,一旦遇到非法格式立即熔断抛出异常,不再向下透传。
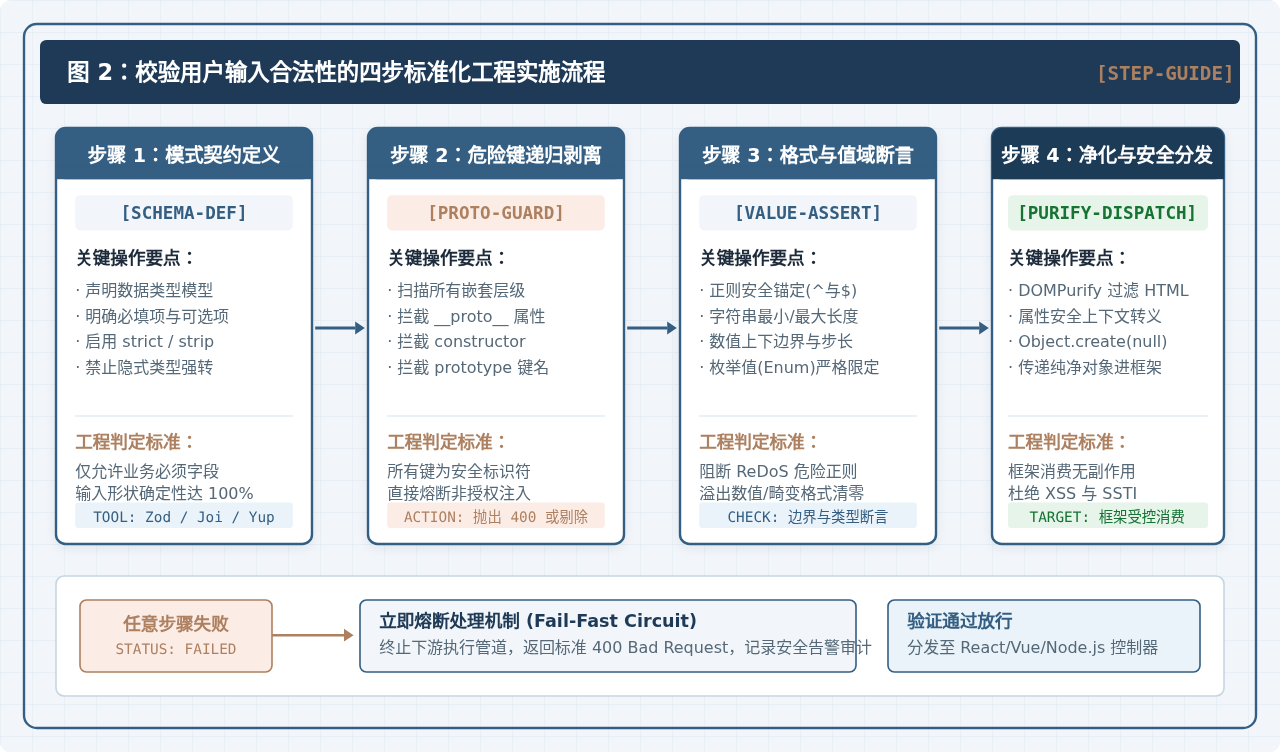
第 1 步:定义数据模式与类型边界(Schema 定义)
任何业务输入都必须具备明确的数据契约。在代码中,应使用类型完备的校验工具(如 Zod、Joi、Yup 等)显式定义每一个字段的白名单结构。核心要求是默认关闭未知字段接收。例如在 Zod 中使用 .strict() 拒绝任何多余属性,或使用默认的结构化解析直接剥离未声明键,从源头消灭隐藏键的生存空间。
第 2 步:剥离未知字段与原型污染键(危险键拦截)
深层嵌套的 JSON 载荷可能在第二层、第三层甚至数组内部携带特权键。必须对输入对象树进行递归探测,严格匹配键名中是否出现 __proto__、constructor、prototype。在底层反序列化或参数解析层(如 Express 的 body-parser 解析后),一旦扫描到此类敏感键,直接判定为恶意载荷并熔断处理。
第 3 步:执行格式规则与值域强断言(格式与区间约束)
不仅要校验数据类型(如数字、字符串、布尔值),还要校验数据在业务语义上的确切范围:
- 字符串必须限制
min()与max()长度,防止超大字符串造成内存占用; - 正则匹配必须使用严格的起始与结束锚点(
^与$),避免长文本回溯引发的正则表达式拒绝服务(ReDoS); - 离散取值必须使用枚举(Enum)限定,严禁任意字符串透传至底层配置;
- 数值型输入必须校验浮点边界,剔除
NaN与Infinity等危险特殊值。
第 4 步:语义清洗与安全传递(Sanitization 与安全容器)
校验通过后的数据,在注入框架组件或传递给下游类库前,仍需根据使用场景进行语义清洗。例如富文本必须经过 DOMPurify 净化,URL 必须核验是否以 http:// 或 https:// 开头。同时,存储业务字典时,优先使用无原型的字典对象 Object.create(null) 或原生 Map,消除原型查找带来的副作用。
三、关键防御场景与具体代码实现
为了让校验落地具备可操作性,下面针对工程中最常遭遇的三种攻击场景,分别给出完整、可运行的校验实现代码。
场景 1:防范原型链污染(深度递归安全校验与剥离)
面对不可控的深层合并需求,不能直接调用未受保护的递归合并函数。必须在合并前拦截危险键,或者在合并逻辑中显式排斥特权属性:
/**
 * 递归安全校验:排查对象中是否存在原型链污染特权键
 * 适用于:深层合并、动态反序列化及类库处理前
 */
function isSafePayload(obj, maxDepth = 10, currentDepth = 0) {
  if (currentDepth > maxDepth) {
    // 超过设定最大深度,拒绝解析,防范栈溢出攻击
    return false;
  }

  if (obj === null || typeof obj !== 'object') {
    return true;
  }

  // 检查当前对象所有自身键名及继承键名
  const keys = Object.keys(obj);
  for (const key of keys) {
    // 拦截原型特权键
    if (key === '__proto__' || key === 'constructor' || key === 'prototype') {
      return false;
    }

    // 递归校验嵌套对象与数组
    const value = obj[key];
    if (typeof value === 'object' && value !== null) {
      if (!isSafePayload(value, maxDepth, currentDepth + 1)) {
        return false;
      }
    }
  }

  return true;
}

/**
 * 安全深度合并实现:仅在无原型对象或纯净属性间执行赋值
 */
function safeDeepMerge(target, source) {
  if (!isSafePayload(source)) {
    throw new Error('SECURITY_ERROR: 非法载荷,检测到潜在原型污染注入');
  }

  for (const key of Object.keys(source)) {
    if (key === '__proto__' || key === 'constructor' || key === 'prototype') {
      continue; // 二次防御性跳过
    }

    const sourceVal = source[key];
    if (typeof sourceVal === 'object' && sourceVal !== null && !Array.isArray(sourceVal)) {
      if (!target[key] || typeof target[key] !== 'object') {
        // 创建无原型的干净字典对象,切断原型继承链
        target[key] = Object.create(null);
      }
      safeDeepMerge(target[key], sourceVal);
    } else {
      target[key] = sourceVal;
    }
  }
  return target;
}

// 验证示例
const maliciousInput = JSON.parse('{ "title": "安全报告", "__proto__": { "isAdmin": true } }');
console.log('检测结果:', isSafePayload(maliciousInput)); // 输出: false
场景 2:基于 Schema 白名单的后端输入验证(以 Zod 为例)
在 Node.js 服务端框架(如 Express、Fastify、Koa)中,应使用中间件机制对 req.body、req.query 和 req.params 统一实施强类型校验。利用 Zod 的 .strict() 方法可直接屏蔽非法键:
import { z } from 'zod';

// 定义业务模型 Schema:白名单机制,严格禁止未声明字段
const UserProfileSchema = z.object({
  username: z.string()
    .min(3, { message: '用户名长度至少为 3 位' })
    .max(20, { message: '用户名长度至多为 20 位' })
    .regex(/^[a-zA-Z0-9_-]+$/, { message: '用户名仅允许字母、数字、下划线及减号' }),

  age: z.number()
    .int({ message: '年龄必须为整数' })
    .min(1, { message: '年龄不能小于 1' })
    .max(120, { message: '年龄不能大于 120' }),

  email: z.string().email({ message: '邮箱格式不合法' }),

  role: z.enum(['reader', 'editor'], { message: '角色仅允许为 reader 或 editor' }),

  // 对可选嵌套配置使用安全限制
  settings: z.object({
    theme: z.enum(['light', 'dark']).default('light'),
    notifications: z.boolean().default(true)
  }).strict() // 嵌套对象同样启用严格白名单
}).strict(); // 根节点启用 strict,任何额外键都将触发报错

/**
 * 通用 Express 校验中间件封装
 */
function validateBody(schema) {
  return (req, res, next) => {
    // 首先进行底层危险键快速探测
    if (!isSafePayload(req.body)) {
      return res.status(400).json({
        code: 'VALIDATION_FAILED',
        error: '请求载荷包含非法或受限的原型键名'
      });
    }

    // 执行 Schema 白名单校验与类型解析
    const result = schema.safeParse(req.body);
    if (!result.success) {
      return res.status(400).json({
        code: 'VALIDATION_FAILED',
        details: result.error.errors.map(err => ({
          field: err.path.join('.'),
          message: err.message
        }))
      });
    }

    // 将校验清洗后的纯净数据覆写回 req.body,确保下游框架消费绝对可信
    req.body = result.data;
    next();
  };
}
场景 3:前端富文本与属性输入的上下文转义与净化
在 React 或 Vue 等现代前端框架中,遇到富文本渲染或动态跳转需求时,必须对输入内容做上下文净化,杜绝伪协议执行:
import DOMPurify from 'dompurify';

/**
 * 校验并净化动态 URL 链接:防范 javascript: 伪协议 XSS
 */
function validateSafeUrl(rawUrl) {
  if (typeof rawUrl !== 'string') return '#';
  const trimmed = rawUrl.trim();

  try {
    // 利用原生 URL 解析器核验协议
    const parsed = new URL(trimmed, window.location.origin);
    if (parsed.protocol === 'http:' || parsed.protocol === 'https:') {
      return parsed.href;
    }
  } catch (e) {
    // 相对路径安全判定:确保不含伪协议前缀
    if (/^(\/|#|\.\/)/.test(trimmed) && !/^javascript:/i.test(trimmed)) {
      return trimmed;
    }
  }
  return '#'; // 非法协议默认降级为安全占位符
}

/**
 * 校验并净化富文本 HTML:在挂载至 v-html 或 dangerouslySetInnerHTML 前执行
 */
function sanitizeRichContent(rawHtml) {
  if (typeof rawHtml !== 'string') return '';

  // 严格配置 DOMPurify 允许的标签与属性白名单
  return DOMPurify.sanitize(rawHtml, {
    ALLOWED_TAGS: ['b', 'i', 'em', 'strong', 'a', 'p', 'ul', 'ol', 'li', 'code'],
    ALLOWED_ATTR: ['href', 'title', 'target'],
    ALLOW_DATA_ATTR: false
  });
}
四、传统黑名单过滤与 Schema 白名单机制对比
在校验用户输入的实践中,很多安全事故源于团队误用了“黑名单过滤”。下面从字段控制、原型链抵御能力、递归支持与维护成本四个核心维度,对比两者的本质差异。
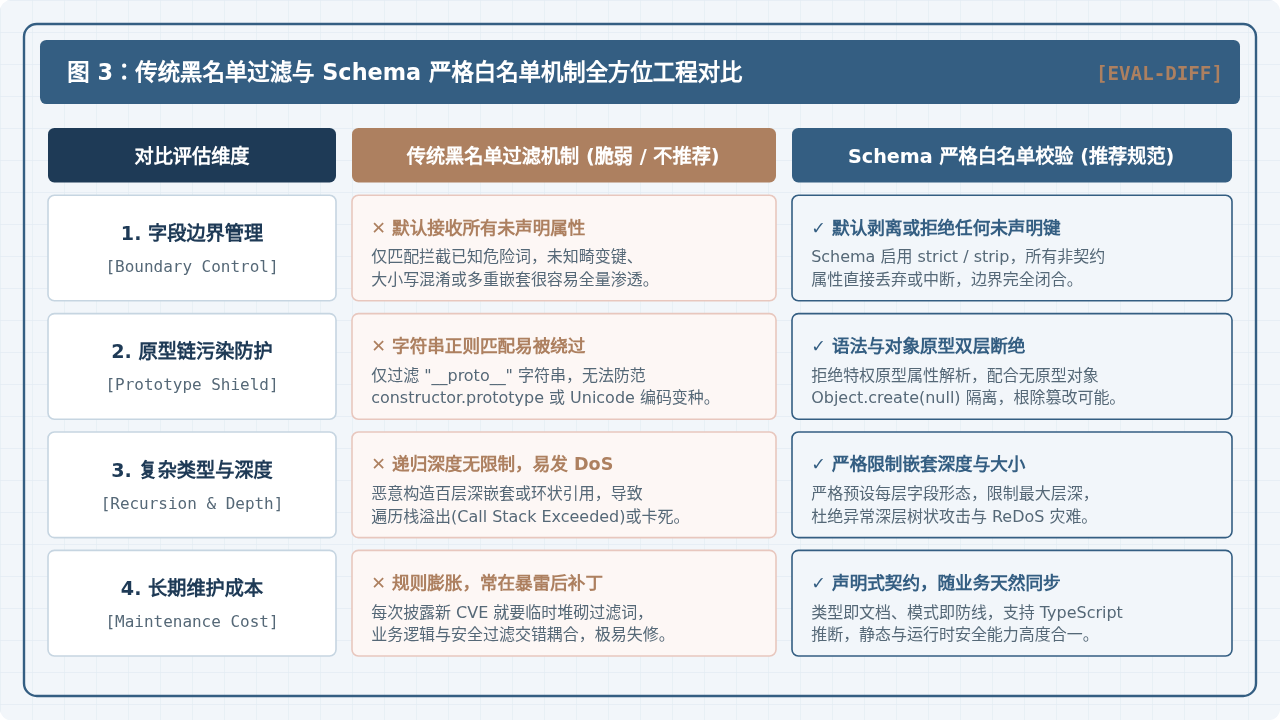
| 评估维度 | 传统黑名单过滤(不推荐) | Schema 严格白名单机制(推荐规范) |
|---|---|---|
| 边界定义方式 | 默认允许所有字段通过,仅针对特定关键词(如 script、__proto__)做正则剔除。 |
默认拒绝一切未声明属性,仅接收 Schema 显式定义的字段,并强约束确切类型。 |
| 抗绕过能力 | 极弱。攻击者可通过大小写变异、Unicode 混淆、深度嵌套等方式轻松绕过黑名单匹配。 | 极强。非预期字段在类型解析阶段即被抛弃或直接报错,不存在模糊匹配盲区。 |
| 原型链隔离 | 无法应对 constructor.prototype 或间接原型链寻址。 |
结合 Object.create(null) 从内存分配层面彻底切断原型继承,从根源消除污染路径。 |
| 长期演进与维护 | 随着新 CVE 披露必须不断追加过滤规则,规则库日渐臃肿且容易破坏正常业务数据。 | 声明式契约驱动,与业务模型天然同步,同时提供 TypeScript 静态类型推断,维护成本极低。 |
五、开发与配置中的关键注意事项
完成校验逻辑的编写后,还需在工程架构与运行环境中落实以下要点,防止因细节疏漏导致防御降级:
注意:严禁仅依赖前端客户端校验。 前端所有的表单验证与输入格式化均属于“用户体验辅助”,攻击者可绕过浏览器界面直接构造 HTTP 请求。后端及微服务内部每个入库服务都必须独立实施白名单校验。
-
请求载荷体积硬限制:在 Web 服务器及中间件层面限制 JSON Body 大小(如在 Express 中设置
bodyParser.json({ limit: '100kb' })),防止攻击者构造超大载荷打满内存。 - 区分“校验(Validation)”与“净化(Sanitization)”:校验是判断输入是否合规,不合规直接驳回;净化是在合规范围内对特殊字符进行转义。绝不能试图用净化去“修复”恶意构造的攻击载荷,发现非法特征应一律拒绝并记录告警。
-
冻结公共关键全局原型:在无动态拓展需求的生产环境启动脚本中,可显式调用
Object.freeze(Object.prototype)。一旦有任何类库试图向全局原型写入新属性,运行时将直接抛出 TypeError 异常,使污染攻击彻底失效。 -
定期扫描第三方依赖漏洞:框架自身的代码即便安全,若引入的旧版本第三方辅助库(如历史版本的 Lodash、Handlebars、Minimist 等)存在已知的原型污染漏洞,依然会受到威胁。应在 CI/CD 流水线中集成
npm audit、pnpm audit或 Snyk 工具进行自动化依赖阻断。
六、全流程防御检查清单与总结
对 JavaScript 框架库输入合法性的校验,不是单一函数的修修补补,而是一套贯穿“接入层、内存层、渲染层、依赖层”的完整工程闭环。
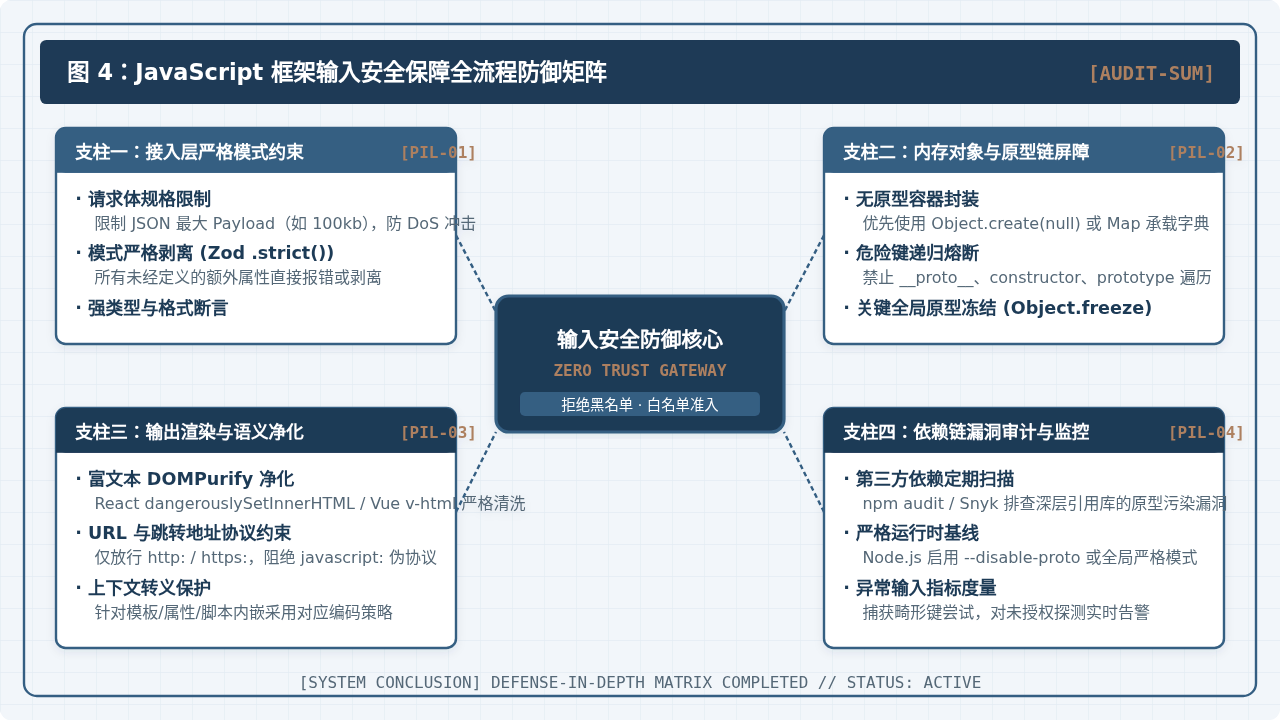
在上线前,建议根据以下检查清单进行逐项核对:
- 所有 API 入口是否均已接入基于 Schema 的严格白名单校验,并显式过滤了未知属性;
- 解析请求体时,是否对深度对象进行了敏感键探测,排除了
__proto__与constructor; - 深拷贝或合并逻辑是否已替换为安全受控的实现,或已使用具备原生防护能力的最新类库;
- 前端在将变量注入 HTML 标签或属性时,是否严格核验了协议头并使用了 DOMPurify;
- 生产依赖项是否通过了最新的 CVE 漏洞安全基线审计。
坚持“零信任(Zero Trust)输入模型”,将校验逻辑前置到系统边界,用白名单代替黑名单,用严格类型模式替代松散字符串检测,就能从根本上消灭绝大部分由框架库漏洞引发的安全隐患。
hls.js 性能调优:缓冲策略与内存占用优化指南
2026-11-05 23:58:42
Node.js 中使用 crypto-js 加密大文件的最佳实践
2026-11-05 19:27:24
tween.js 内存泄漏预防:怎么正确停止动画与清理对象
2026-11-05 15:52:56
Vue或React项目中为何不建议直接使用JS刷新页面
2026-11-05 13:57:30
哪里可以找到高质量的免费JS脚本资源?
2026-11-05 13:15:03