Node.js适合做什么不适合做什么:IO密集型与CPU密集型的界限
深入剖析Node.js的事件循环与异步底层模型,厘清IO密集型与CPU密集型任务的界限,提供典型代码对比、常见认知辨析、性能排查步骤与多线程架构解耦方案。
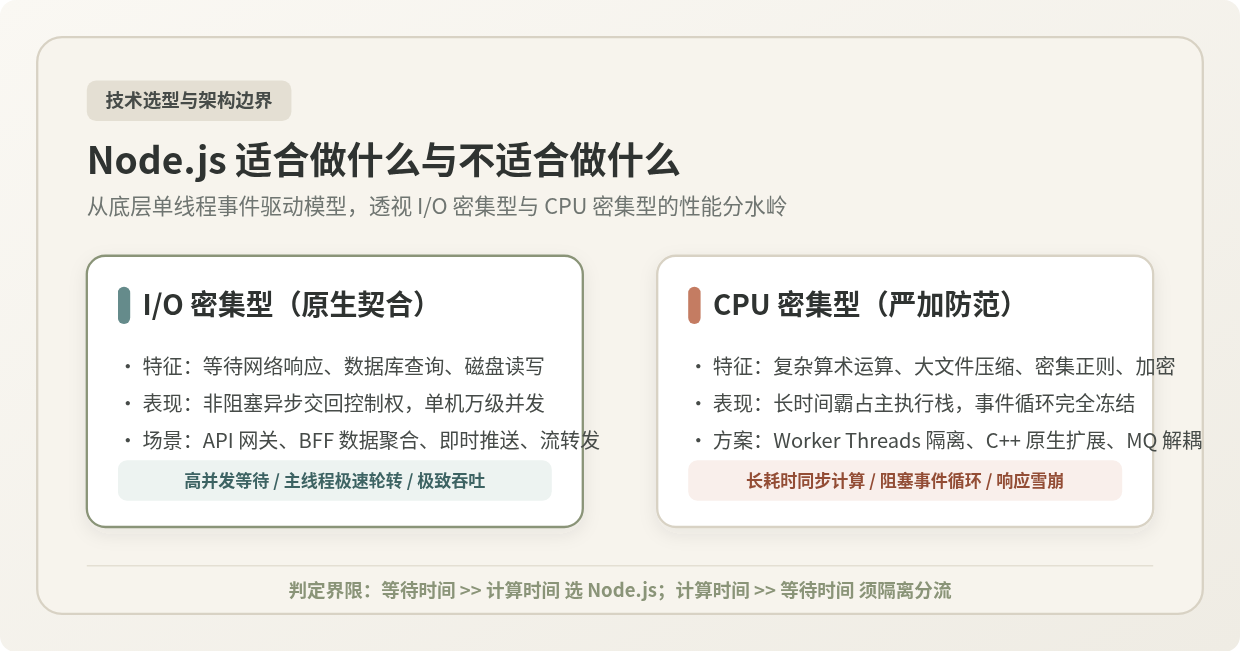
Node.js 的底层由单线程事件循环(Event Loop)与非阻塞 I/O 驱动,当请求遇到网络传输、文件存取或数据库查询等等待操作时,它能立即释放执行权并处理下一个任务,因而极其擅长承载吞吐量大、依赖外部系统响应的 I/O 密集型 业务;相反,当代码需要持续占用 CPU 进行大规模数值运算、长文本深度递归或复杂加密时,单主线程会被长期霸占,导致后续所有并发请求陷入排队等待甚至超时,因此它天然不适合在主线程承载 CPU 密集型 任务。理解两者的根本分界并掌握多线程隔离与架构解耦方法,是决定 Node.js 选型成败的关键。
一、底层模型剖析:为什么会出现两极表现?
要看清 Node.js 适合与不适合的边界,首先必须准确理解其核心运行机制。在传统的基于多线程并发模型的服务器(如传统的 Apache HTTP Server 或基于多线程阻塞的 Java Web 容器)中,每个接入的客户端连接通常需要分配一个独立的系统线程。当有数千个并发连接时,大量的内存被线程栈消耗,操作系统的 CPU 核心也在频繁的线程上下文切换中损失大量算力。
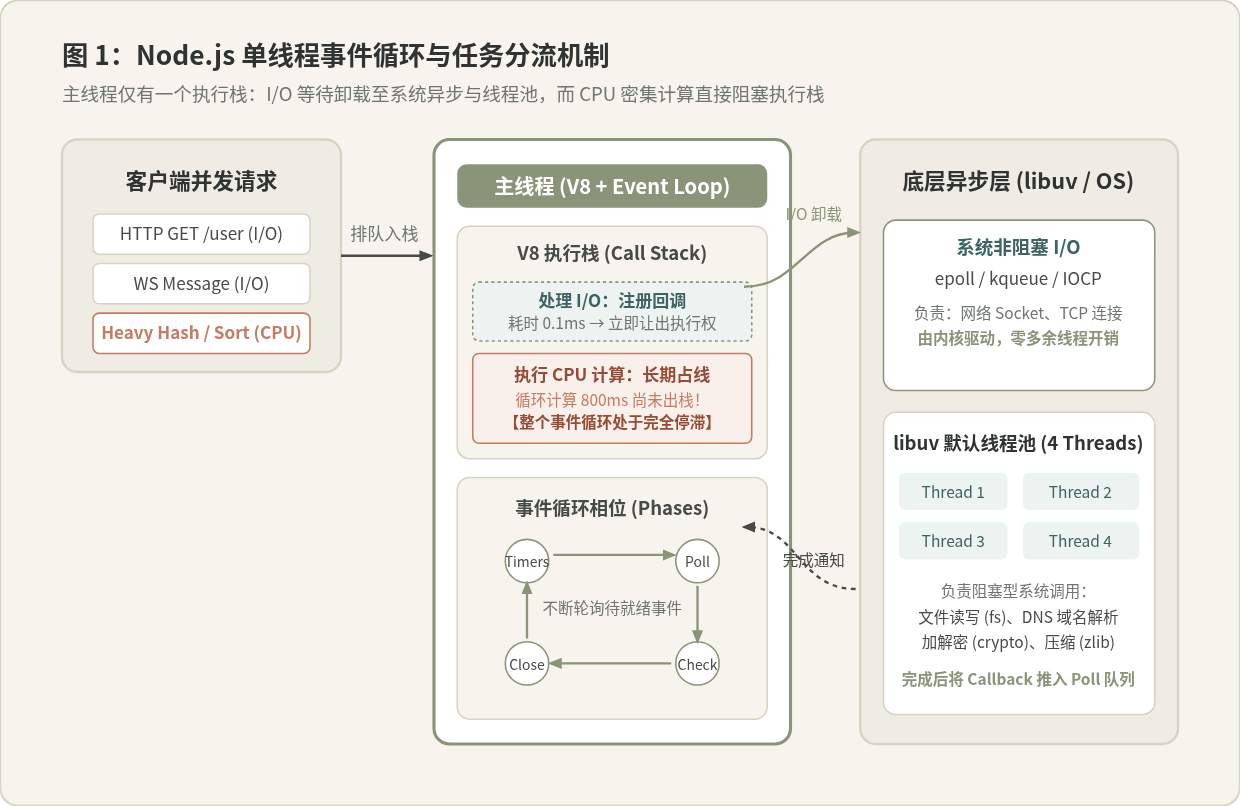
Node.js 则采用了截然不同的设计理念:JavaScript 代码执行在单一的主线程(Main Thread)中,所有的变量分配、对象操作和业务逻辑调用都在一个 V8 执行栈(Call Stack)里按序运转。但在主线程之下,Node.js 紧密结合了跨平台抽象库 libuv。
- 网络 I/O 的零等待:对于 HTTP、TCP 等网络 Socket 连接,底层直接委托给操作系统内核提供的高效事件通知机制(Linux 下的
epoll、macOS 下的kqueue、Windows 下的IOCP)。当网络数据包尚未到达时,主线程无需占用任何 CPU 算力干等,直接转去执行其他任务;当内核收到数据包后,触发事件通知,Node.js 才将预先绑定的回调函数推入事件循环队列依次执行。 - 阻塞型系统调用的线程池卸载:对于本地文件系统(
fs)、DNS 查询以及部分由 Node.js 内部实现的密码学算法(如crypto.pbkdf2),由于操作系统层面缺乏普适的纯异步非阻塞系统调用,libuv 会将这些阻塞操作委派给底层的默认工作线程池(Thread Pool,默认 4 个线程)。底层线程完成读写后,再将结果推回主线程。
这种结构决定了:只要代码逻辑是“发出 I/O 请求 → 等待外部响应 → 执行轻量回调处理结果”,Node.js 就能以极其微小的内存消耗和极高的速率在数以万计的连接之间穿梭调度。然而,如果回调本身包含耗时 500 毫秒的复杂纯数学计算,整个 V8 执行栈在整整 500 毫秒内都无法清空,事件循环彻底停摆,后面的任何新请求甚至连 TCP 三次握手后的分发都无法完成。
二、Node.js 适合做什么:I/O 密集型业务的天然温床
I/O 密集型(I/O-Bound)任务的核心特征是:任务耗费的大部分时间都在等待外部硬件或远程系统返回数据,而本机的 CPU 运算时间仅占极小比例(通常不足 5%)。在这些场景中,Node.js 的事件驱动机制能够发挥出最大效能。
1. API 网关与 BFF(Backend for Frontend)层
在现代微服务架构中,前端页面往往需要调用多个不同领域的微服务接口,并将多方返回的数据清洗、聚合后统一输出。这种业务形态几乎全部是网络 I/O 操作。
使用 Node.js 构建 BFF 层,可以利用 Promise.all 并发请求多个底层微服务,在网络往返期间主线程不被阻塞,数据到达后进行轻量级的 JSON 结构拼接即可返回。单台轻量级虚拟机往往就能轻松抗住数万 QPS 的网络转发。
2. 即时通讯与长连接推送(WebSocket / SSE)
如在线协同办公文档(类似协同编辑、多人光标实时同步)、在线聊天室、物联网设备心跳监控及金融行情推送。这些场景的共同特征是:连接数极多,但每个连接大部分时间处于静默状态,仅在特定事件发生时由服务端广播一小段文本消息。
Node.js 单个进程维护一个 Socket 句柄仅消耗微量的文件描述符与轻量内存,无需为每个闲置连接预留几兆字节的线程调用栈,因而在长连接并发规模上具有显著的资源成本优势。
3. 大文件流式代理与数据管道(Stream Pipeline)
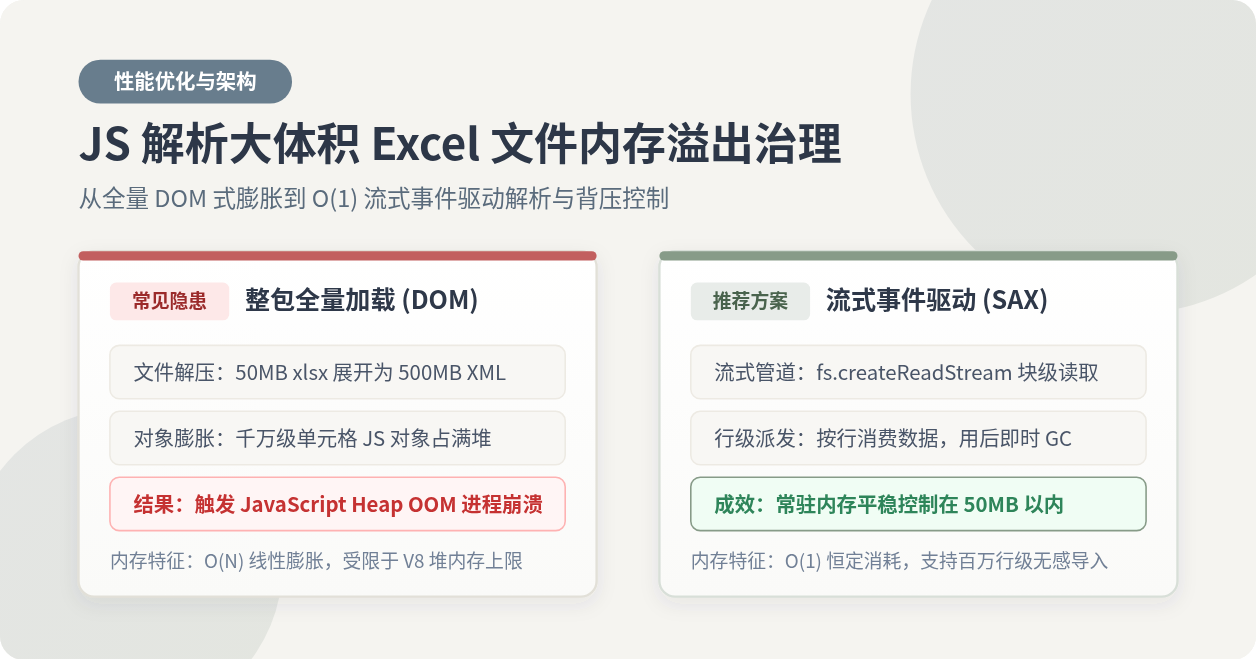
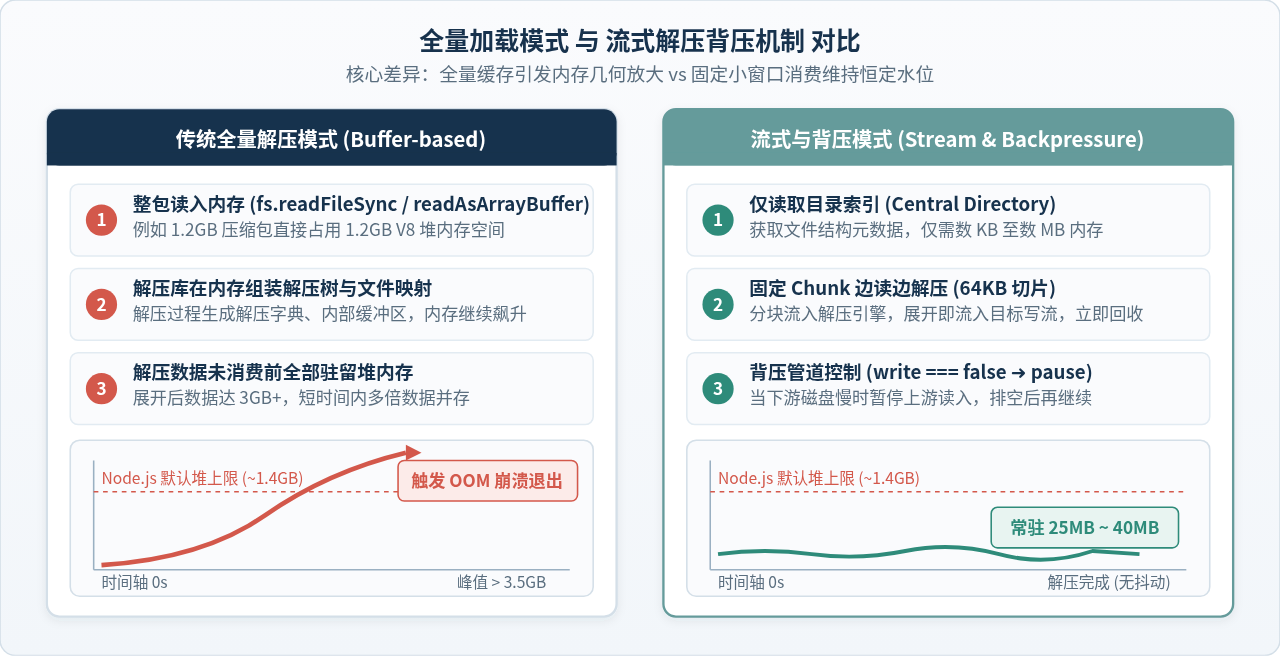
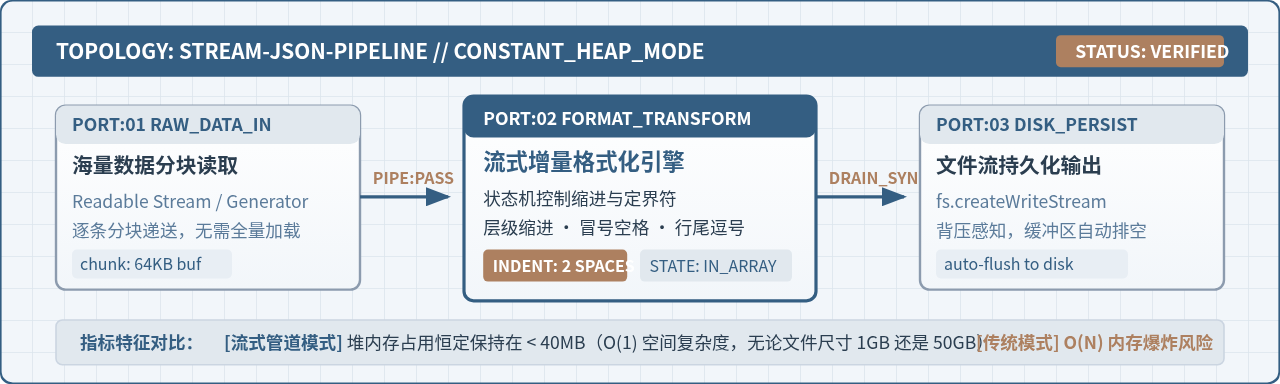
当服务端需要接收用户上传的百兆视频、日志文件,并实时经过哈希校验或转发至对象存储服务(如 S3 或本地存储)时,如果将整个文件读入内存进行处理,瞬间就会导致内存溢出崩溃(OOM)。
Node.js 内置了极其完善的 Stream 抽象机制,支持背压(Backpressure)自适应调节。数据块(Chunk)在内存中流动,消费端处理慢时自动通知生产端暂停读取,整个传输链路几乎不给主线程增加计算压力。
// 示例:Node.js 基于 Stream 的高并发非阻塞文件流式管道处理
import { createReadStream, createWriteStream } from 'node:fs';
import { createGzip } from 'node:zlib';
import { pipeline } from 'node:stream/promises';

async function streamCompressFile(sourcePath, destinationPath) {
  // 仅在缓冲区维持微小 chunk,不占用堆内存,依靠底层 I/O 流水线执行
  try {
    await pipeline(
      createReadStream(sourcePath),
      createGzip(),
      createWriteStream(destinationPath)
    );
    return { success: true };
  } catch (err) {
    console.error('流式处理中途异常:', err);
    throw err;
  }
}
三、Node.js 不适合做什么:CPU 密集型任务的窒息陷阱
CPU 密集型(CPU-Bound)任务的核心特征是:任务耗费的时间主要集中在本机 CPU 核心的算术逻辑运算、寄存器操作与内存数据搬运,计算耗时占绝大部分,几乎没有外部 I/O 等待。如果把这类任务直接放到 Node.js 的主线程中执行,将会造成灾难性的后果。
1. 事件循环阻塞(Blocking the Event Loop)的连锁反应
当一个客户端发起了一个耗时 1 秒的密集计算请求(例如复杂的素数生成或递归搜索),在这 1 秒钟之内:
- 其他所有试图建立连接的新请求都无法完成握手;
- 已经发出 I/O 请求、正在等待执行回调的其他正常请求被锁在队列中;
- 用于健康检查的探针(如 Kubernetes 存活探针
livenessProbe)无法在超时阈值内收到 200 响应,导致容器被管控系统误判为死锁并强行重启。
2. 常见的隐蔽 CPU 密集型踩坑场景
许多初学者常常误以为“CPU 密集”只存在于科学计算或 3D 渲染,实际上在常见的 Web 开发中,有许多容易被忽视的隐蔽操作同样属于严重的 CPU 密集任务:
- 超大 JSON 的同步解析与序列化:当接口返回或上传的 JSON 达到 50MB 以上,
JSON.parse()或JSON.stringify()必须在主线程递归遍历整个 AST 树,通常会导致主线程停滞几十毫秒至数秒不等。 - 灾难性回溯的正则表达式(ReDoS):如果不慎编写了存在指数级回溯潜力的正则表达式(如
/(a+)+$/),一个恶意构造的短字符串就可以让 V8 正则引擎在主线程耗费数分钟的纯 CPU 算力,直接导致整个服务瘫痪。 - 高强度的同步密码学哈希:在用户注册或登录验证时,如果错误地调用了同步版本的密码哈希函数(如
bcrypt.hashSync()),单次运算往往需要几十毫秒的 CPU 密集计算,高并发下主线程会瞬间被拖死。 - 富媒体图像像素与音视频处理:对高清图片进行高斯模糊、缩放裁剪,或者进行音频格式转换,这些工作必须完全依赖 CPU 密集指令甚至 GPU 加速,绝不能在主线程内执行。
// 反例:在主线程中执行长循环计算
import http from 'node:http';

function computeHeavyTask() {
  let total = 0;
  // 模拟需要占用主线程 500ms 的纯算术循环
  for (let i = 0; i < 5e7; i++) {
    total += (i ^ 2) % 7;
  }
  return total;
}

const server = http.createServer((req, res) => {
  if (req.url === '/heavy') {
    const start = performance.now();
    computeHeavyTask(); // 阻塞主线程 500ms
    res.end(`Heavy task done in ${(performance.now() - start).toFixed(1)}ms`);
  } else {
    // 即使是快速请求,如果排在 /heavy 之后,响应延迟也会从 1ms 暴增至 500ms+
    res.end('Fast endpoint response');
  }
});

server.listen(3000);
四、关键界限:核心特征与性能指标对比
为了在系统架构设计初期就准确划分业务属性,下表给出了两类任务在系统核心资源、运行表现及选型对策上的对比矩阵:
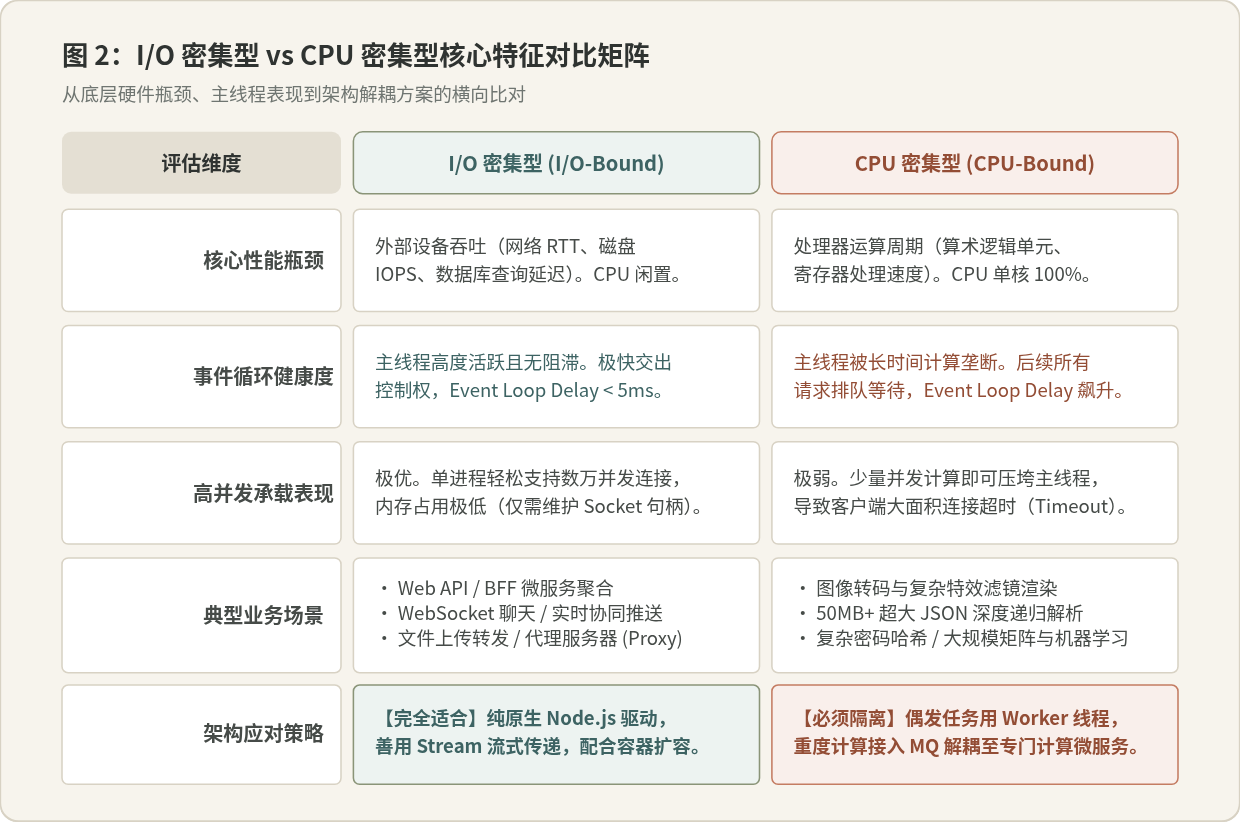
| 评估指标 | I/O 密集型 (I/O-Bound) | CPU 密集型 (CPU-Bound) |
|---|---|---|
| 时间分配比例 | 等待时间 > 90%,计算时间 < 10% | 计算时间 > 80%,等待时间 < 20% |
| 系统硬件瓶颈 | 网络带宽、RTT、磁盘 IOPS、数据库吞吐 | CPU 主频、多核运算能力、内存带宽 |
| Node.js 主线程状态 | 轻量轮询,快速派发事件并出栈 | 执行栈被长时间独占,事件循环严重饥饿 |
| Event Loop 延迟 | 通常保持在 1ms ~ 5ms 之间的极低水平 | 飙升至数百毫秒甚至数秒,吞吐量断崖下跌 |
| 单机并发连接承载 | 轻量支持数万长连接,仅占用句柄资源 | 极低,数十个并发计算即可打崩集群 |
| 工程选型建议 | 强力推荐:原生 Node.js 第一梯队选择 | 谨慎防范:须做多线程隔离或异构服务解耦 |
五、容易混淆的认知辨析
在技术团队的技术选型讨论中,关于 Node.js 的能力边界往往存在几种典型的片面认识。厘清这些说法的合理成分与修正空间,有助于做出更客观的技术决策。
辨析一:“只要把代码写在 async 函数或 Promise 里,就不会阻塞主线程?”
常见误区:有些开发者认为,只要把耗时的循环或大对象处理包装在 new Promise(resolve => ...) 中或者声明为 async 函数,任务就会被后台异步执行,不影响其他请求。
实际机制:Promise 和 async/await 只是 JavaScript 的微任务(Microtask)语法机制,用来管理异步结果的传递,它绝不会自动将 JavaScript 代码派发到另一个独立的 CPU 线程。如果在 new Promise((resolve) => ...) 的执行体中写了一个耗时 1 秒的密集计算循环,它依然会在当前主线程的微任务队列中霸占执行栈,事件循环一样会被牢牢冻结。
辨析二:“Node.js 是单线程的,所以在多核服务器上完全是浪费资源?”
常见误区:既然 Node.js 只有一个事件循环主线程,一台拥有 32 核或 64 核的高性能物理服务器是不是根本跑不满性能?
实际机制:“Node.js 运行时执行 JavaScript 是单线程”并不等于“Node.js 生产架构只能使用一个 CPU 核”。在工业级部署中,通常通过两种方式充分榨干多核算力:
- 进程级水平扩容:利用 Node.js 原生的
cluster模块,或者借助 PM2、Kubernetes,在每台机器上按照 CPU 核心数量启动对应数量的独立 Node.js 工作进程。每个进程各自拥有独立的 V8 引擎与事件循环,由内核或反向代理统一做负载均衡; - 底层线程协作:底层的 libuv 自身就维护着 C++ 线程池,在进行文件读写、加密解密和系统调用时,这些底层计算本来就是并行利用多核 CPU 的。
辨析三:“只要项目里出现 CPU 密集运算,就必须完全推翻 Node.js 改用其他语言?”
常见误区:一听到系统里有数据压缩、图像裁切或离线报表生成,就认为 Node.js 完全不能用,必须整体迁移到 Go、Java 或 Rust。
实际机制:完全不必因噎废食。绝大部分真实的 Web 业务系统都是“90% 的 I/O 交互 + 10% 的局部计算”。对于这 10% 的计算需求,Node.js 自身提供了完备的 worker_threads 线程池隔离机制;如果性能要求极高,还可以通过 napi-rs 或 C++ Addons 编写原生扩展插件,让主服务继续保留 Node.js 高效开发和高吞吐网络代理的红利,仅把具体算法函数委托给底层原生多线程执行。
六、实操落地:主线程阻塞排查与混合业务解耦四步法
当你在业务迭代中遇到了潜在的 CPU 计算与主线程性能瓶颈时,建议遵循标准化的排查与改造流程:
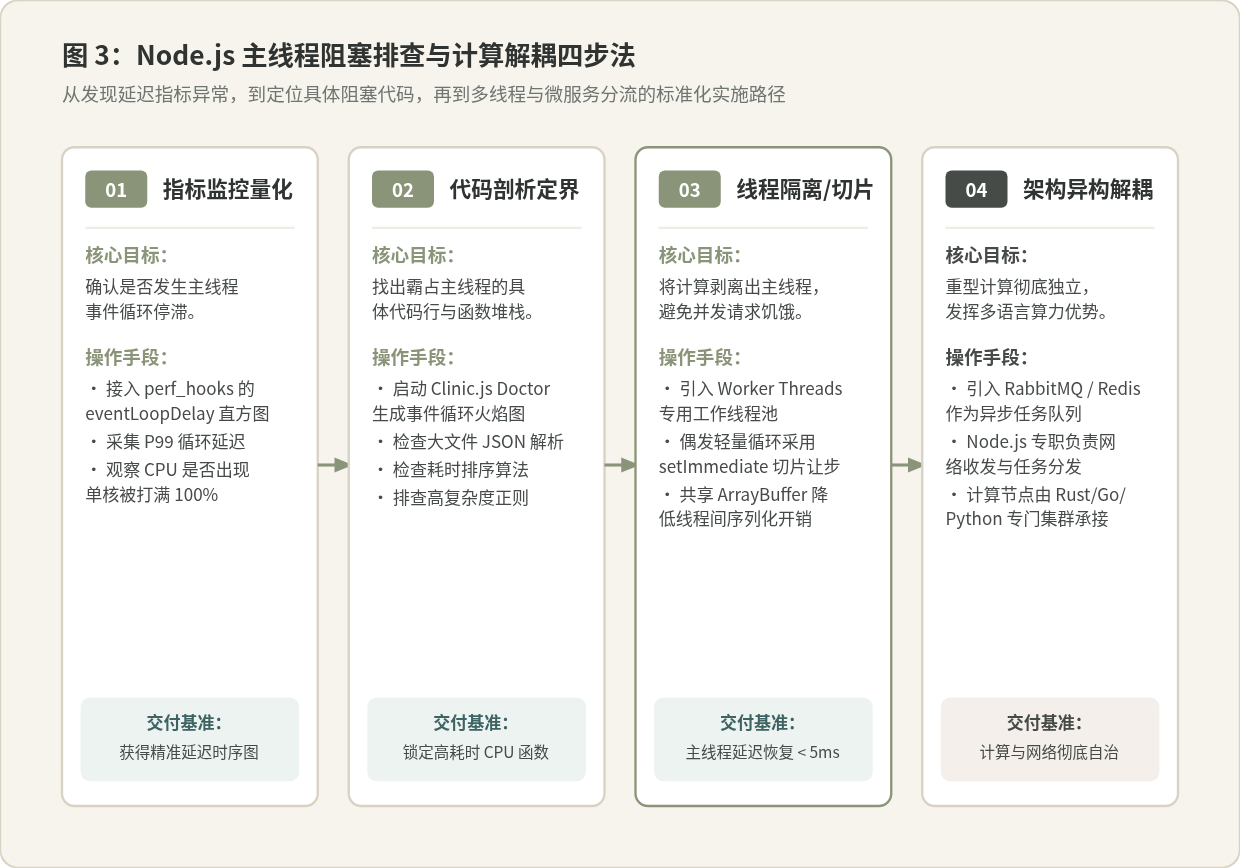
第一步:量化与监控 Event Loop 延迟指标
不要凭借主观猜测定位性能问题。在 Node.js 中,通过原生 node:perf_hooks 模块的 monitorEventLoopDelay 能够以微秒级别高精度量化主线程的停滞情况:
import { monitorEventLoopDelay } from 'node:perf_hooks';

// 初始化事件循环直方图,采样分辨率为 20ms
const h = monitorEventLoopDelay({ resolution: 20 });
h.enable();

setInterval(() => {
  const p99 = (h.percentile(99) / 1e6).toFixed(2); // 转换为毫秒
  const max = (h.max / 1e6).toFixed(2);
  console.log(`[EventLoop Health] P99 Delay: ${p99}ms | Max Delay: ${max}ms`);

  // 重置统计直方图
  h.reset();

  if (parseFloat(p99) > 50) {
    console.warn('【警告】主线程发生显著阻塞,存在 CPU 密集或长耗时同步操作!');
  }
}, 5000);
第二步:轻量循环的时间分片(Time Slicing)
如果是一批数量较多但单次耗时不长的数据处理任务(例如分批遍历转换 100,000 个数组元素),不需要强行启动多线程,可以通过 setImmediate 将计算任务切片为多个微小块,在每个时间片之间主动让出执行权,保证网络 I/O 能够插空响应:
// 将大数组分批处理,避免长时间独占主线程
function processInSlices(items, batchSize, processFn) {
  return new Promise((resolve) => {
    let index = 0;

    function nextSlice() {
      const end = Math.min(index + batchSize, items.length);
      while (index < end) {
        processFn(items[index]);
        index++;
      }

      if (index < items.length) {
        // 主动让出 CPU 控制权,交由下一个事件循环 tick 继续执行
        setImmediate(nextSlice);
      } else {
        resolve();
      }
    }

    nextSlice();
  });
}
第三步:引入 Worker Threads 实现进程内计算隔离
对于需要持续消耗 CPU 算力的运算(例如密码散列、复杂数据加密或大型结构计算),应当使用 Node.js 官方的 node:worker_threads 模块,将其分配至专门的 Worker 线程中执行。主线程与工作线程通过消息通道(MessageChannel)异步通信,主线程的 Event Loop 完全不受干扰。
// 主线程代码 (main.js)
import { Worker } from 'node:worker_threads';
import http from 'node:http';

function runWorkerTask(workerData) {
  return new Promise((resolve, reject) => {
    // 实例化独立的工作线程,拥有独立的 V8 实例与内存空间
    const worker = new Worker(new URL('./task-worker.js', import.meta.url), {
      workerData
    });

    worker.on('message', resolve);
    worker.on('error', reject);
    worker.on('exit', (code) => {
      if (code !== 0) reject(new Error(`Worker stopped with exit code ${code}`));
    });
  });
}

http.createServer(async (req, res) => {
  if (req.url === '/compute') {
    try {
      // 耗时的计算交给独立线程,主线程保持 0 阻塞,依然能高速响应其他请求
      const result = await runWorkerTask({ count: 5e7 });
      res.end(`Result: ${result}`);
    } catch (err) {{
      res.statusCode = 500;
      res.end(err.message);
    }}
  } else {
    res.end('Main thread is perfectly smooth and responsive!');
  }
}).listen(3000);
// 工作线程代码 (task-worker.js)
import { parentPort, workerData } from 'node:worker_threads';
// 在独立线程中执行密集算术运算
let total = 0;
for (let i = 0; i < workerData.count; i++) {
total += (i ^ 2) % 7;
}
// 将计算结果通过 IPC 通道回传主线程
parentPort.postMessage(total);new Worker(),因为创建新的 V8 实例和上下文也有几毫秒的开销。建议使用线程池管理库(如 piscina),在服务启动时预先初始化常驻的工作线程池,请求到达时借出线程执行计算。
第四步:超重型计算的架构级异构解耦
当面对秒级甚至分钟级的超级 CPU 任务(如 4K 视频压缩、大模型推理、大型科学矩阵运算),即便在 Node.js 中启动多线程,单台服务器的 CPU 和内存也会迅速被打满。
此时的标准架构解耦方案是:Node.js 仅作为接入层与调度层。Node.js 接收用户请求,完成参数校验与权限鉴权,迅速向消息队列(如 RabbitMQ、Kafka、Redis Stream)推送一条任务消息,并立即向客户端返回“任务已受理,请稍后查询”或通过 WebSocket 推送后续进度;后端真正的密集计算则由专门为计算性能打造的语言集群(如 Python、Go、Rust、C++)独立自治地消费和执行。
七、总结与选型决策指南
评价一门编程语言或技术栈的优劣,关键在于将其放置在最符合其设计哲学的场景中。Node.js 不是包治百病的万能银弹,但只要顺应其事件循环与非阻塞机制,它就能在现代互联网架构中发挥出极高的工程效益与吞吐表现。
面对新的业务系统或子模块设计时,可以参考以下决策树进行技术选型:
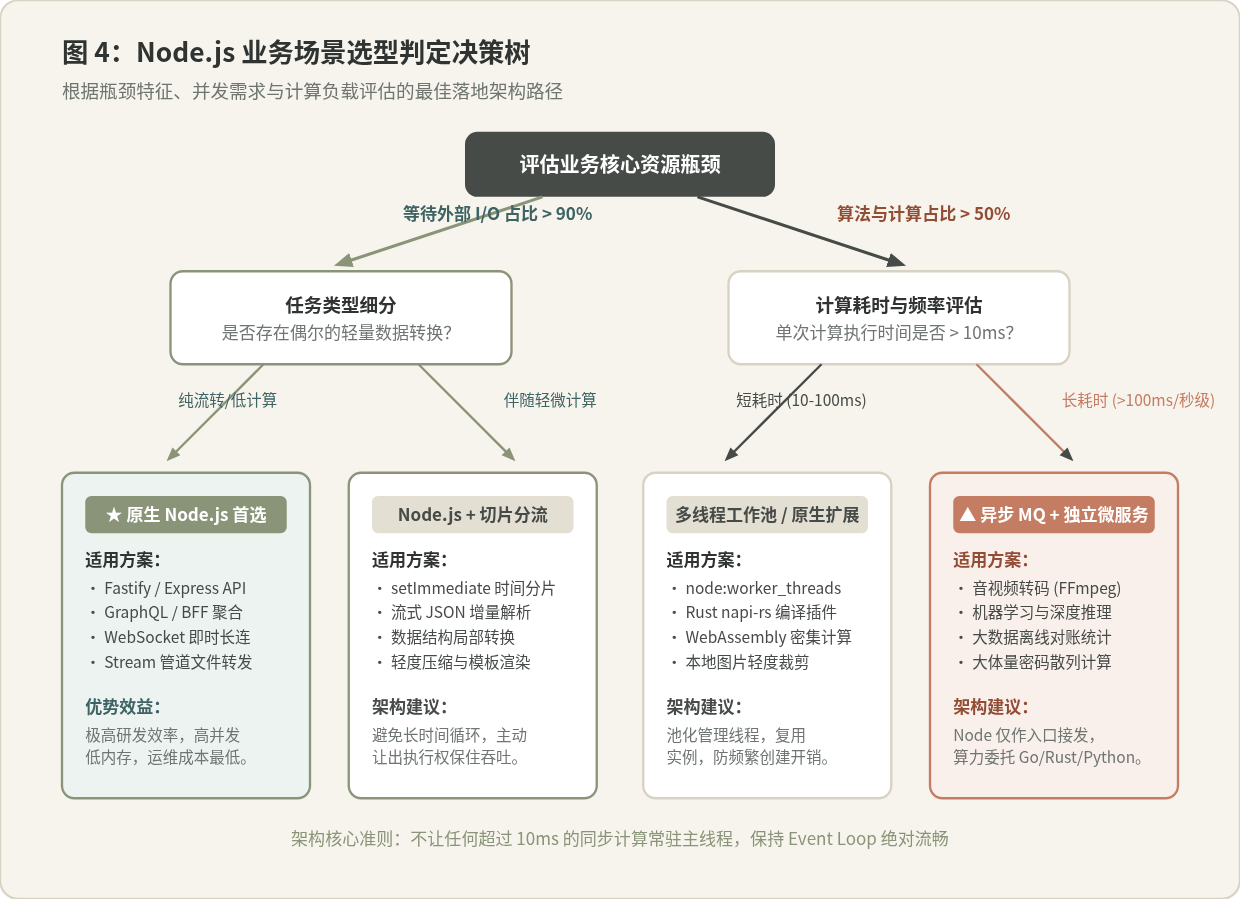
在团队技术栈的架构治理中,牢记以下三条黄金准则:
- 把等待交给 Node.js:任何本质为网络等待、微服务聚合、长连接推送和流式文件转发的需求,毫不犹豫地采用 Node.js,能获得最短的交付周期和极佳的并发表现;
- 把主线程还给事件循环:严禁任何单次耗时超过 10 毫秒的纯同步逻辑(长循环、深层大 JSON、脆弱正则表达式)常驻主线程,随时利用
monitorEventLoopDelay进行延迟守卫; - 分层治理重型算力:毫秒级计算用 Worker 线程池就地分流,秒级以上重型任务通过消息队列解耦到专门的计算微服务集群,实现网络吞吐与高强度算力的各司其职。
JS循环拼接大量字符串为何推荐用array.join
2026-11-12 14:28:46
JavaScript禁用怎么解除有哪些更现代的替代方案
2026-11-08 17:14:36
JavaScript框架库漏洞怎么做数量统计
2026-11-08 13:32:16
怎么用JS三元表达式简化if-else判断
2026-11-05 18:55:13
前端页面怎么实现JSON数据的高亮格式化展示
2026-11-05 18:12:52